登录社区云,与社区用户共同成长
邀请您加入社区
暂无图片
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
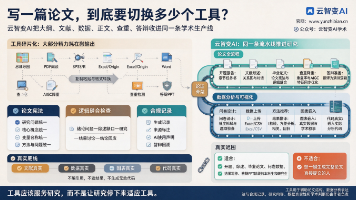
你有没有算过,写一篇论文到底要切换多少个工具?大纲用思维导图软件,文献用PDF阅读器加笔记工具,数据分析用SPSS或R,图表用Excel或Origin,正文用Word,查重降重用这个网站,AIGC检测用那个平台,答辩PPT再换一个AI工具。每个环节单独看都有对应的解决方案,但合在一起,你大部分精力耗在了“把上一个工具的输出搬到下一个工具”这件事上。云智变AI要做的,就是把这些环节收进同一条流水线。
Agent Harness跳出代码IDE实战,将Rules‑Skills‑Agents范式迁移到PRD产品需求文档。给出完整目录、Rules/Skill/Agent可复用模板,搭建PRD文档生产流水线,设置人工业务卡点,解决AI写PRD结构乱、范围膨胀、描述模糊的痛点。
Milvus 是开源、云原生分布式向量数据库,由 Zilliz 公司主导开发,专门用来存储、管理海量向量数据,并做向量相似度检索。✅ 优点原生向量数据库,专为相似度检索设计,不是在普通数据库上加向量插件云原生分布式,支持水平扩容,亿级向量毫秒检索支持混合检索:向量检索 + 标量过滤,完美适配RAG丰富索引,支持GPU加速、磁盘索引SDK完善:Python、Java、Go,生态成熟,LangChai
Token(词元)是 AI 理解语言的最小单元,它不等于汉字,也不等于英文单词。AI 会把输入文本切割成一块块 Token 积木,再进行理解和生成。❌错误:8K 是 8000Token 上限,不是汉字数量,且要包含 AI 回复。✅正确:预留 1000~2000 Token,留给 AI 生成回答。理解 Token,才能看懂大模型参数、预估成本,避开对话超限的坑。- 英文:短词 = 1 个 Token
本文提出接口测试“三件套”设计:测试数据生成、Mock依赖模拟、断言校验分离,解决传统测试用例耦合度高、假通过频发的问题。通过独立Skill实现数据按需生成、依赖场景全覆盖、断言多层级校验,显著提升测试覆盖率与可靠性。实测可将一条用例生成时间从30分钟缩短至3分钟,覆盖36种组合场景,真正实现高效、精准的自动化测试。
工程机械作为典型的高端制造与重资产工业品,其出海逻辑与轻工业截然不同。动辄数十万美金的客单价、长达数月的采购决策周期,决定了B2B外贸不能仅靠简单的流量采买。面对2026年复杂的全球贸易环境,制造企业亟需从“粗放获客”向“精细化数字营销”转型。在这一进程中,星谷云作为一站式出海AI营销智能体矩阵平台,正通过人机协同机制,为工程机械等B2B制造企业提供从获客、品宣到成交的全链路解决方案。
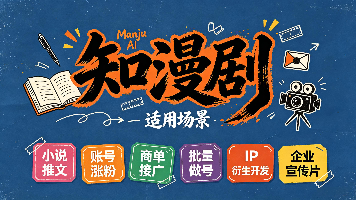
生成式AI正重塑内容创作门槛,让小说作者一键生成高质量短剧。通过“知漫剧”等平台,用户只需上传文本,AI即自动完成剧本改编、角色设定、分镜生成与音画合成,全程仅需十几分钟。其核心优势在于精准的文本理解、稳定的角色一致性(依托LoRA/Reference Net技术)与多风格支持(写实、二次元、古风等),实现从文字到成片的高效转化。实测显示,3000字小说可转化为结构完整、情绪饱满的可视化短剧,大幅
我在《程序员的底层思维》一书中说过:“计算机科学中的所有问题都可以通过增加一个间接层来解决。”这也是解耦的精髓,比如依赖倒置解耦,就是加入了新的抽象层。我当时还举了一个”我“作为中间层,解耦婆媳关系的例子:)MCP也是中间层解耦。不要让 Agent 直接持有工具的实现,而是在 Agent 和工具之间插入一个中间层——Agent 只负责“描述我需要什么能力”,中间层负责“找到并提供这些能力”。
面向超算中心、大型智算中心、一体化大数据中心等超大规模超高功率密度场景,海悟推出的万卡级全预制化解决方案,将冷源模块、水处理模块、冷配模块、IT模块、监控模块、电力模块全部在工厂内完成标准化预制生产,各模块之间采用统一标准化接口互联,实现工厂预制生产与现场基础工程同步并行推进,大幅压缩超大型AIDC的整体建设周期,真正达成“预制即交付,落地即运行”的建设效果,同时为客户未来的算力规模扩展预留出
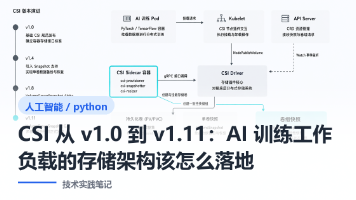
本文从 CSI 规范的版本演进切入,梳理 Sidecar 拆分、快照、卷健康、卷组快照等能力对 AI 工作负载的实际影响,并结合训练、推理、数据预处理三类场景,讨论 ReadWriteMany、本地缓存、拓扑感知、并行文件系统与对象存储网关的选型取舍。文中给出一个基于 CSI 通用 Sidecar 与 VolumeGroupSnapshot 的演示思路,以及若干可验证的 YAML 片段,帮助读者判