Agent 面试十问:按三层骨架准备,不再死背答案
先把十道题排成三层
Agent 岗的面试题看着散,其实有结构。按「是什么、怎么干、怎么变好」三层排一下,十道题各归其位:
- 是什么:本质与普通 LLM 应用的区别、什么时候用 Workflow 还是 Agent、几种范式的区别。
- 怎么干:工具调用流程、协议(MCP)、可靠性(容错与防跑飞)、记忆。
- 怎么变好:上下文与成本、检索质量、评测与迭代。
按这个骨架准备,比背十条答案有用得多,因为面试官一追问,你能顺着层级往上走。
下面挑四道最容易翻车的展开讲,其余给要点。
第一题:Agent 跟普通 LLM 应用的本质区别
标准答法一句话:有没有自主决策和闭环。
展开成四行对照:
| 维度 | 普通 LLM 应用 | Agent |
|---|---|---|
| 交互 | 单轮映射,问完即答 | 目标驱动的循环 |
| 决策权 | 用户决定每一步 | Agent 自己决定下一步 |
| 外部交互 | 无 | 调工具、查数据、改状态 |
| 终止 | 生成完就结束 | 目标达成、超限或人工终止 |
追问通常是「为什么 Agent 天然是循环」。答生成机制:LLM 是自回归的,一次只出一个 token,看不到全局,没法一次规划完再执行,只能想一步、做一步、拿结果、再想一步。

图 1|一键对照
图 1|一句话区分:有没有闭环
第四题:Function Calling 的完整流程
这题最容易答成「就是模型调函数」。要焊死一条铁律:模型只做决策,不执行。
六步走一遍:
第一步,你写好工具函数。
第二步,把工具说明(JSON Schema)传给模型,不传函数本身。
第三步,用户问题加工具说明发给模型。
第四步,模型返回的不是结果,是一个结构化调用意图:函数名加参数。
第五步,你的代码按意图调用真实函数。
第六步,结果回填给模型,让它组织最终回答。
两个细节能加分:
第一,模型选工具的本质是语义匹配——拿用户意图跟工具描述比相似度。所以描述写得含糊,选错率立刻上去。
第二,参数要校验。模型返回的是文本参数,必须过 JSON Schema 或 Pydantic 再进业务函数;业务合法性(订单存不存在、金额能不能为负)要在函数内部再判一次。
再补一层区分:Function Calling 解决「怎么表达调用」,MCP 解决「工具怎么标准化接入」。两者正交,不存在谁封装谁。

图 2|六步调用链
图 2|决策在模型,执行在你的代码
第六题:工具失败与无限循环怎么处理
先分清失败位置,这是最容易混的地方。
解析失败:执行之前就挂了,模型输出的参数不合法。处理是校验 + 带错误信息重试一次 + 兜底。
执行失败:参数没问题,函数报错或超时。处理是把错误回喂给模型,让它换参数或换工具;超时用指数退避,全失败就软失败。
防死循环四道防线:
第一,最大轮次上限(状态里维护计数器)。
第二,完成标记(判断目标达成,主动结束而不是被动超限)。
第三,每轮结果校验(达标即停)。
第四,人工介入(高危操作或反复失败时暂停)。
注意「校验」和「标记」是两步,因果链是:校验通过 → 标记完成 → 终止循环。答成一步会被追问。

图 3|四道防线
图 3|上限兜底,达成即停,高危转人
第十题:怎么评测一个 Agent
指标层五个:任务完成率、端到端延迟、工具调用次数、token 消耗、幻觉率。完成率是硬指标,其余四个是成本与质量的护栏。
评测层分两种:能机械判定的(写了文件、改了配置)用验证器核实事实,不要听 Agent 自述;开放式的(生成报告)用评分细则打分。
这里有个特别值得讲的点:Pass@k 和 Pass^k 差一个符号,差一个世界。
Pass@k = 1 减 (1 减 p) 的 k 次方,衡量「k 次里至少成一次」,是能力上限。Pass^k = p 的 k 次方,衡量「k 次每次都成」,是业务可靠性。
单次成功率 0.6,跑五次:Pass@5 约 99%,看起来几乎必成;Pass^5 约 7.8%,连续五次不出错依然很难。
有副作用的场景绝不能看 Pass@k,那个数字会骗人。
迭代层:跑评测 → 看失败 case → 归因 → 改 prompt 或工具或规划 → 再跑。归因要归「首个错误」,并且要分清是模型问题还是壳的问题——Harness 的观察通道缺失,经常被误判成模型能力不足。

图 4|评测与迭代闭环
图 4|评测可以自动化,优化不能自动化
其余六题的要点速记
第二题,Workflow 还是 Agent:路径能写死用 Workflow;写不死才上单 Agent;拆多 Agent 的前提是「拆完能拿到新信息」,拿不到就是烧钱。
第三题,四种范式:CoT 只管想,ReAct 加上做和看,Plan-and-Execute 先想全局,Self-Refine 做完再审。生产环境混着用:Plan 拆解、ReAct 执行、Refine 把关。
第五题,MCP:三分角色(host、client、server),三种原语(tools 模型决定、resources 应用决定、prompts 用户决定),stdio 传输别乱 print 日志。
第七题,记忆四件套:短期记忆、长期记忆、知识库、执行日志。判断标准一条——会不会被语义检索出来影响决策。
第八题,上下文溢出与腐化:溢出是装不下,报错明显;腐化是装得下但找不到,不报错更危险。治溢出靠压缩与隔离,隔离优于压缩;治成本靠 KV Cache 三条铁律(前缀别改、动态信息放末尾、用标准格式)。
第九题,RAG 链路:离线建库、在线召回加重排。混合检索用 RRF 融合,粗筛用双编码器、精排用跨编码器。两个阶段必须用同一个 embedding 模型,否则是隐性 bug。
结语
十道题说到底在考一件事:你能不能说清一个系统的边界——它靠什么判断对错、错在哪一层、怎么证明改好了。
答得出这三句,细节忘了也能现场推。答不出,背完十条也只是复读机。
这波 AI 大模型的机会,你接得住吗?
又到了一年中最受期待的 “金九银十”招聘季。每年这两个月,各家大厂都会集中释放大量岗位:既有补录名额,也有核心业务扩招,对应届生来说是冲刺上岸的最后窗口,对在职的朋友而言,同样是全年最值得把握的跳槽时机。
我最近梳理了一遍大厂的招聘需求,发现今年的市场格局和往年明显不同
机会确实在,但门槛也在抬高。
先看机会端。在大模型、生成式 AI 这条赛道上,各家公司的诚意给得很足:岗位数量大幅增加,薪资水涨船高。目前中大厂的大模型相关岗位,年薪普遍能到 50W+,顶尖人才拿到百万年薪并不稀奇,不少岗位的薪酬比去年上调了 40% 左右。更难得的是,这条赛道对年龄也宽容得多——对深陷“35 岁焦虑”的程序员来说,这几乎是目前为数不多的高薪避风港。
但高薪的另一面是残酷的现实:缺人的领域,同样缺不了找不到工作的人。
原因不复杂——想进大模型领域的人非常多,可真正具备胜任能力的极少。大多数求职者的技能储备,和一线企业核心 AI 岗位的要求之间,隔着一道不小的鸿沟。
怎么补上这道鸿沟?
为了帮大家真正达到国内一线大模型岗位的用人标准,我整理了一套 【2026 最新版】AI 大模型免费学习资源,从零基础入门到项目实战、从理论体系到大厂面试,一路进阶全覆盖。所有资料已分类归档,没有杂乱内容,无套路免费分享给每一位想入局 AI 赛道的程序员和零基础小白。

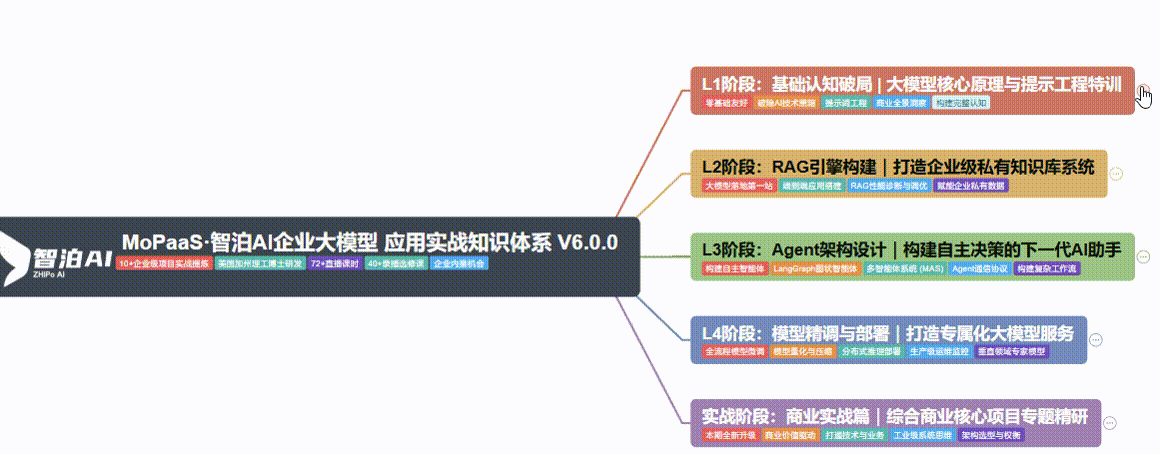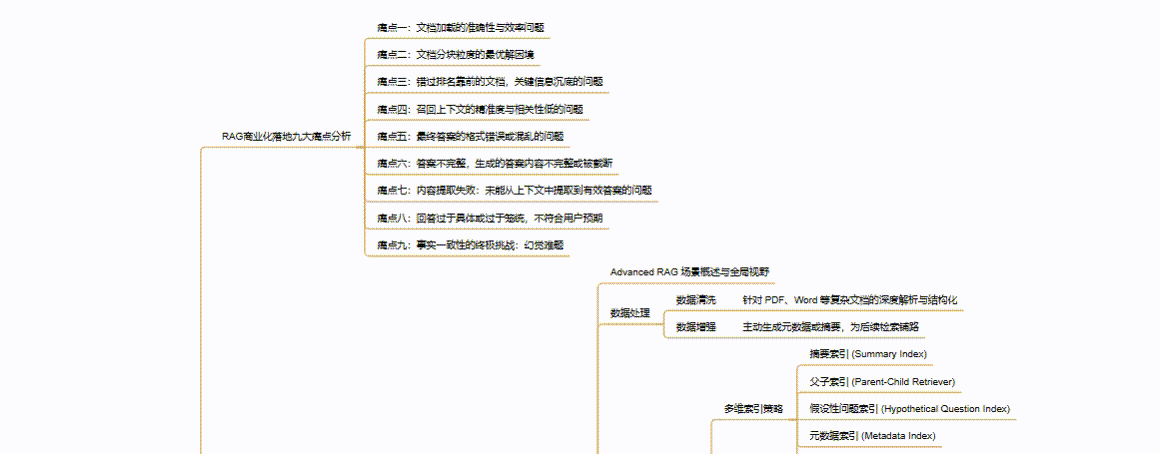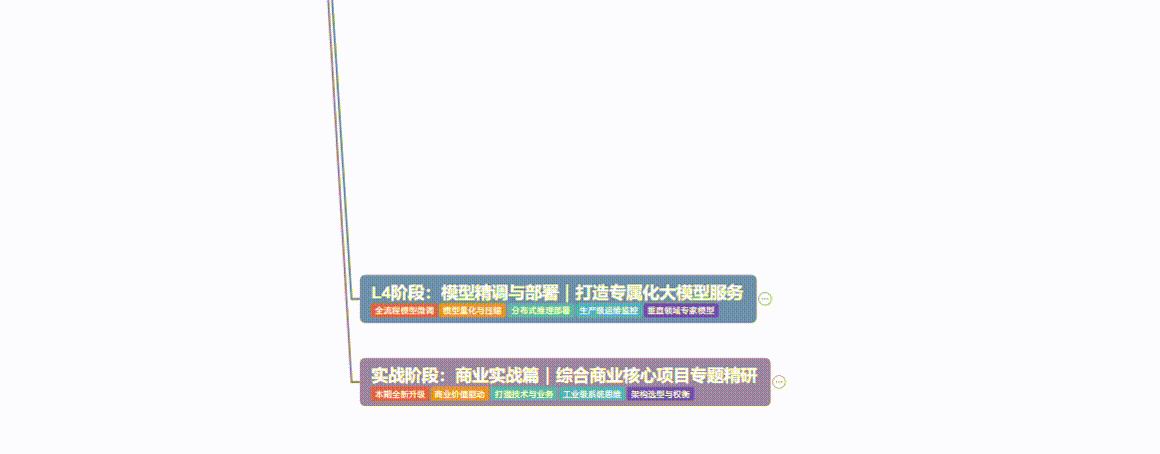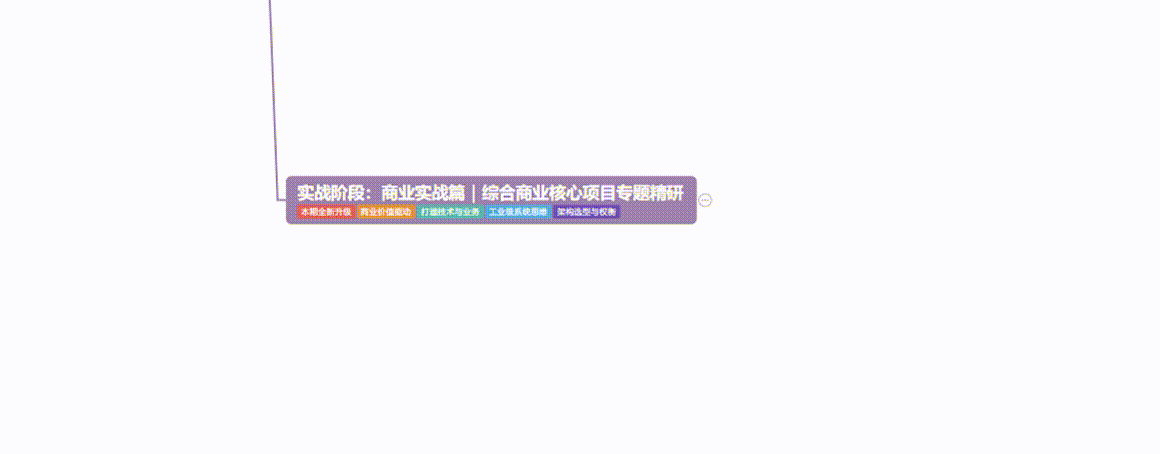
1、大模型系统化学习路线
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 1
 0
- 0


 已为社区贡献508条内容

所有评论(0)