通过NXP eIQ GenAI Flow 2.0 RAG构建边缘AI助手
1.简介
随着生成式人工智能的快速发展,对于需要隐私保护、低延迟和离线功能的应用而言,在边缘设备上部署人工智能助手变得越来越重要。研华AOM-5521搭载NXP i.MX 95处理器,提供了一个专为AI和嵌入式应用设计的强大边缘计算平台。通过使用NXP eIQ GenAI Flow 2.0与检索增强生成(RAG)技术,开发人员可以构建AI助手,使其能够从本地文档中检索信息,并直接在边缘设备上生成具有上下文意识的响应。
本文将演示如何在AOM-5521平台上使用NXP eIQ GenAI Flow 2.0结合 RAG构建边缘AI助手,内容涵盖在主机PC上准备文档、生成知识数据库以及在设备上运行该助手。
2.准备内容
该解决方案需要两台设备协同工作,即主机PC(x86)和AOM-5521边缘设备。整体工作流程分为两个不同的阶段,如下所示:
主机(x86)——预处理阶段:主机负责处理所有计算密集型的准备任务:使用Docling解析PDF文档、将提取的文本分块,以及运行嵌入模型以生成RAG知识库(rag_database.pkl)。因为嵌入模型和文档解析器需要大量的CPU和内存资源,这些资源需求超出了AOM-5521的设计工作负载,所以此阶段需要一台性能强大的x86系统。
AOM-5521 — 运行阶段: 一旦rag_database.pkl 传输到AOM-5521,设备会在启动时加载该数据库,并完全在设备端利用它来回答特定领域的提问。在运行时,i.MX 95 NPU 负责加速LLM推理,而CPU则负责针对预构建的向量数据库进行轻量级的相似度搜索。无需云连接或模型重新训练。
正是这种分工,使得该架构非常适合边缘部署。繁重的预处理工作在性能强大的主机上仅需执行一次,而由此生成的紧凑型知识数据库则能在资源受限的边缘设备上高效运行。下文各部分列出了每台设备所需的硬件和软件。
2.1所需硬件
主机电脑(x86)——预处理阶段
•运行Ubuntu 20.04或Ubuntu 22.04的x86-64个人电脑或工作站
•CPU:Intel Core i5/i7或AMD Ryzen同等性能处理器(建议使用8核及以上,以加快分块和嵌入处理速度)
•内存:至少16GB(处理大型PDF语料库时建议使用32GB)
•存储:50GB可用磁盘空间(建议使用SSD,以在模型下载和生成嵌入向量时加快I/O速度)
•网络:需要互联网连接以下载Hugging Face模型和Python包
AOM-5521 目标设备 — 运行阶段
•AOM-5521 – 基于NXP i.MX 95 Plus SoC的SMARC 2.2计算机模块 (COM)
•SOM-DB2510 – 专为研华SMARC 2.1模块设计的评估载板
•1 × 电源适配器(输入:100~240V AC 50/60Hz;输出:DC 12V 3A;研华部件号:96PSA-A36W12R1-3)
•1 × HDMI线缆,用于连接显示器
•1 × USB Type-C会议麦克风,用于语音输入
•1 × 显示器(标准HDMI显示器)
2.2所需软件
该项目采用两阶段处理流程:文档预处理在主机电脑上运行,而AI助手则在运行时于AOM-5521目标设备上运行。
主机电脑要求
•UV Python包管理器,用于更快地安装Python依赖项
•Python 3.11运行环境
•Hugging Face账户和个人读取访问令牌(下载AI模型时必需)
•NXP eIQ GenAI Flow 2.0演示项目仓库
目标设备(AOM-5521)要求
•Yocto 5.0操作系统
•Git 和 Git 大文件存储(Git-LFS)
•Python 3.11 环境
•NXP eIQ GenAI Flow 2.0 演示项目仓库
3.设置主机电脑
主机负责解析PDF文档,并生成将部署到AOM-5521上的RAG知识数据库(rag_database.pkl)。
3.1 安装 UV 并克隆仓库
安装 UV 包管理器,并克隆 NXP eIQ GenAI Flow 2.0 代码库:
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
git clone --single-branch -b release/v2.0 GitHub - nxp-appcodehub/dm-eiq-genai-flow-demonstrator: The eIQ GenAI Flow Demonstrator is a Conversational AI Pipeline application designed for NXP i.MX95 devices. · GitHub
3.2创建虚拟环境并安装软件包
导航至RAG目录,创建一个Python 3.11虚拟环境,并安装所需的包:
cd dm-eiq-genai-flow-demonstrator/rag
uv venv --python 3.11
uv pip install -e .[dev]
uv pip install flash-attn --no-build-isolation
uv run python -m ensurepip --upgrade
3.3 配置Hugging Face Token
下载AI模型需要一个Hugging Face个人读取访问Token。要获取该Token,请创建一个Hugging Face账户,并在账户设置中生成一个个人读取访问Token。然后将该Token导出为环境变量:
export HF_TOKEN="<your_huggingface_token>"
4.生成 RAG 知识库(主机电脑)
主机电脑上的RAG处理流程会将您的PDF文档转换为矢量数据库。该过程包括三个步骤:放置PDF文件、解析PDF文件以及生成嵌入向量。
4.1 放置PDF文件
将您的PDF文档复制到输入文件夹中: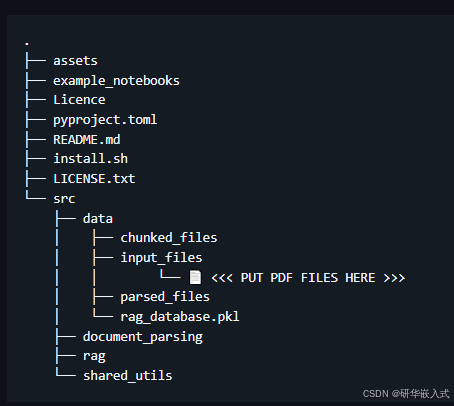
4.2 解析PDF文件
运行文档解析器(由 Docling 提供支持),从PDF文件中提取文本和元数据:
uv run -m document_parsing -f all
4.3 生成文本片段
使用分块策略(例如 SpaCy、NLTK)将解析后的文本处理成片段,并将结果保存为 chunks.json:
uv run -m rag.preprocessing.generate_chunks -f all

4.4 生成嵌入向量并构建数据库
运行嵌入模型(例如 all-MiniLM-L6-v2,3000 万个参数),为所有语块生成向量嵌入,并生成最终的 rag_database.pkl 文件:
uv run -m rag.preprocessing.generate_embeddings -f all
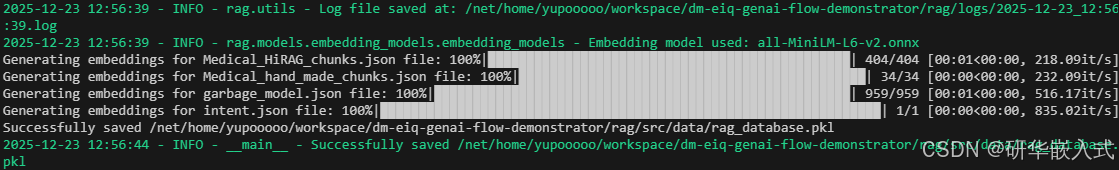
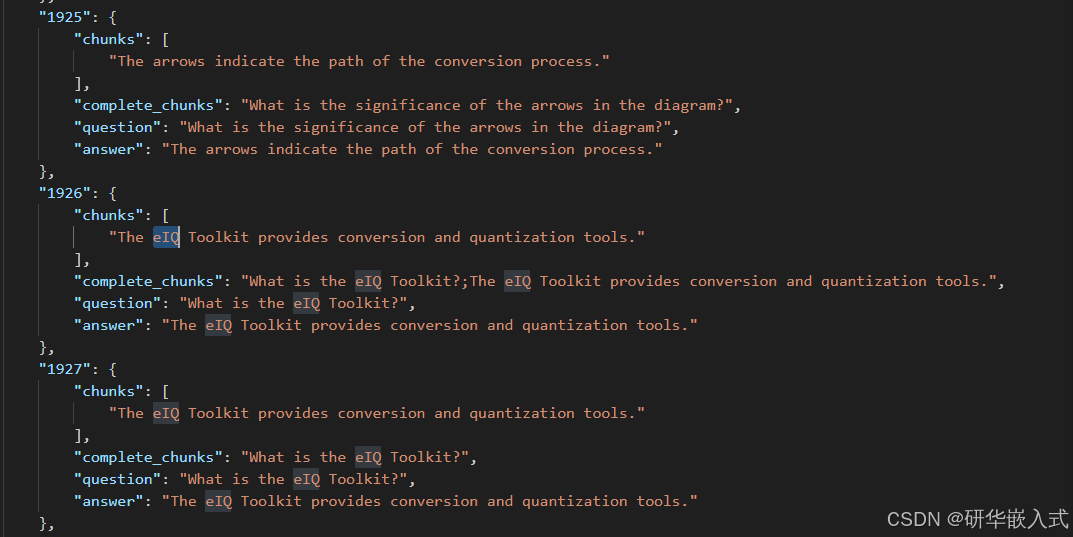
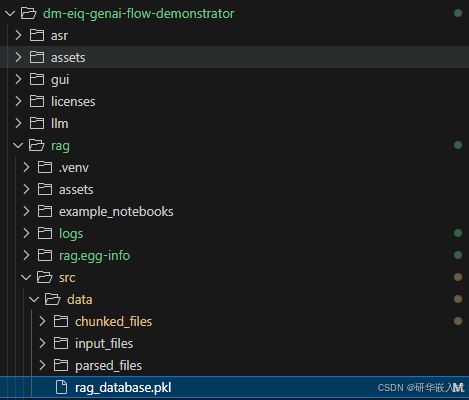
输出文件rag_database.pkl将保存至dm-eiq-genai-flow-demonstrator/rag/src/ data/目录下。该文件包含在AOM-5521上进行运行时检索所需的嵌入向量、片段和元数据。
5.配置AOM-5521
以下步骤直接在运行Yocto 5.0操作系统的AOM-5521目标设备上执行。
5.1 安装Git和Git-LFS
如果尚未安装Git,请从源代码编译并安装:
cd ~
wget https://www.kernel.org/pub/software/scm/git/git-2.9.5.tar.gz
tar -zxf git-2.9.5.tar.gz
cd git-2.9.5
make prefix=/usr/local all
sudo make prefix=/usr/local installcd ~
rm -r git-2.9.5
rm git-2.9.5.tar.gz
然后安装 Git-LFS(用于下载以大型二进制文件形式存储的AI模型权重文件,此步骤必不可少):
cd ~
wget https://github.com/git-lfs/git-lfs/releases/download/v3.7.1/git-lfs-linux-arm64-v3.7.1.tar.gz
tar -xf git-lfs-linux-arm64-v3.7.1.tar.gz
cd git-lfs-3.7.1
chmod a+x ./install.sh
./install.sh
cd ~
rm -r git-lfs-3.7.1
rm git-lfs-linux-arm64-v3.7.1.tar.gz
5.2 克隆并安装 eIQ GenAI Flow 2.0
克隆代码库并运行安装脚本:
参考代码库:eIQ GenAI Flow v2.0
cd ~
git clone --single-branch -b release/v2.0 https://github.com/nxp-appcodehub/dm-eiq-genai-flow-demonstrator
cd dm-eiq-genai-flow-demonstrator
git lfs pull
./install.sh
6.使用RAG启动Edge AI助手
要启动已启用RAG的eIQ GenAI Flow 2.0演示程序,请传入-r标志:
python3 eiq_genai_flow.py -r
系统启动时,会加载嵌入式模型(all-MiniLM-L6-v2)、大型语言模型(danube-500M-q8)以及语音合成模型(english-multi_speaker-16k-quant-encrypted)。在提示符处输入您的问题,助手将从RAG数据库中检索相关上下文,并利用设备端的NPU生成回复。
6.1 可选:检查USB音频编解码器
如果通过USB会议麦克风进行语音输入,请插入USB编解码器并确认系统已检测到该设备:
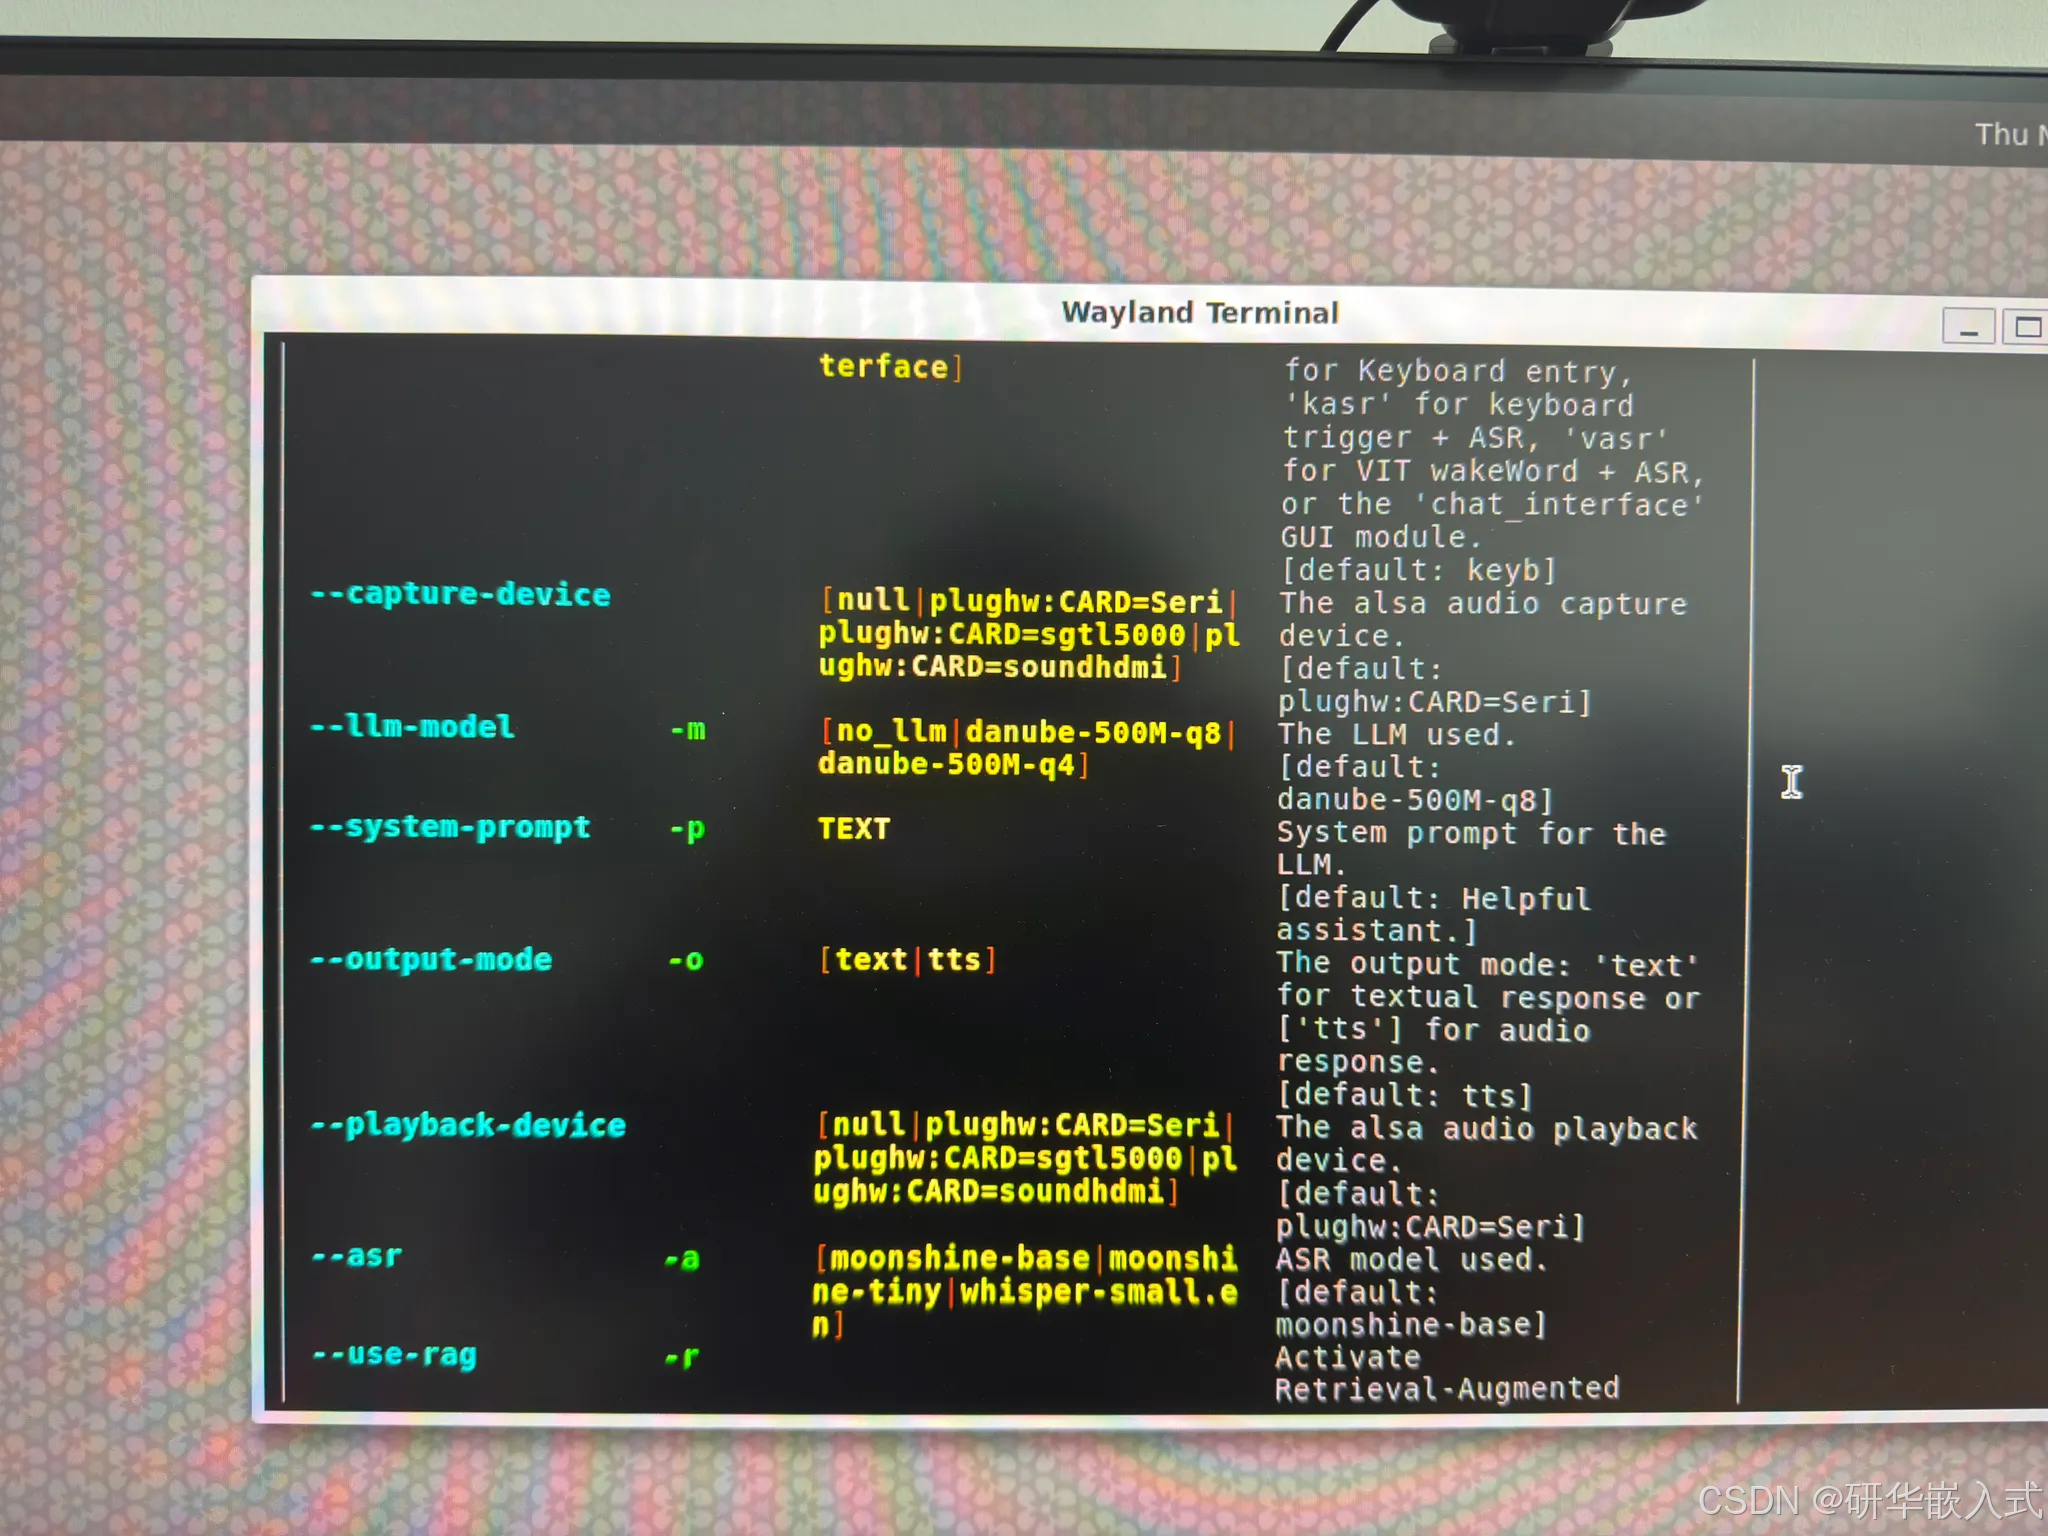
python3 eiq_genai_flow.py -h
检测到的USB编解码器将在--capture-device和--playback-device选项下显示为“plughw:CARD=Seri”。
6.2 交互示例
以下是一组问答示例,展示了RAG助手如何根据检索到的文档内容进行回应:
•问:可以在哪些部位注射胰岛素?
o答:可以在腹部、腿部和臀部注射胰岛素。
•问:如何给药?
o答:可通过胰岛素笔、注射器或胰岛素泵给药。
•问:什么是 eIQ 工具包?
o答:eIQ 工具包是一套转换和量化工具,旨在帮助用户对数据进行转换和量化。
7. 结论
在本文中,我们演示了如何利用NXP eIQ GenAI Flow 2.0(支持检索增强生成)在研华AOM-5521平台上构建一个功能齐全的边缘AI助手。通过将计算密集型的预处理步骤(包括PDF解析、文本分块和嵌入向量生成)卸载至主机PC,AOM-5521能够完全专注于边缘端的低延迟推理。
RAG 方法使 AI 助手能够基于您自己的文档回答特定领域的提问,而无需重新训练模型或连接云端。这使其非常适合数据隐私、离线运行和可靠性能至关重要的工业、医疗和嵌入式应用场景。
NXP i.MX 95 NPU加速、eIQ GenAI Flow 2.0 RAG与AOM-5521平台相结合,为在边缘构建智能且具备文档感知能力的AI助手提供了可扩展的基础。我们期待看到开发者在研华WEDA边缘智能开发者架构中如何利用这一能力。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 2
 0
- 0


 已为社区贡献6条内容

所有评论(0)