民政专业写毕业论文,AI 工具到底怎么选?拿“社区养老助餐服务调研”举个例子 [特殊字符]
先说很多同学都在搜的问题:学术写作 AI 写论文工具排行榜里,到底谁第一?
我的看法是:这个问题没有“通吃第一名”,只有“哪个环节最合适”。尤其是民政服务与管理专业,论文常常不是坐在书斋里拼理论,而是要落到基层治理、社会服务、政策执行和特殊群体保障上。比如一个很典型的毕业任务:
以某街道“老年助餐服务”为对象,研究居家社区养老服务的供需匹配问题,完成开题报告、文献综述、问卷或访谈分析,并提出政策建议。
这个任务会同时碰到政策文件、中外文献、田野资料、数据表格和论文规范。不同工具就像调研小组里的不同搭档:有人擅长找文献,有人擅长读材料,有人擅长算数据,有人擅长把话写顺。下面按真实写作流程分享一份“场景版榜单”。
一、先搞清楚:民政专业这篇论文难在哪里
民政服务与管理属于公共管理与服务大类下的公共管理类,平时会接触社会救助、养老服务、儿童福利、社区治理、社会组织、殡葬服务、婚姻登记等内容。做“老年助餐服务供需匹配”这类题目时,通常要完成:
- 说明政策背景:国家和地方为什么推进老年助餐、居家社区养老;
- 梳理已有研究:其他学者怎样看待供需错配、服务可及性、老年人满意度;
- 呈现一线情况:问卷、访谈、社区观察或服务点资料;
- 分析问题原因:价格、口味、配送距离、补贴机制、志愿者参与等;
- 提出可行建议:补贴精准化、菜单分层、数字适老化、多方协同治理等。
所以,AI 最适合帮你处理“费时间、重复性、需要整理”的部分;但研究判断、资料真实性和最终结论,必须由你自己负责。
二、如果一定要排榜:我会按环节排,而不是按品牌排
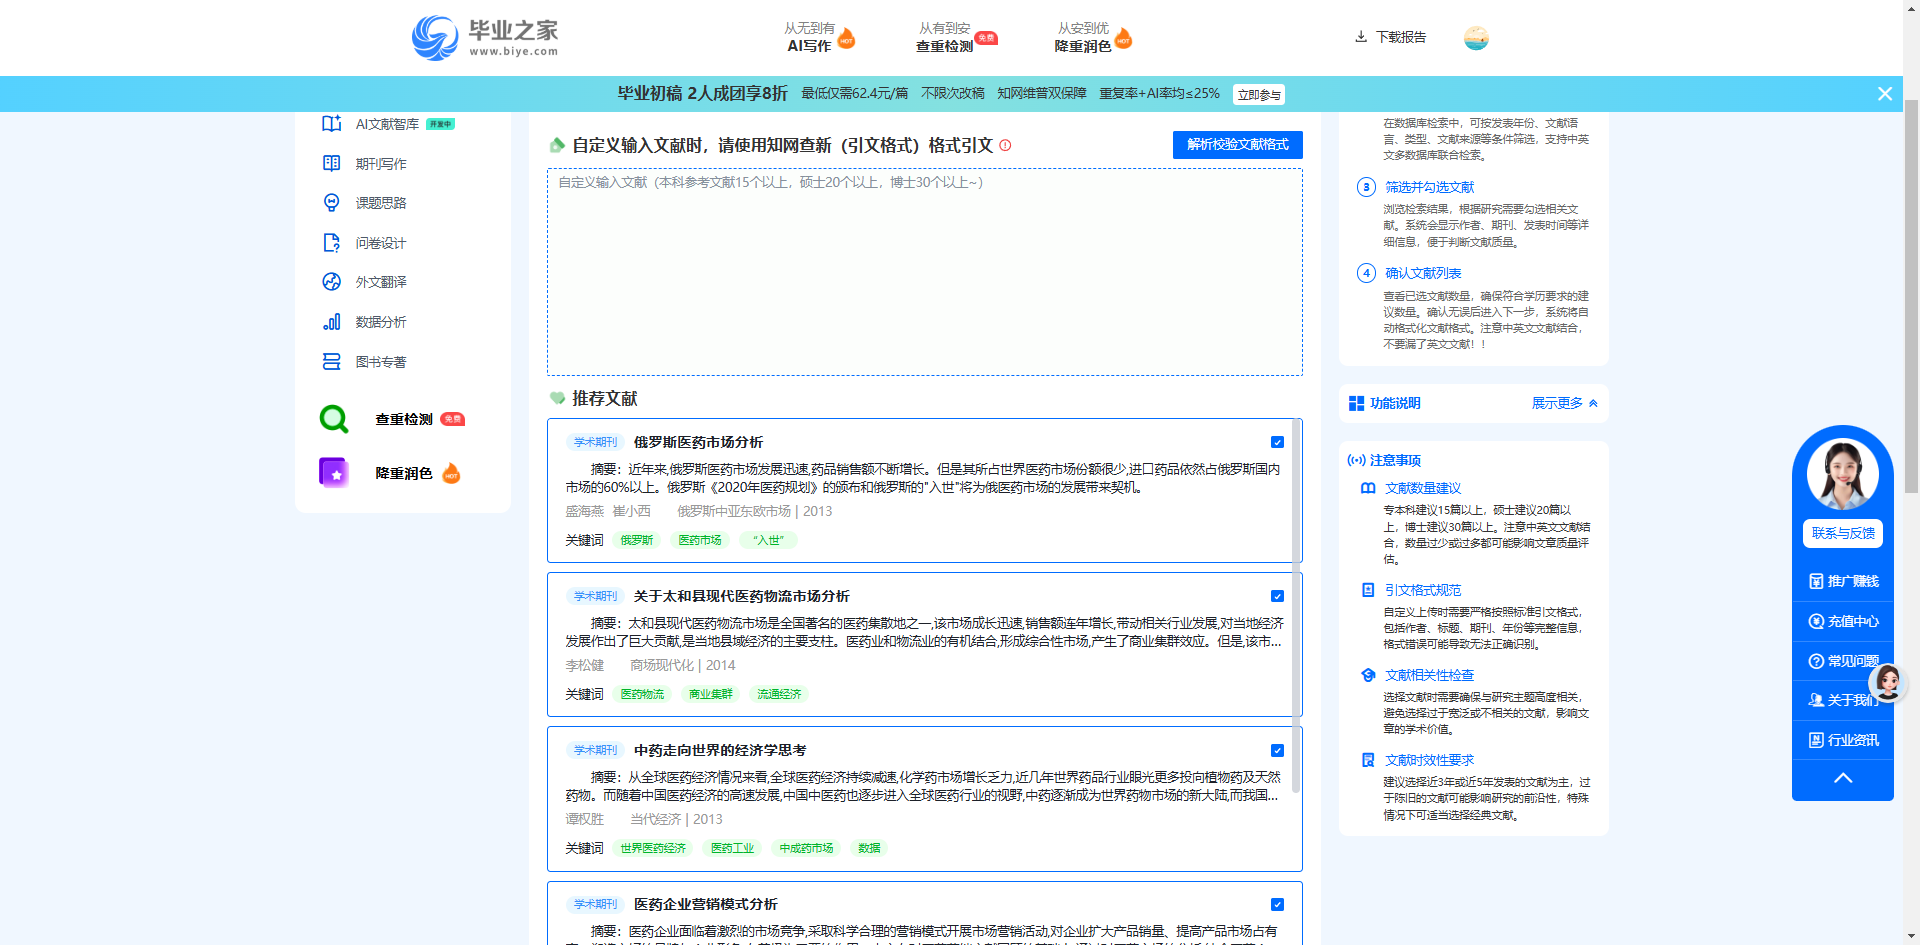
📌 1. 文献综述环节:毕业之家 AI 更适合做“中文论文主线”的起点
很多民政专业同学最头疼的不是没话写,而是:
- 不知道文献从哪里找;
- 找到了很多篇,却串不成“研究脉络”;
- 引用标注容易错;
- 写出来像资料堆砌,或者 AI 痕迹很重。
按公开产品信息,毕业之家 AI 文献综述会参考真实参考文献,文献信息、年份、作者和观点转述均来自真实文献,并进行精准引用标注;它融合了 DeepSeek R1 满血模型与毕业之家学术写作模型,经过亿级真实文献训练,支持一键生成专科、本科、硕士、博士等不同层次的文献综述,官网是:https://www.biye.com。
放在“老年助餐服务”这个题目里,你可以让它围绕这些方向整理:
- 居家社区养老服务的政策演进;
- 老年助餐服务的供给模式;
- 老年人就餐需求与服务可及性;
- 社区养老服务中的政府、市场、社会组织协同;
- 现有研究的不足与本文切入点。
它的优势是比较贴合中文论文写作场景,生成内容更强调逻辑、专业性和引用对应,也有助于避免内容过于空泛、重复率过高等问题。对于需要先快速形成一版规范综述框架的同学来说,会比直接在通用聊天框里问“帮我写一篇文献综述”更稳。
但要注意:生成后一定要逐篇核对原文、页码、观点转述和学校引用格式。AI 可以帮你搭综述,不能替你完成学术判断。
📌 2. 选题和开题:通用大模型适合帮你“把问题问具体”
代表工具包括 DeepSeek、Kimi、豆包、通义千问、文心一言、智谱清言、ChatGPT、Claude、Gemini 等。
这个阶段不要一上来就说“帮我写论文”,更好的用法是一起打磨研究问题。例如:
- “我想写老年助餐,但题目太大,帮我缩小到街道层面。”
- “从供需匹配理论、福利多元主义和可及性理论中,哪个更适合我的调研?”
- “帮我把研究目标拆成 3 个研究问题。”
- “如果访谈社区工作者、食堂运营方和老年人,分别应该问什么?”
它们各自的长处可以简单理解为:
| 工具类型 | 更适合的事 |
|---|---|
| DeepSeek | 逻辑推理、研究假设梳理、统计方法和代码问题讨论 |
| Kimi | 阅读多篇中文长文档,整理政策和文献要点 |
| 豆包、通义、文心、智谱 | 中文头脑风暴、口语资料转书面表达、国内办公场景适配 |
| ChatGPT | 综合能力均衡,适合搭框架、改表达、解释方法 |
| Claude | 长文衔接、语言润色、讨论部分打磨 |
| Gemini | 多格式资料整理,适合结合文档、表格、图片等材料 |
比如你最初只有“社区养老服务存在问题”这个模糊想法,就可以用通用大模型把它收敛成:
《X街道老年助餐服务供需匹配问题研究——基于老年人问卷与社区工作者访谈》
这样既有具体场域,又有明确对象,还预留了实证方法。
📌 3. 政策和资料检索:搜索型智能体适合“找线索”,但必须回到官方原文
写民政类论文,政策文件非常关键。可以使用 Perplexity、秘塔 AI 搜索,以及具备联网检索能力的大模型或智能体,先快速了解:
- 国家层面关于养老服务体系、老年助餐行动的政策;
- 本省、本市、本区的补贴标准和实施办法;
- 街道或社区公开的服务点、收费、运营方式。
但这类工具给出的内容只能当“线索”。正式写作时,一定要回到:
- 中国政府网、民政部官网;
- 地方政府、民政局、街道办官网;
- 正式发布的政策 PDF 或公告;
- 统计年鉴、民政事业发展统计公报等。
⚠️ 特别提醒:政策可能更新,AI 搜索结果可能引用旧版本,也可能把不同地区的补贴标准混在一起。涉及金额、年龄条件、补贴对象、服务时间等信息时,必须以官方最新文件为准。
📌 4. 英文文献和实证研究:专业科研 AI 更适合当“文献助理”
如果学校要求参考外文文献,或者你想借鉴国外社区养老、营养服务、长期照护经验,可以使用:
- Consensus、Elicit:适合查找实证研究,整理研究方法、样本、结论和局限;
- SciSpace:适合解释英文论文中的复杂段落、研究设计和概念;
- ResearchRabbit、Connected Papers:适合从一篇核心文献出发,追踪作者、关键词和研究网络;
- NotebookLM:适合基于你自己上传的论文、课件、访谈稿做限定资料问答。
例如,你可以用它们查找:
- community-based elderly care;
- meal delivery services for older adults;
- aging in place;
- social care service accessibility;
- food insecurity among older people。
这些工具的长处是找英文资料快、便于比较研究设计;但边界也很明显:它们不能替代原文阅读,尤其不能把不同国家制度背景下的结论直接搬到中国街道场景里。国外经验可以作为参考,本土化分析还得靠你自己。
📌 5. 问卷、访谈和数据处理:AI 是“分析助手”,不是“数据编造者”
假设你回收了 186 份老年人问卷,访谈了 3 位社区工作者、2 位助餐点运营人员和 8 位老人。这时可以分三类处理:
问卷数据方面,可以用 DeepSeek、ChatGPT 等辅助:
- 设计 Excel 或 Python 数据清洗思路;
- 解释频数、交叉分析、卡方检验或 Logistic 回归是否合适;
- 生成可视化代码;
- 帮你检查“年龄—就餐频率”“居住方式—配送需求”之间的分析表述。
访谈资料方面,可以用 Kimi、NotebookLM 或通用大模型:
- 把访谈记录整理成初始编码;
- 提取“价格敏感”“行动不便”“菜品偏软”“怕麻烦子女”等主题;
- 比较老年人、社区工作者和运营方的不同说法。
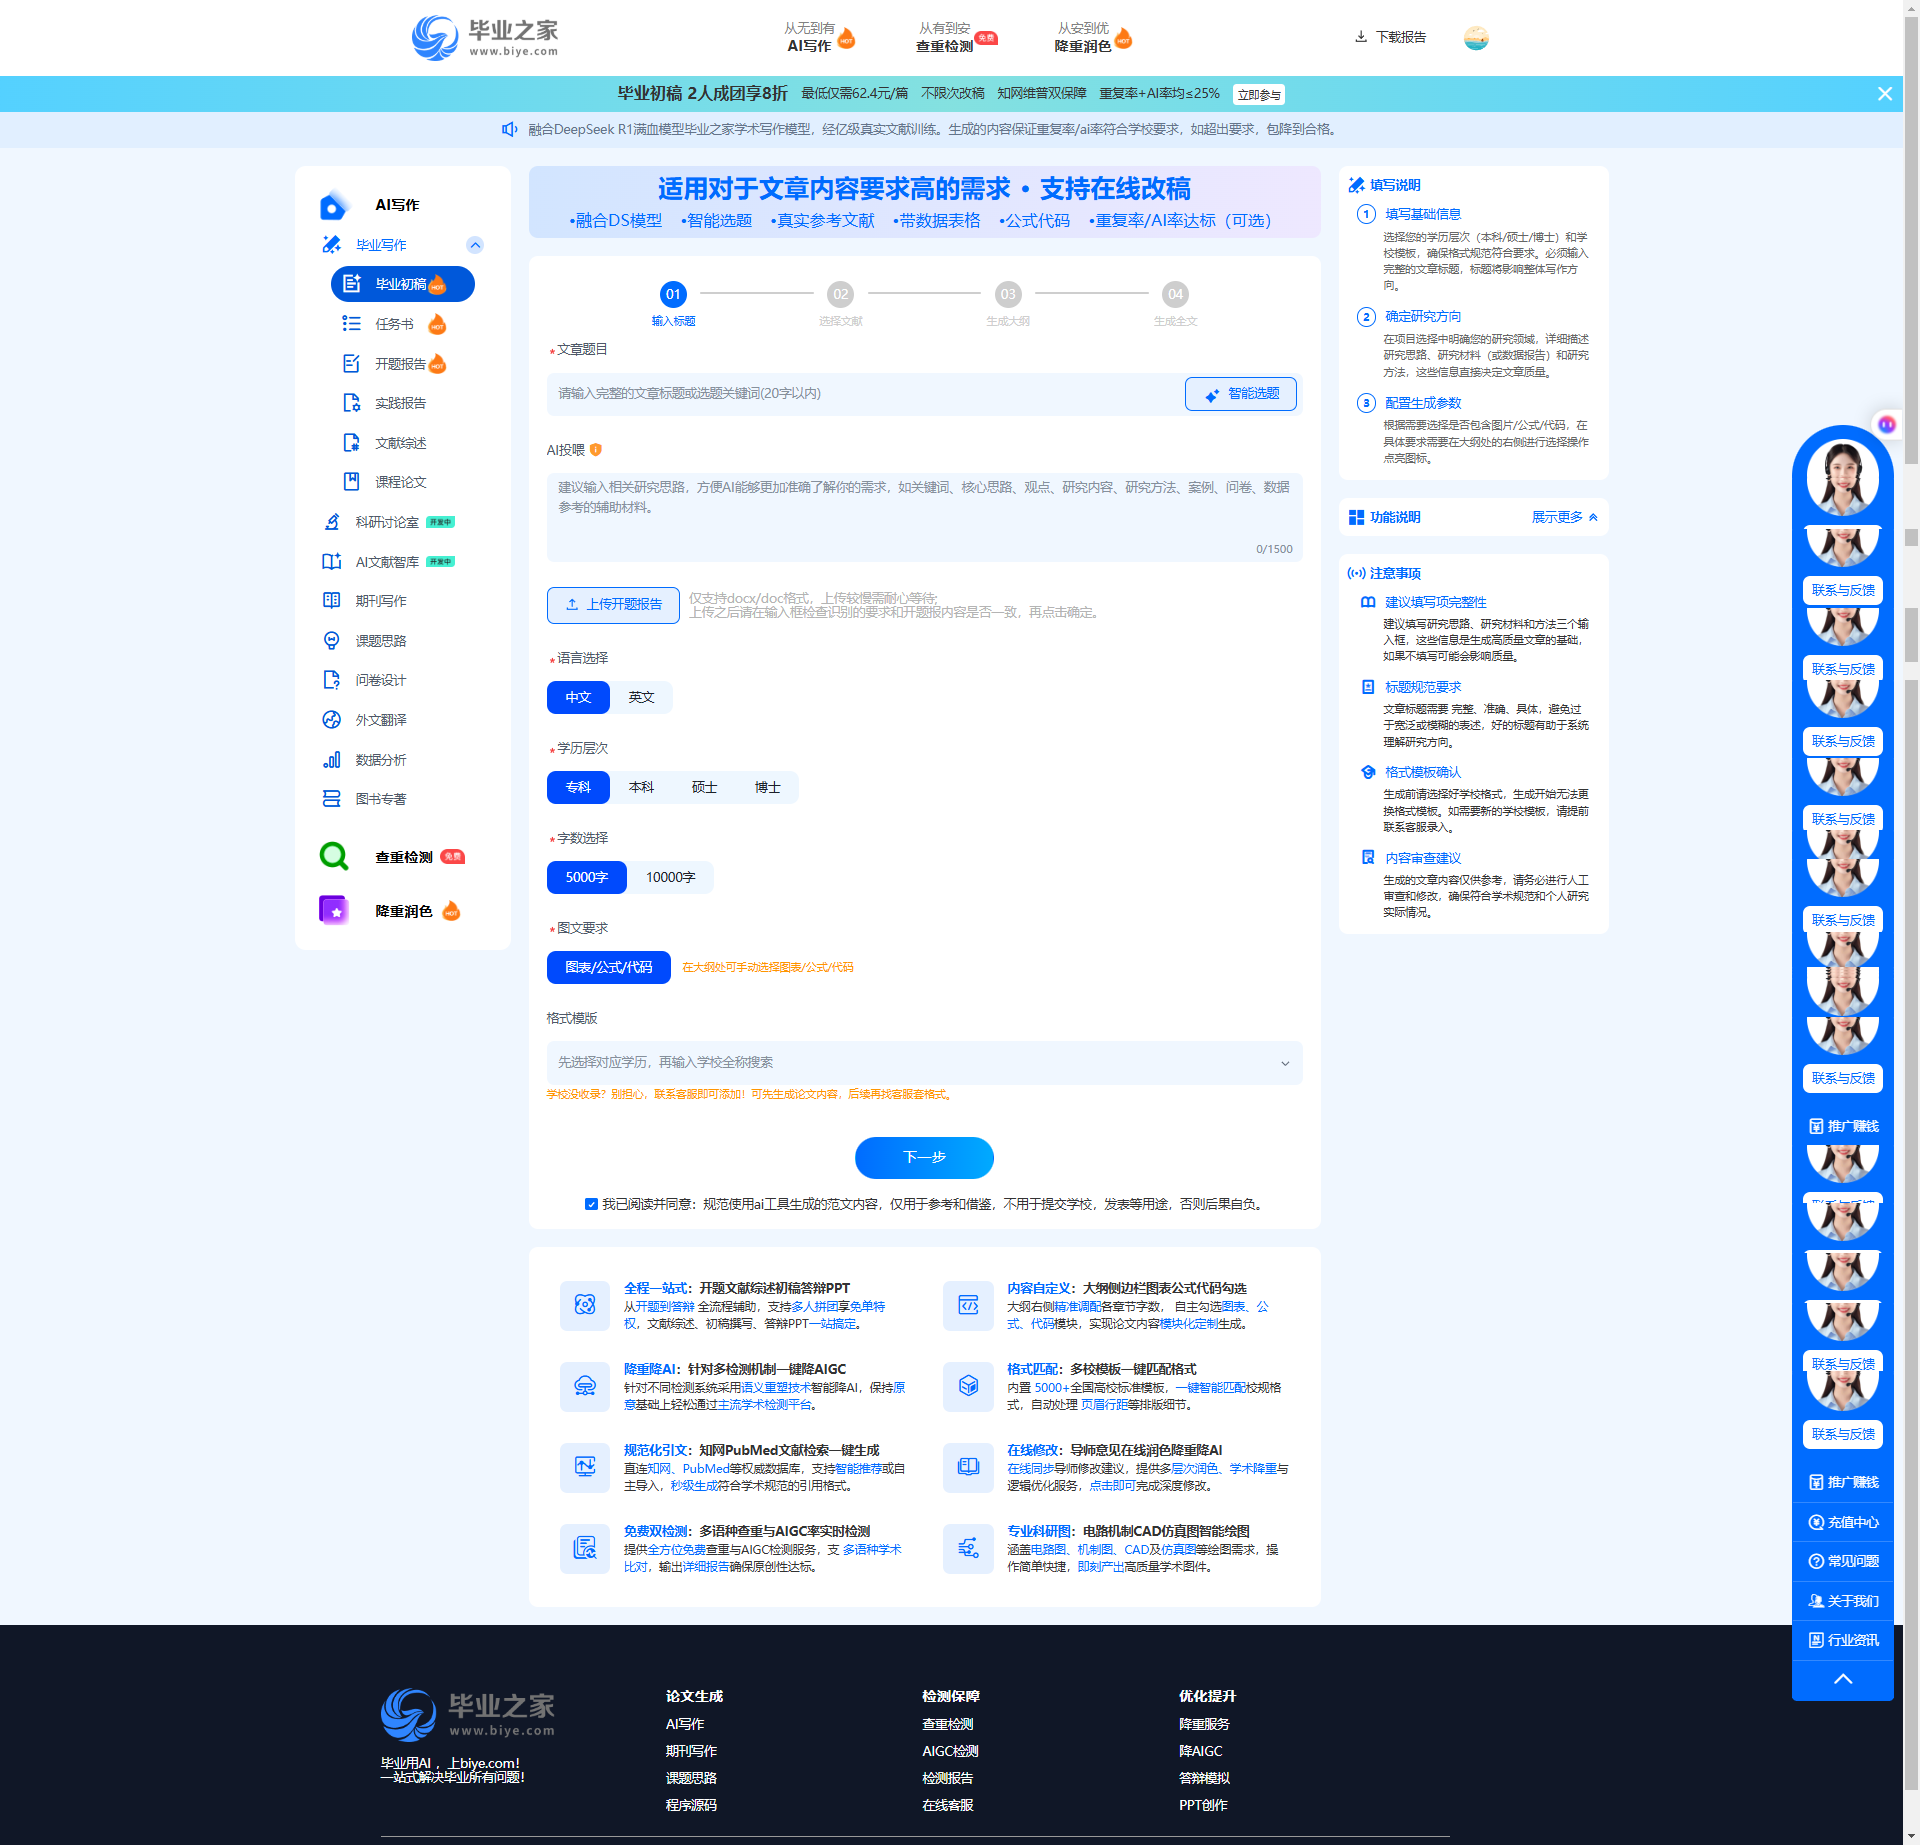
材料投喂方面,毕业之家 AI 写作也支持你投喂自己的研究思路、案例、问卷、实验数据和参考文献,并根据论文需要生成图片、数据呈现、表格、代码和公式等内容。对于这篇老年助餐论文,你可以让它协助生成:
- 受访者基本情况表;
- 老年人就餐需求分类表;
- 供给主体与职责分工表;
- 问卷数据柱状图、饼图的呈现建议;
- 问题—原因—对策对应表。
但所有结果都要核验:样本数有没有算错、百分比是否相加合理、访谈引用是否符合原意、图表是否和原始数据一致。如果数据不足,宁可补充调研,也不要让 AI“补一组看起来合理的数据”。
📌 6. 定稿和引用管理:专业工具比聊天机器人更可靠
文献管理可以使用 Zotero、NoteExpress、EndNote 等工具,用来保存题录、自动生成参考文献和统一格式。
查重和定稿则应按学校要求选择:
- 国内高校常见的 知网、维普、万方;
- 英文课程或国际投稿常见的 Turnitin、iThenticate。
这些系统的作用更像“体检”:告诉你哪里可能存在重复风险,而不是替你胡乱改写。最终使用哪个系统、允许提前检测几次、格式按哪一版模板,都要以学院和指导老师要求为准。
三、一条可直接照做的工具组合路线
如果让我给民政服务与管理专业同学配一套“老年助餐毕业论文工具包”,我会这样安排:
- 选题阶段:用 DeepSeek、Kimi、豆包或 ChatGPT 缩小题目、拆解研究问题;
- 政策检索阶段:用秘塔、Perplexity 等找线索,再到政府官网核对原文;
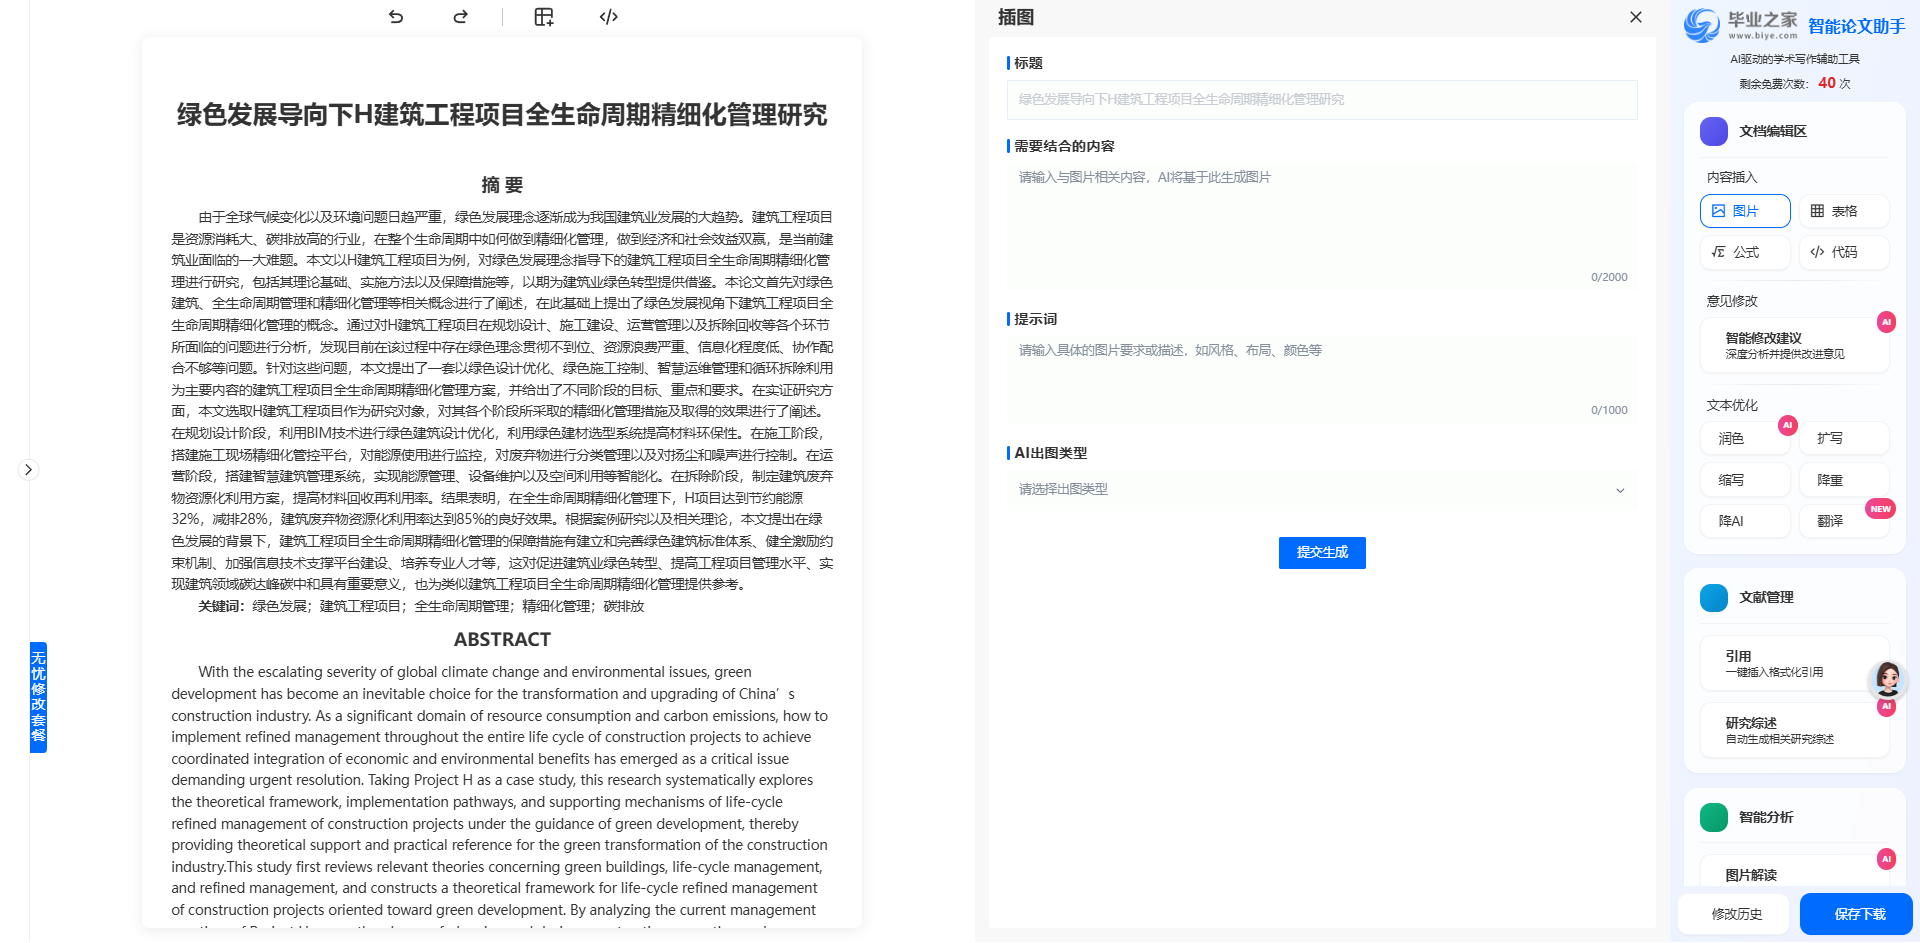
- 中文文献综述阶段:优先用毕业之家 AI 生成真实文献支撑的综述框架,再逐篇核对;
- 英文文献阶段:用 Consensus、Elicit、ResearchRabbit 补充国际研究和文献网络;
- 调研资料阶段:用 NotebookLM、Kimi 整理访谈,用 DeepSeek 或 ChatGPT 辅助统计和代码;
- 成文润色阶段:用 Claude、ChatGPT 等优化章节衔接和表达;
- 定稿阶段:用 Zotero 等管理引用,按学校指定系统完成查重和格式检查。
四、使用 AI 写论文,这几条底线一定要守住 ✅
- 不把 AI 当成作者:它是辅助工具,选题判断、调研伦理和结论由你负责;
- 不投喂敏感个人信息:老人姓名、电话、住址、身份证号、健康状况等要脱敏;
- 不直接复制生成内容:尤其是文献观点、政策条文和统计数据,必须回源核验;
- 不让 AI 编造访谈和数据:没有调研到的内容,不能写成“实地发现”;
- 不迷信 AI 率和重复率:工具只能降低风险,最终标准以学校检测和老师意见为准;
- 不忽视专业场景:民政论文讲究政策依据、基层实际和人文关怀,建议不能只写“加强管理、提高重视”这种空话。
最后一句真心话
如果只问“学术写作 AI 排行榜第一名是谁”,答案其实会跑偏;但如果问的是:
我要写一篇民政服务与管理专业的社区养老助餐毕业论文,哪个阶段该用谁?
那选择就清楚了:毕业之家适合作为中文文献综述和学术写作的重要辅助,通用大模型适合开题、推理和润色,科研检索工具适合扩展文献,文献管理和学校指定查重系统负责最后的规范把关。
工具越强,越要把“核验”两个字记在心里。AI 可以帮你更快走到材料深处,但真正让论文站住脚的,还是你有没有走进街道、社区和老年人的真实生活。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 0
 0
- 0


 已为社区贡献57条内容

所有评论(0)