DeepSeek V4.1 Flash · Step 5 · MiMo V2.6 Pro/Flash,一套自编考卷,四家官网 chat 各跑三遍
摘要:本文用一套 9 道可验算的硬题,对 DeepSeek V4.1 Flash、Step 5、MiMo V2.6 Pro 和 MiMo V2.6 Flash 四款免费档大模型做了同台裸考实测。结论是:答案对错层面四家基本打平,所有翻车事故都集中在同一道矛盾检测题上;真正的差距在速度和稳定性——MiMo 深度惊人但思考动辄十几分钟,DeepSeek 则全程零错误、零崩溃、零等待。作者最终选择无脑 DeepSeek,并指出免费档网页端在深度、速度、稳定三者中顶多给你两样。
DeepSeek MiMo Step免费档同台实测:答案几乎全对,翻车全在同一道题
到处都在晒 MiMo V2.6 的跑分,夸上天的说法满天飞。但跑分表不会告诉你两件事:它答一道题要想多久,以及它什么时候会当场宕掉。
所以我自己出了一套考卷:9 道题(8 道正题 + 1 道加考),全是能一步步验算的硬题。范围覆盖最坏情况穷举、约束求解、四步溶液混合、矛盾检测、链式计算、Agent 任务规划、时钟陷阱,外加一道带 6 条硬约束的编码题。
考生四位:DeepSeek V4.1 Flash、Step 5、MiMo V2.6 Pro、MiMo V2.6 Flash。全拉到各自官网 chat 里同台,不开联网、不调工具、纯裸考,多数题目同题重复三遍测稳定性。
先说结论,省得你往下翻:
- 答案对错层面,四家基本打平——除了 MiMo Flash 在一道简单题上摔了一跤;
- 所有的事故,全集中在同一道题上;
- 深度、速度、稳定,免费档顶多给你两样。我的选择是:无脑 DeepSeek。
下面按顺序讲。
一、考官先翻车:我的标准答案先错了
这套考卷戏剧性的一幕,发生在判卷环节,跟考生无关。
第 2 题是道约束求解题:四块花田,规则给了对角守恒(左上=右下,右上=左下)、相邻差值≤7、总量 100,已知红色 28 朵,问黄蓝绿各多少。
我出题时的设计意图是陷阱题:标准答案给了 3 组解,考模型会不会漏解。
结果 DeepSeek 三跑全答"黄=蓝=22,唯一解",还主动写了唯一性证明。我按答案键判它错,直到我重新读题才发现:规则 1 白纸黑字写了"右上=左下",这条规则直接强制黄=蓝,再由总量锁定 22。唯一解,模型是对的,我的标准答案是错的。出题的时候我只执行了自己规则的前一半,把后一半忘了。
处理方式很直接:改题面(删掉"右上=左下"),作为加考题让四家重考。结果四家全给出了完整的 3 组解。
这件事真正触动我的一点是:旧题面下四家都顶住"答案键预期多解"的陷阱答了唯一解,新题面删掉规则后它们又都正确枚举出 3 组。题面一变,答案跟着变。它们是真在读题推理,不是在背题库。连考官都会翻车,这正是独立实测存在的理由。
二、成绩单:对错层面,四家基本打平
9 个计分单元,先看总表(✅ 表示该题全部跑次正确):
| 计分单元 | DS V4.1 Flash | Step 5 | MiMo Pro | MiMo Flash |
| Q1 最坏情况穷举 | ✅×3 | ✅×3 | ✅×3 | ⚠️ 2/3,1 跑错 |
| Q2 约束求解(原版) | ✅×3 | ✅×3 | ✅×3 | ✅×3 |
| Q3 四步溶液混合 | ✅ | ✅ | ✅ | ✅ |
| Q4 矛盾检测 | ✅×3 | ⚠️ 1 崩 | ⚠️ 2 崩 | ⚠️ 1 次被放弃 |
| Q5 链式计算 | ✅ | ✅ | ✅ | ✅ |
| Q6 Agent 规划 | ✅×2 | ✅×2 | ✅×2 | ✅×2 |
| Q7 时钟陷阱 | ✅ | ✅ | ✅ | ✅ |
| Q8 编码 6 硬约束 | ✅×2 | ✅×2 | ✅×2 | ✅×2 |
| 加考(修正版 Q2) | ✅×3 | ✅×3 | ✅×3 | ✅×3 |
几道题的成色说明一下:
- Q3 溶液混合是全卷计算量的重头戏:四步倾倒、每步要算转移的盐量,最后 A 瓶 230ml/20.82%、B 瓶 500ml/14.08%、C 瓶 270ml/22.86%,Step 和 MiMo 两档还主动做了"总盐量 180 克守恒"的校验(DeepSeek 没做这步,直接交了答案)。更意外的是,四家全都在开头指出了同一处题面瑕疵:题目给的是体积、要的是质量百分比,缺密度数据,严格来说算不出来,然后声明按密度 1g/ml 的常规假设解题。免费档模型开始反过来审题面了。
- Q1 那一跤是全卷仅有的一次真实推理错误,MiMo Flash 第三跑答了 28(正确 29)。事后拆解:它的推理框架本身没错,但枚举失败集合时把两种情形里"跟条件无关的西瓜糖"漏算了一遍,同一个失误一张卷里犯两次,最大失败集合被算成 27,答案差 1。同一家族的 Pro 三跑全对,Flash 自己前两跑也对。智力够用,仔细度断了弦。
- 顺便说个四家里只有 MiMo Flash 抓到的细节:Q3 题面说 B 瓶 500ml,第一步倒 100ml 进去就变 600ml——如果 500ml 指瓶子容量,这瓶水早溢出来了。它指出题面的 ml 只能理解为"初始装液量"。挑刺能力这块,四家谁都不缺。
到这里,如果你只想知道"谁聪明",答案已经出来了:都够聪明,跑分焦虑可以放下了。真正拉开差距的,在下面。
三、所有的翻车,全在同一道题上
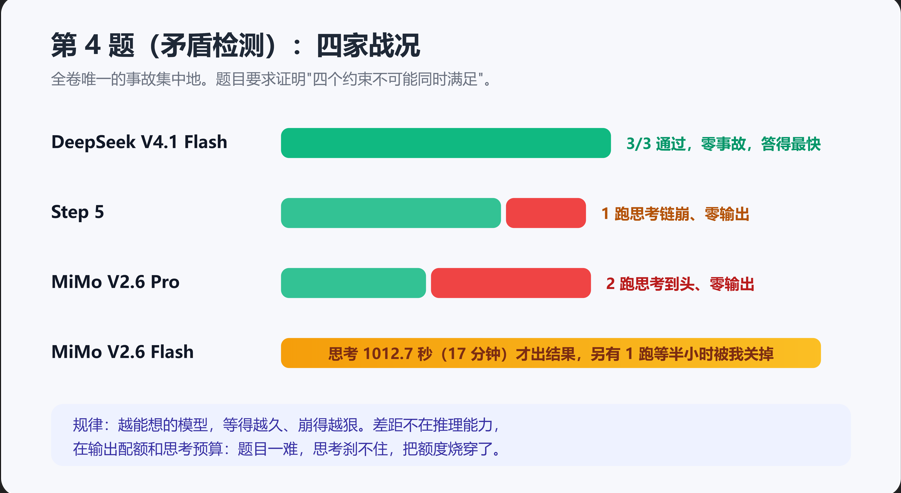
第 4 题是全卷最狠的一道:写个函数找出列表里出现次数为奇数的元素,但禁止用任何额外数据结构、时间 O(n)、空间 O(1),然后问:这些要求能同时满足吗?
标准答案:不能,而且要给出证明。
这道题是照着"矛盾检测"设计的,结果它成了照妖镜,只是照出来的不是智力:
| 第 4 题战况 | |
| DS V4.1 Flash | 3 跑全过,零事故 |
| Step 5 | 1 跑思考链崩掉、零输出;另 2 跑满分 |
| MiMo Pro | 2 跑思考到最后、正文一个字没出来;仅有的成功一跑是全场天花板答卷 |
| MiMo Flash | 1 跑思考半小时没结果,被我手动关掉;出结果的两次,一次思考了 1012.7 秒——17 分钟 |
注意一个反直觉的规律:越是能想的模型,崩得越狠。 MiMo 家族在成功状态下交出了比别家深一档的证明:Pro 用了通信复杂度的下界论证,Flash 用了自动机状态计数,都到了教科书水准;DS 的证明偏浅,给的是反例加直觉论证,但它三跑全过、总共没让你等超过一分钟。
差距出在输出配额和思考预算上:题目一难,思考就刹不住,跑着跑着把输出额度烧穿了。免费档网页端的真实短板在这儿,不在脑子上。
四、速度:流畅本身就是优势
这一节没有跑分,只有体感,但恰恰是它决定了我的选择。
四家答完 9 道题,体感差距是这样的:DeepSeek 快得多,Step 中等,MiMo 两档都慢,Flash 略好于 Pro,但也只是"从绝望变成煎熬"。
夸张的一次等 MiMo:屏幕上"思考中"滚了 17 分钟才吐出答案。我可以负责任地说,任何真实使用场景里,我早在第 3 分钟就关掉页面了。事实上那次测试里就有一跑是等我失去耐心手动掐掉的。
这里必须说句公道话:MiMo 的深度是真的。同样的第 4 题,DS 给的是"能用"的证明,MiMo 给的是"能发表"的证明。问题在于,我付不起那个时间。
五、各家的小怪相:错都错得很有性格
多跑测试的好处是能抓到跑分表从不展示的一面:
- Step 5:有一跑它没解题,反过来把我给的材料当成了"用户提交的答案",开局一句"你的推理是正确的,我复核一遍",审稿人上身。另一跑开局自称"作为 StepFun 的模型,我无法真正操作您的电脑"。诚实,但全卷就它一个这么开场。
- MiMo Pro:有一跑把整份答案原样输出了两遍,复读机式 glitch。
- MiMo Flash:除了 Q1 那次失误,还贡献了一处把细节抠到秒的加分:Q7 时钟题算完 7.5° 之后,顺手把时针分针"真正重合"的时刻也算了出来:约 3 点 16 分 22 秒。我验了,对的。
- DS:没有怪相。它的缺点是证明给得浅、答案写得啰嗦,仅此而已。
六、我的结论:免费档三选二,我选快和稳
9 道题、四家、七十多轮作答跑下来,我的总结是一句话:
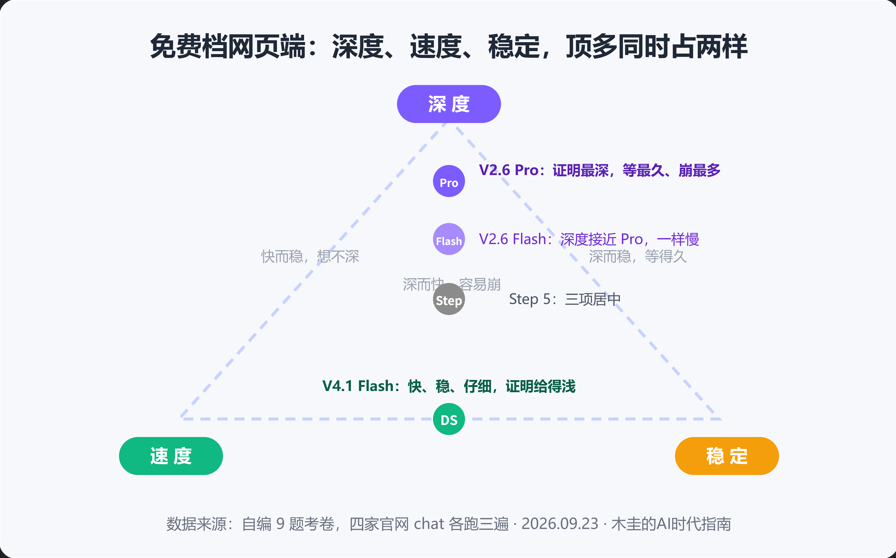
深度、速度、稳定,免费档网页端顶多给你两样。
- MiMo Pro/Flash:深度天花板 + 稳定性中等,代价是速度慢到影响可用性。适合不赶时间的研究场景,不适合当日常主力。
- Step 5:三项居中,证明能力意外地硬,但没有一项顶到头。
- DS V4.1 Flash:深度偏浅,但速度、稳定、仔细度全占:全卷零错误、零崩溃、零等待。
所以我的答案很明确:在结果没问题的情况下,我无脑选 DeepSeek。整个过程太流畅、太舒服,这种"问完就有人接话"的体验用过就回不去。也认真考虑过费用:DeepSeek 的 API 价格摆在那儿,说实话它并没有贵到让我愿意用 MiMo 那种等待时间去换的程度。为了一段 17 分钟的更优雅证明等 17 分钟,这笔账怎么算都不划算。
跑分表会告诉你谁的分高,只有自己出一套题跑一遍,才会告诉你谁用着舒服。整套考卷我发成了公开网页,不服的自取测试:免费档大模型同台实测 · 自编考卷(9 题) 。毕竟连我的标准答案都翻过车,这可能是整场测试里的头号彩蛋。
测试口径:2026-09-23,四家官网 chat 网页端实测(非 API),关闭联网与工具,每题新对话、多数题目同题重复三遍测稳定性;MiMo 以公测期 V2.6 Pro 为主力、V2.6 Flash 补测,均为公测期免费可用版本。公测期版本随时可能灰度切换,结论有时效性。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)