OpenAI深夜扔出王炸:GPT-6 Sol与Luna登场,API价格直接腰斩,Claude被正面狙击
凌晨的AI圈又被一颗重磅炸弹惊醒。就在Anthropic发布新旗舰不到九十分钟后,OpenAI反手打出了一套组合拳——GPT-6 Sol和GPT-6 Luna正式亮相。这不是简单的型号迭代,而是一场精心策划的突袭:把旗舰GPT-6 Astra身上最值钱的能力,塞进两个更快、更便宜的模型里,同时把API价格砍到上一代促销价的一半。
距离GPT-6 Astra发布还不到三周,OpenAI便火速补齐了产品线的腰部和底座。官方口径很明确:Astra依然是处理最难、最重要任务的"顶格选项",但如果你想要的是日常高频调用、可规模化的智能体验,Sol和Luna才是更务实的选择。Solar与Lunar,日月同辉,名字起得颇有几分寓意——一个主攻专业与复杂,一个主打轻快与普惠。
价格砍半,成本红利直接喂到嘴边
这次发布最让开发者心跳加速的,毫无疑问是定价。GPT-6 Sol的API价格降至每百万Token输入2美元、输出10美元;GPT-6 Luna更是低至输入0.1美元、输出0.5美元,两项均较GPT-5.6的促销价下调50%。OpenAI还顺手优化了提示缓存机制,默认提供更高的缓存命中率,缓存读取折扣力度加大,让重复上下文能被智能复用——响应更快,账单更薄。
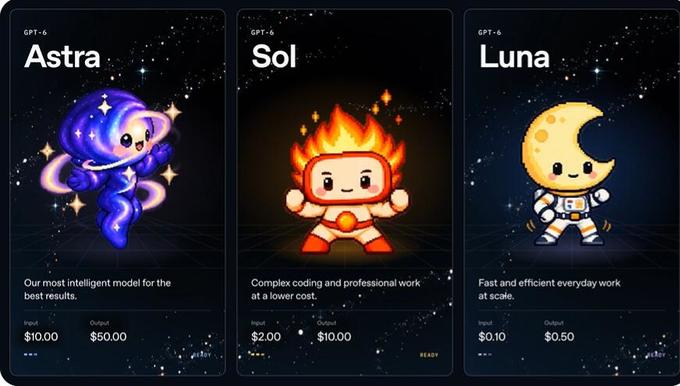
对中小企业和独立开发者来说,这意味着什么?过去跑不起的智能体工作流,现在同样的预算能翻着倍地跑。单位Token成本每降一档,AI能渗透的场景就宽一圈。OpenAI把缓存与推理效率提升省下的钱,几乎全额让利给了用户,这一手在竞争白热化的大模型市场里,杀伤力不容小觑。
基准测试成绩单:用对手六分之一的成本赢
数字不会说谎。在AutomationBench跨应用业务流程测试中,GPT-6 Sol在高强度设置下的表现压过了Claude Opus 5,单项任务成本仅高出9%;而在"智能体最后的考试"(Agents' Last Exam)里,Sol拿下了56.4%的分数,超越Claude Opus 5的最高纪录,任务成本却低出60%。
编程能力更是Sol的主场。DeepSWE v1.1软件工程测试中,Sol交出了68.8%的成绩,距离最高分只差1.1个百分点,而单项任务成本骤降约80%。Luna的表现同样可圈可点,性能摸到竞品中档水平,成本优势却相当突出。计算机操作方面,OSWorld 2.0离线测试里Sol以约80%的成本优势追平对手中端档位,Luna则直接超越上一代旗舰,成本却只有后者的十分之一。
不止跑分,"说话方式"也换了
鲜少有人注意到的一个细节是:Sol和Luna继承了改进版GPT-6 Astra的沟通风格。在技术和编程对话中,它们明显更简洁清晰,堆砌术语、输出低价值废话的毛病收敛了不少。事实可靠性上,在匿名化的真实对话评测里,Sol的错误率约为上一代的一半,已经接近Astra的可靠性水准;Luna的进步同样显著。对齐方面也有实打实的改进——在编码任务中,误导性语句的出现频率明显下降,模型"胡说八道"的冲动被摁住了不少。
现在就能用,普通聊天还要再等等
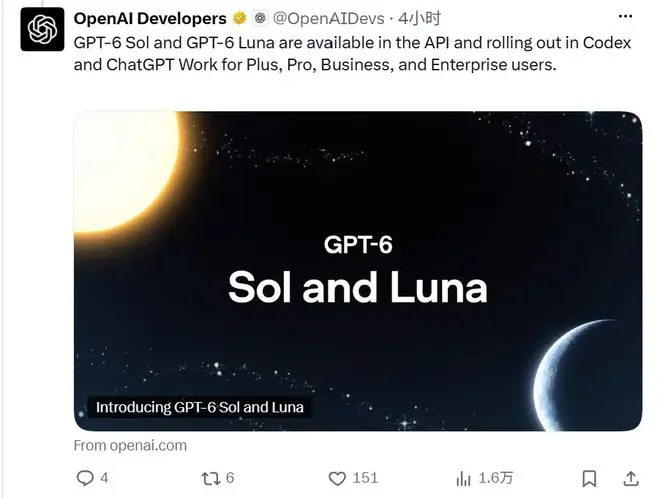
落地节奏上,OpenAI这次没有玩"期货"。GPT-6 Sol和GPT-6 Luna已在ChatGPT Work和Codex中全面上线,Plus、Pro、Business、Enterprise和Edu用户即刻可用;API中以gpt-6-sol和gpt-6-luna两个模型ID开放调用;免费用户和Go用户也能在桌面端应用里用上Luna。唯一的小遗憾是,两款模型暂时还未向普通ChatGPT聊天界面全量推送,官方表示会在全天范围内逐步放开,以保证服务稳定。
回头再看这盘棋,OpenAI的意图已经昭然若揭:Astra负责把能力边界推到极限,Sol和Luna负责把这份能力以可负担的价格送进千家万户的工作流。旗舰立标杆,走量赢市场——这场大模型的价格战,显然才刚刚进入真正的白热化阶段。对于观望已久的开发者和企业而言,眼下或许正是重新评估AI预算、把智能体流水线跑起来的最好窗口期。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)