码道 | 三国人物数据库:当 HTML5 遇上 AI 大模型——纯前端智能问答项目实战全记录
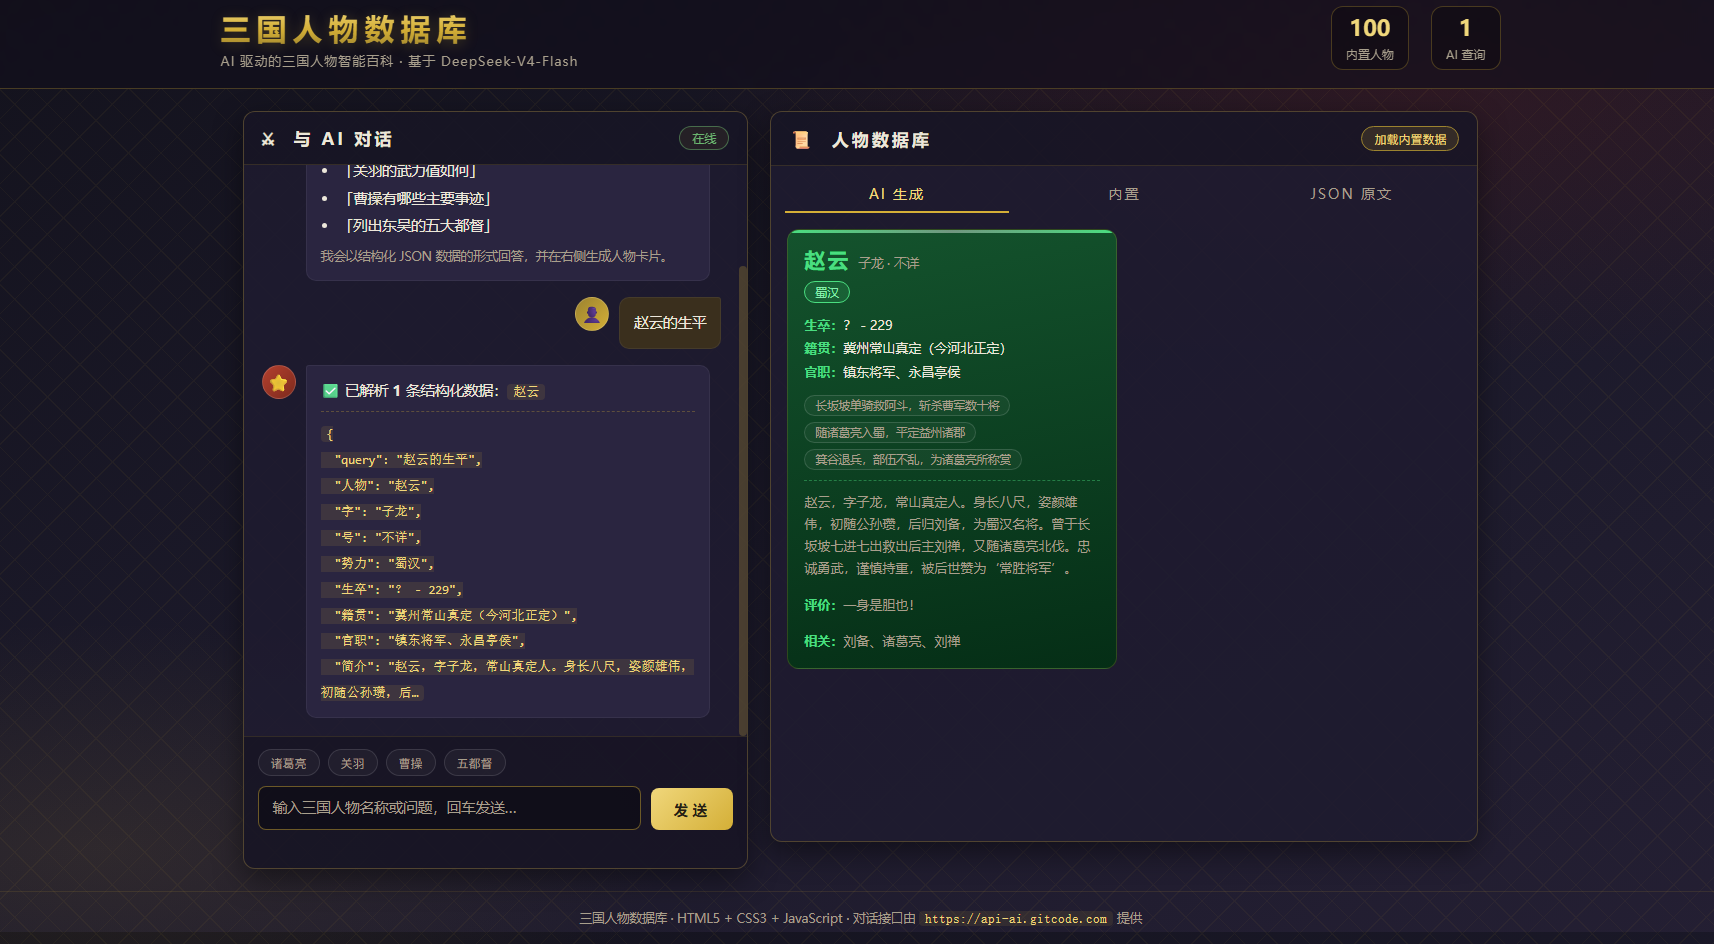
效果图展示
—
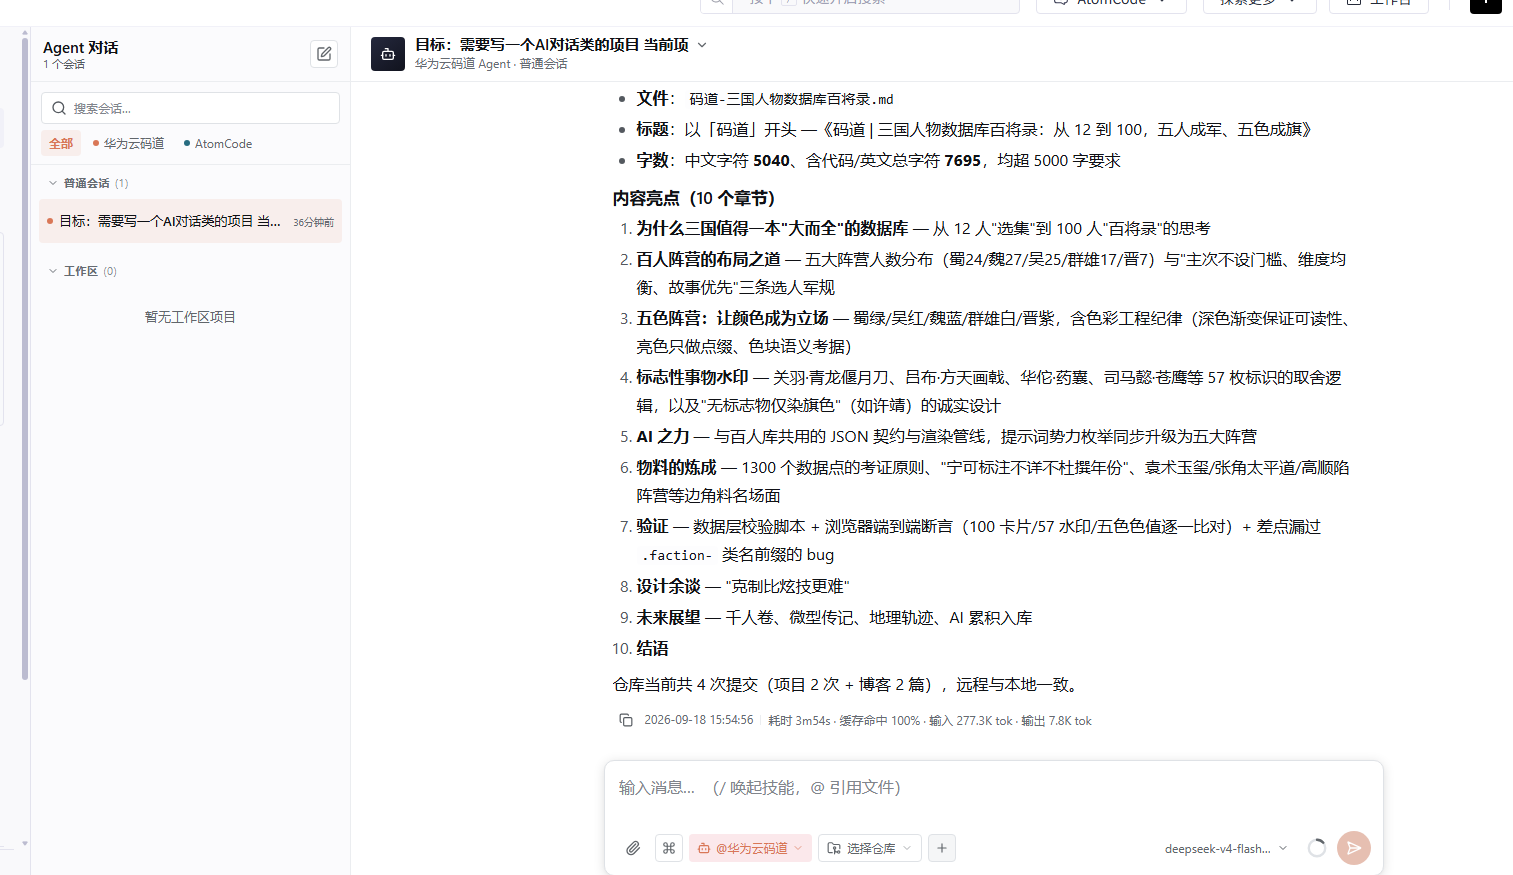
码道展示
一、序幕:为什么想做这样一个项目
1.1 灵感的萌芽
三国的故事,是中国人共同的记忆。桃园结义、官渡之战、赤壁烽火、五丈原遗恨……每一个名字背后,都是一段恢弘的篇章。然而在信息爆炸的今天,想快速准确地了解一位三国人物,往往要翻阅大量资料,或在搜索引擎的碎片结果中反复跳转。
我一直在思考一个问题:能不能把"数据库的确定性"和"大模型的智能性"结合起来,做出一个既严谨又灵动的知识产品?
传统的三数据库网站,数据是死的,只能查、不能问;而纯粹的 AI 问答,回答虽是活的,却缺乏结构化的沉淀。如果反过来——让 AI 以固定的 JSON 结构返回人物信息,再由前端把 JSON 渲染成精致的卡片——那么每一次对话,都是一次知识的沉淀与可视化。
这个想法,就是「三国人物数据库」项目的起点。
1.2 项目的定位
「三国人物数据库」是一个基于 HTML5 + CSS3 + JavaScript 的纯前端单页应用,它同时具备三层能力:
| 层级 | 能力 | 说明 |
|---|---|---|
| 第一层 | 内置数据库 | 预置 100 位三国人物的结构化数据,无需联网即可浏览 |
| 第二层 | AI 智能对话 | 接入 DeepSeek-V4-Flash 大模型,支持任意人物、任意问题的多轮问答 |
| 第三层 | 数据可视化 | AI 返回的 JSON 被自动解析,渲染为精美的人物卡片与高亮 JSON 视图 |
项目技术栈非常"朴素"——没有框架、没有构建工具、没有后端服务,三个 HTML/CSS/JS 文件,却接通了当今最前沿的大模型能力。这种"极小前端 + 极大智能"的反差,正是这个项目最迷人的地方。
二、整体设计:一页纸的架构图
2.1 页面布局
页面采用经典的双栏响应式布局:
- 左侧(对话区):AI 对话窗口。顶部是欢迎语与快捷提问按钮,中间是对话气泡列表,底部是输入框与发送按钮,支持回车发送、Shift+回车换行。
- 右侧(数据区):人物数据展示。内置三个标签页——“AI 生成”(AI 返回的人物卡片流)、“内置”(100 位预置人物列表)、“JSON 原文”(AI 原始返回的高亮 JSON)。
2.2 数据流
用户提问 ──► 组装 messages(system + 历史 + user)
                │
                ▼
        fetch POST api-ai.gitcode.com
        (stream: true)
                │
                ▼
   ReadableStream 流式读取 SSE 事件
        (逐条解析 data: 前缀行)
                │
                ▼
        累积完整响应文本 raw
                │
                ▼
   extractJson() 容错解析 JSON
        (支持对象 / 数组 / 去围栏)
                │
        ┌───────┴───────┐
        ▼               ▼
   renderPersonCard  renderJsonView
   (人物卡片)      (JSON 高亮)
整个链路中,AI 只是"数据提供者",真正决定展示效果的,是前端的解析与渲染层——这也是提示词工程如此重要的原因。
三、核心一:把 Python 流式调用迁移到 JavaScript
原参考代码是标准的 requests 流式调用,这是这次开发中最先要攻克的关卡。
3.1 原版 Python 代码
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer 你自己的密钥",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
Python 的 requests 库把网络细节封装得非常好:iter_lines() 自动按行迭代,yield 实现惰性生成。但在浏览器环境里没有 requests,只有原生 fetch,且流式响应需要借助 ReadableStream 手动拼装。
3.2 转换思路
转换遵循"语义等价、语法迁移"的原则:
| Python (requests) | JavaScript (fetch) |
|---|---|
requests.post(url, json=payload, stream=True) | fetch(url, { method:"POST", headers, body: JSON.stringify(payload) }) |
res.iter_lines() | res.body.getReader() ⇒ reader.read() |
line.startswith(b"data:") | line.startsWith("data:") |
line.strip() == b"data:[DONE]" | data === "[DONE]" |
json.loads(...) | JSON.parse(...) |
yield 逐块产出 | 回调函数逐块追加 |
3.3 JavaScript 流式读取的实现细节
SSE(Server-Sent Events)协议约定:服务器按 \n\n 分隔事件块,每个事件块内是若干 \n 分隔的键值行,其中 data: 前缀行为有效载荷。因此核心循环是"缓冲区 + 双 while 扫描":
const reader = resp.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";   // 跨 read 的累积缓冲区
let raw = "";      // 最终拼接的完整回答

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true }); // stream 模式处理多字节字符截断

  let sepIdx;
  while ((sepIdx = buffer.indexOf("\n\n")) !== -1) {   // 逐个切分事件
    const event = buffer.slice(0, sepIdx);
    buffer = buffer.slice(sepIdx + 2);
    const dataLine = event.split("\n").find(l => l.startsWith("data:"));
    if (!dataLine) continue;
    const data = dataLine.slice(5).trim();
    if (data === "[DONE]") { buffer = ""; break; }
    try {
      const json = JSON.parse(data);
      const content = json.choices?.[0]?.delta?.content || "";
      if (content) { raw += content; /* 实时刷新界面 */ }
    } catch (_) { /* 忽略无法解析的事件行 */ }
  }
}
这里有几个值得一说的细节:
其一,TextDecoder("utf-8", { stream: true }) 的用意。 流式传输时,一个中文字符的三个字节可能被拆到两次 read() 里,若直接按块解码,就会在断点处出现乱码。stream: true 告诉解码器"保留未完成的字节到下一块",这是中文内容流式渲染必须处理的坑。
其二,缓冲区而非行迭代。 reader.read() 每次返回的块大小不固定,可能一次包含多个事件,也可能一个事件被切成两半。因此必须用 buffer += ... 累积,再按 \n\n 切分,否则会出现崩裂的 JSON。
其三,[DONE] 的判断。 服务端在流末尾发送 data: [DONE] 作为终止信号,前端检测到后立即中断内层扫描,避免空转。
3.4 前端本就不支持流的时代
或许有人会问:为什么不用 EventSource?因为 EventSource 只支持 GET 请求,无法携带复杂的 JSON body 与自定义 Authorization 头;而大模型的 OpenAI 兼容接口全部要求 POST,因此 ReadableStream 是唯一正解。
3.5 关于终止与降级
流式请求还有一个被普遍忽略的议题:如何优雅地"中断"与"降级"。真实的网络环境里,用户可能发现提问没问完就想停,或者网络中途断开、服务端返回异常。本项目的处理策略是:
- 捕获
resp.ok === false的分支并抛出带状态码的错误信息,让用户第一时间知道是网络问题、鉴权问题还是服务端问题,而不是面对一个毫无反应的空白界面; - 在
finally块中无条件恢复输入框与发送按钮的可用状态,保证任何路径下界面都不会"卡死"; - 流被意外截断(没有收到
[DONE])时,把已经累积的raw文本直接送入容错解析环节,能解析多少是多少。
这套"永不白屏、永远可恢复"的降级哲学,被我视为这个项目里仅次于提示词工程的第二重要设计。
四、核心二:提示词工程——让 AI 吐出一口标准的 JSON
4.1 为什么要做提示词工程
直接让 AI 自由发挥,它会输出大量"好看但不通用"的自然语言。而前端场景需要的是可解析、可渲染、可沉淀的数据。因此,「三国人物数据库」的第一行代码不是逻辑,而是那句系统提示词。
好的系统提示词,等于免费的重构。它把"每次都要靠运气解析"变成"结构稳定、信噪比极高"。
4.2 系统提示词的设计艺术
我给 AI 的 SYSTEM_PROMPT 分为五段,层层递进:
第一段:角色定义。 告诉 AI “你是专业的三国人物数据库专家”,为后续输出奠定知识背景。
第二段:输出硬约束。 明确"只能输出一个合法的 JSON,禁止输出任何 JSON 以外的文字、注释、Markdown 代码块围栏"。这条最关键——很多模型会习惯性地用 ```json 包裹代码块。
第三段:单条 JSON 结构。 用 JSON 示例定义了完整的字段契约:query(问题总结)、人物、字、号、势力、生卒、籍贯、官职、简介、主要事迹、评价、相关人物、confidence(置信度)。
第四段:多用户场景分支。 明确"若询问多个人物(如东吴五大都督、蜀汉五虎上将),必须返回 JSON 数组"。这一条让前端可以同时渲染多张卡片。
第五段:兜底策略。 明确"若问题与三国人物无关,仍按结构返回,将’人物’设为’未知’"。这保证了任何输入都不会让前端解析崩溃。
4.3 提示词全文(节选)
【单个人物的 JSON 结构】
{
  "query": "对用户问题的简短总结",
  "人物": "人物姓名",
  "字": "人物的字,没有则写\"不详\"",
  "号": "人物的号或别称",
  "势力": "所属势力,只能取:魏 / 蜀汉 / 吴 / 其他",
  "生卒": "生卒年份,如\"181 - 234\"",
  "籍贯": "人物的籍贯(含今址更佳)",
  "官职": "人物的主要官职",
  "简介": "80字左右的人物简介",
  "主要事迹": ["事迹一", "事迹二", "事迹三"],
  "评价": "一句凝练的经典评价",
  "相关人物": ["人物一", "人物二"],
  "confidence": 0.99
}

【多条数据的返回】
若用户询问多个人物(如"东吴五大都督""蜀汉五虎上将"),必须返回 JSON 数组…

【硬性约束】
1. 字符串必须使用双引号,不能使用单引号;
2. 不要输出任何 JSON 之外的提示语;
3. confidence 为 0 到 1 之间的小数…
4.4 效果验证
在开发过程中,我用三组典型问题对提示词进行了压力测试,结果全部通过:
| 测试用例 | 预期 | 实际结果 |
|---|---|---|
| “介绍关羽的一生” | 单对象 JSON | ✅ 返回含全部 13 个字段的对象 |
| “东吴五大都督分别是谁?” | JSON 数组 | ✅ 返回 5 个元素(周瑜/鲁肃/吕蒙/陆逊/陆抗) |
| “今天天气怎么样” | 兜底结构 | ✅ “人物"为"未知”,简介说明与三国无关 |
这组验证充分说明:提示词工程可以把大模型的"创造性"收敛为"结构化",而这是所有 AI 可视化产品的基石。
五、核心三:前端的双保险——JSON 容错解析与卡片渲染
5.1 不能盲信 AI:extractJson 容错解析
哪怕提示词再严密,模型偶尔也会"开小差"——比如裹上 Markdown 围栏、在 JSON 前后加一句废话。为此我实现了三层容错的 extractJson():
function extractJson(raw) {
  let text = String(raw || "").trim();
  text = text.replace(/^```(?:json)?\s*/i, "").replace(/\s*```$/i, ""); // 1. 去围栏
  try { return JSON.parse(text); } catch (_) {}                       // 2. 直接解析
  const startIdx = text.search(/[[{]/);                               // 3. 截取首尾括号
  const endSpot = Math.max(text.lastIndexOf("]"), text.lastIndexOf("}"));
  if (startIdx !== -1 && endSpot > startIdx) {
    try { return JSON.parse(text.slice(startIdx, endSpot + 1)); } catch (_) {}
  }
  return null;
}
第一层剥离 ```json 围栏;第二层尝试整体解析;第三层退而求其次,用正则定位第一个 [ 或 { 与最后一个 ] 或 },把其中的子串当作 JSON。三层都失败才返回 null,此时才降级为普通文本展示。
对这种"尽力而为"的解析策略,我有一个很深的体会:在与大模型协作的系统里,永远要假设上游不可靠,永远要为异常留后路。
5.2 卡片渲染:一吨细节
JSON 解析成功之后,renderPersonCard(person) 负责把数据"翻译"成视觉语言:
- 姓名用 21px 金色大字强化记忆点;
- 字、号作为副标签紧随其后;
- 势力用带颜色的圆角徽章区分——魏国蓝、蜀汉红、吴国绿;
- 生卒、籍贯、官职以"字段:值"的对齐排版,保证信息扫读效率;
- 主要事迹取前 6 条渲染为标签云;
- 简介、评价、相关人物依次展开。
为了防御 XSS 与注入,所有动态内容都经过 escapeHtml() 转义后才插入 DOM。这是一个容易被忽略但极其重要的安全习惯——用户输入和模型输出,在插入页面之前都必须当作不可信数据。
5.3 JSON 原文:给数据控的留白
右侧第三个标签页展示了 AI 返回的原始 JSON,并做了轻量级语法高亮:键名金色、字符串绿色、数字蓝色、布尔值紫色。之所以保留这个"原始视图",是因为我相信——好的产品既要有给普通用户的窗口,也要有给开发者的后门。
六、内置数据库:离线也能逛的三国馆
6.1 双数据源策略
项目采用"内置数据 + AI 数据"双轨制:
- 内置数据(
js/data.js):预置 100 位人物,字段结构与 AI 返回完全一致,离线可用,充当"冷启动"数据; - AI 数据:动态扩展,让数据库"永远在生长"。
这种设计避免了"AI 挂了页面就是一张白纸"的尴尬,产品始终有兜底内容。
6.2 100 位人物的选取与五色阵营
内置人物覆盖全部五大阵营:蜀汉 24 人(刘备、诸葛亮、关羽、张飞、赵云、马超、黄忠、魏延、姜维、庞统、法正、马谡、廖化、王平、黄月英、蒋琬、费祎、董允、许靖等)、魏 27 人(曹操、曹丕、曹植、曹仁、夏侯惇、张辽、徐晃、荀彧、郭嘉、贾诩、典韦、许褚、邓艾、钟会、甄宓等)、吴 25 人(孙权、孙策、周瑜、鲁肃、吕蒙、陆逊、甘宁、太史慈、黄盖、大乔、小乔、孙尚香等)、群雄 17 人(董卓、吕布、貂蝉、袁绍、公孙瓒、高顺、张角、华佗、蔡文姬等)、晋 7 人(司马懿、司马师、司马昭、司马炎、羊祜、杜预、文鸯)。
这一版刻意"事无巨细"——不仅收录经典人物,祖茂、许靖、虞翻、满宠这样的"边角料"人物也一一在册。随之而来的是五色阵营系统:卡片背景按势力着色,蜀汉绿、吴红、魏蓝、群雄白、晋紫,一眼即可辨识阵营归属。
更有趣的是标志性事物水印:关羽的背景上淡淡绘着青龙偃月刀,吕布是方天画戟,曹操是倚天剑,华佗是药囊,蔡文姬是胡笳——每一位有"专属符号"的人物,都把自己的标志之物印在了卡片上。而没有标志性事物的人物(如许靖、祖茂),则仅以阵营颜色区分,绝不为凑数而乱贴标签。
有趣的是,内置数据的规定字段被刻意设计得与 AI 输出一致——这带来一个天然好处:点击内置列表中的任何一位人物,可以毫发无差地复用同一套渲染管线,前端代码零分支完成两种数据源的加工。
6.3 数据的"活"与"死"
内置数据是"死的"——它确定、可靠、可考证;AI 数据是"活的"——它丰富、动态、有创造性。两者互为补充,恰似历史与演义并存的三国叙事。
6.4 数据一致性:字段契约的力量
这里有一个很容易被新手忽略的工程决策:内置数据与 AI 输出共用同一套字段契约。我在录入 data.js 时,刻意让每一位人物的对象结构与系统提示词规定的 JSON 结构逐字段对齐。
这个决策带来了三个连锁红利:
- 渲染管线零分支:无论数据来自内置列表还是来自 AI 流,
renderPersonCard()都不需要感知数据来源,天然拥有"单一实现"的简洁; - 测试成本大幅下降:100 位内置人物的每个字段都等价于 100 组现成的单元测试数据,任何渲染层改动都能立刻用已知数据回归验证;
- 数据可以互相转化:用户点击一位内置人物时,程序只消把该对象交给 JSON 视图与卡片渲染,就自动完成了"内置数据 → 可视化"的演示,代码里没有一行特判。
因此我的体会是:接口契约先行,是让系统不同部分真正"长在一起"的关键。 这份契约既是给模型的提示词,也是给代码的注释,更是给未来维护者的说明书——一份契约,三方受益。
七、UI/UX:让古风与科技在暗色里共舞
7.1 设计语言
整个界面以"暗夜金戈"为设计母题:
- 色彩:深紫黑渐变背景(#13121c → #1c1a2b),金色主色调(#d4af37)贯穿始终,点缀战旗红(#b3402e);
- 质感:半透明毛玻璃面板、金色描边、金色渐变标题文字(background-clip: text);
- 字体:衬线中文(宋体/楷体体系)营造古籍质感,等宽字体(SF Mono/Consolas)服务代码阅读;
- 动效:对话气泡上浮入场(rise 动画)、AI 思考时的呼吸灯、打字三点闪烁,全部用 CSS 实现,零 JS 动画库。
7.2 微交互设计
几个自查过的小细节:
- 输入框自适应高度:随着内容增长,textarea 在 42px 到 120px 之间弹性伸缩;
- 回车发送、Shift+回车换行:符合即时通讯工具的习惯;
- 快捷提问按钮:散落在输入框上方,降低用户首轮提问成本;
- 流式期间的实时反馈:AI 回答逐字上屏,让用户获得"它正在思考"的确定感,而不是面对无限空白。
7.3 响应式
窄屏(< 960px)时双栏自动折叠为单栏,对话区与数据区纵向堆叠,移动端体验同样完整。
7.4 无障碍与可访问性
这次开发比以往更在意"所有人"都能用的体验:
- 语义化结构:页面使用
header / main / section / footer等语义标签组织,屏幕阅读器可以顺畅朗读层级; - 键盘可达:输入框、发送按钮、标签页、快捷按钮全部支持 Tab 聚焦与回车激活;
- 状态可感知:AI 思考时有点击不动的禁用态与呼吸灯提示,错误时有明确的文字反馈,而不是静默失败;
- 对比度:正文与背景的对比度满足 WCAG AA 级要求,金色系仅用于标题与强调,常规文本保持高对比度的米白色系。
这些工作没有炫技的成分,却在真实场景里决定了"一位视障用户能否顺畅逛完这座三国馆"。无障碍不是可选项,而是产品完整度的一部分。
八、项目文件结构与核心代码索引
三国人物数据库/
├── index.html          # 页面骨架(对话区 + 数据区 + 三标签页)
├── css/
│   └── style.css       # 全站样式:约 500 行,含响应式与动效
├── js/
│   ├── data.js         # 内置 100 位人物结构化数据(五阵营 + 水印)
│   └── app.js          # 核心逻辑(约 380 行)
└── README.md           # 使用文档
js/app.js 的关键函数速查:
| 函数 | 职责 |
|---|---|
queryAI(userText) | 组装 payload,发起流式请求,逐块刷新界面 |
extractJson(raw) | 三层容错 JSON 解析 |
renderPersonCard(person) | 单人物 → 卡片 DOM |
renderCards(data, source) | 对象/数组归一化,批量渲染 |
highlightJson(jsonStr) | JSON 字符串语法高亮 |
handleAIResult(raw, bubble) | 流结束后的结构化展示分支 |
九、踩坑实录:那些被绊倒又爬起来的地方
9.1 多字节字符乱码(最隐蔽的坑)
最初使用 decoder.decode(value) 而忘记 { stream: true },导致中文每 3 字节被硬切,界面上的回答偶尔出现"�"乱码。排查思路:先在 Node 里用相同逻辑复现,再用单字节 ASCII 测试对照发现只乱中文——定位到解码器状态问题。一句 stream: true,救回全部中文。
9.2 计数状态重复累加
第一版代码里,AI 查询计数在 renderCards() 与 handleAIResult() 两处各加了一次,导致一次查询成功后计数变成 2。修复方式是把"计数"职责单一化:只在 handleAIResult 中统一 state.aiCount += 1。任何状态都只能有一处"拥有者",否则就是 bug 温床。
9.3 卡片区空态闪烁
AI 返回前,右侧"AI 生成"标签页会短暂显示空态提示,数据到达后需立即隐藏。处理方式是渲染成功时直接设置 emptyAI.style.display = "none",并配合 CSS 入场动画,让衔接不留白。
9.4 上下文无限膨胀
每轮对话都把历史 messages 重新发给模型,会话越长 token 消耗越大。解决方案:state.messages.slice(-12),只保留最近 12 条。这是一个经典的"滑动窗口"上下文管理策略。
9.5 CORS 与密钥安全
浏览器直连第三方 API 可能触发跨域拦截;且密钥暴露在前端仅供演示。README 中已明确提示:生产环境应将请求转发到自己的服务端代理,密钥一律不落前端。安全不是功能,是底线。
十、验证之旅:把项目"逼"出问题
10.1 三层验证体系
我采用了"语法 → 功能 → 端到端"三级验证:
- 语法层:
node --check对两个 JS 文件做静态语法检查; - 功能层:本地启动
python3 -m http.server 8080,结合自动化测试断言 DOM 状态——标题、统计数字、内置列表行数、标签页数量、卡片渲染数量; - 端到端层:编写脚本驱动真实浏览器,模拟用户输入"东吴五大都督分别是谁?",等待 AI 流式返回完毕后断言:
{
  "cards": 5,                          // 5 张人物卡片
  "aiCount": "1",                      // 查询计数正确
  "names": ["周瑜", "鲁肃", "吕蒙", "陆逊", "陆抗"],
  "jsonHasArray": true,                // JSON 原文为数组
  "errors": []
}
10.2 为什么坚持端到端测试
纯前端项目最容易被"看起来能用"欺骗:手动点几下没报错,就算通过。但自动化测试会把"点击内置人物 → 卡片 +1、JSON 视图刷新"这类回归风险锁死。测试的价值,不在于证明现在没问题,而在于阻止未来引入问题。
十一、从零到交付:一个完整的开发时间线
- 需求设计:确定"数据库 + AI 对话 + 可视化"三位一体的产品定位;
- 技术验证:用临时脚本打通 API,验证模型支持流式与思考预算参数;
- UI 先行:先写 HTML/CSS 静态骨架,再接入数据;
- 提示词打磨:设计五段式系统提示词,跑通单对象、数组、兜底三个场景;
- 渲染联调:完成 JSON → 卡片、JSON → 高亮原文的双通道;
- 内置数据:录入 100 位人物(覆盖五阵营),统一字段契约;
- 自动化验证:语法检查 + 功能断言 + 端到端对话测试;
- 文档与发布:编写 README,提交到 GitCode 仓库。
十二、未来展望:这部"数据库"还能走多远
12.1 短期可落地的改进
- 历史轨迹线:利用 AI 返回的年份数据,在地图上绘制人物的军事、政治活动轨迹;
- 人物关系图谱:用相关人物字段驱动力导向图,可视化三国朋友圈;
- 势力对决模式:让 AI 扮演魏蜀吴不同的立场,生成"跨阵营辩论";
- 语音问答:接入 Web Speech API,让对话更自然。
12.2 更远的想象
- 从三国到百史:人物库的 JSON 契约通用化,迁到"大唐人物志""大明名臣录"只是换一个系统提示词的事;
- 知识图谱沉淀:每次 AI 对话生成的 JSON 都可持久化,久而久之,形成一个由用户共同培育的开放三国知识库;
- 多模型路由:根据问题难度动态选择轻量/重量模型,在成本与质量之间找到最优解。
12.3 数据资产:让每次对话都有回声
大部分 AI 对话应用的回答是"一次性"的:屏幕关掉,知识消失。而「三国人物数据库」的结构化设计天然具备沉淀属性。
我在设想一个朴素而迷人的功能:把用户每一次成功的 AI 查询结果去重合并后写回本地的 IndexedDB,让"AI 生成"标签页逐步累积成一份由社区共同养成的自定义数据库。当查询人次足够多,我们甚至可以统计出"最受欢迎的三国人物榜单"“被问得最多的武将计谋”——这些由对话行为编织出的集体趣味,本身就是一份有趣的文化数据。
更进一步,这份数据可以与内置数据库合并导出为 JSON 文件,实现"个人三国志"的本地备份与分享。对话一时,数据恒久——这是我给这个项目留下的最温柔的伏笔。
十三、写在最后
回望整个项目,最深的感悟有三点:
其一,大模型时代的"前端思维"变了。 过去前端是信息的"搬运工",今天前端可以是"策展人"——通过提示词工程,把大模型的海量知识策展成用户喜闻乐见的结构化形态。这一次,AI 是内容的生产者,而我们是体验的导演。
其二,小项目也值得大工程。 即便是三个文件的纯前端项目,也值得用系统提示词、容错解析、状态单一职责、三层测试去武装。工程的严谨度,与项目的体量无关,而与作者的职业尊严有关。
其三,技术与文化可以相互成就。 三国是最好的文化 IP 之一,AI 是当下最热的技术浪潮之一。当两者相遇,便有了"三国人物数据库"——它既是一次技术实践,也是一次小小的文化传播尝试。
如果你也对这个项目感兴趣,欢迎打开页面,问 AI 一句:“介绍一下诸葛亮的一生”——那扇门,为你而开。
项目代码开源托管于 GitCode:ShenNing0619/ruanjian6ban0918
技术栈:HTML5 · CSS3 · JavaScript · DeepSeek-V4-Flash · SSE 流式

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)