从演示文稿到文本叙事:SenseNova U1.5 Lite 下的版本化再生成
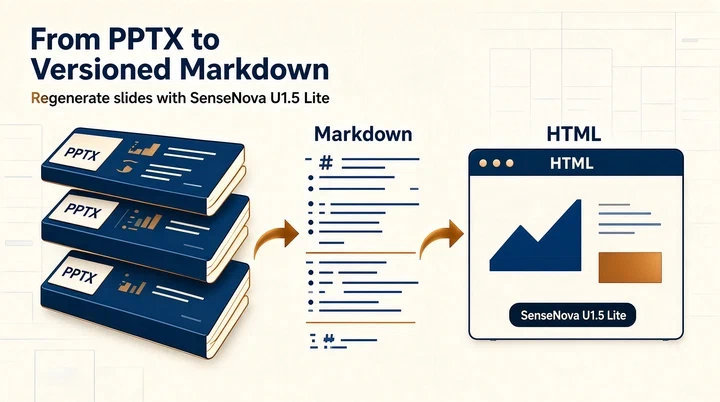
这不是一篇关于“用 AI 做 PPT”的经验。它讲的是一次反向解构:把十年 slide 从二进制文件拆回文本叙事,再让文本、任务、模型和版本共同成为知识再生的底座。
一、起点:演示文稿如何被锁进二进制牢笼
真正的问题,不是“有没有 slides”,而是近十年的 slide 长期被锁在 PPTX 这种展示容器里。
开源之道从 2016 年 12 月起步,到 2026 年,已经积累 147 场分享、27 场线下活动、77 本共读书籍的记录,累计 2602 张 slide。它们不是普通素材,而是近十年反复讲、反复改、反复沉淀下来的知识资产。但它们长期以 PPTX 文件存在:能放映,难 diff;能打开,难检索;能复制,难合并;能改一版,却很难说清“这一版到底改了什么”。
PPTX 适合表达,不适合演化;适合一次性交付,不适合长期协作;适合屏幕里的视觉秩序,不适合文字层面的审查和版本治理。把 PPTX 当作知识容器,几乎是逆向而行。对于持续生产内容的组织来说,这不只是“文件格式不优雅”,而是一种结构性阻塞:内容越长,阻塞越重;分享越多,债务越厚;越重要,越难维护。
近十年里,这件事一直像鲠在喉中。它不致命,但每次整理、合并、迁移、复述,都会重新卡住一次。
这次迁移要解决的,不是用 AI 更快做出一份幻灯片,而是把演示文稿拆回它真正应该拥有的形态:文本叙事。具体路径是用 Hermes Agent、SenseNova 系列模型和 Skills 能力,把多个 PPTX 转成 Markdown;再以 Markdown 作为可 Git、可 diff、可 grep、可审计的事实源;最后通过 SenseNova U1.5 Lite、SenseNova 6.8 Flash Lite 和 sn-ppt-standard 流水线,实时生成 HTML 页面与配图。
PPTX 是展示容器,Markdown 才是知识容器。当知识容器被版本化之后,演示文稿才第一次具备像代码一样的演化能力。换句话说,这场迁移不是把 PPT 搬到网页上,而是重新承认:演示文稿里的思想,应该拥有自己的历史。
这篇文章讲的不是“AI 做 PPT”,而是把已经被二进制封装的十年内容重新文本化、版本化、再生成化。开源之书的 slide 素材不是“要做的”,而是“已经写好了的”;缺的不是内容,是一套能把内容从二进制牢笼里放出来、再让它重新长出来的流水线。
二、流水线的骨架:把生成拆成可审计的工序
选型没有太多犹豫。SenseNova 提供的 sn-ppt-standard skill 已经定义了一个完整的 stage 化 pipeline。它把 preflight、style、outline、asset-plan、gen-image、page-html 和 export 串成一条可审计工序链。
每个 stage 的输入输出都是确定性的 JSON。preflight 读 source.md,产出 document_digest.json;outline 读 digest,产出 slide_outline.json;asset-plan 读 outline,产出 asset_plan.json。以此类推,环环相扣。
stage 化设计对存量迁移的意义是可插拔、可重试、可跳过。一个 deck 的 gen-image 失败了,下一个 deck 可以从头开始,不必重跑全部;已经完成的 style、outline 在下次运行时会自动跳过。它把一个原本不可解释的“生成演示文稿”动作,拆成了一组可以被检查、回滚和继续推进的工序。
Hermes Agent:让 pipeline 拥有执行、记忆和修复能力
这条流水线不是单点脚本。它的执行环境是 Hermes Agent:Agent 负责读取仓库、调用 stage、检查中间 JSON、在失败时定位模型路由或超时问题,再把恢复策略写回脚本和 Kanban task。这个环境的关键不是“会调用 API”,而是它把模型调用、文件状态、任务队列和部署反馈连接成一个可恢复闭环。
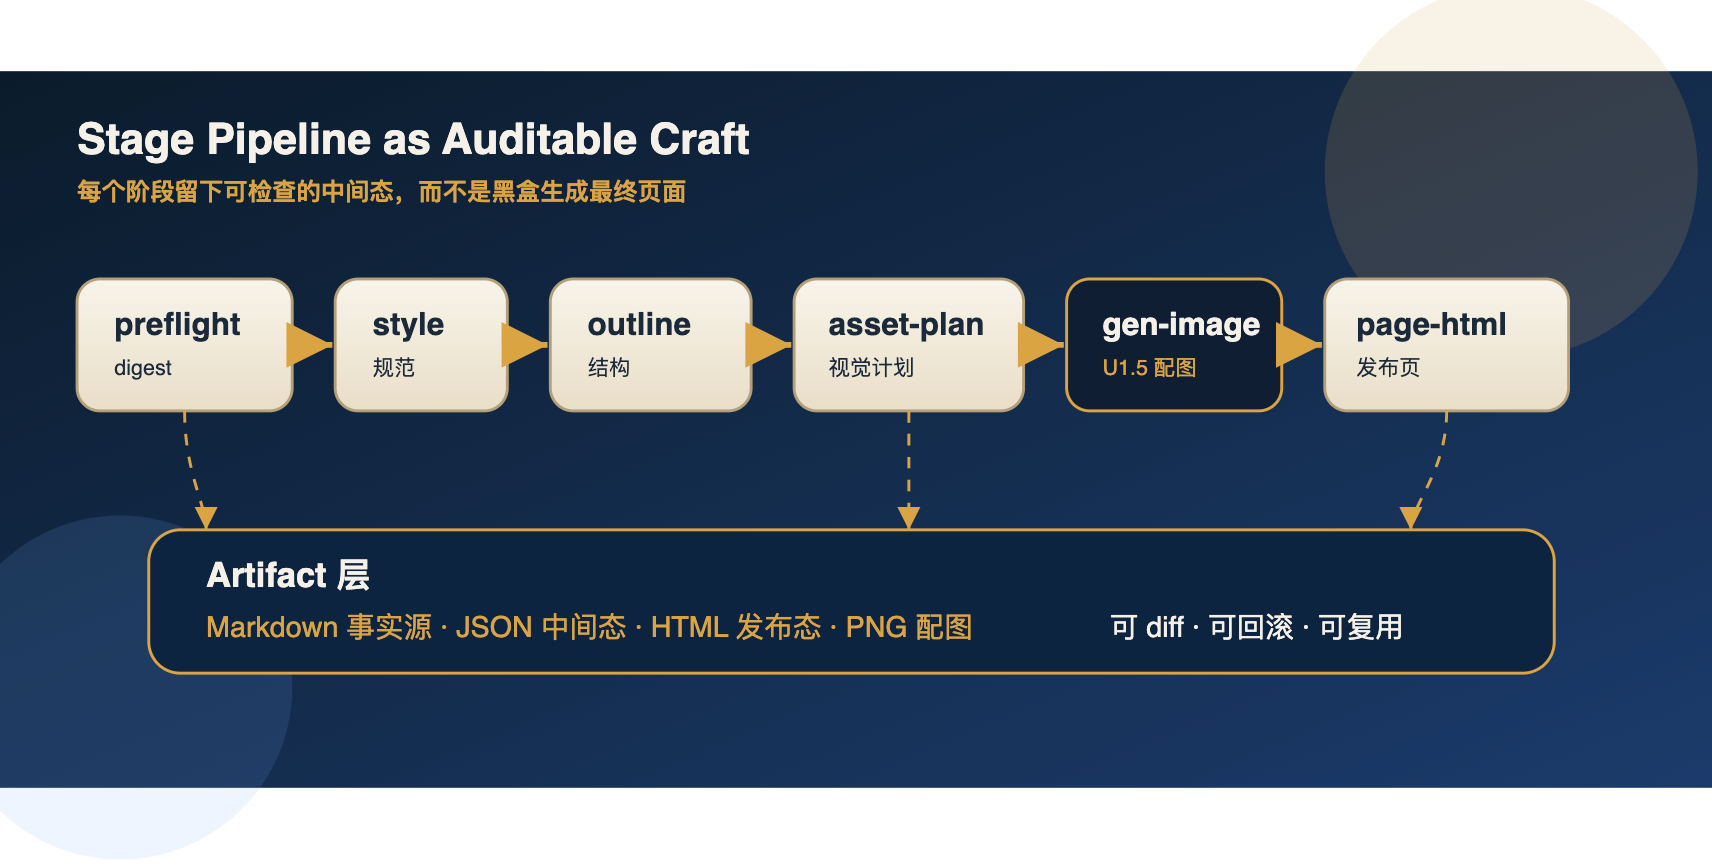
这条架构线里有三个可审计对象:Markdown 是事实源,JSON stage artifacts 是生成中间态,HTML deck 是发布态。Agent 的价值不是替代这三者,而是在它们之间建立可恢复的调度与修复。
配图选择 SenseNova U1.5 Lite——商汤“日日新”系列的新一代图片创作模型,2026 年 8 月正式发布。较上一代 U1 Fast 在构图、光影、材质细节和高分辨率输出上全面提升。选它的另一个原因是它能同时承担文生图和 VLM 质检两个角色:生成配图,然后用同样的模型能力自检图片质量。
一个 10 页 deck 的完整生命周期(实测):
| Stage | 输入 | 输出 | 耗时 |
|---|---|---|---|
| preflight | source.md | document_digest.json | <1s |
| style | style_catalog.md | style_spec.json | <1s |
| outline | digest + style | outline.json(10 页) | 30-60s |
| asset-plan | outline | asset_plan.json(6-9 个 slots) | 60-90s |
| gen-image | asset_plan + prompt | page_XXX_slot.png | 5-6 min/张 |
| page-html | outline + images | page_XXX.html | 30-60s/页 |
总耗时:约 50-65 分钟/个 10 页 deck。
瓶颈一目了然:gen-image 每张 5-6 分钟,是全部 stage 里最慢的。一张图片要经历 prompt 生成、U1.5 Lite API 调用(约 2 分钟)、VLM 质检(约 1 分钟)、可能的重试。一个 10 页 deck 有 6-9 张配图,光图片就要 40-50 分钟。
147 个 deck 串行跑下来,22 小时起步。数字本身不性感,但它把一个原本模糊的“生成演示文稿”变成了一条可估算、可排队、可恢复的生产线。
三、运行中的摩擦:Agent、Skill 与模型的分工
从 20 个 deck 的验证批开始,真正的问题不再只是“能不能生成”,而是不同环节之间的边界是否清晰。
验证批运行时遇到的三类问题,本质上都指向同一个工程教训:
- 模型路由要显式配置。 outline、asset-plan、page-html 走文本/推理模型;gen-image 走文生图模型;VLM 质检走视觉模型。任何一个环境变量没覆盖,错误信息都可能伪装成“图片没生成”或“模型返回为空”。
- 长任务要按资源边界拆分。 78 页的大 deck 一次批量生图必然超过常规 timeout。最后采用的策略不是“把超时调更长”,而是逐张生成、单图超时、deck 级重试。
- 发布系统有自己的发现规则。 Hugo 的
content/是路由和元数据,static/是资源;slides 播放器里硬编码的 deck id 和 iframe 缩放逻辑,也必须在模板层修正,否则静态文件“存在”但不等于“可见”。
这些问题当然重要,但它们不是这篇文章的主线。它们更像迁移过程中的摩擦:真实、必要、可修,但不应掩盖真正有价值的变化——演示文稿第一次成为 Agent 工作流里的可调度对象。
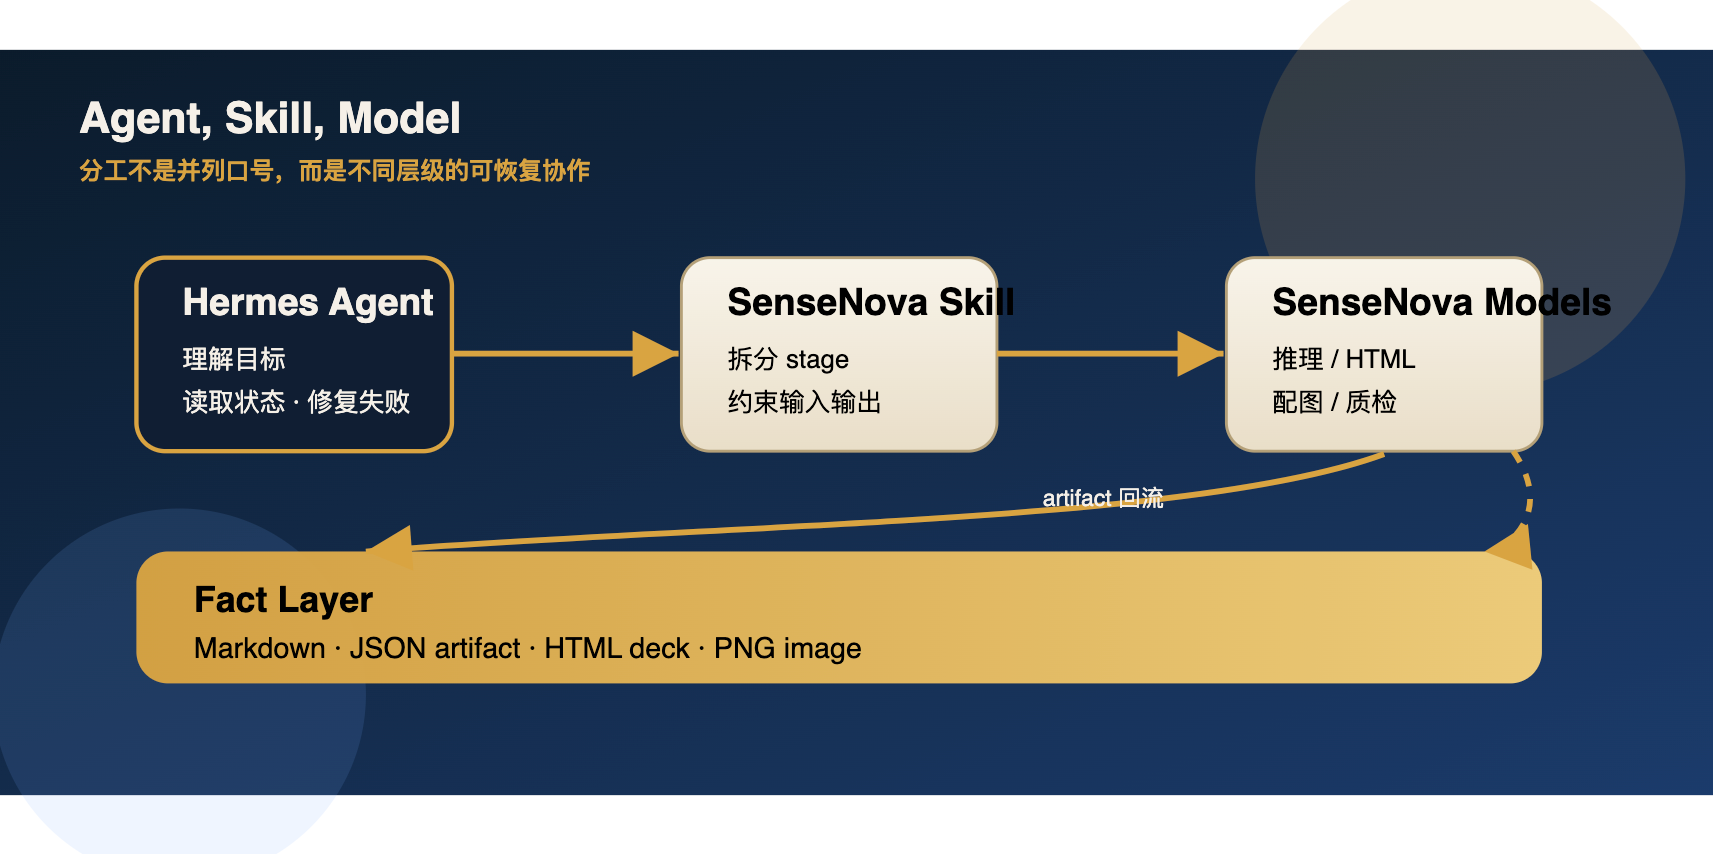
Hermes Agent 是操作主体。 它不是“调用模型 API 的脚本”,而是维护上下文、调用 skill、读取日志、判断失败类型、决定重试策略的执行者。Agent 的价值在于把分散的模型能力和文件状态连接起来:哪一个 stage 完成了,哪一个图片失败了,哪一个 deck 可以进入下一个任务,都由 Agent 根据事实和工具反馈推进。
SenseNova Skills 是流程约束。 sn-ppt-standard 把工作拆成 preflight → style → outline → asset-plan → gen-image → page-html → export。每个 stage 有明确输入、输出、JSON artifact 和可跳过条件。Skill 约束了模型的自由度:模型不是每次从零创作整套 PPT,而是在确定的中间态上继续生成。这样,Agent 的错误可以被定位到某个 stage,而不是淹没在“生成结果不好”这个黑盒里。
SenseNova 模型提供具体生产能力。 sensenova-6.8-flash-lite 负责文本理解、大纲、HTML 结构和页面修复;sensenova-u1.5-lite 负责实时配图,承担文生图能力。它们不是同一件事:文本模型负责结构与叙事,图像模型负责视觉表达;Agent 负责让它们在同一条流水线里协作。
这就是这条 pipeline 的核心:不是“让大模型做 PPT”,而是让 Agent 调度 Skill,Skill 调用 Model,Model 产出可审计 artifact,Agent 再根据 artifact 继续推进。
四、数据与节奏:长尾任务不是英雄主义
截至这篇文章更新的时候(2026 年 9 月),真实数据如下:
| 指标 | 数值 |
|---|---|
| 源素材 deck | 147 个 Markdown(去重后在 slides-src/ 下组织为 107 个 deck 目录) |
| 源素材 slides | 2602 张 |
| Kanban 队列 | 94 个 task(92 done,2 archived)——已全部完成 |
| 已完成 deck | 54 个 |
| 已完成 pages | 515 张 HTML |
| 累计配图 | 234 张 PNG |
| 修复前失败率 | 90% |
| 修复后失败率 | 0% |
| 持续运行时长 | 约 36 小时(2026-08-27 → 2026-09-03) |
从第一批 14 个 deck 到全部 54 个 deck 上线,kanban worker 在 max_in_progress=1 的串行调度下持续运行了约 7 天,最终 94 个 task 全部完成,无需人工介入。
deck 的规模分布(来自 manifest):
| 页数范围 | 数量 | 占比 |
|---|---|---|
| <10 页 | 14 个 | 10% |
| 10-15 页 | 86 个 | 59% |
| 16-30 页 | 36 个 | 24% |
| >30 页 | 11 个 | 7% |
中位数约 15 页,平均 18 页。最长的一个 deck 78 页——这个 deck 的图片生成阶段,batch-gen-image 一次超时 600 秒就是被它触发的。
这里没有出现什么“模型突破”。真正起作用的是节奏:147 个 deck、2602 张 slide、22 小时起步,不是一次性能完成的冲刺,而是一条需要被拆散、被排队、被恢复的长尾生产线。
五、为什么不是“AI 做 PPT”:环境往往先于模型失败
这篇文章很容易写成“用 AI 批量做 PPT 的体验”:开头讲痛点,中间讲技术选型,结尾讲工程闭环。但真实的经验和这个叙事完全不一样。
三个反常识的观察:
第一,AI 没出错,出错的从来是我们给它的环境。
U1.5 Lite 生成了图片,VLM 质检也收到了图片,但质检阶段被路由到了另一个不可用的模型。VLM 调用失败 → “没有图片” → 拒绝。这是一个纯粹的运维 bug——模型路由配置错了。不是 U1.5 Lite 的图片有问题,不是 VLM 的质量标准有问题,是模型路由错了。
在 147 个 deck 的迁移过程中,U1.5 Lite 没有一次生成失败过,VLM 质检没有一次因为图片本身的质量而拒绝过。所有的失败都来自外部环境——配额、超时、参数拼写、transform-origin。
第二,pipeline 的健壮性取决于最弱的配置环节,不是最弱的 AI 模型。
sn-ppt-standard 的 stage 设计很健壮——每个 stage 输入输出确定,可重试可跳过。但整个流水线的健壮性在 .env 文件里:一个配额的耗尽、一个参数的拼写、一个 transform-origin 的取值,任何一处不对,整个 147 deck 的迁移就卡住。AI 模型本身没有脆弱性,脆弱的是我们给它的运行环境。
第三,存量迁移的本质不是技术,是耐心。
147 个 deck,2602 张 slide,22 小时串行跑。没有炫技的算法,没有复杂的编排,就是一个 Python 脚本循环遍历 147 个目录,每个目录跑 6 个 stage,失败了就重试,完成了就 commit。近十年欠的债,需要近十天的耐心来还。
开源之书从 2016 到今天,近十年欠账 147 个 deck。这不是一个可以靠“更好的 AI”来解决的问题——AI 已经够好了。这是一个可以靠“更完整的流水线 + 更耐心的运行”来解决的问题。
而这个问题正在被解决:94 个 kanban task 全部完成,54 个 deck、515 张 HTML 页面已经上线。
第一批 14 个 deck 是在批处理脚本的 4.6 小时里跑出来的;剩下的 40 个 deck 是在 kanban worker 约 7 天的不间断运行里完成的。从 14/147 到 54/107,进度条终于走到了一个可以喘口气的地方。
六、开源的意义:把流程本身交给公共演化
这个流水线最终产出的不是 147 个 HTML 页面,是一个可以复用的模式。
任何一个有存量内容的团队,都可以用同样的方法——stage 化的 pipeline、SenseNova 配图、Hugo 部署——把自己的 Markdown 素材批量迁移为可展示的 HTML deck。流程是公开的,代码是开源的,经验已经写下来了。
开源之书的 slides 仓库(GitHub)完全开源。任何人都可以:
- Fork 仓库
- 复制一个
content/books/xx-your-book.md - 写 Markdown 内容 + 配图 prompt
- Push → CI 自动部署 → 你的 slides 上线
slide 写作的下一个十年,不是更好的 PPT 软件,而是让 slide 像代码一样可 Git、可 CI、可复用。而这件事,不需要更多设计师,只需要一套能跑通的流水线。
七、从批处理到 Kanban:任务调度的一次重构
如果只把 pipeline 看成脚本,问题会停在“跑完 147 个 deck”。但真正的问题不在这里:近十年的素材不是一批同质任务,而是不同页数、不同主题、不同图像复杂度的长尾队列。它需要的不是一个更长的后台进程,而是一个能持续理解任务状态、调度执行、记录失败、恢复进度的 Agent 工作流。
六月的批处理脚本先跑通了 14 个 deck。剩下的 133 个 deck 继续暴露出后台进程的问题:terminal(background=true) 跑出来的进程仍然是 Hermes 会话的子进程。Dashboard 重启、会话超时、系统负载抖动,都会让它收到 SIGTERM。更麻烦的是,这个脚本没有独立的任务事实源;脚本死了,进度就混在日志和文件系统里,需要人再判断“刚才做到哪里”。这不是“加个 nohup”能解决的技术小毛病,而是批处理架构的边界:它适合一次性完成任务,不适合跨会话、跨重启、跨数天的长任务。
Hermes Kanban 把这个边界重新划了一遍。每个 deck 变成一张独立卡片:标题记录 deck,body 记录要执行的脚本,max-runtime 和 max-retries 记录资源边界,assignee 记录 worker,idempotency-key 记录重复执行时的事实身份。94 个 task 被创建后,Gateway 以 max_in_progress_per_profile=1 的方式逐个派发 worker,每完成一个,就在约 60 秒内派发下一个。这里的并发不是越大越好;对 SenseNova 配额、图片生成耗时和 VLM 质检来说,稳定串行反而是更可靠的生产线。
Kanban 的强项,是让 Agent 不靠“记忆”推进工作。Agent 不需要记得昨天跑到哪个 deck,也不需要猜测某张图片是上次失败还是这次失败。它只需要读取队列:可运行的 task 就执行,失败就根据错误类型重试或阻塞,完成就进入 done,不再处理。每张卡片都有状态、重试次数、失败原因和幂等键;整个迁移过程因此从“一个长时间运行的脚本”变成了“一组可审计、可恢复、可继续的任务事实”。
每个 task 的粒度也值得记录。我们没有把 107 个 deck 拆成 1000 多张 per-page task,而是选择 per-deck。原因是单个 deck 内部存在强依赖:preflight、style、outline、asset-plan、batch-gen-image、batch-page-html 之间共享上下文和文件状态,跨 stage 的错误恢复最好留在同一个 worker 内完成。跨 deck 的并发和恢复交给 Kanban,deck 内部的串行和状态跳过交给 run_one_deck.py。这形成了清晰的层级:Kanban 管全局节奏,脚本管局部工序,Skill 管生成规范,Model 管具体生产能力。
第一次用 Kanban 跑 2024-10-ignorance-and-awe 时,冒烟测试暴露了两个 pipeline 层问题。batch-page-html 十页全部失败,日志里不是页面内容失败,而是模型路由没有把输出放到可读的 content 字段;随后又遇到并发过高导致的 TPM/RPM 限额。修正是显式覆盖 SN_TEXT_MODEL、SN_CHAT_MODEL、SN_VISION_MODEL,并把页面生成并发降到 1。这两个问题再次说明:失败通常不在 AI 的能力边界里,而在 Agent 运行的基础设施边界里。
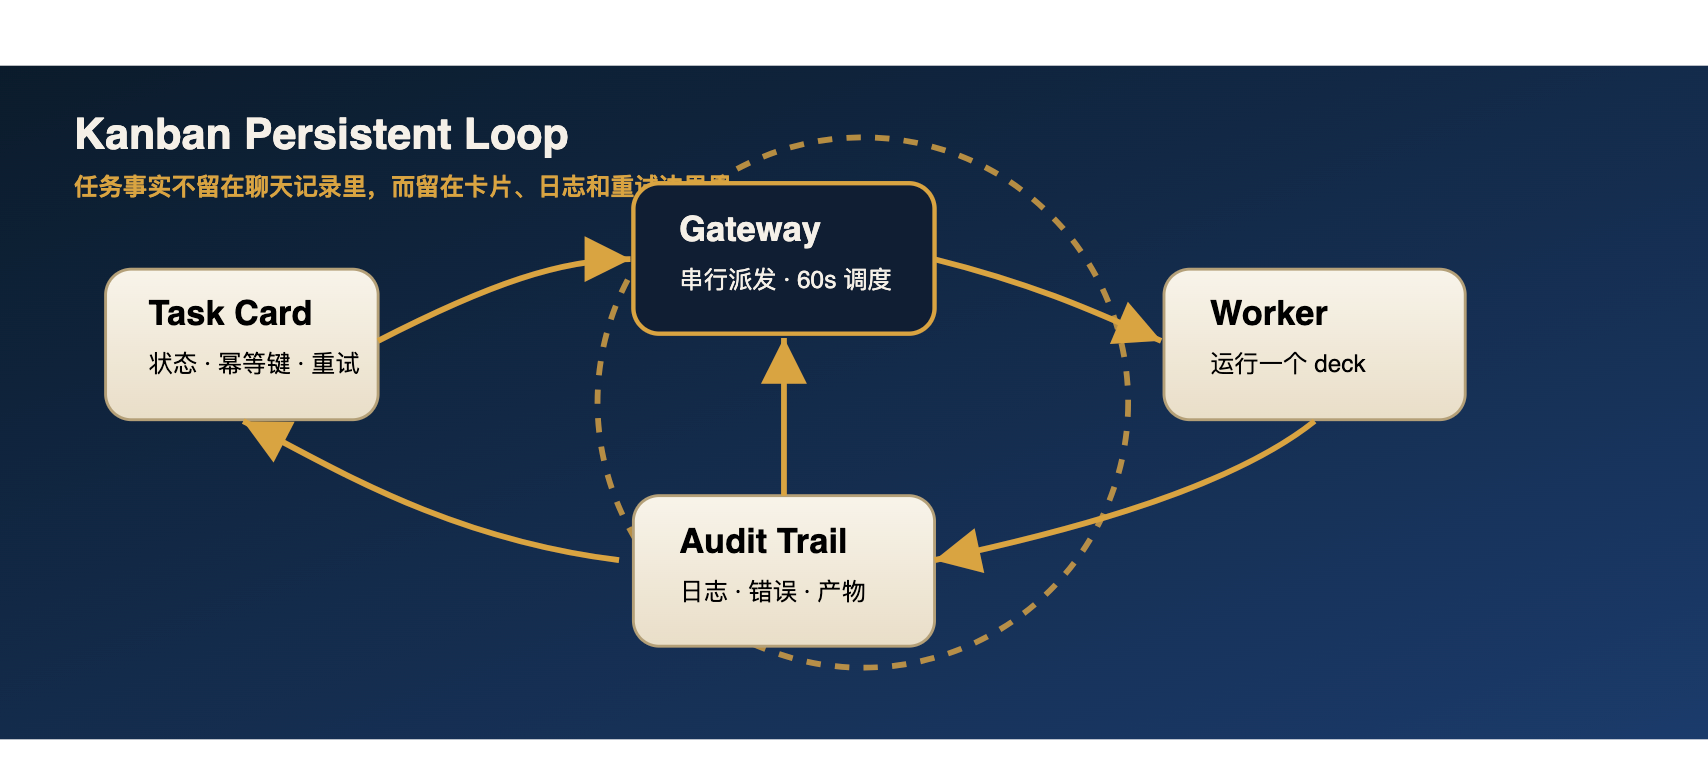
从调度角度看,Kanban 的持续能力有三层。第一层是恢复:任务状态不依赖聊天上下文,Hermes 会话重启后仍能继续;第二层是审计:每次失败都留下 task、worker、错误和重试记录;第三层是节制:失败次数超过阈值自动 blocked,避免一个坏配置反复消耗配额。对于 147 个 deck、2602 张 slide 这种长尾迁移,真正的瓶颈不是模型能否生成一页,而是系统能否在没有人类持续陪跑的情况下,持续、稳定、可解释地推进几十上百个对象。
这就是为什么这条 pipeline 不能只写成“我写了一个脚本”。脚本能执行动作,Kanban 才能让动作变成可持续的工作事实。Agent 的意义也不是替代人做判断,而是把长任务的记忆、调度和恢复成本从人脑里移出来,变成可检查的队列、卡片、日志和版本。
八、完成回顾:Agent 让协作变成版本化资产
2026 年 9 月初,94 个 Kanban task 全部完成:92 个 done,2 个 archived。从「黑客伦理」到「开源的世界」,54 个 deck 上线,515 张 HTML 页面和 234 张配图进入发布仓库。调度层没有再出现结构性中断;从 4.6 小时的批处理到约 7 天的 Kanban,整个迁移过程中反复出现的问题仍然是模型路由、配额、超时、Hugo 静态资源路径这些基础设施问题,而不是 pipeline 逻辑本身。
这次完成最有价值的部分,不是 515 张页面这个数字,而是协作方式的变化。过去,slide 的协作发生在 PPTX 文件里:一个人打开文件,改一页,另一个人另存一版,最后靠文件名、邮件和记忆判断哪一版是新的。文本化之后,协作发生在 Markdown、JSON artifact、HTML、commit 和 review 里。每一页的叙事、每一张图片的 prompt、每一段 HTML 的生成依据、每一次失败的重试记录,都可以被 diff、被审计、被回滚、被复用。
Agent 在这个过程里的意义,是把“协作”从人手工同步文件,提升成系统可维护的工作流。人类仍然决定什么值得讲、怎样表达、什么内容需要修改;Agent 负责把这些决定转成可执行的任务,处理 stage 依赖,读取日志,识别失败类型,调用模型,检查产物,更新队列状态,再把结果提交到版本系统。这里的关键不是“AI 自动做完了所有事”,而是 Agent 承担了协作中的上下文、状态和恢复成本。
版本化也不只是 Git 意义上的 commit。Markdown 是可读的事实源;JSON stage artifact 是生成过程中的可审计中间态;HTML deck 是发布态;Kanban task 是执行事实;SenseNova 模型的输出是生成记录。它们共同构成一个可追踪的知识生产链:从想法到页面,不再是一次性的屏幕表演,而是一段可以回看、可以分叉、可以修订、可以重新生成的文本历史。
这也是开源之道这些年一直在做的事情的镜像。开源不是把最终文件给别人,而是把演化过程打开。slide 也一样:一旦它从二进制文件变成文本资产,它就能进入 fork、review、CI、issue、merge request、release notes 和后续再创作的循环。近十年积累下来的 147 个 deck,不是过去式,而是下一次分享、下一次课程、下一次书籍、下一次活动的前置资产。
所以,这次迁移真正的完成回顾是:我们不是把 PPT 搬到了网上,而是把演示文稿重新变成可以被思想使用的材料。文本让它可写,版本让它可演化,Agent 让它可持续,SenseNova 让它可实时再生成。演示文稿终于不再只是“讲完即止”的容器,而成了知识继续生长的入口。
作者:「开源之道」·适兕(LiJiansheng) 仓库:github.com/oscar-open-source-book/website https://github.com/oscar-open-source-book/website
线上展示:osbook.opensourceway.blog/slides/https://osbook.opensourceway.blog/slides/

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)