AI 模拟面试:大厂二面高频项目深挖之“高并发多级缓存一致性治理”
·
AI 模拟面试:大厂二面高频项目深挖之“高并发多级缓存一致性治理”
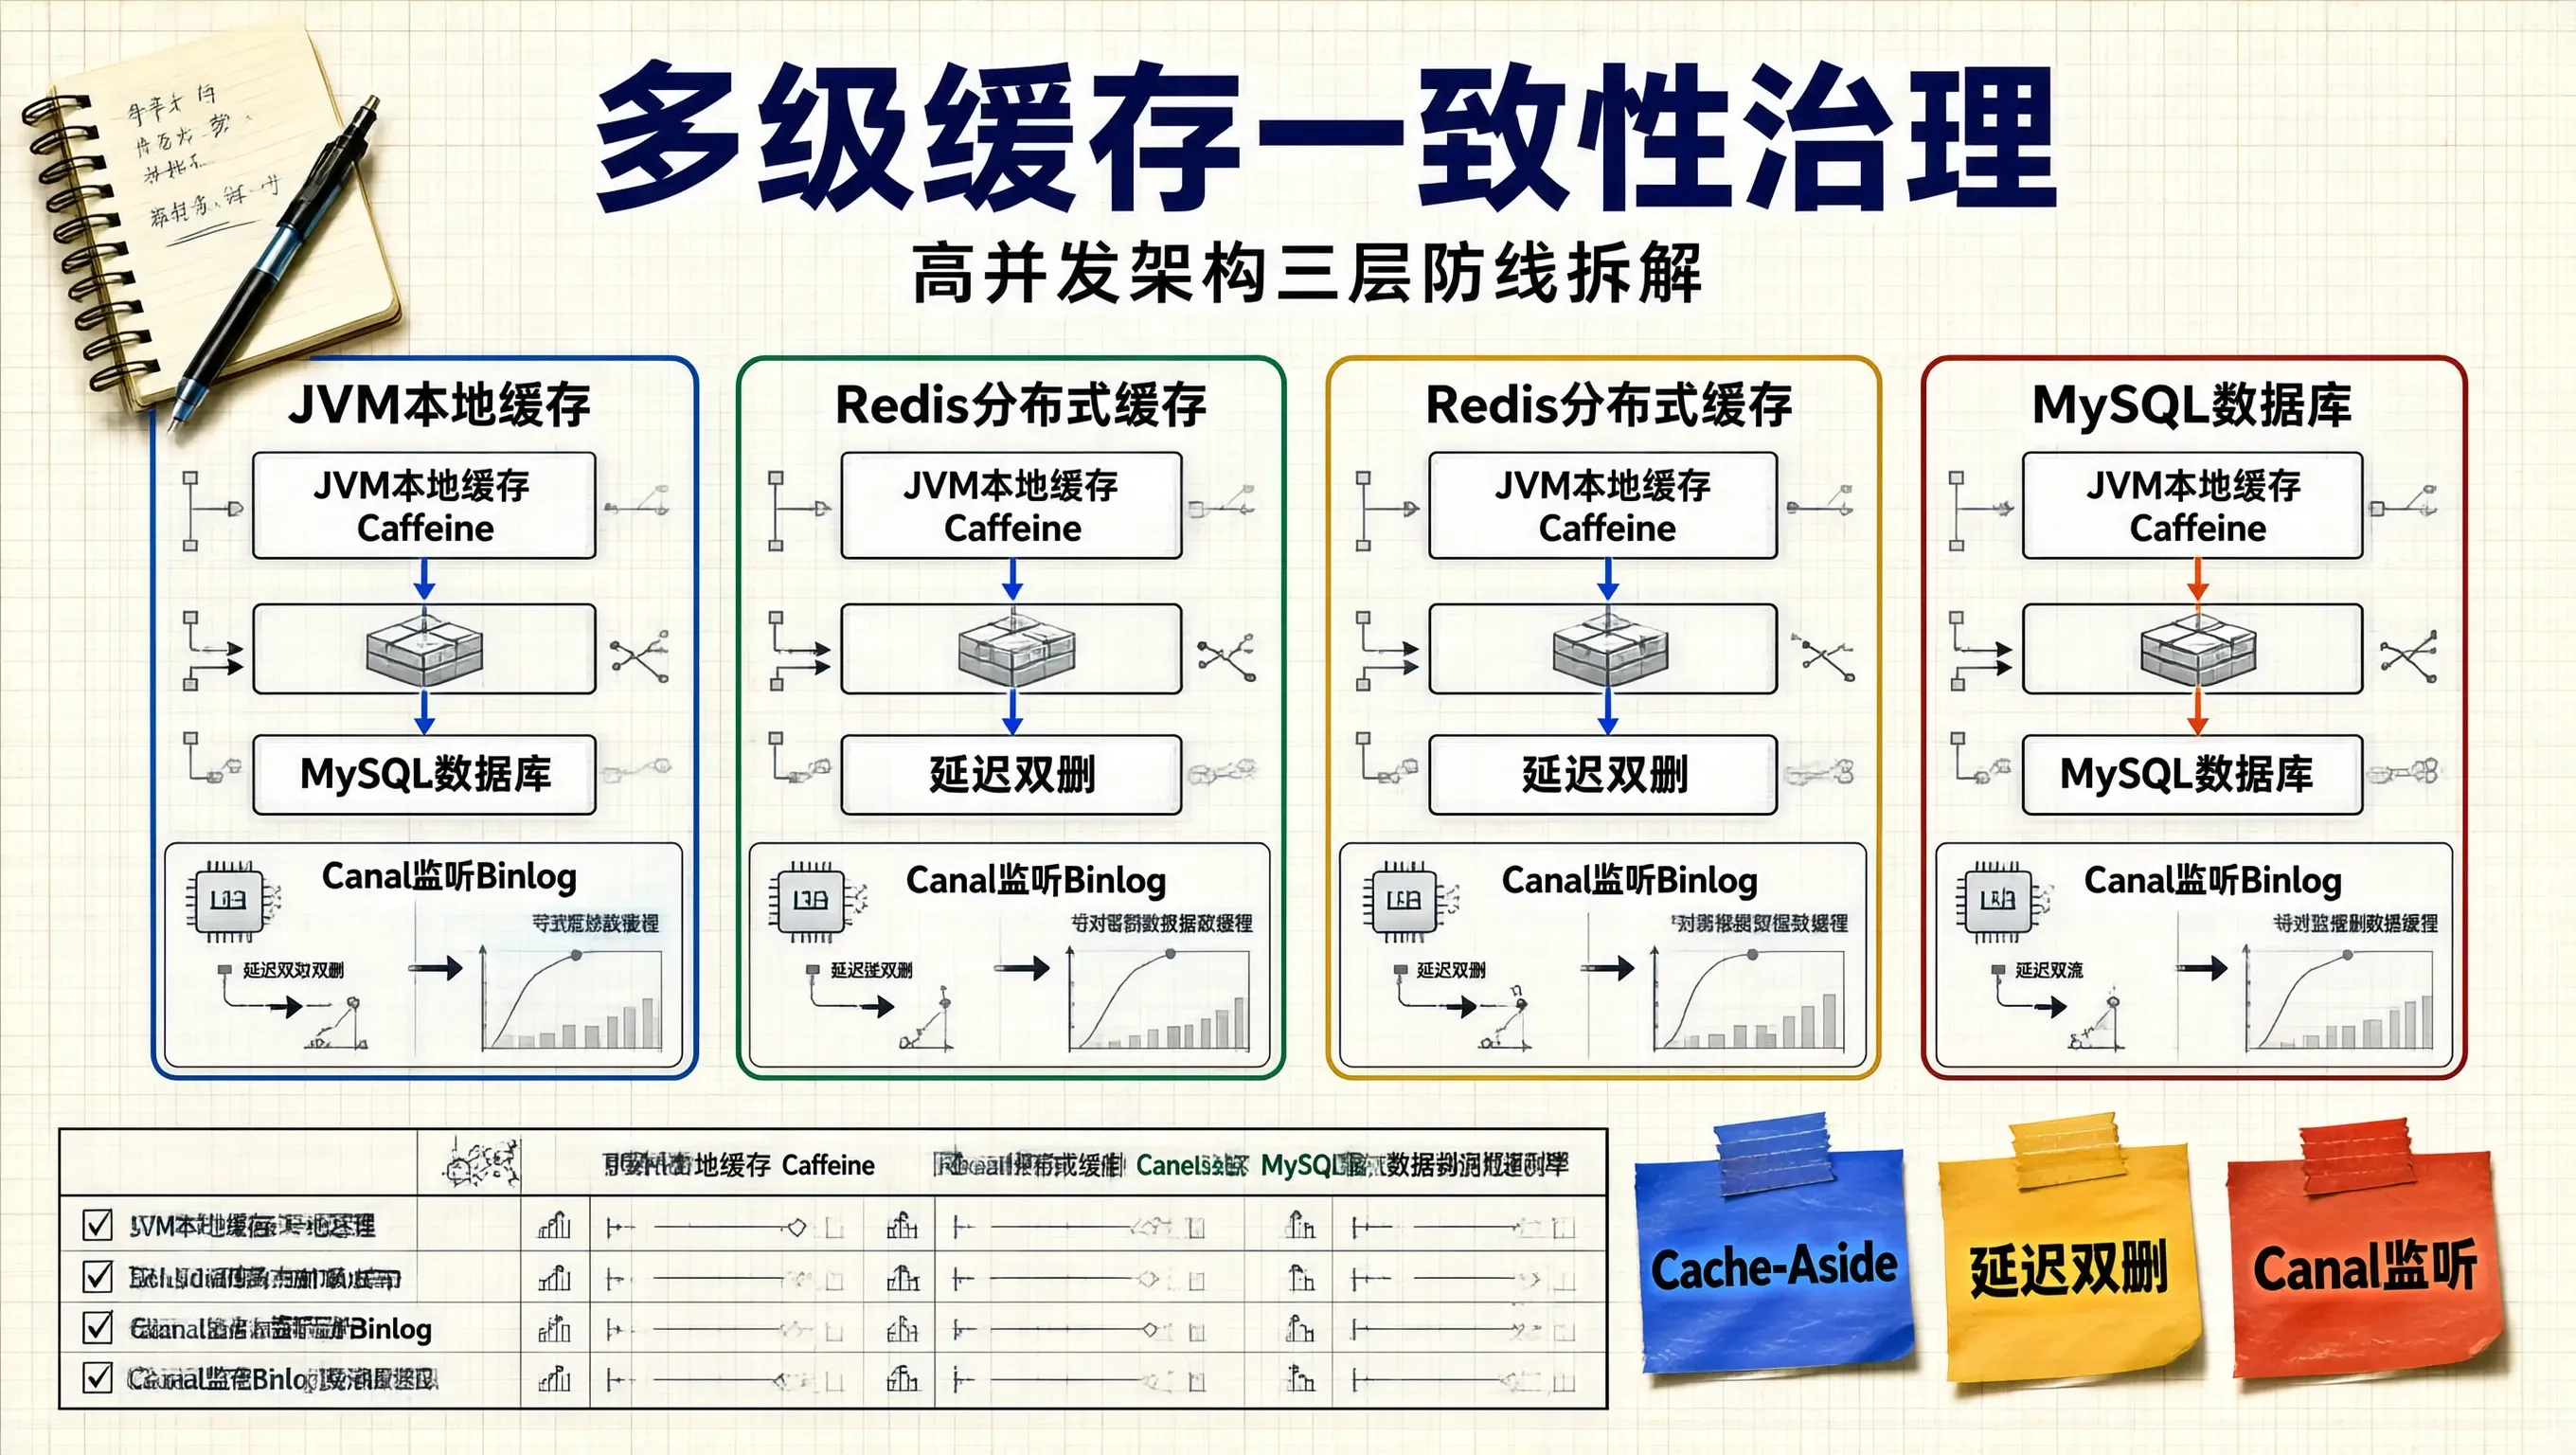
在各大厂的后端二面和资深技术答辩中,几乎每个应届生的简历上都写着“引入 Redis 缓存提升系统并发”。
而面试官通常会顺着这个项目展开长达 20 分钟的“高可用连环拷问”:
“你们的多级缓存架构中,JVM 本地缓存(Caffeine)与分布式缓存(Redis)的数据一致性是如何保证的?为什么采用‘先更新数据库,再删除缓存’而不是‘先删除缓存,再更新数据库’?在主从读写分离架构下,主从复制延迟导致的‘缓存脏读覆盖’你有哪些针对性的防御方案?Canal 监听 Binlog 挂了怎么办?”
今天我们通过 AI 模拟面试的硬核复盘,把多级缓存架构下的数据一致性与高并发避坑因果链彻底讲透。
核心论证一:为什么是“先更新 DB,再删除 Cache”?
在并发读写场景下,存在两种经典更新策略:
策略 A:先删除缓存,再更新数据库(容易造成永久脏数据)
graph TD
    A[请求 1 写: 删除 Redis 缓存] --> B[请求 2 读: 发现缓存为空]
    B --> C[请求 2 读: 从 DB 读取到旧数据 10]
    C --> D[请求 1 写: 更新 DB 写入新数据 20]
    D --> E[请求 2 读: 将旧数据 10 写入 Redis 缓存]
    E --> F[灾难: 缓存中永久残留旧数据 10, DB 中是新数据 20!]
致命缺陷:并发读写下,产生脏数据的概率极高,且脏数据会永久驻留缓存直到 TTL 过期。
策略 B:先更新数据库,再删除缓存(Cache Aside Pattern,业界标准)
graph TD
    A[请求 1 读: 发现缓存为空] --> B[请求 1 读: 从 DB 读取到旧数据 10]
    B --> C[请求 2 写: 更新 DB 写入新数据 20]
    C --> D[请求 2 写: 删除 Redis 缓存]
    D --> E[请求 1 读: 将旧数据 10 写入 Redis 缓存]
为什么策略 B 发生脏数据的概率极低?
要想让策略 B 产生脏数据,必须满足以下严苛时序:
- 读请求命中缓存缺失,去查 DB;
- 在读请求拿到数据之后、写入缓存之前,恰好有一个写请求完整地执行了“更新 DB + 删除缓存”;
- 读请求最后将旧数据写回缓存。
由于 写 DB 的耗时(涉及物理磁盘 I/O 和行锁)远长于纯内存写 Redis 缓存,在现实高并发中,写请求几乎不可能插在读请求从 DB 读取到写缓存这极其短暂的几十微秒之间!因此策略 B 的安全性远高于策略 A。
核心论证二:读写分离架构下的“主从延迟脏读”终极解法
在大型系统中,MySQL 通常开启读写分离(Master 写,Slave 读)。
此时即使采用 Cache-Aside,依然可能出现如下漏洞:
- 线程 A 更新 Master DB;
- 线程 A 删除 Redis 缓存;
- 线程 B 读请求从 Slave 从库读取数据(此时主从复制存在 100ms 延迟,Slave 依然是旧数据);
- 线程 B 将从库的旧数据写回 Redis,造成脏数据!
工业级破局方案:延迟双删 + Canal 异步监听
// 方案一:延迟双删机制(轻量级防御)
public void updateDataWithDelayedDoubleDelete(DataDTO dto) {
    // 1. 更新主库
    dbMapper.updateMaster(dto);
    // 2. 第一次删除缓存
    redisTemplate.delete(cacheKey);

    // 3. 异步触发延迟第二次删除(延迟时间根据主从复制最大延迟通常设为 500ms~1000ms)
    scheduledExecutor.schedule(() -> {
        redisTemplate.delete(cacheKey);
    }, 500, TimeUnit.MILLISECONDS);
}
// 方案二:基于 Canal 监听 MySQL Binlog 异步解耦(工业级推荐)
@Component
public class BinlogCacheSyncConsumer {
    @KafkaListener(topics = "mysql_binlog_order_topic")
    public void onBinlogChange(String message) {
        BinlogData data = JSON.parseObject(message, BinlogData.class);
        if ("UPDATE".equals(data.getType()) || "DELETE".equals(data.getType())) {
            String cacheKey = "cache:order:" + data.getPrimaryKey();
            // 由 Canal 确保在从库同步完成后/事务提交后可靠删除 Redis 缓存
            // 若删除失败,由 Kafka 重试机制兜底,彻底保证最终一致性
            redisTemplate.delete(cacheKey);
        }
    }
}
核心论证三:Caffeine 本地缓存与 Redis 的分布式同步
当系统引入 JVM 本地缓存(Caffeine / Guava Cache)构建两级缓存时:
- 单实例修改了本地缓存和 Redis;
- 其他 10 台集群服务器的 JVM 本地缓存如何实时感知并失效?
标准解法:Redis Pub/Sub 广播广播失效
当任意节点发生数据更新时:
- 更新 DB 并删除 Redis;
- 向 Redis 的
Topic:CACHE_INVALIDATE发送广播消息; - 所有微服务实例监听该 Topic,接收到消息后各自执行
caffeineCache.invalidate(key),实现全集群本地缓存的毫秒级失效。
模拟面试总结
面对多级缓存一致性的连环深挖,按照三层防线作答:
- 基础防线:Cache-Aside 先更 DB 后删 Cache;
- 主从防线:Canal 监听 Binlog 异步延时重试,解耦业务逻辑;
- 多级同步:Redis Pub/Sub 广播实现全集群本地 Caffeine 缓存的毫秒级同步与失效。
逻辑闭环、架构完备,必能征服挑剔的技术面试官。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)