LangChain-AI应用开发框架(3) - 认识嵌入模型,嵌入模型的接入方式,嵌入模型的应用场景
目录
检索增强生成 (Retrieval‑Augmented Generation,RAG)
一、认识嵌入模型
什么是嵌入模型?
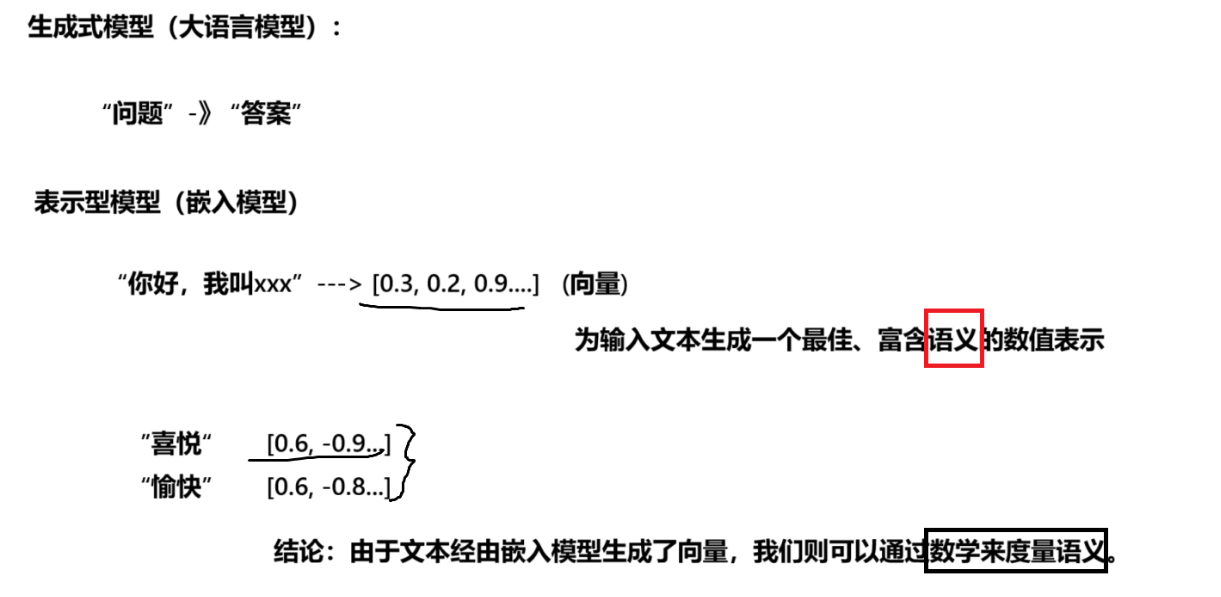 大语言模型是生成式模型。它理解输入并生成新的文本(回答问题、写文章)。它内部实际上也使用嵌入技术来理解输入,但最终目标是 “创造”。
嵌入模型(Embedding Model)是表示型模型。它的目标不是生成文本,而是为输入的文本创建一个最佳的、富含语义的数值表示 (向量)。
由于计算机天生擅长处理数字,但不理解文字图片的含义。嵌入(Embedding)的核心思想就是将人类世界的符号(如单词、句子、产品、用户、图片)转换为计算机能够理解的数值形式(即向量,本质上是一个数字列表),并且要求这种转换能够保留原始符号的语义和关系。
我们可以把它想象成一个翻译过程,把人类语言 “翻译” 成计算机的 “数学语言”。
结论:既然是 “数学语言”,那么我们可以用数学的方式来比较向量,从而达到【度量语义】的目的!
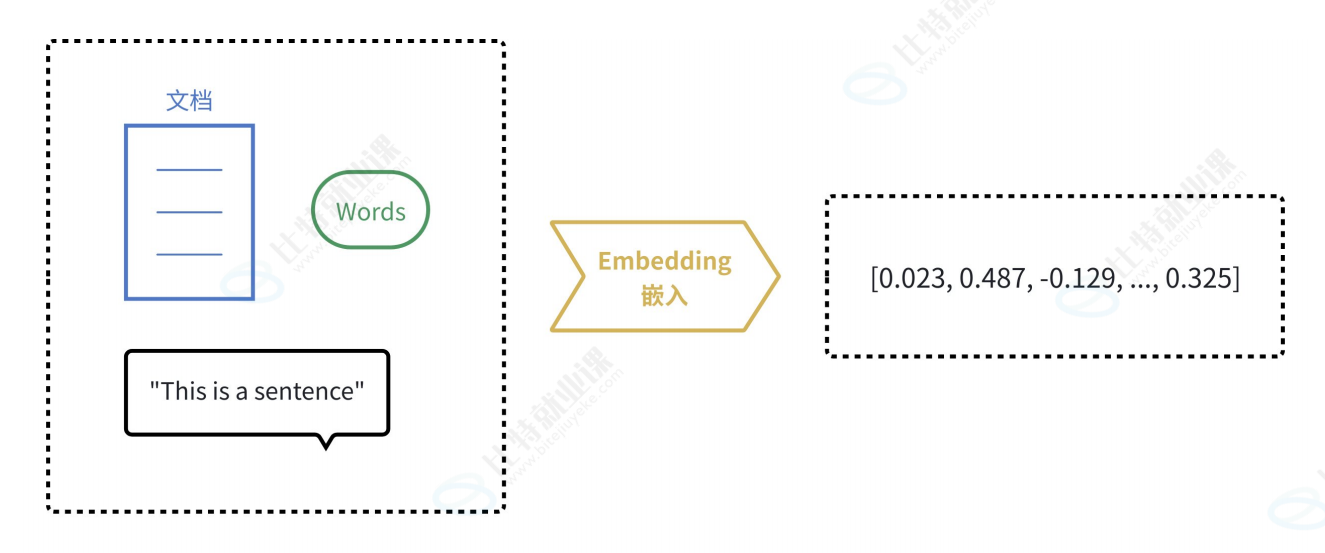
维度是什么:就是向量里面数字的个数,比如 3072 维,代表输出的向量列表里面一共有 3072 个浮点数。维度越高,携带的语义信息越多,向量数据库存储开销也会变大,部分模型支持降维,牺牲少量精度换取更小存储。
上下文长度:代表这一次最多能处理多长的文本,超过长度就要做文档切分。
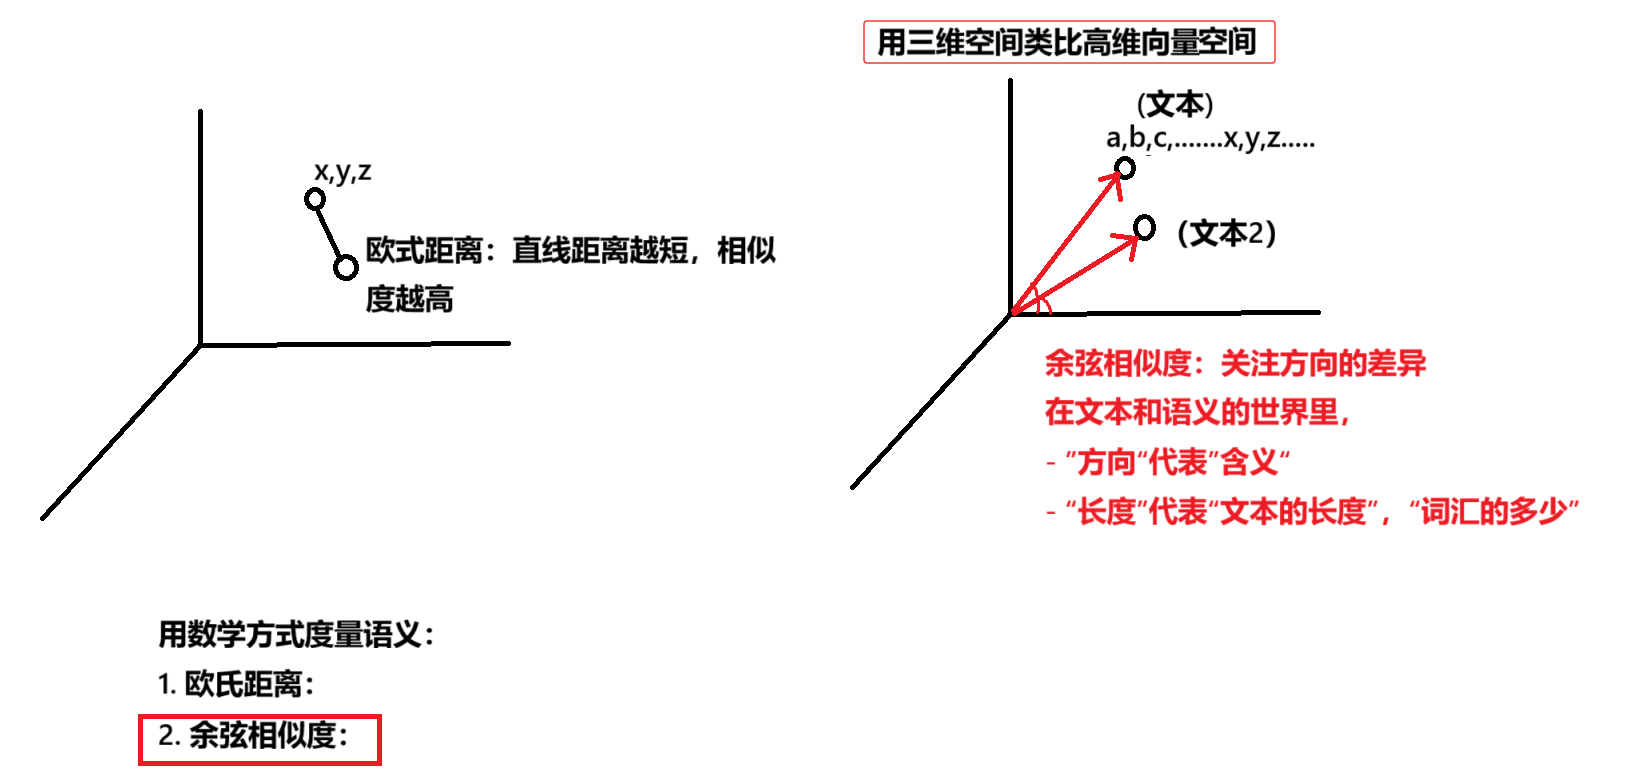
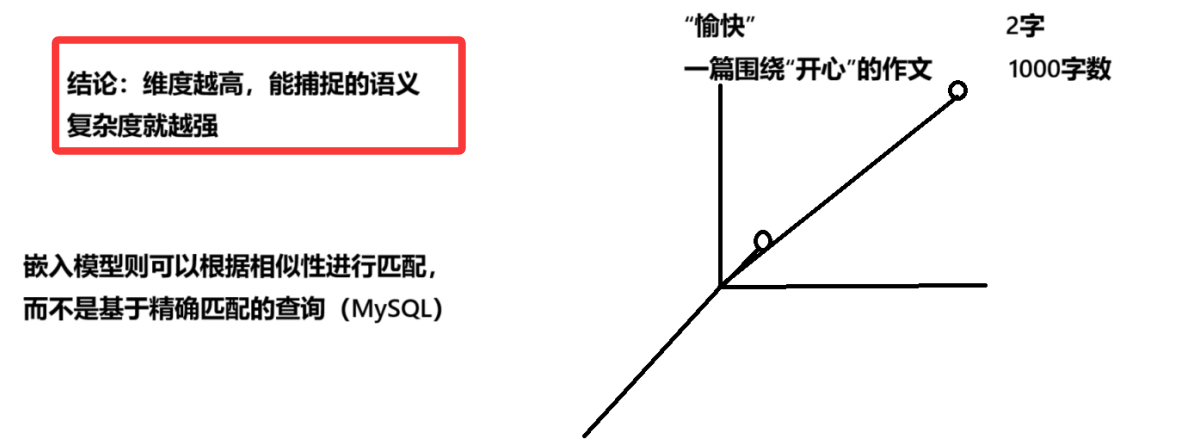
嵌入模型应用场景
根据嵌入的特性,由此延伸出许多嵌入模型在 AI 应用的使用场景:
语义搜索 (Semantic Search)
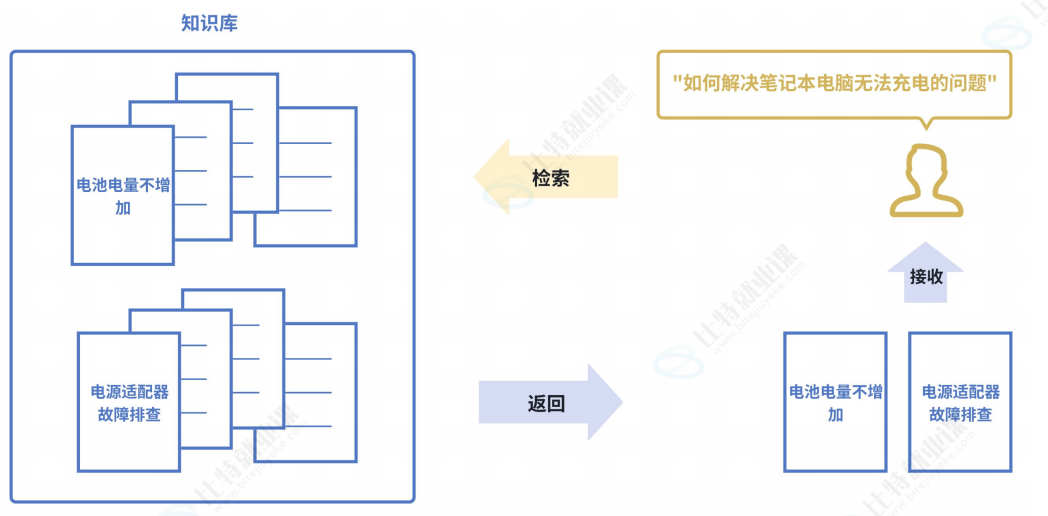
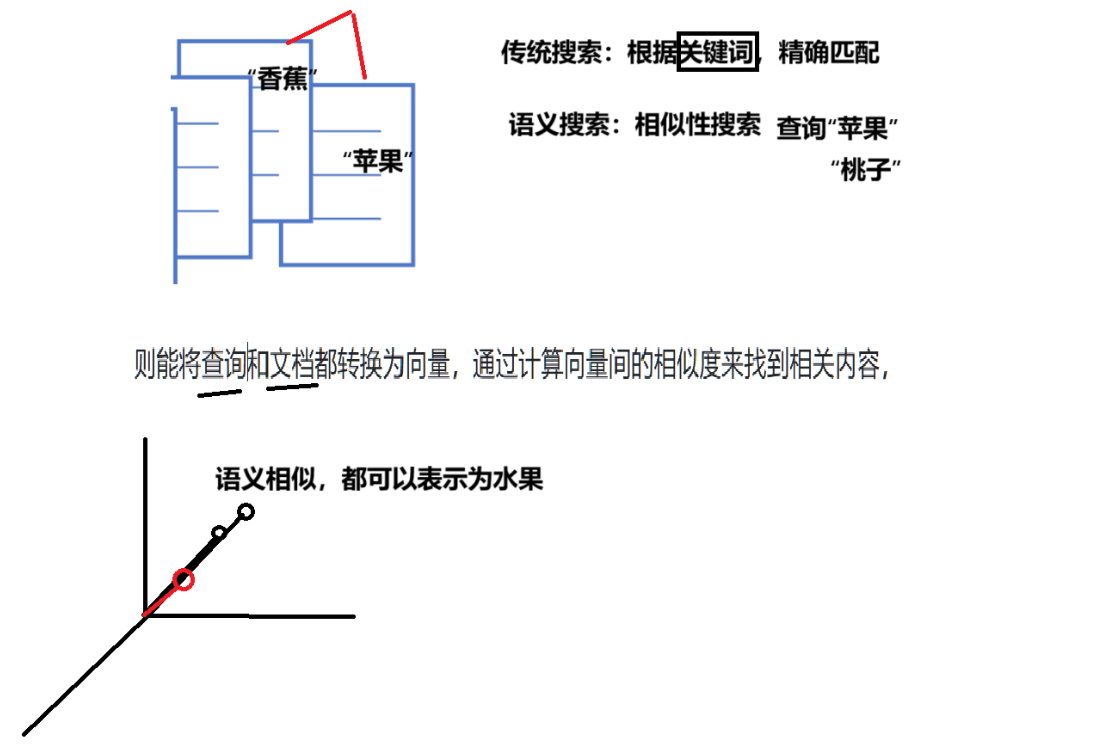
- 传统搜索 : 依赖关键词匹配 (搜 “苹果”),只能找到包含 “苹果” 这个词的文档。
- 语义搜索 : 则能将查询和文档都转换为向量,通过计算向量间的相似度来找到相关内容,即使文档中没有查询的确切词汇也能被检索到。即使知识库中并未直接出现 “笔记本电脑无法充电” 这个词组,语义搜索也能通过向量相似度精准地找到该文档。
检索增强生成 (Retrieval‑Augmented Generation,RAG)
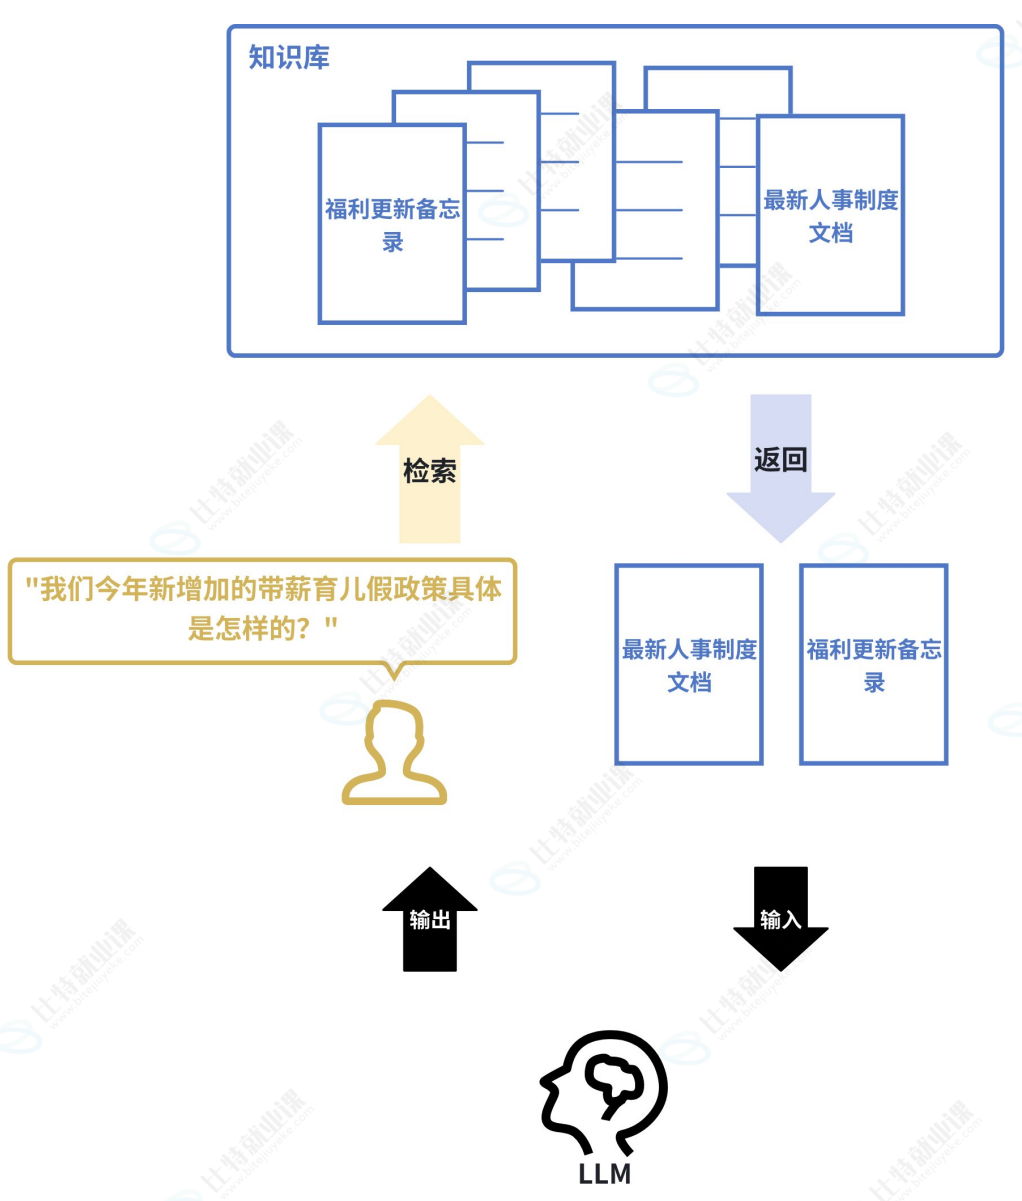
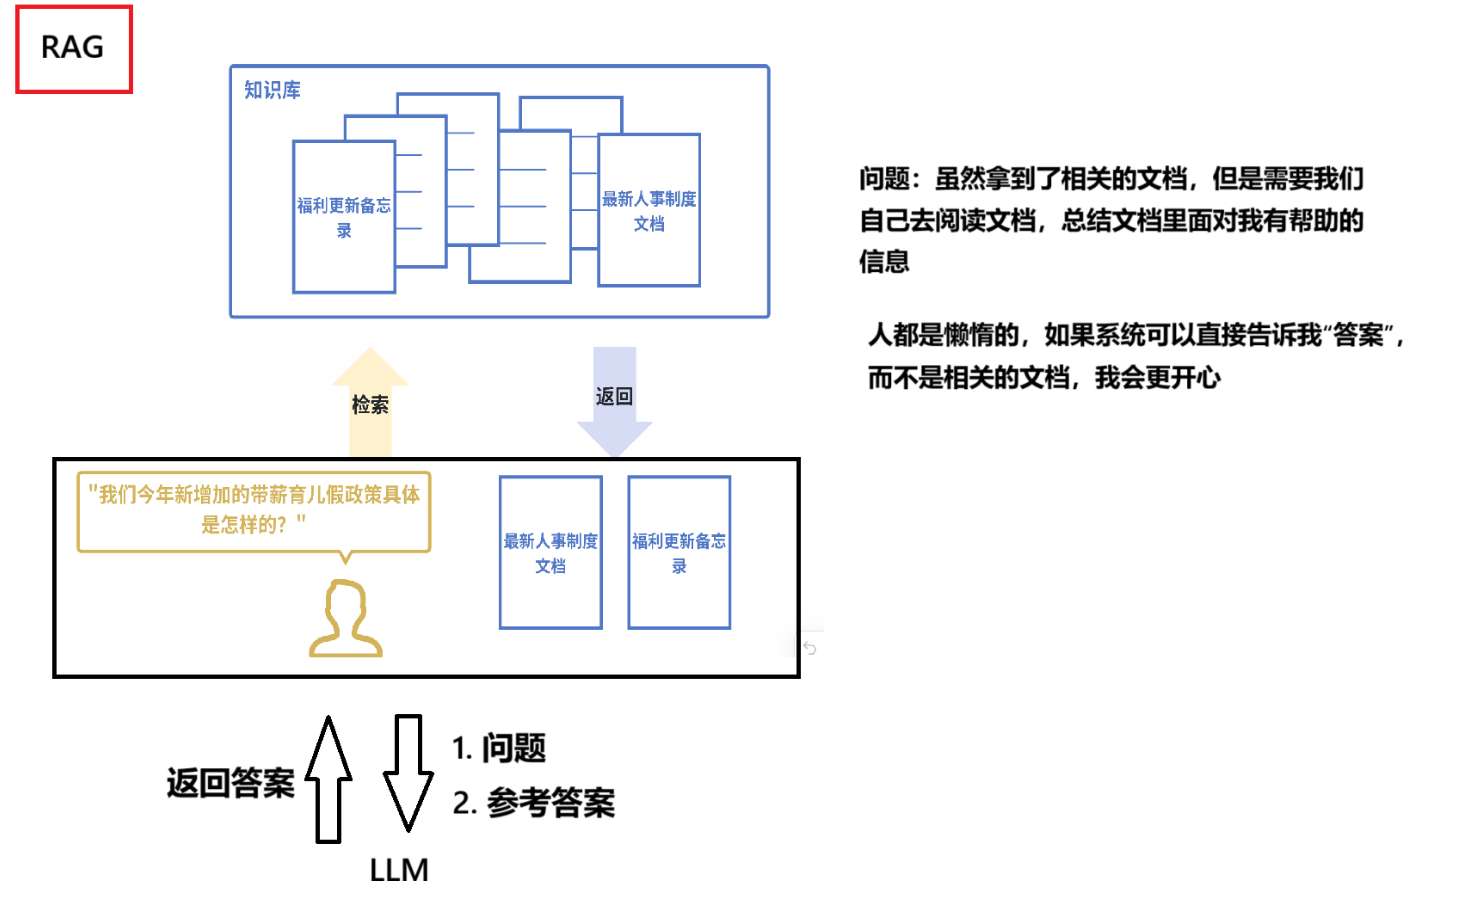
这是当前大语言模型应用的核心模式。当用户向 LLM 提问时,系统首先使用嵌入模型在知识库 (如公司内部文档) 中进行语义搜索,找到最相关的内容,然后将这些内容和问题一起交给 LLM 来生成答案。这极大地提高了答案的准确性和时效性。
例如:一家公司的内部客服机器人接到员工提问:“我们今年新增加的带薪育儿假政策具体是怎样的?” 系统会首先使用嵌入模型在公司的最新人事制度文档、福利更新备忘录等资料中进行语义搜索,找到关于 “今年育儿假规定” 的具体条款,然后将这些【条款】和【问题】一起提交给 LLM,LLM 便能生成一个准确、具体的摘要回答,而非仅凭其内部训练数据可能产生的过时或泛泛的答案。
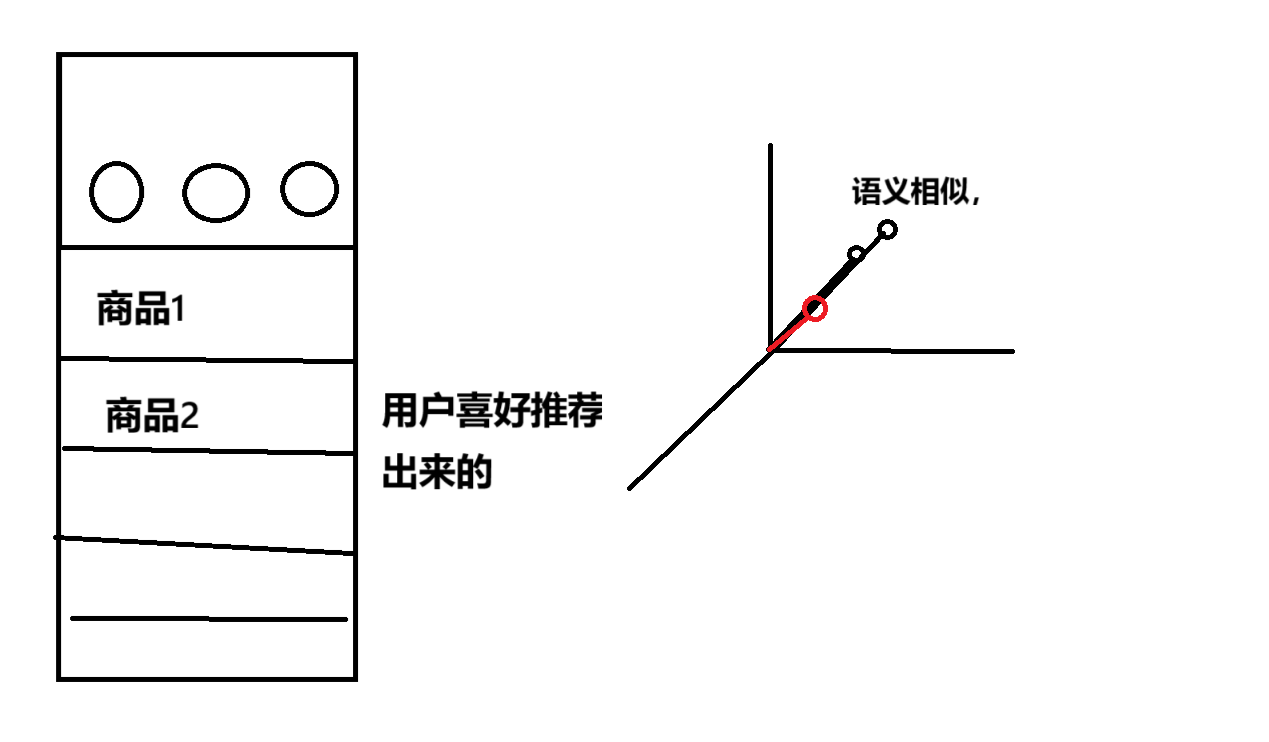
推荐系统 (Recommendation Systems)
将用户(根据其历史行为、偏好)和物品(商品、电影、新闻)都转换为向量。喜欢相似物品的用户其向量会接近;相似的物品其向量也会接近。通过计算用户和物品向量的相似度,就可以进行精准推荐。
例如:一个流媒体平台将用户 A(喜欢观看《盗梦空间》和《黑镜》)和所有电影都表示为向量。系统发现用户 A 的向量与那些也喜欢《盗梦空间》和《黑镜》的用户向量很接近,而这些用户普遍还喜欢《星际穿越》。尽管用户 A 从未看过《星际穿越》,但通过计算用户向量与电影向量的相似度,系统会将这部电影推荐给用户 A。
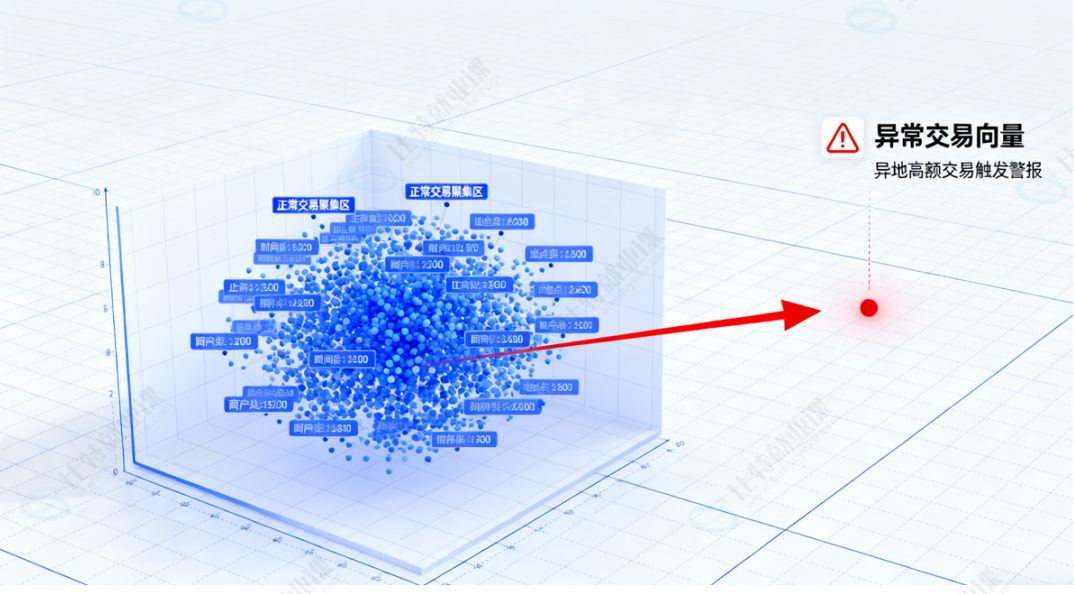
异常检测 (Anomaly Detection)
正常数据的向量通常会聚集在一起。如果一个新数据的向量远离大多数向量的聚集区,它就可能是一个异常点。
例如:一个信用卡交易反欺诈系统,通过学习海量正常交易记录(如金额、地点、时间、商户类型等特征的向量),形成了 “正常交易” 的向量聚集区。当一笔新的交易发生时,系统将其转换为向量。如果该向量出现在 “正常聚集区” 之外(例如,一笔发生在通常消费地之外的高额交易),系统则会将其标记为潜在的欺诈交易并进行警报。
主流的嵌入模型
-
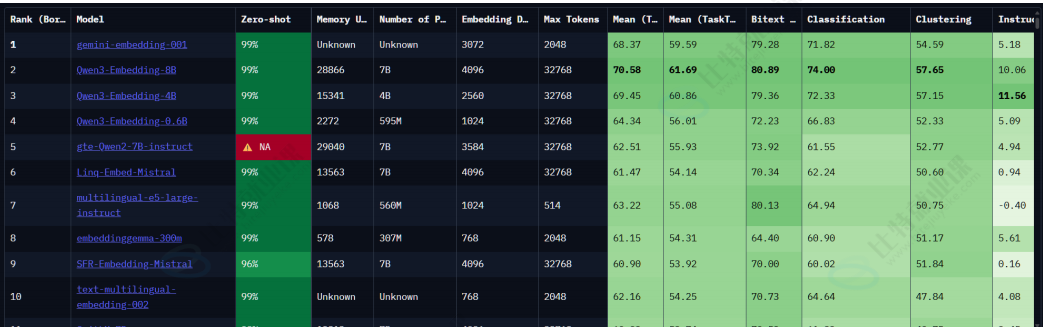
text‑embedding‑3‑large (OpenAI):OpenAI 最强大的英语和非英语任务嵌入模型。默认维度 3072,可降维如 1024 维;输入令牌长度支持为 8192。
-
Qwen3‑Embedding‑8B (阿里巴巴):开源模型,支持 100 + 种语言;上下文长度 32k;嵌入维度最高 4096,支持用户自定义的输出维度,范围从 32 到 4096。推理需要一定的 GPU 计算资源(例如,至少需要 16GB 以上显存的 GPU 才能高效运行)。
-
gemini‑embedding‑001 (Google):支持 100 + 种语言;默认维度 3072,可选降维版本:1536 维或 768 维;输入令牌长度支持为 2048。
其他参考:
- Huggingface 的 MTEB 评测:https://huggingface.co/spaces/mteb/leaderboard
Huggingface 的 MTEB(Massive Multilingual Text Embedding Benchmark)评测,是业界比较公认的标准。
二、嵌入模型接入方式
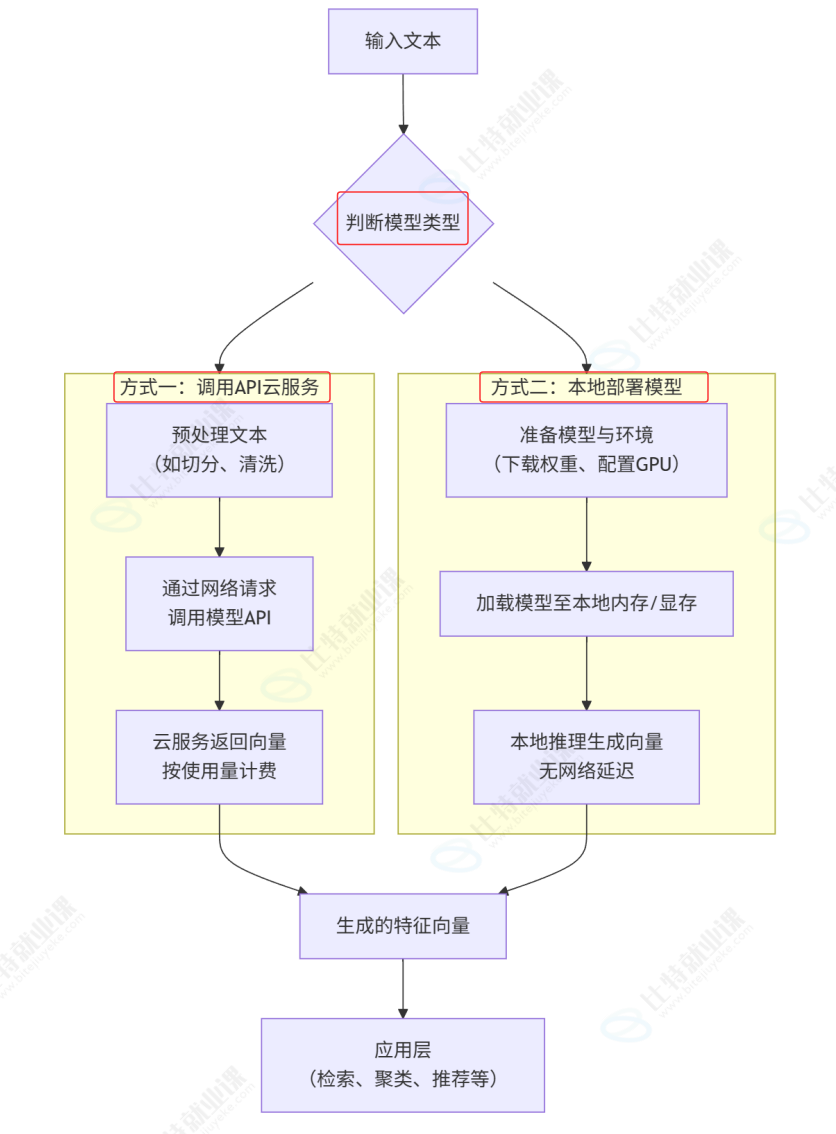
嵌入模型接入和使用方式根据模型类型(开源或闭源)有根本性的不同。下图清晰地展示了两种典型的接入流程。
API 接入 (闭源)
API 接入是最快速、最简单的方式,无需管理任何基础设施。只需要向模型提供商的服务端发送一个 HTTP 请求即可。
适用模型:text‑embedding‑3‑large,gemini‑embedding‑001 等。
通用步骤:
- 注册账号并获取 API Key:在对应的云服务平台(如 OpenAI Platform, Google AI Studio/Vertex AI)上注册账号,获取用于身份验证的 API Key。
- 安装 SDK 或构造 HTTP 请求:使用官方提供的 SDK(如
openai,google‑generativeai)或直接构造 HTTP 请求。 - 调用 API 并处理响应:发送文本,接收返回的 JSON 格式的向量数据。
示例 1:发起 HTTP 请求
响应结果包含嵌入向量(浮点数列表)以及一些其他元数据:
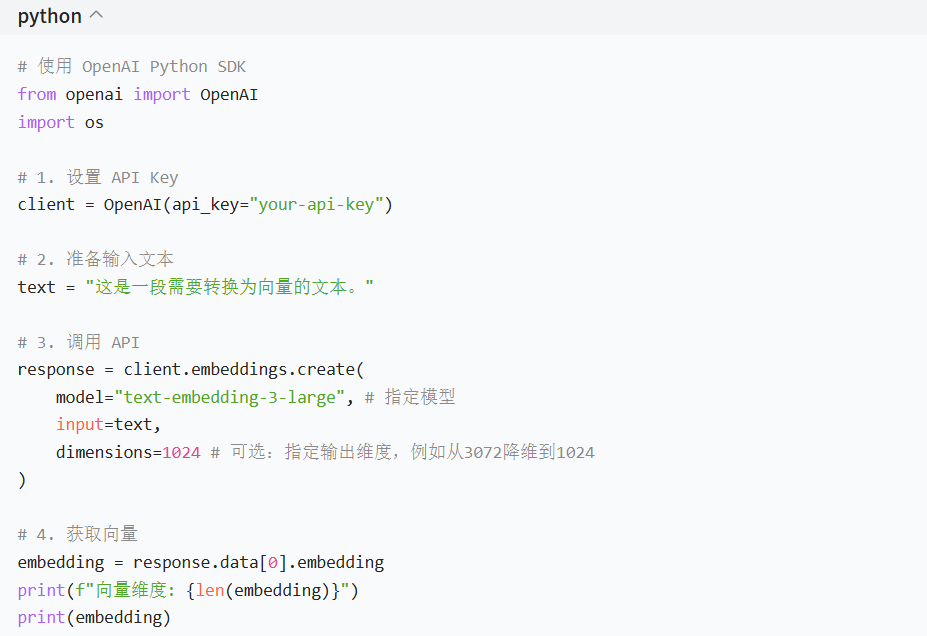
闭源嵌入模型 API 调用逻辑和调用大语言模型几乎一模一样。传进去一段文本,接口返回一大串数字向量,usage字段同样统计消耗的 token,嵌入模型也是按 token 计费。返回的embedding数组就是我们要存进向量数据库的向量。
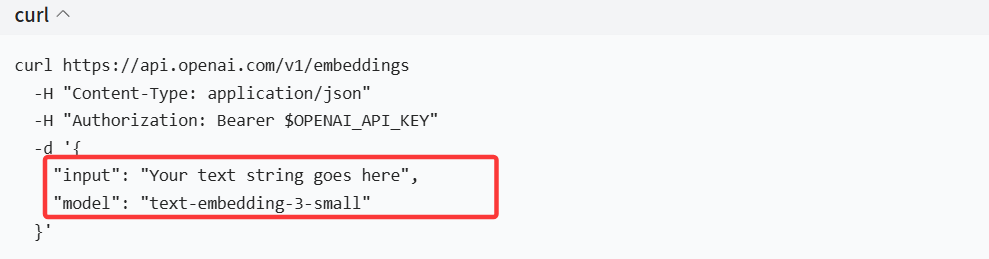
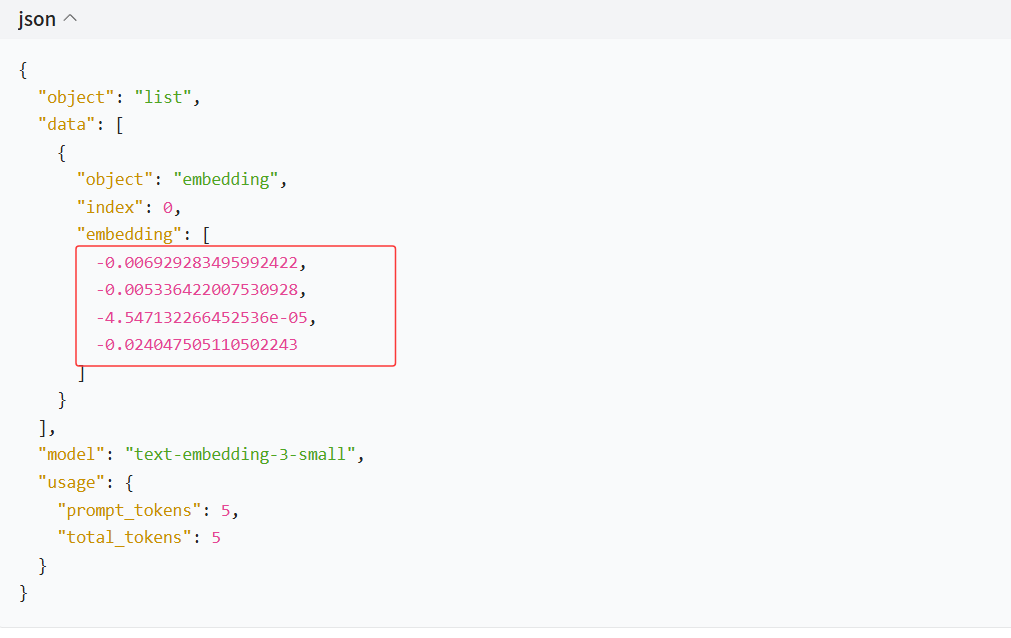
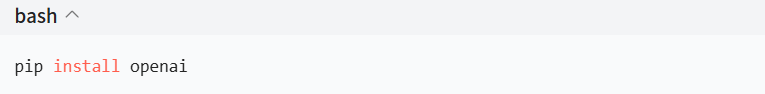
示例 2:接入 SDK
现在终端安装库:
示例代码:
本地部署 (开源)
本地部署方式需要自行准备计算资源(通常是带有 GPU 的机器)来运行模型,适合对数据隐私、成本和控制权有更高要求的场景。
适用模型:Qwen3‑Embedding‑8B 等。
通用步骤:
- 环境准备:准备一台有足够 GPU 显存的服务器(对于 Qwen3‑Embedding‑8B,需要至少 16GB 以上显存)。
- 模型下载:从 Hugging Face 等模型仓库下载模型权重文件和配置文件。
- 代码集成:使用像
transformers这样的库来加载模型并进行推理。
这部分有兴趣的可以下来自行研究。对于大多数初创项目或原型验证,从 API 方式开始是最佳选择。当应用规模化或面临严格的数据合规要求时,再考虑迁移到本地部署开源模型。
在实际应用中,直接调用嵌入模型获取结果,与直接调用原生 LLM 存在相似的问题:无论是通过 API 还是本地部署获得向量,下一步通常都是将它们存入向量数据库(如 Chroma,Milvus,Pinecone 等)以供后续检索。为了便于切换不同的嵌入模型,很多项目会使用像 LangChain 这样的框架,它们提供了统一的嵌入模型接口。
多种不同的嵌入模型全部接入 LangChain 框架统一接口,上层业务直接调用这一套接口,底层可以随意切换嵌入模型,业务代码不用大改。
三、模型平台
Hugging Face (国外)
Hugging Face 是一个知名的开源库和平台,该平台以其强大的 Transformer 模型库和易用的 API 而闻名,为开发者和研究人员提供了丰富的预训练模型、工具和资源。对于从事 AI 研究的人来说,其重要性不亚于 GitHub。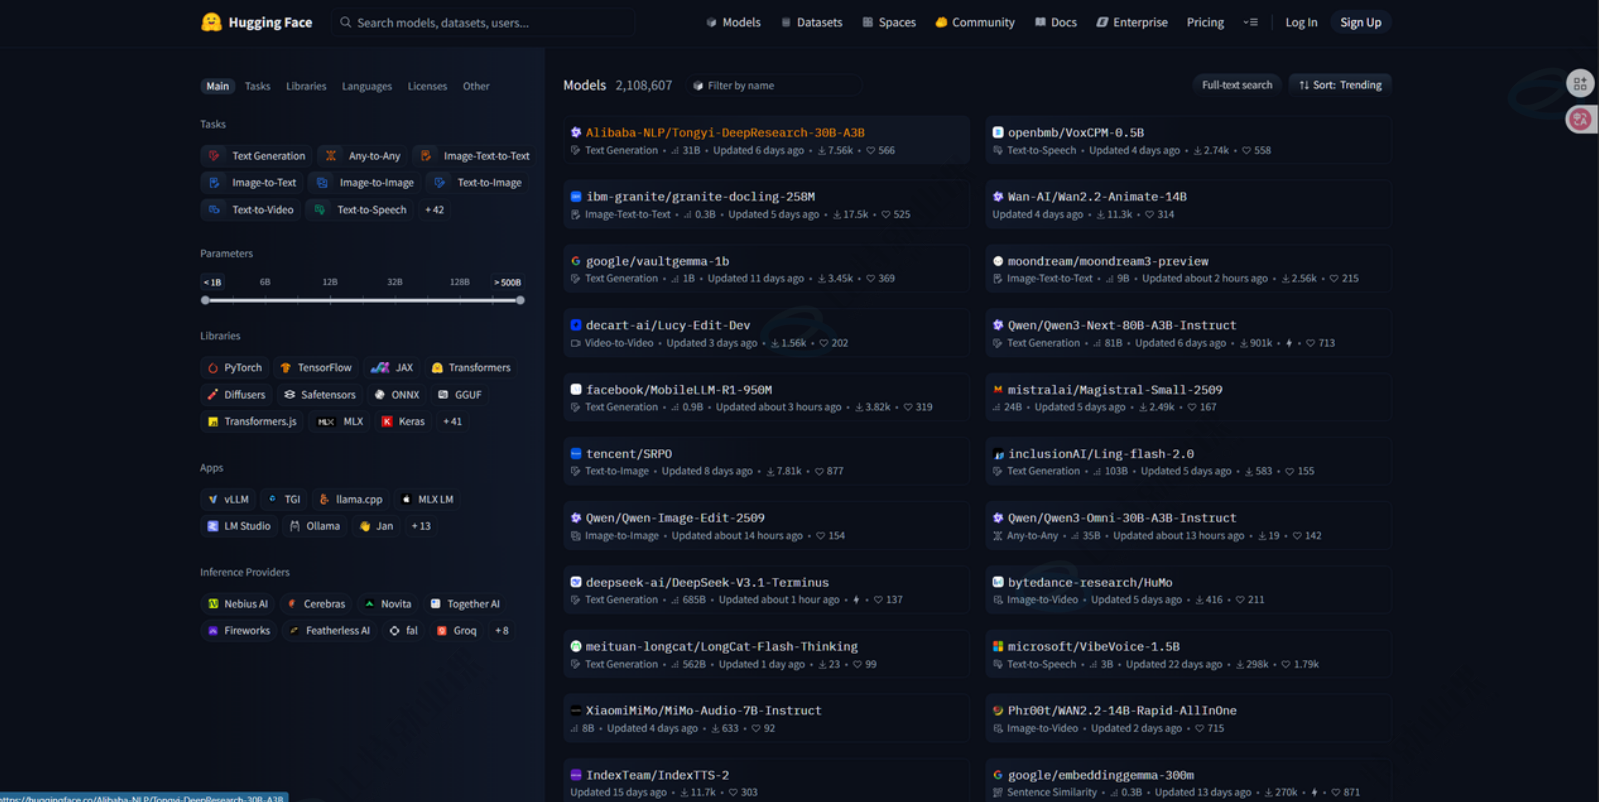
魔搭社区 (国内)
官网:ModelScope(界面和 HuggingFace 设计的基本一样)
魔搭(ModelScope)是由阿里巴巴达摩院推出的开源模型即服务(MaaS)共享平台,汇聚了计算机视觉、自然语言处理、语音等多领域的数千个预训练 AI 模型。其核心理念是 "开源、开放、共创",通过提供丰富的工具链和社区生态,降低 AI 开发门槛,尤其为企业本地私有化部署提供了一条高效路径。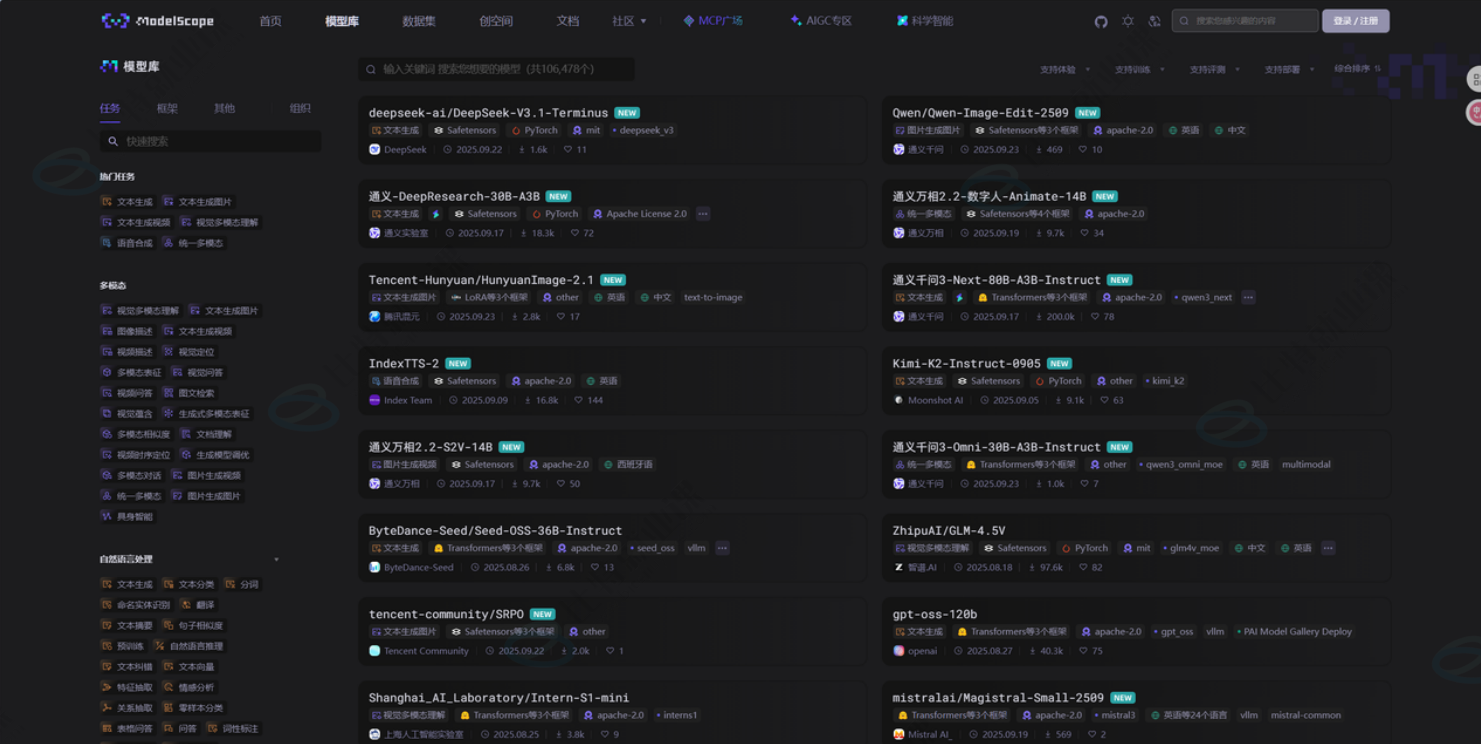
四、相关问题
Q1:嵌入模型,可以叫它嵌入式模型吗?二者意思一样吗?
不可以,二者含义完全不一样。 嵌入模型对应英文
Embedding Model,专门用来把文本转换成向量;而 “嵌入式模型” 一般指部署在单片机、开发板这类嵌入式硬件设备上运行的 AI 模型。仅仅英文词根相同,中文只差一个字,指代的事物完全不同,开发场景里要严格区分叫法。
Q2:LLM 大语言模型就是生成式模型,接收问题然后生成答案,对吗?
对。ChatGPT、DeepSeek、Gemini、豆包全部属于生成式大语言模型。输入问题或者提示词,模型输出全新的文本内容,核心能力就是生成文字回答。
Q3:大语言模型内部会使用嵌入技术吗?
会。大模型在处理输入文本的时候,内部会把词语转化成向量,这个过程就是嵌入技术。但要分清:大模型只是内部使用嵌入技术作为中间计算环节,它本身并不是嵌入模型,对外输出依然是可读文本,不是向量数组。
Q4:大语言模型和嵌入模型是 AI 下两个不同的模型分支吗?
是的。二者训练目标、输出产物不同。大语言模型是生成式模型,输出文本,负责理解、创作、回答问题;嵌入模型是表示性模型,只输出向量数字,不生成文字,专门用来做语义编码、相似度比对。二者属于独立的两类模型。
Q5:同一个厂商,既可以拥有大语言模型,也可以拥有嵌入模型吗?比如 OpenAI、DeepSeek?
完全可以,二者并不矛盾。OpenAI 既有 GPT 系列大语言模型,也有 text‑embedding 系列嵌入模型;DeepSeek 既有对话大模型,也有 deepseek‑embedding 嵌入模型;阿里千问同样同时具备对话 LLM 和 Qwen3‑Embedding 嵌入模型。它们是两套独立训练的模型产品,开发的时候可以单独调用,RAG 场景下就会把两者搭配协同工作。
Q6:普通用户、开发人员,分别什么情况下会接触嵌入模型?
普通日常用户几乎感知不到嵌入模型,网页端聊天全程只用大语言模型。开发人员如果只是简单做对话调用,也可以完全不用嵌入模型;只有开发 RAG 知识库、语义检索这类业务的时候才需要主动显式调用嵌入模型,完成文档向量化并存入向量数据库。
Q7:国内 DeepSeek、阿里千问,都有配套的嵌入模型吗?
都有。阿里有 Qwen3‑Embedding 系列,支持 API 调用,也可以开源本地部署;DeepSeek 提供 deepseek‑embedding 系列,同样支持 API 与开源部署,字节、智谱等国内厂商也都有自家嵌入模型。
Q8:不管是各类大语言模型,还是各式各样的嵌入模型,LangChain 都能提供统一接口,实现接入吗?
对。LangChain 做了一层抽象封装,对外提供统一的调用接口。底层我们可以随意切换:OpenAI 的 LLM、DeepSeek 的 LLM、千问 LLM,或是 OpenAI 嵌入模型、Qwen 本地开源嵌入模型。上层业务代码不需要大规模改动,只需要更换模型配置参数即可,这也是 LangChain 框架很核心的价值。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 10
 0
- 0


 已为社区贡献8条内容

所有评论(0)