WorkMate 如何模拟人类记忆:让 AI 越用越懂你
引子:上一秒刚告诉它,下一秒就问你是谁
你有没有遇到过这样的 AI:上一秒你刚告诉它你的名字、你的需求、你的偏好,下一秒它又问"请问您是谁?"
这不是段子,是很多 AI Agent 的真实状态。它们有一个通病,叫"失忆症"——对话一结束,上下文清零,下次启动就是一个全新的陌生人。你昨天刚让它帮你调好的配置,今天再问"上次那个问题解决了吗",它一脸茫然。
这背后的原因,是大多数 AI Agent 根本没有"记忆"这个概念。它们靠的是一块有限的"上下文窗口",装得下就记得,装不下就忘。而窗口一旦满了,最早的信息就被无情地截断丢弃——哪怕那条信息恰恰是最关键的。
那么,人类是怎么解决这个问题的?人类有记忆。而 WorkMate 的聪明之处,就在于它模拟了人类的记忆模式,让 AI 也能"记住过去、参照习惯、越用越懂你"。
一、Agent 的"失忆困境":问题出在哪
先看看,Agent 在对话过程中,到底会遇到哪些问题。归纳起来,主要是四个。
第一个问题:上下文丢失。 这是最核心的问题。AI Agent 在多轮对话或长期任务中,一旦超出模型的上下文窗口限制,又没有建立持久记忆机制,早期信息就会被截断、遗忘。结果就是回答前后矛盾、重复询问用户、任务中断。有研究显示,朴素的全上下文方案,token 消耗比记忆层方案高出约 10 倍,响应延迟高出约 91%。
第二个问题:"中间遗忘"。 大模型的注意力机制存在一个"中间遗忘"现象——上下文越长,模型越容易"迷失"。即使是最新的模型,在超长上下文场景下,中间部分的信息召回率也会显著下降。也就是说,它可能记得开头,记得结尾,却把中间最关键的内容忘了。
第三个问题:多 Agent 接力漏话。 一些系统采用多个 Agent 分工协作,一个负责理解意图、一个查数据库、一个生成回复。听起来很优雅,实际跑起来像几个同事接力传话,每传一次就漏一点上下文。有团队复盘后发现,70% 的 token 消耗在了重复传递背景信息上,真正用于回答问题的只占三成。
第四个问题:成本失控。 上下文越长,每次调用的成本就越高。如果管理不当,一个 Agent 一天处理上千次对话,费用可能翻 3 到 5 倍。
这四个问题,本质上是同一个根源:Agent 只有"工作记忆",没有"长期记忆"。 它只能记住当前这一小段对话,记不住过去,更记不住"你这个人"。
二、人类是怎么记忆的:三层记忆的智慧
要解决 Agent 的失忆问题,最好的老师,其实是人类自己。因为人类的大脑,天然就是一套精妙的记忆系统。
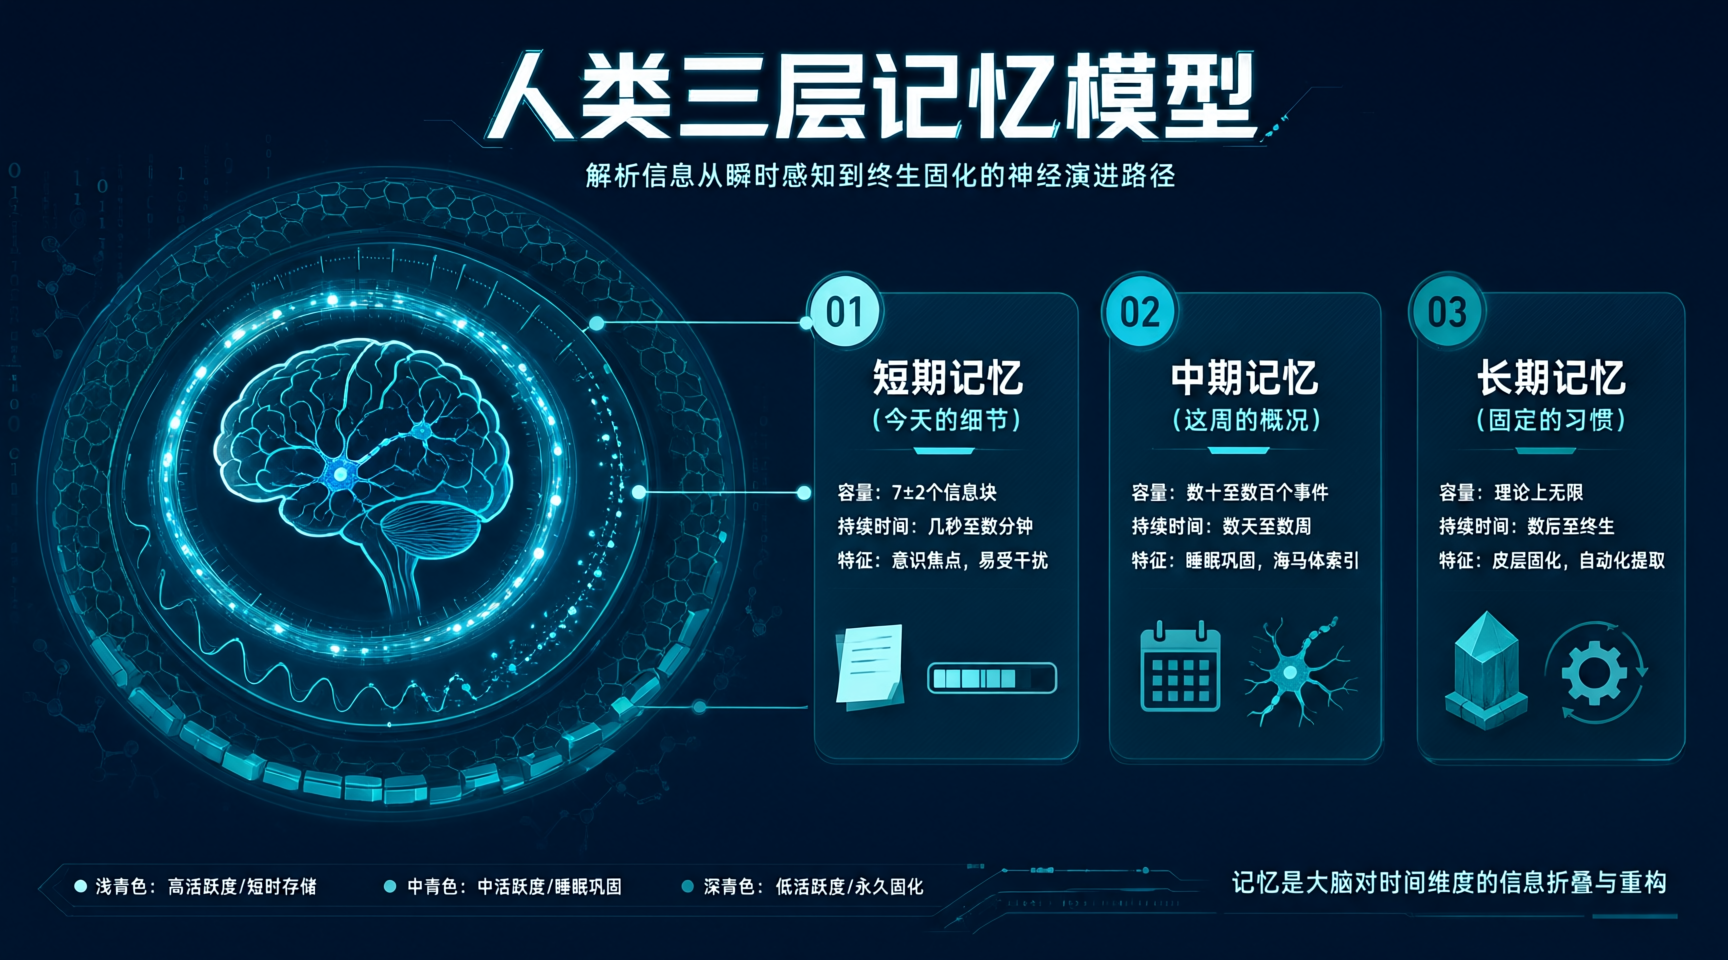
人类记忆,大致可以分成三层。
第一层,短期记忆——记住今天的细节。 你今天上午开了什么会、见了谁、聊了什么,这些细节你都记得清清楚楚。短期记忆容量不大,但足够鲜活,能支撑你处理"当下正在发生的事"。
第二层,中期记忆——记住这周的概况。 这周你完成了哪些事项、大致情况如何,你心里有数。虽然记不住每一句话的细节,但你知道"这周做了三件事,其中两件已经完成,一件还在推进"。中期记忆帮你把握"最近一段时间的脉络"。
第三层,长期记忆——形成固定的习惯。 你习惯用表格呈现数据、喜欢简洁的文风、偏好用中文沟通……这些是长期积累下来的"习惯和偏好"。它们不占用你当下的注意力,却在你做每一件事时,悄悄地影响你的选择。
而人类执行任务时,有一个关键的动作:先回忆,再参照。
当你接到一个新任务,你不会从零开始。你会先回忆——"这件事我以前做过吗?当时是怎么做的?用了什么方法、走了什么步骤?"然后,你会参照过去的习惯和惯例——"我习惯怎么处理这类事?我的标准是什么?"
这就是人类高效的原因:我们不是每一次都重新发明轮子,而是站在过去的记忆和经验之上。
三、WorkMate 的三层记忆架构:把人类的记忆模式搬进 AI
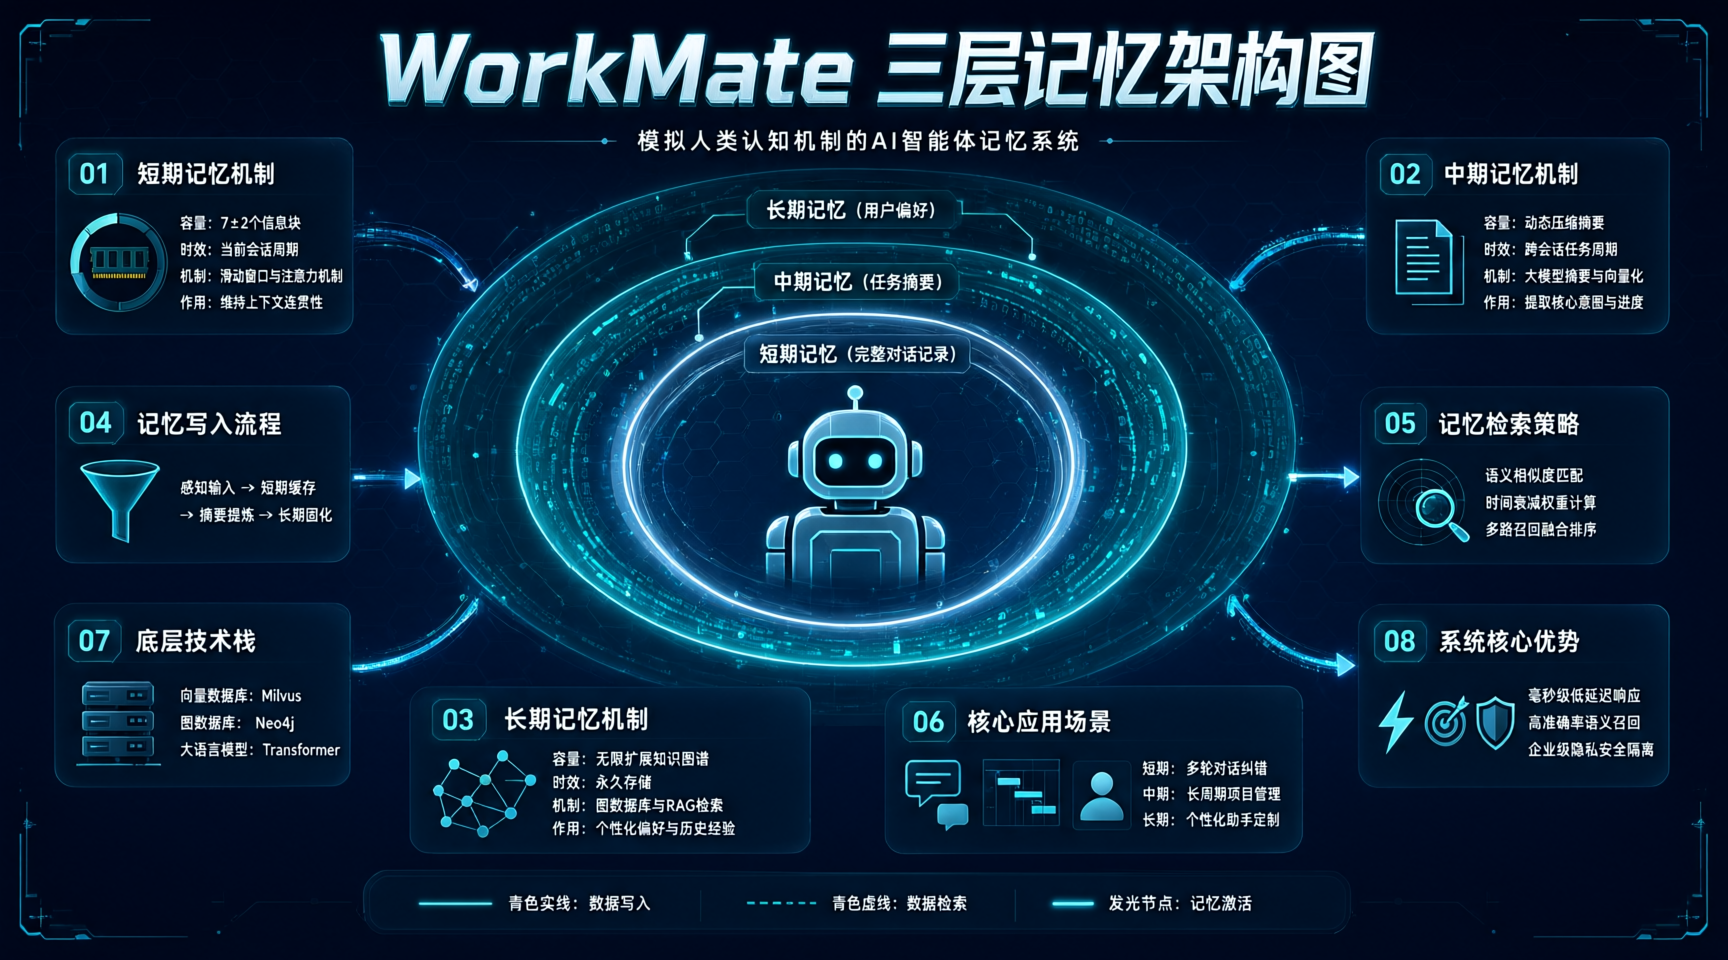
WorkMate 的设计者显然深谙这一点。它的记忆系统,就是一套模拟人类记忆的三层架构。
短期记忆,对应人类的"记住今天的细节"。 WorkMate 存储用户最近完成任务的完整对话记录,为 AI 提供最近任务的完整上下文。这样,当你在一个连续的任务里和 AI 协作时,它能记住你前面说过的话、做过的决定,不会"聊着聊着就忘了"。
中期记忆,对应人类的"记住这周的概况"。 WorkMate 会在每次任务完成后,自动调用大模型生成一段不超过 300 字的对话摘要,重点保留用户的需求、决策和关键结论。这些摘要,就是 AI 的"中期记忆"——它记不住每一句话的细节,但记得住"最近做过哪些事、大致是什么情况"。
长期记忆,对应人类的"形成固定的习惯"。 WorkMate 会通过一个"后评估器",在任务完成后自动分析用户输入和 AI 回复,提取用户的稳定偏好——比如"报告要简洁""用表格呈现""请用中文""发邮件通知"。这些偏好,就是 AI 的"长期记忆",是它对你这个人的"习惯画像"。
更精妙的是,WorkMate 还模拟了人类"先回忆、再参照"的执行方式。它有一个"相关记忆搜索"机制:当你发起一个新任务时,AI 会先去历史记忆里搜索——"有没有处理过类似的事情?当时是怎么做的?"然后把这些相关经验加载进来,作为当前任务的参照。
这就和人类一样了:接到新任务,先回忆类似经验,再参照过去的习惯,最后动手做。
四、WorkMate 如何组织上下文:记忆的"注入"与"管理"
三层记忆架构是"骨架",但要真正发挥作用,还需要一套精密的"记忆管理"机制。WorkMate 在这方面下了不少功夫。
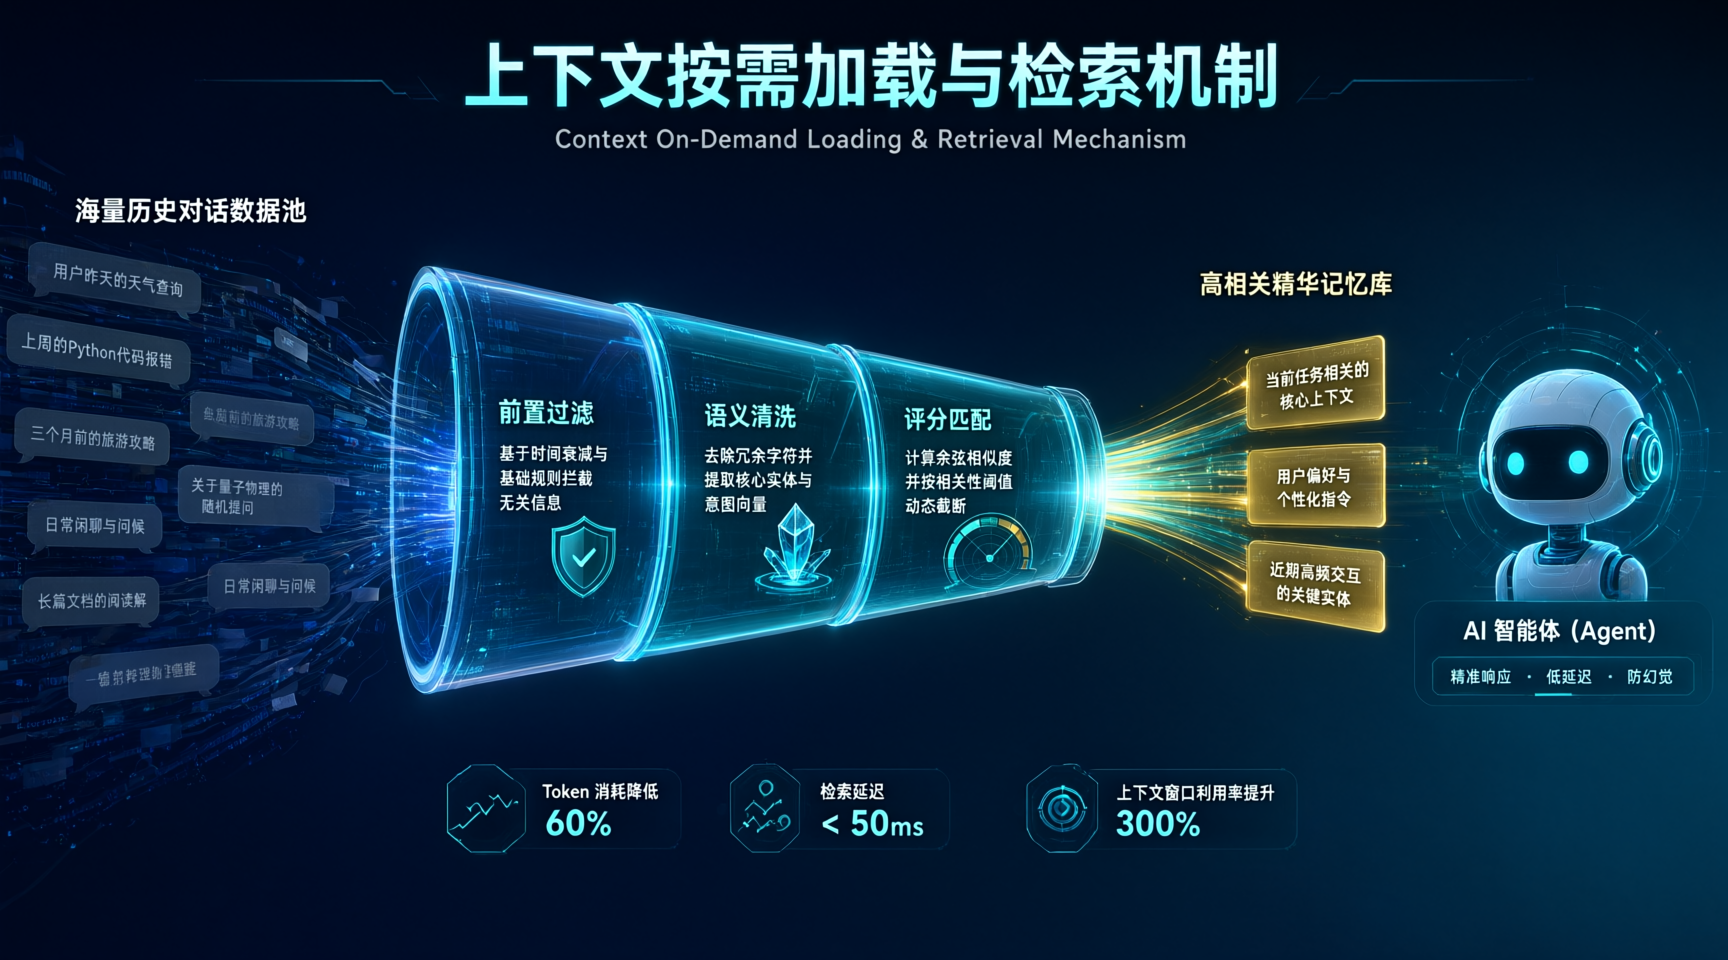
第一,按需加载,而不是全量塞入。 很多 Agent 的做法,是把所有历史对话一股脑塞进 prompt,结果上下文窗口很快爆掉,成本飙升。WorkMate 恰恰相反——它不加载全部历史,只在需要时检索相关记忆。系统提示词构建时,会并行加载三层记忆:中期记忆(摘要)、长期记忆(偏好)、相关记忆(主题搜索),然后按"长期→中期→相关"的顺序注入。这样既保证了 AI 有足够的记忆,又避免了上下文膨胀。
第二,三层防护的相关记忆搜索。 为了避免"为了搜索而搜索",WorkMate 给相关记忆搜索设置了三层防护:第一层,剥离来源前缀标记,获得纯净的查询语义;第二层,前置过滤,跳过"你好""测试"这类无实质内容的短句;第三层,LLM 评分匹配,对候选摘要进行 0-10 分评分,只保留 5 分以上的高相关结果。这套机制确保"回忆"是精准的,而不是"想起一堆无关的东西"。
第三,对话压缩,保留关键链路。 当对话过长时,WorkMate 会自动压缩——保留任务执行链路(触发、思考、执行、结论),去除冗余噪声(冗长数据、重复寒暄、无效试错)。这样,即使是很长的对话,也能被压缩成"精华",既不丢失关键信息,又不占用太多空间。
第四,偏好自动提取与去重。 后评估器在任务完成后,会用大模型分析对话,提取用户偏好,然后与已有偏好做语义去重——避免"图片文字语言:中文"和"图片文本要求:中文"这种重复条目。只保存真正新增的偏好,让长期记忆保持干净、准确。
五、为什么 WorkMate 能越用越懂你、越用越聪明
把这一切串起来,就能回答那个最关键的问题:为什么 WorkMate 能越用越懂用户、越用越聪明?
答案,藏在"记忆的循环沉淀"里。
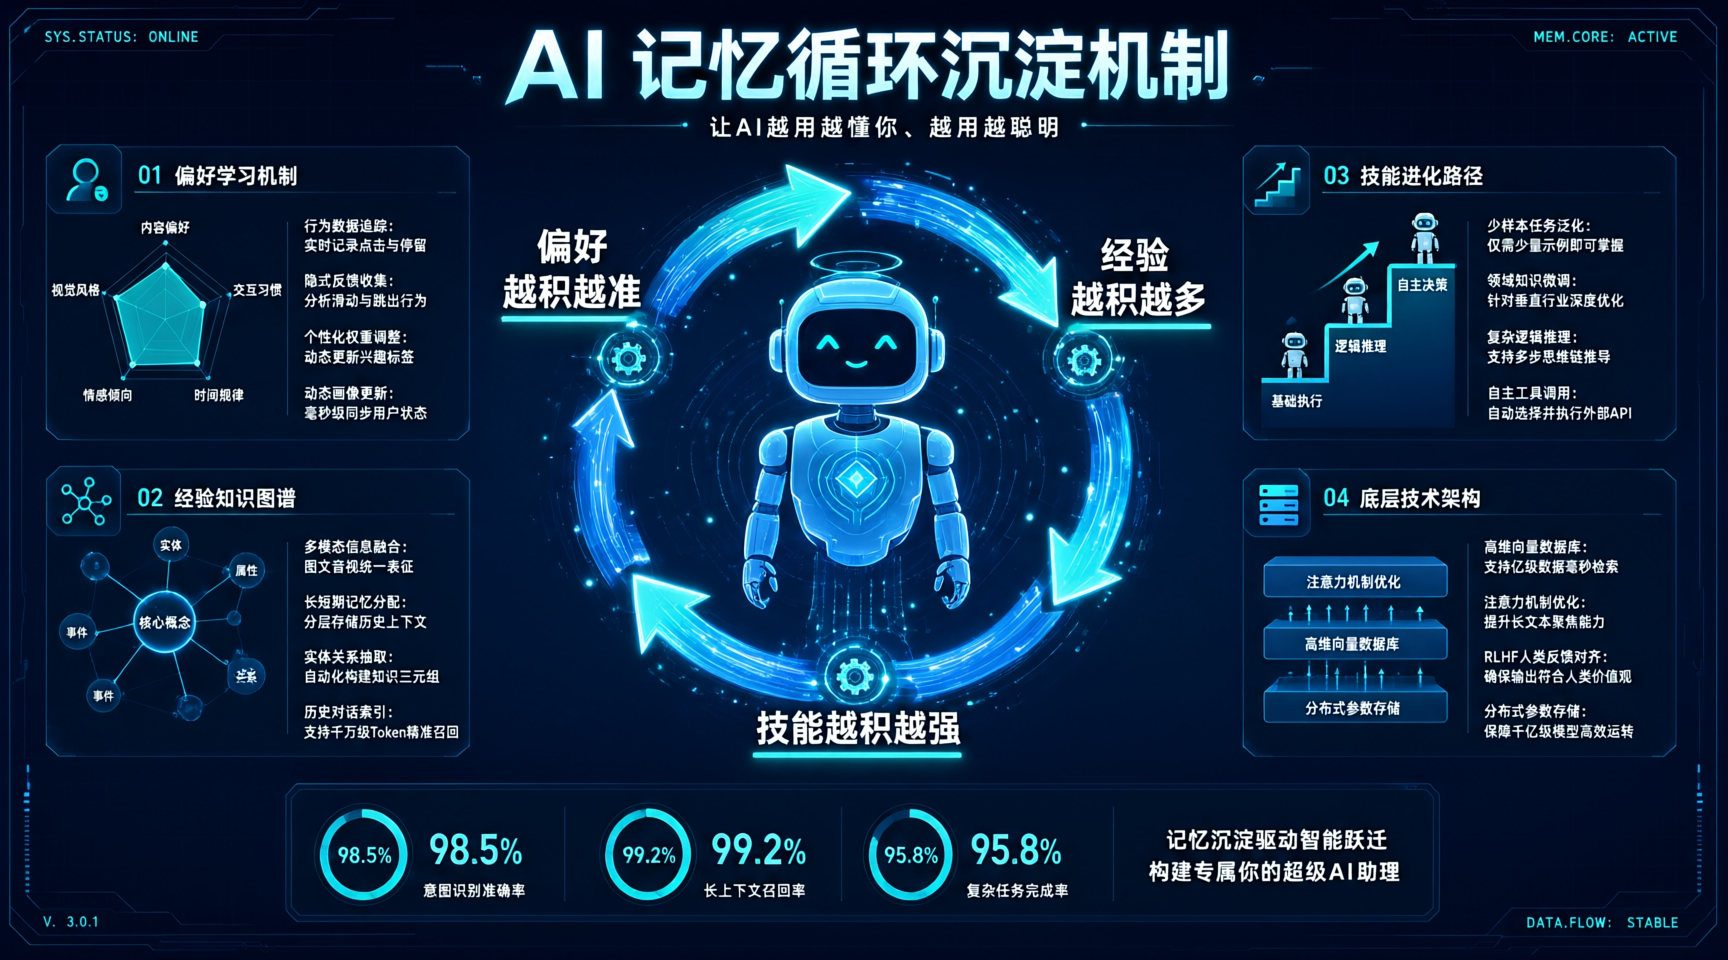
第一层循环:偏好越积越准。 每一次任务完成,后评估器都会从对话中提取你的偏好,并沉淀到长期记忆。用得越多,AI 对你的习惯画像就越完整、越准确。第一次它可能只知道"你喜欢用表格",第十次它就知道"你喜欢用表格呈现关键事项清单和时间倒排表,截止时间默认设周五下午三点"。这就是"越用越懂你"。
第二层循环:经验越积越多。 每一次任务完成,都会生成一份摘要,沉淀到中期记忆。当你下次遇到类似任务时,相关记忆搜索会把过去的经验找出来,供 AI 参照。用得越多,AI 可参照的"历史经验"就越丰富,处理新任务时就越有章法。这就是"越用越有经验"。
第三层循环:技能越积越强。 WorkMate 的后评估器,还会利用记忆系统存储的对话,自动评估"是否需要创建新技能、改进已有技能"。当它发现你反复做某类重复性操作时,会把这些经验沉淀成"技能",下次直接调用。用得越多,AI 掌握的技能就越多,能力就越强。这就是"越用越聪明"。
这三层循环,让 WorkMate 从一个"每次从零开始的工具",变成了一个"带着记忆和习惯成长的伙伴"。它记得你的偏好、记得过去的经验、记得学到的技能,并且把这些记忆持续地沉淀、更新、复用。
结语:记忆,是 AI 从"工具"变成"伙伴"的分水岭
回到开头那个问题:为什么很多 AI 会"上一秒刚告诉它,下一秒就问你是谁"?
因为它们没有记忆。而没有记忆的 AI,永远只能是一个"工具"——你用一次,它忘一次,你们之间没有任何积累。
WorkMate 的不同,在于它把"记忆"这件事,当成了整个系统的核心。它模拟了人类的记忆模式——短期记住细节、中期记住概况、长期形成习惯;它模拟了人类的执行方式——先回忆类似经验,再参照过去的习惯;它甚至模拟了人类的成长方式——把每一次经历,都沉淀成下一次的养分。
正是这套记忆系统,让 WorkMate 从"工具"走向了"伙伴"。它越用越懂你,越用越有经验,越用越聪明。而这一切的起点,其实很简单——让 AI 学会"记住"。


有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)