我们可能一直低估了 Agent Harness:真正决定 Agent 能力的,已经不只是模型
这段时间我一直在看 Agent,尤其是 DeepSeek 最近开源的 DeepSeek Harness。
刚开始接触 Harness 这个概念时,我其实有一个很直接的疑问:
Agent 不就是大模型 + Function Calling(函数调用)+ 一套循环吗?
LangGraph、MCP、RAG 这些东西都已经有了,为什么现在又开始讲 Harness?
但把 DeepSeek Harness、Claude Code、Codex 这些东西真正拆开来看以后,我的看法发生了比较大的变化。
现在我越来越觉得,今天很多 Agent 产品真正拉开差距的地方,已经不完全是模型,而是模型外面的那一整套运行系统。
也就是 Harness。
DeepSeek 在自己的 Harness 页面上直接写了一句话:
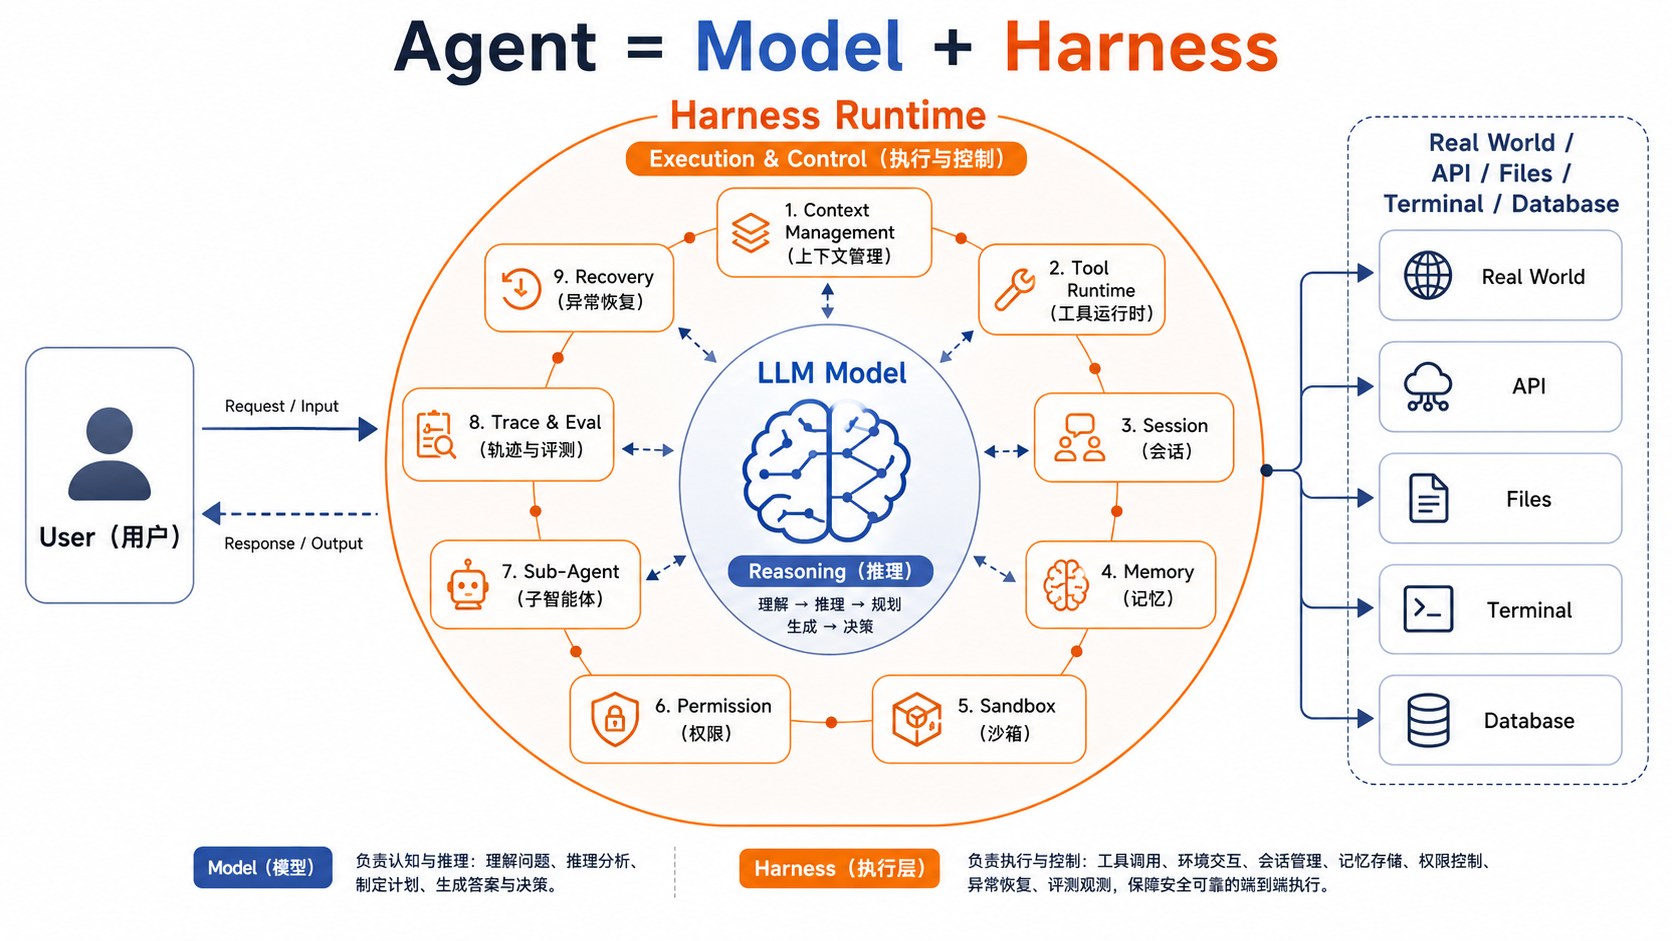
Agent = Model + Harness
这个表达其实很准确。
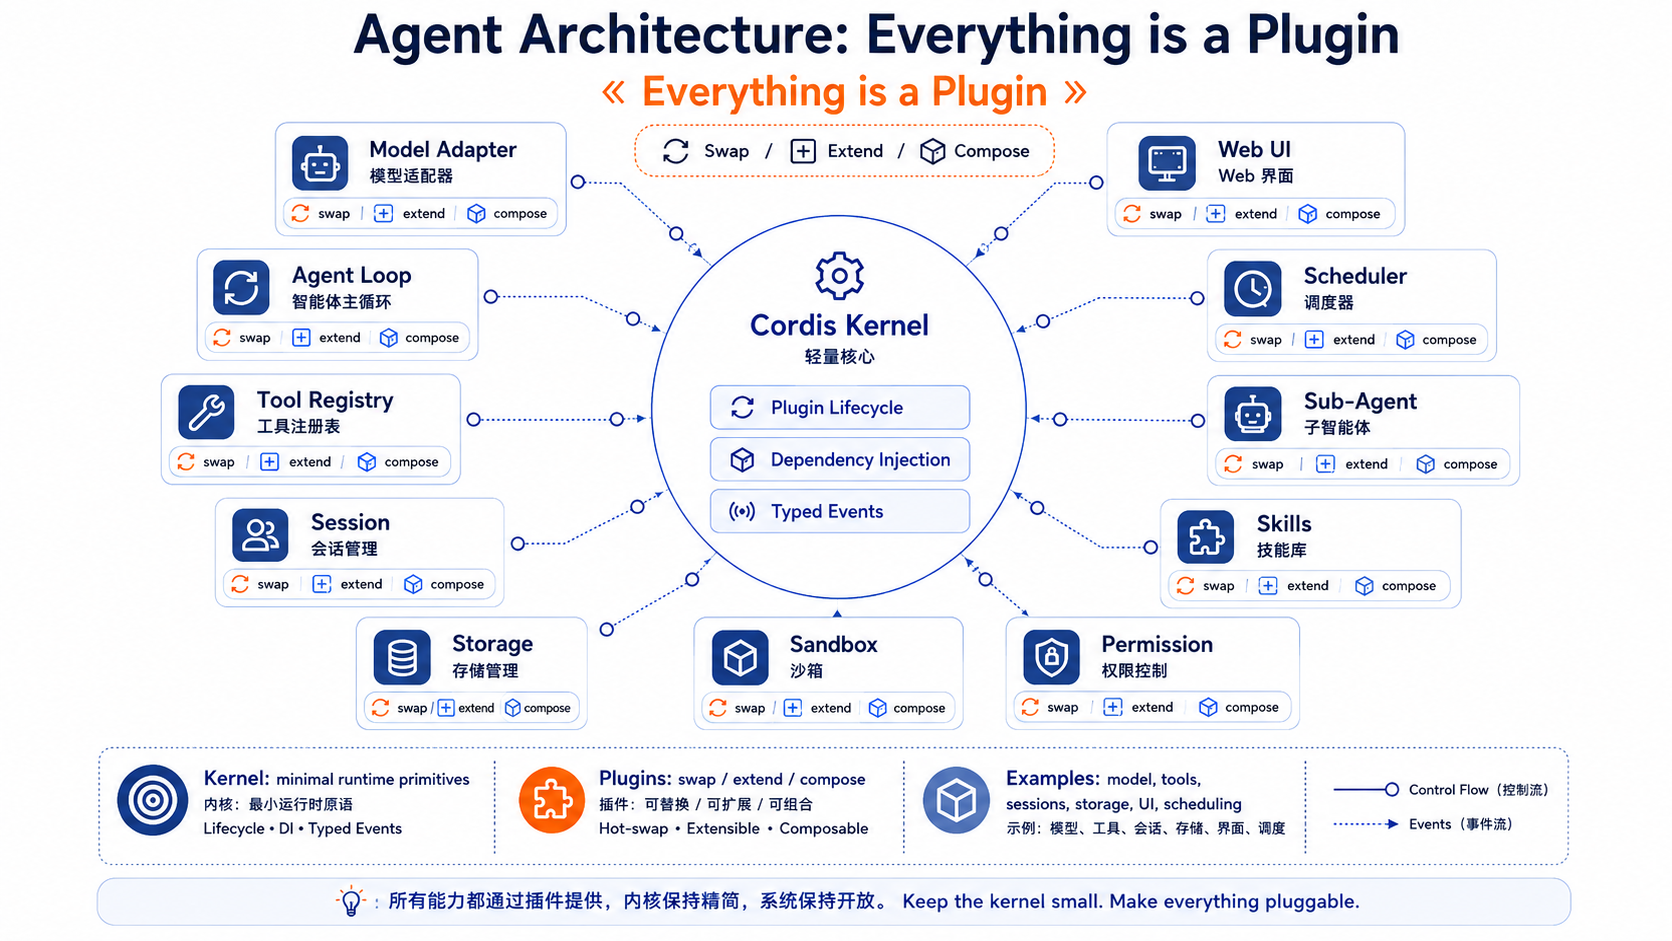
模型提供推理能力,而 Harness 决定模型能看到什么、能调用什么、工具到底允不允许执行、执行失败怎么办、上下文什么时候压缩、任务怎么恢复、子 Agent 怎么调度,以及这一整条执行过程能不能被追踪和复现。DeepSeek Harness 甚至把 model、tools、skills、sessions、sandboxes、storage、loops、scheduling 和 UI 都拆成了可替换插件。
2026 年 OpenAI 自己也开始频繁使用 Harness Engineering(Harness 工程)这个词。OpenAI 在一篇工程文章里提到,他们用 Codex 搭建了一个约百万行代码的内部产品,团队越来越少直接“写代码”,而是把精力放在环境、约束、文档、反馈循环和验证系统上。文章里有一句很有意思的话:
Humans steer. Agents execute.
也就是,人负责设计系统,Agent 负责执行。
这其实就是 Harness Engineering(Harness 工程)开始受到关注的原因。
一、先把 Harness 说清楚:它其实不是另一个 Agent 框架
我最开始容易把 Harness 和 LangGraph 这一类框架混到一起。
后来发现两者关注的问题其实不完全一样。
LangGraph 更偏向:
节点 A
  ↓
节点 B
  ↓
条件判断
 ↙   ↘
C     D
也就是说,它很适合描述:
Agent 的工作流应该怎么走。
而 Harness 的问题更底层一点。
它关心的是:
模型这一轮为什么被调用?

模型看到了哪些上下文?

模型现在允许使用哪些工具?

模型返回的 Tool Call 合法吗?

参数对不对?

这个 Tool Call 到底能不能真正执行?

应该在宿主机执行还是 Sandbox 中执行?

执行失败以后重试还是终止?

执行结果以什么格式重新进入模型?

这个过程有没有留下 Trace?

程序崩了以后能不能 Resume?

上下文爆了以后怎么办?

子 Agent 怎么启动?

子 Agent 用什么模型、什么工具、什么 Harness?

什么时候认为任务真的结束?
所以我现在更愿意把 Harness 理解成:
大模型和真实世界之间的 Agent Runtime(智能体运行时)+ Control Plane(控制平面)。
如果用操作系统打比方,大模型更像 CPU。
CPU 很强,但只有 CPU 还远远不够。
进程怎么调度、内存怎么管理、文件怎么访问、权限怎么控制、异常怎么处理,这些都是操作系统负责的。
Agent 其实也是一样。
二、Agent Loop 其实没有想象中复杂,真正复杂的是 Loop 外面的东西
如果只看最简单的 Agent Loop(智能体循环),代码甚至可以很短。
逻辑无非就是:
while True:
    response = llm(messages, tools)

    if response.tool_calls:
        for call in response.tool_calls:
            result = execute_tool(call)
            messages.append(result)
    else:
        return response
模型先思考。
需要工具就调用工具。
Harness 执行工具,把 Observation(观察结果)重新交给模型。
模型继续思考。
直到模型不再调用工具,返回 Final Answer(最终回答)。
OpenAI 对 Codex Agent Loop 的公开解释基本也是这个结构:用户输入进入模型,模型可能直接回答,也可能产生 Tool Call;Agent 执行工具,把结果加入后续输入,再次调用模型,直到结束。
DeepSeek 当前默认的 Agent Loop 是一个典型的 ReAct-style(ReAct 风格)循环:模型生成响应,如果产生 Tool Call,则 Harness 执行工具,并将结果重新加入 Session,再进入下一次模型调用。
但这里需要区分两个概念。Agent Loop 是 Harness 层面的运行控制机制,而 ReAct 是循环内部可以采用的一种推理—行动策略。 DeepSeek 默认实现叫 ReactLoopAgent,并不意味着 Agent Loop 与 ReAct 是同一个概念。事实上,DeepSeek 将 Loop 本身设计成可替换能力,未来完全可以换成 Planner-Executor(规划-执行)、Reflection(反思)或其他循环策略。
DeepSeek 默认循环本质仍然是:
LLM
 ↓
Tool Call
 ↓
Observation
 ↓
LLM
 ↓
Tool Call
 ↓
...
 ↓
Final Answer
只是到了产品级系统以后,真正的代码不会是前面那十几行。
实际更接近:
while True:

    request = context_manager.build(session)

    response = model.invoke(request)

    session.append(response)

    for tool_call in response.tool_calls:

        tool = tool_registry.resolve(tool_call.name)

        args = schema_validator.validate(
            tool.schema,
            tool_call.arguments
        )

        permission.check(tool, args)

        result = sandbox.execute(
            tool,
            args
        )

        session.append(result)

    if termination_policy.should_stop(session):
        break
这里真正值得研究的,其实不是 while True。
而是:
context_manager
tool_registry
schema_validator
permission
sandbox
session
termination_policy
这些才是 Harness。
也正因为如此,同一个模型放到不同 Harness 里面,最终表现可能完全不像同一个 Agent。
三、DeepSeek Harness 最有意思的地方,并不是 Agent Loop,而是“一切皆插件”
DeepSeek Harness 给我的第一感觉其实不是“它的 Agent Loop 多先进”。
恰恰相反。
它的 Agent Loop 反而比较克制。
真正有意思的是它底层的设计:
Everything is a Plugin(一切皆插件)。
DeepSeek Harness 底层用了一个叫 Cordis 的插件系统。
模型是插件。
Tool Registry(工具注册表)是插件。
Session(会话)是插件。
Agent Loop 是插件。
Sandbox 是插件。
Storage 是插件。
甚至 UI 也是插件。
这就产生了一个很有意思的结果。
以前我们做 Agent,经常是:
Agent
 ├─ 写死 OpenAI
 ├─ 写死 Tool Calling
 ├─ 写死 Memory
 ├─ 写死 Loop
 └─ 写死 Executor
换一个东西,就要改主体代码。
DeepSeek 的思路则更像:
                Cordis Context
                       │
        ┌──────────────┼──────────────┐
        │              │              │
      Model          Session         Tools
        │              │              │
      Plugin          Plugin         Plugin
        │              │              │
        ├──── Sandbox Plugin ─────────┤
        │
        ├──── Agent Loop Plugin
        │
        └──── SubAgent Plugin
Agent 本身反而逐渐变成了一个“组装结果”。
你甚至可以替换 Agent Loop,而不必重新写整个 Agent。
这点我觉得非常关键。
因为它意味着:
模型不再是 Agent 系统唯一可以替换的东西,连 Agent 的运行逻辑本身都可以替换。
这才是真正意义上的 Harness。
四、我最喜欢 DeepSeek Harness 的其实是 Session
Harness 里面我目前最感兴趣的不是 Tool Calling,而是 Session(会话)。
因为以前我们开发 Agent,很容易把 Session 理解成:
messages = [
    {"role": "user", ...},
    {"role": "assistant", ...},
    {"role": "tool", ...}
]
然后:
messages = Session
但 DeepSeek Harness 不是这个思路。
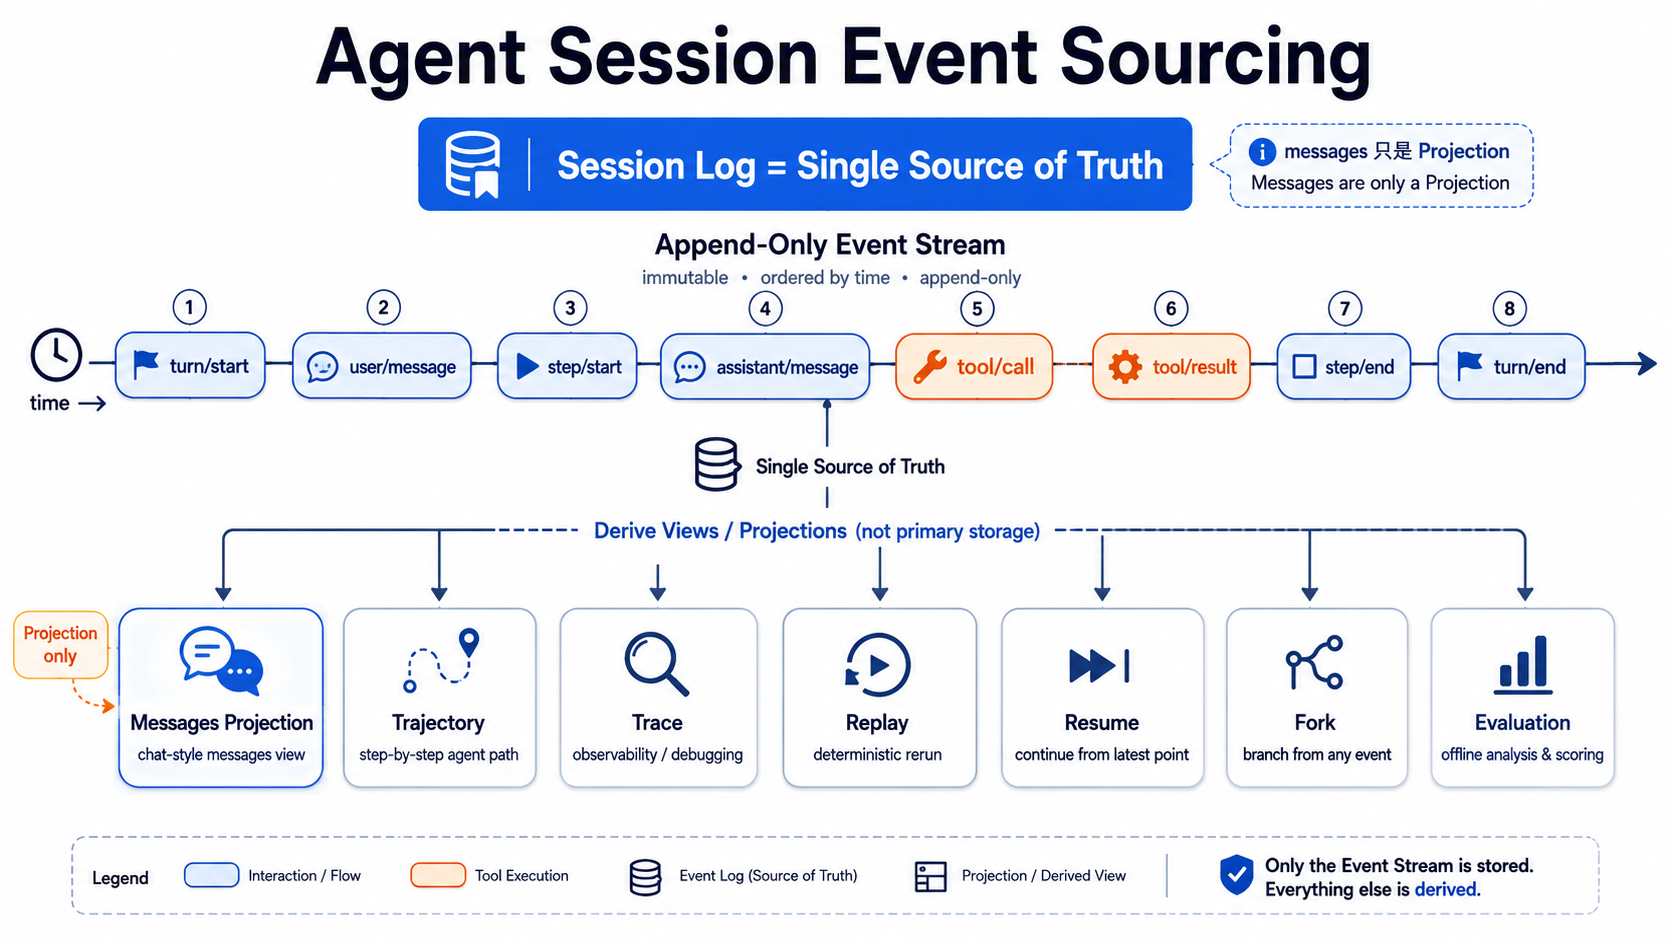
它现在的 Session 更接近 Event Sourcing(事件溯源)。
官方设计里,一个 Session 是:
append-only typed SessionEvent log
也就是:
仅追加的类型化事件日志。
LLM 使用的 messages 并不是事实源,而是从 Session Event(会话事件)里面派生出来的一种 Projection(投影视图)。
于是一个 Session 里面就不只是:
User Message
Assistant Message
还可以记录:
turn/start

user/message

step/start

assistant/message

tool/call

tool/result

step/end

turn/end
包括 Compaction(上下文压缩)、Hook、Usage、Request Header 等,也都可以成为事件。
这看起来只是“日志记得更细”,但其实影响非常大。
因为一旦 Session 变成事实源:
Session Event Log
       │
       ├──► Messages
       │
       ├──► UI
       │
       ├──► Trace
       │
       ├──► Replay
       │
       ├──► Resume
       │
       └──► Eval
很多原本需要单独维护的东西突然统一了。
这也是为什么 DeepSeek 可以做到:
Resume
Fork
Search
Replay
Trajectory
都基于同一条 Event Stream(事件流)。官方甚至明确表示,模型看到的系统提示词、工具调用与结果、子 Agent 调度以及上下文注入等,都可以进入 Session Log。
这比“我额外接一个日志系统记录一下 Tool Call”要完整得多。
Session 还有一个很容易被忽略的作用:Crash Recovery(崩溃恢复)
假设 Agent 调用了一个工具:
delete_file()
Harness 已经开始执行了。
结果程序突然崩了。
重新启动之后,如果系统只是保存了:
messages
那就很麻烦。
因为你可能不知道:
这个 Tool 到底有没有执行?

执行了一半?

已经执行成功但结果没写回来?

还是压根没执行?
如果 Harness 直接重试,对于查询类工具可能无所谓。
但如果这是:
转账
删文件
发邮件
创建订单
提交数据库事务
盲目重试就可能产生严重问题。
DeepSeek 的 Session Persistence(会话持久化)专门区分了类似:
TOOL_NOT_STARTED

TOOL_OUTCOME_UNKNOWN
这种状态。
如果工具已经留下 tool/call,却没有留下最终结果,恢复时 Harness 会把它视为“结果未知”,而不是简单地重新执行。对于可能产生 Side Effect(副作用)的工具,需要先检查外部状态,而不是无脑 Retry(重试)。
这个细节其实非常“工程”。
而且它恰恰说明:
Agent 从 Demo 走向 Production(生产环境)以后,难点已经不是“模型会不会调用工具”这么简单了。
五、Function Calling 最大的问题,不是模型会不会返回 JSON
这也是我最近想法变化比较大的一个地方。
之前做 Function Calling(函数调用)时,很容易把问题理解成:
怎么通过 Prompt 让模型稳定输出 JSON?
后来我越来越觉得这个思路有问题。
模型输出:
{
  "tool": "delete_file",
  "path": "/xxx"
}
并不意味着 Harness 就应该直接:
delete_file("/xxx")
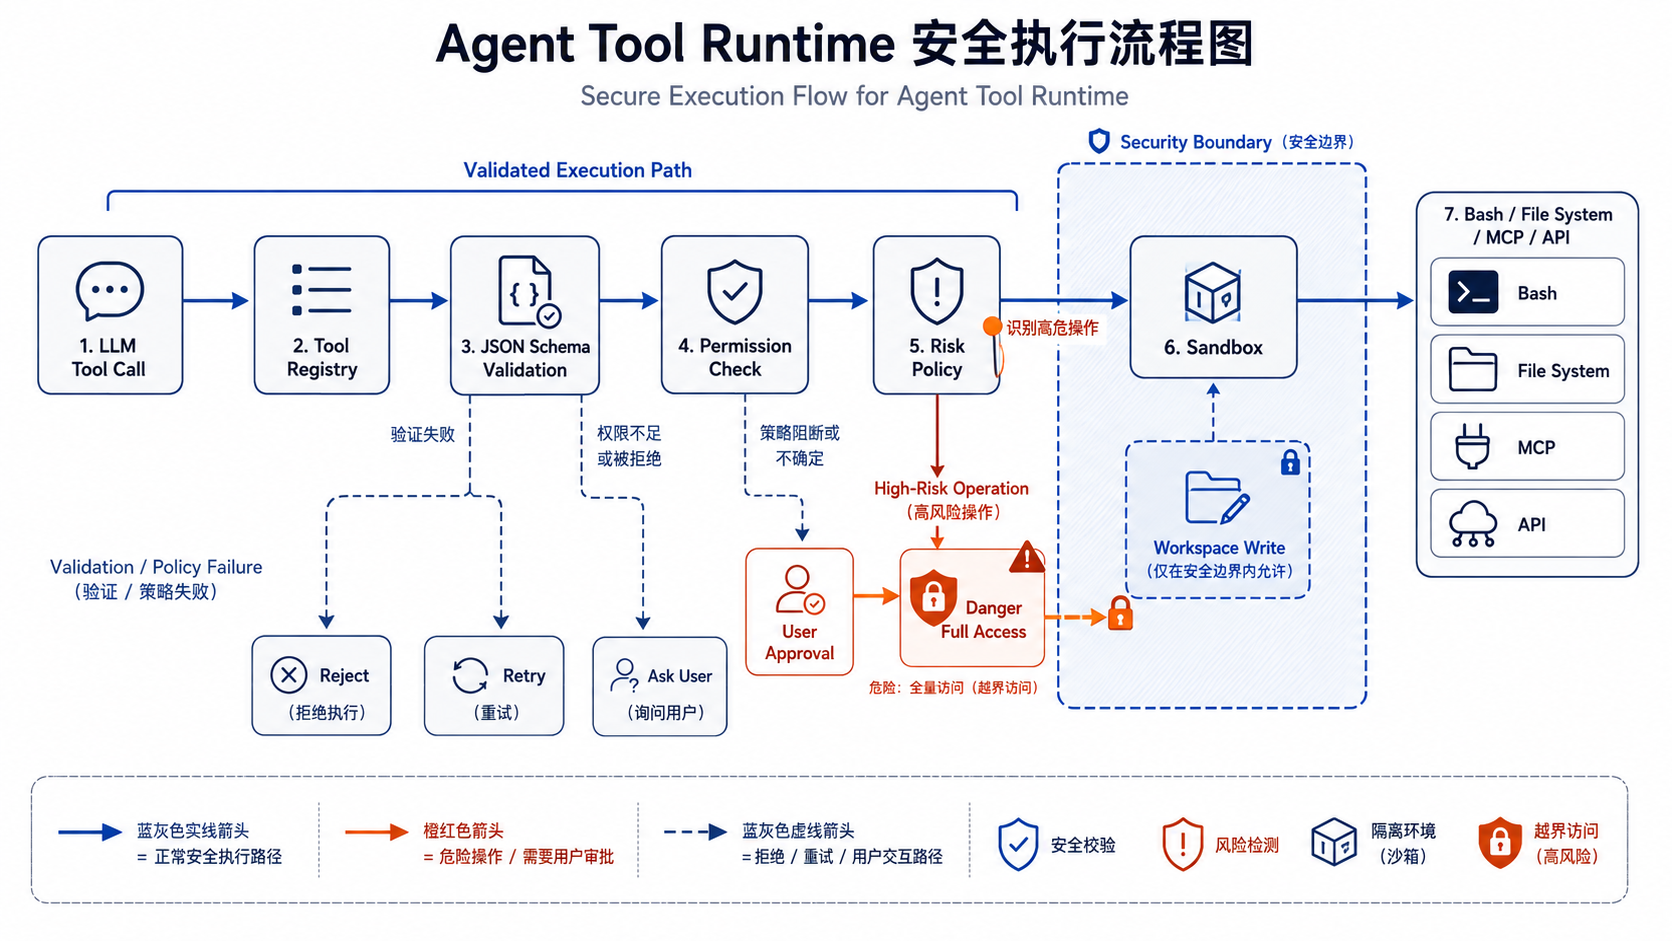
模型只能提出 Tool Call,真正决定它能不能执行的必须是 Harness。
中间至少应该存在这样一条链:
LLM
 │
 ▼
Tool Call
 │
 ▼
Tool Exists?
 │
 ▼
JSON Parse
 │
 ▼
JSON Schema / Pydantic
 │
 ▼
Parameter Validation(参数校验)
 │
 ▼
Permission Check(权限检查)
 │
 ▼
State Check(状态检查)
 │
 ▼
Risk Policy(风险策略)
 │
 ▼
Executor
 │
 ▼
Tool
这也是为什么我现在觉得:
Function Calling 微调解决的是“模型更会调用工具”,Harness 解决的是“即使模型犯错,也不能把系统搞坏”。
两者完全不是一个层面。
DeepSeek Harness 当前第一方 Tool 可以通过 typed schema DSL(类型化 Schema DSL)定义参数,并在执行前真正进行 Runtime Validation(运行时校验)。缺少必填字段、类型错误、Enum(枚举)错误、嵌套结构不合法,都可以直接被拦截为 INVALID_ARGS,而不是把错误参数交给实际 Tool。
如果我们在 Python Agent 中实现类似东西,我仍然比较推荐:
JSON Schema
      +
Pydantic
但这里要注意:
DeepSeek Harness 自己是 TypeScript 系统,它并不是在用 Pydantic。
Pydantic 是我们在 Python Harness 中实现同类“结构化边界校验”的一种方案。
这个区别还是要分清楚。
六、Sandbox 不是锦上添花,而是 Agent 真正获得执行能力之后必须存在的一层
当 Agent 只能回答问题的时候:
Hallucination → 回答错了
问题还比较有限。
但当 Agent 能执行:
rm
git
curl
python
npm
docker
甚至调用企业内部 API 后,问题性质就完全变了。
这时候:
Hallucination
可能直接变成:
Production Incident
所以 Sandbox(沙箱)其实是 Coding Agent Harness 最重要的模块之一。
我们之前讨论 DeepSeek 时,我一开始把它粗略理解成:
Bash 在隔离环境里面执行。
这个理解不算错,但还不够完整。
DeepSeek 当前的 Sandbox 更像一个独立 Capability Seam(能力接口层)。
在 Linux 上,它可以选择 Bubblewrap 或 Landlock;macOS 使用 Seatbelt;不同平台实现不同,而且如果要求 Sandbox 却找不到可以真正执行隔离的后端,它的设计倾向是 Fail Closed(失败关闭),而不是偷偷退化成无限制执行。
它还把:
Sandbox Mode(沙箱模式)
和:
Approval Policy(审批策略)
拆开管理。
例如:
workspace-write
+
ask
表示只能在 Workspace(工作区)范围内写,如果希望扩大权限,需要询问用户。
而:
danger-full-access
+
never
则是另一套权限组合。
所以一个真正完整的 Agent Tool Runtime(工具运行时)不是:
LLM → Bash
而应该是:
LLM
 ↓
Tool Schema
 ↓
Policy
 ↓
Permission
 ↓
Sandbox
 ↓
Process
 ↓
Result
这才是一个可控的执行系统。
七、DeepSeek 的 Sub-Agent 设计,是我觉得它和 Claude Code、Codex 差异比较明显的地方
我们前几天在这个问题上聊了很久。
当时有一个问题:
Claude Code、Codex 也有 Sub-Agent(子智能体),那 DeepSeek Harness 的 Sub-Agent 到底有什么特别?
现在再看,这个问题可以说得更准确一点。
Claude Code 当前当然有自己的 Sub-Agent 系统。
它的 Sub-Agent 可以拥有:
独立 Context Window(上下文窗口)
独立 System Prompt(系统提示词)
独立 Tool Access(工具权限)
独立 Permission(权限)
甚至可以选择不同 Claude Model
这可以很好地隔离 Context(上下文),比如让 Explore Agent 去读几千行代码,最后只把结论交回主 Agent,而不是污染主 Agent 上下文。
Codex 现在同样支持 Sub-Agent Workflow(子智能体工作流),可以 Spawn(生成)多个 Agent 并行工作,再汇总结果。
所以:
“只有 DeepSeek 有 Sub-Agent”肯定是不对的。
真正让我觉得 DeepSeek 有意思的是另外一点:
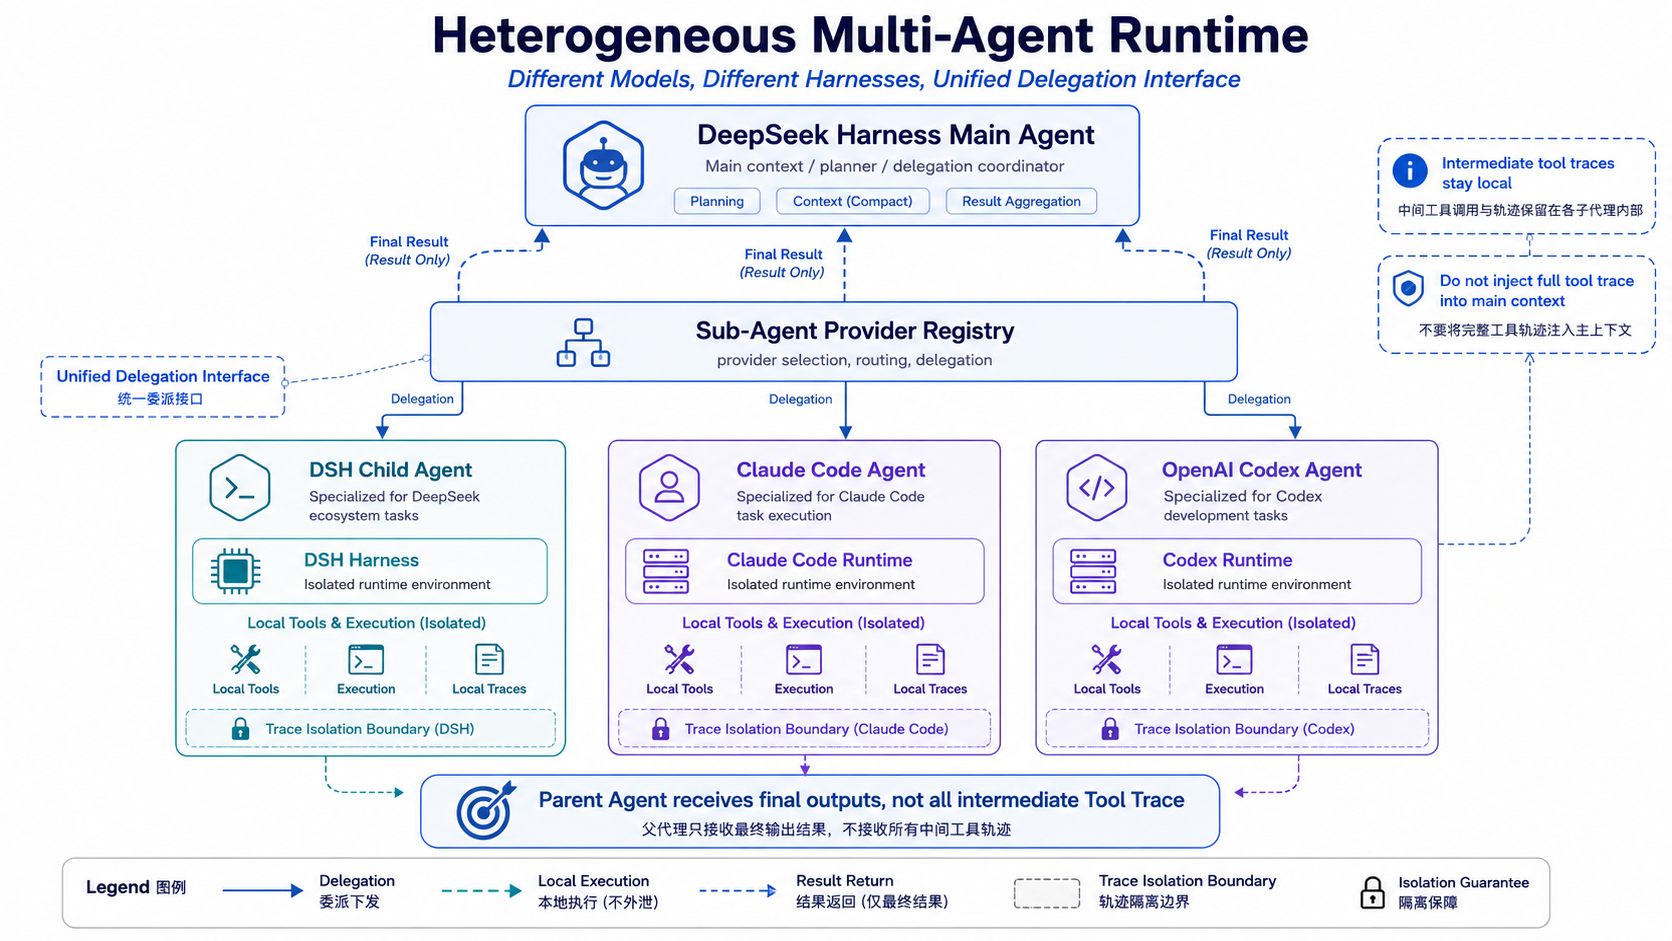
DeepSeek 把 Sub-Agent 本身也抽象成了 Provider(提供方)。
目前官方仓库已经存在:
spawn-in-process

fork-in-process

ACP

dsh-sdk

codex

claude-code
等 Sub-Agent Provider。
也就是说,一个 DeepSeek Harness Agent 可以把任务委派给:
另一个 DeepSeek Agent

或者

真正的 Claude Code

或者

真正的 Codex
其中 Claude Code Provider 会调用官方 Claude Agent SDK,而 Codex Provider 会启动:
codex app-server --stdio
创建一个临时 Codex Thread(线程)执行任务。
这就产生了一个很有意思的架构:
               DeepSeek Harness
                     │
            Main Agent / Session
                     │
        ┌────────────┼────────────┐
        │            │            │
        ▼            ▼            ▼
   DSH Agent    Claude Code     Codex
        │            │            │
    DSH Harness   Claude Harness  Codex Harness
所以我之前有一个理解现在基本可以保留:
Claude Code 内部创建一个 Claude Sub-Agent,本质上仍然是在 Claude Code 这一套运行体系里工作;Codex 自己的 Sub-Agent 同理。
而 DeepSeek 可以把“另外一个 Agent 产品”直接作为自己的 Sub-Agent Provider。
这意味着父 Agent 和子 Agent 不一定共用一套 Harness。
这就是所谓的 Heterogeneous Agent Runtime(异构智能体运行时)。
而且这里还有一个很值得纠正的误区:
多 Agent 通信不等于必须使用 A2A(Agent-to-Agent,智能体间协议)。
DeepSeek 调 Claude Code 走 Claude Agent SDK。
调 Codex 走 Codex App Server。
所以:
Multi-Agent
≠
A2A
A2A 只是多智能体互操作可能采用的一种协议,而不是多智能体系统成立的必要条件。
八、Session + Sub-Agent,其实也在解决另一个问题:Context Explosion(上下文爆炸)
Agent 做长任务时有一个特别现实的问题:
工具调用越多,Context 越长。
例如:
User
↓
Search
↓
200 行结果
↓
Read File
↓
500 行代码
↓
Bash
↓
300 行日志
↓
Read File
↓
...
最后所有东西都塞进:
messages
Context Window(上下文窗口)迟早爆掉。
Codex 自己公开介绍 Agent Loop 时也明确提到,Agent 可以在一个 Turn(轮次)里产生大量工具调用,因此 Context Window Management(上下文窗口管理)本身就是 Harness 的责任之一;当 Token 超过阈值后,需要进行 Compaction(上下文压缩)。
OpenAI 在 Harness Engineering 的文章里还提到了一个我很喜欢的原则:
不要给 Agent 一本 1000 页的说明书,给它一张地图。
他们最后把 AGENTS.md 做成了一个比较短的“目录”,真正的信息放在结构化 docs 中,需要的时候再逐层读取,也就是 Progressive Disclosure(渐进式披露)。
Sub-Agent 其实也是一种 Context Management(上下文管理)。
比如:
Main Agent
   │
   ├── Research Agent
   │       └── 读 50 个文件
   │
   ├── Test Agent
   │       └── 跑几千行测试日志
   │
   └── Review Agent
           └── 分析 Diff
主 Agent 最后只得到:
Research Result

Test Result

Review Result
而不是把所有原始过程都塞进主 Context。
所以多 Agent 并不只是为了:
并行加速。
还有一个非常重要的价值:
Context Isolation(上下文隔离)。
Claude Code 的官方 Sub-Agent 文档现在也明确把这一点作为主要使用场景之一。
九、为什么我现在越来越重视 Trace,而不仅仅是最终答案
这也是 Harness 和普通 Chatbot 差异最大的地方之一。
普通 QA 系统评测:
Question
↓
Answer
↓
Correct / Wrong
很多时候已经够用了。
但是 Agent 不一样。
假设最终任务失败:
“帮我找到文件并修改配置,然后重新启动服务。”
最终失败了。
问题可能发生在完全不同的位置:
Intent Recognition(意图识别)错了

Planner(规划器)拆错任务

选错 Tool

Tool 参数错

重复调用 Tool

执行顺序错

工具已经成功但 Agent 没理解结果

Context 被压缩丢了信息

出现异常以后 Retry 策略错误

任务已经完成还在循环

Sub-Agent 返回结果没有正确进入父 Agent
所以 Agent Eval(智能体评测)不能只评最终答案。
必须评 Trajectory(执行轨迹)。
例如:
Task Success(任务成功率)

Tool Selection Accuracy(工具选择准确率)

Parameter Validity(参数有效率)

Duplicate Tool Call Rate(重复工具调用率)

Execution Order Validity(执行顺序正确率)

Recovery Success Rate(异常恢复成功率)

Termination Accuracy(终止判断准确率)
这也是为什么我觉得 DeepSeek Session 的 Event Sourcing 设计很值得研究。
因为:
Trace
已经不是另外接一个监控 SDK 去“旁路监听”。
它天然就在 Session 里面。
从这个角度再看:
Session
Trace
Replay
Eval
其实可以逐渐变成一套东西。
十、Session 甚至可以直接变成 Harness 的测试数据
这是我看 DeepSeek Session 时想到的一个很有意思的用途。
假设我们已经跑过一次 Agent:
User Request

↓
Planner

↓
Tool Call A

↓
Tool Result A

↓
Tool Call B

↓
Tool Result B

↓
Final Answer
这一整条执行过程已经存在 Event Log(事件日志)里。
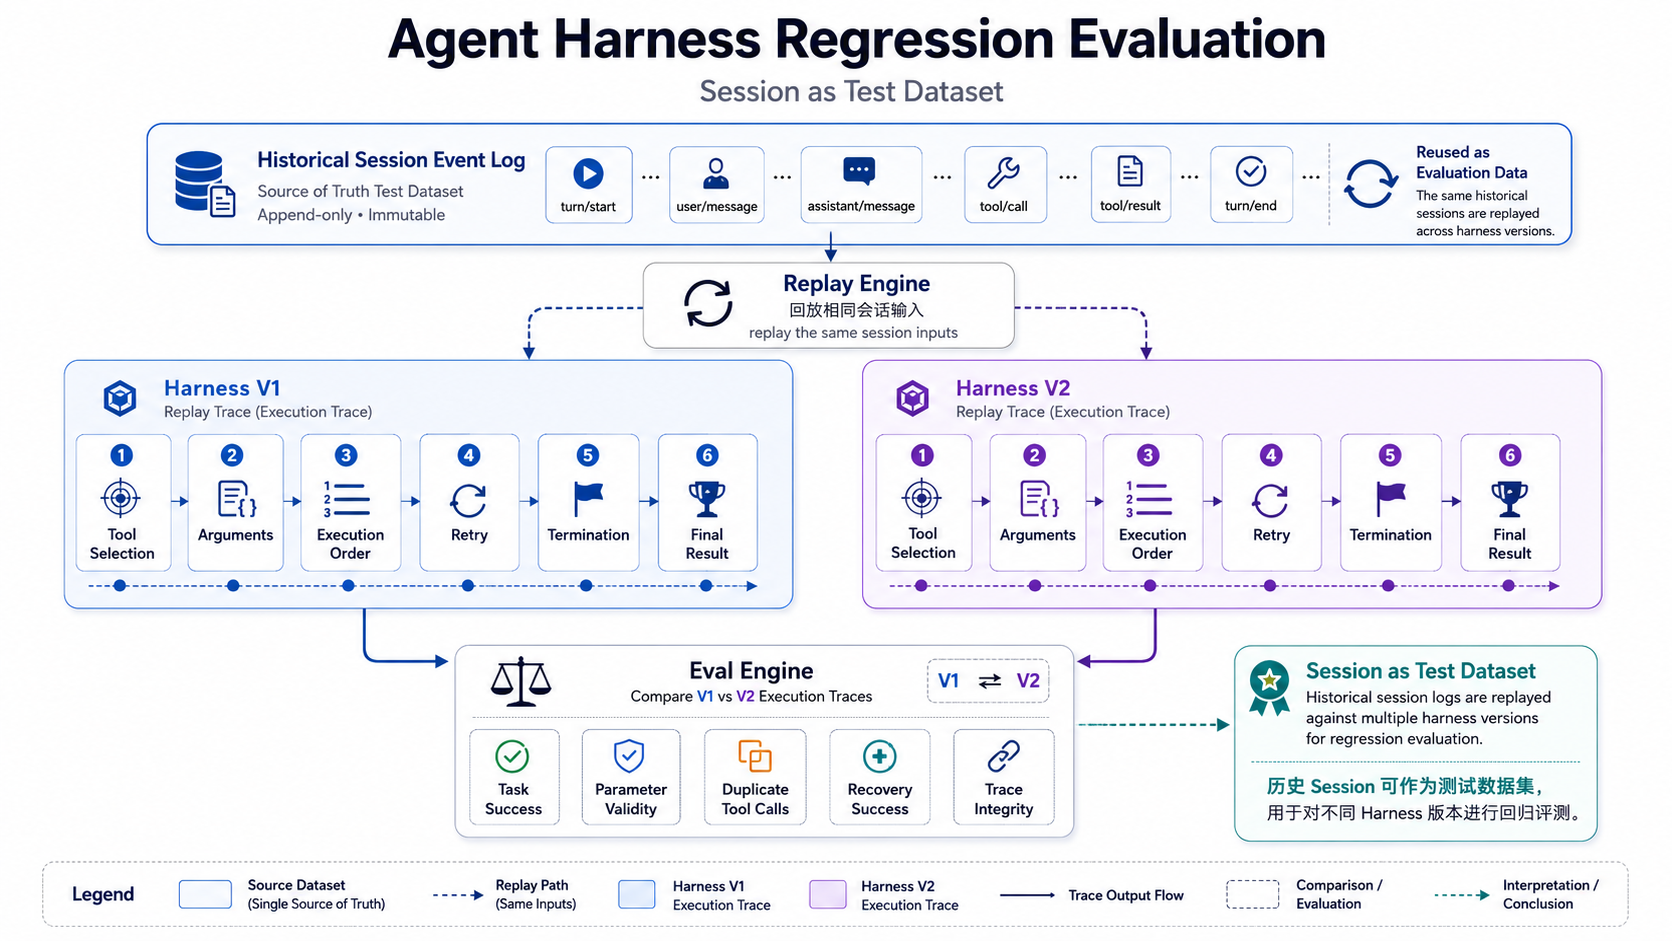
那么它就可以保存成一个 Test Case(测试用例)。
之后我们不一定非得重新让模型随机跑一遍。
还可以利用历史 Session 做:
Replay
然后检查新版本 Harness 是否出现:
Tool Result 配对错误

状态恢复错误

Session Projection 错误

Context 构建错误

Hook 顺序变化

Trace 丢失

Crash Recovery 行为改变
甚至可以进一步做更强的实验:
Model 不变
Prompt 不变
Input 不变

只修改 Harness
然后比较:
Harness V1

vs

Harness V2
这就变成了 Harness Regression Eval(Harness 回归评测)。
这里需要强调一点:
这是我基于 DeepSeek Session / Replay 机制进一步推导出来的工程实践,不等于 DeepSeek 官方已经提供了完整的“固定模型输出、自动比较 Harness”的标准评测产品。
但它给了一个非常好的底层基础。
这也是我为什么后来想在自己设计 Mini Agent 时,把 Session 放到系统核心,而不是最后再补一套日志。
十一、这也解释了为什么我现在不太赞同“Agent 的核心就是 Workflow 编排”
工作流编排当然重要。
Planner(规划器)也重要。
DAG(有向无环图)也重要。
但这些都只是 Harness 的一部分。
一个生产级 Agent 更完整的结构应该类似:
                 User
                   │
                   ▼
              Agent Runtime
                   │
         ┌─────────┴─────────┐
         │                   │
    Context Engine       Session Engine
         │                   │
         ▼                   ▼
        LLM              Event Store
         │
         ▼
      Planner
         │
         ▼
      TaskPlan
         │
         ▼
 ┌─────────────────────┐
 │ Validation Layer    │
 │                     │
 │ Pydantic            │
 │ JSON Schema         │
 │ Tool Schema         │
 │ DAG Check           │
 └─────────────────────┘
         │
         ▼
      Executor
         │
         ▼
    Tool Runtime
         │
 ┌───────┼────────┐
 ▼       ▼        ▼
MCP     Bash     API
 │
 ▼
Sandbox / Permission
         │
         ▼
       Result
         │
         ▼
     Session Event
         │
         ├── Trace
         ├── Replay
         └── Eval
所以我现在如果再设计一个 Agent 项目,会把:
Planner
和:
Executor
分得非常清楚。
Planner 只能提出:
TaskPlan
但是:
Planner 没有执行权。
TaskPlan 必须经过:
Pydantic

JSON Schema

Tool Schema

DAG Validation(DAG 校验)

Dependency Gate(依赖门禁)
然后 Executor 才真正调度 Tool。
这个思想和前面的 Tool Calling 是一样的:
LLM 可以提出行动,但最终执行权必须掌握在 Harness 手里。
模型负责 Intelligence(智能)。
Harness 负责 Authority(权限)和 Control(控制)。
我觉得这是 Agent 工程里一个非常重要的边界。
十二、那模型还重要吗?
当然重要。
Harness 并不是在否定模型能力。
模型推理能力越强:
Planning 更好

Tool Selection 更准

长任务稳定性更高

错误恢复能力更强
这些都是事实。
但问题在于:
模型能力再强,也不能代替工程边界。
一个强模型仍然可能:
Tool 参数写错

重复执行操作

错误理解 Observation

无限 Retry

访问不该访问的文件

在错误目录执行命令

把不可信网页里的 Prompt Injection 当指令

上下文越来越长

错误判断任务已经结束
你不能靠一句 Prompt:
Please be careful.
解决这些问题。
所以我现在对 Agent 的理解更接近:
Model
负责“想做什么”

Harness
负责“允许怎么做”

Tool
负责“真正去做”

Session
负责“发生过什么”

Eval
负责“做得对不对”
这几个层次分开以后,很多 Agent 设计问题突然会清楚很多。
十三、DeepSeek Harness 和 Claude Code、Codex,我现在会怎么理解
如果非要用比较简单的方式总结,我不会再说:
DeepSeek Harness 比 Claude Code 或 Codex 更先进。
这种比较其实没什么意义。
我更愿意说,它们的设计重心不一样。
| 系统 | 我目前的理解 |
|---|---|
| Claude Code | 产品化非常成熟的 Coding Agent Harness,强调开发体验、Context、Tool、Permission、Sub-Agent、Skills 等 |
| Codex | OpenAI 自己的 Coding Agent Harness,Agent Loop、Sandbox、AGENTS.md、Skills、Sub-Agent 等能力逐渐形成完整运行系统 |
| DeepSeek Harness | 更像一个试图把 Harness 本身做成“可组装基础设施”的开源 Runtime,重点是 Plugin、Session、Capability Seam 和异构 Agent Provider |
Claude Code 和 Codex 更像:
给你一辆已经调得很好的车。
而 DeepSeek Harness 给我的感觉更像:
把发动机、变速箱、悬架、刹车和控制系统都拆开,
然后告诉你这些东西可以重新组合。
这也是为什么 DeepSeek Harness 对普通用户来说未必比 Claude Code 更好用。
但如果你本身就在研究:
Agent Runtime

Tool Runtime

Session

Multi-Agent

Agent Eval

Harness Engineering
那它确实非常值得看。
当然现在还有一个很现实的问题:
DeepSeek Harness 目前仍处于 Developer Preview(开发者预览)阶段,而且官方明确提示未来还会存在 Breaking Changes(破坏性兼容变更)。
所以目前更适合:
研究

理解架构

做实验

借鉴设计
而不是简单地认为它已经是一套完全稳定的生产标准。
最后
过去一段时间,我对 Agent 的关注点其实发生了明显变化。
一开始关注的是:
模型选哪个?

Prompt 怎么写?

Function Calling 准不准?

Planner 怎么设计?
后来慢慢变成:
Tool 为什么可以被执行?

错误参数为什么没有被拦住?

任务状态到底存在哪里?

程序崩溃以后怎么继续?

Tool 执行一半怎么办?

上下文爆炸怎么办?

子 Agent 的 Context 怎么隔离?

模型为什么有权限访问这个文件?

这条 Agent 轨迹能不能 Replay?

Harness 改了一版以后,怎么证明它没有退化?
这些问题其实都已经不再只是“大模型问题”。
它们越来越像传统的软件工程、分布式系统、操作系统、工作流引擎和可观测性问题。
只是现在,系统中间多了一个非常强、但又具有随机性的决策者:
LLM
而 Harness 要做的事情,就是把这个“不完全可靠的智能”放进一个可控、可恢复、可追踪、可评测的工程系统里面。
所以如果现在再让我给 Agent Harness 下一个定义,我大概会这么说:
Harness 不是让模型变聪明的东西。
它是让一个已经足够聪明、但并不完全可靠的模型,能够在真实世界里持续工作的那套工程系统。
而随着模型能力继续提高,我反而觉得 Harness 的重要性不会下降。
可能恰恰相反。
模型越能做事,我们就越需要知道它能做什么、不能做什么、做过什么,以及做错以后怎么办。
这可能才是 Harness Engineering 真正开始变重要的原因。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)