6【AI数学基础】标量、向量、矩阵、张量
在AI(尤其是深度学习)里,数学不再只是抽象的符号,而是有几何形状的实体,可以把AI数学中的核心“形状”分为四个层级:
第一层:点、线、面(基础维度)
这是AI处理数据的原材料。(维度:你需要几个「坐标」才能锁定一个具体的数。)
| 数据形状 | 举例 | 特征 | 在 NumPy 中 |
| 标量Scalar (0维) | 温度 36.5°C,或者一个像素的灰度值 | 它就是一个数,只有大小,没有方向 | shape 显示为空元组 () |
| 向量Vector (1维) | [身高, 体重, 年龄],或者一天中每小时的气温记录 | 就是一根“箭头”或一串数。比如 一串有序的数 | Shape为 (n,),n 是元素个数 |
| 矩阵Matrix (2维) | 一张黑白图片,就是 高度 x 宽度 的灰度矩阵,或者权重矩阵(神经网络里的参数)也是这个形状,它负责把输入的向量“拉伸”或“旋转”到另一个空间 | 就是一张“表格”,有行和列,或一个平面 | Shape 为 (行数, 列数) |
| 张量Tensor (3 维及以上) | 全国 300 个城市、每个城市一周 7 天、每天 24 小时的气温 | 张量是向量和矩阵向任意维度的推广。 | Shape 为 (城市数, 天数, 小时数) 即 (300, 7, 24) |
1. 向量的运算
①加法,数乘
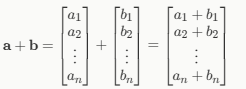
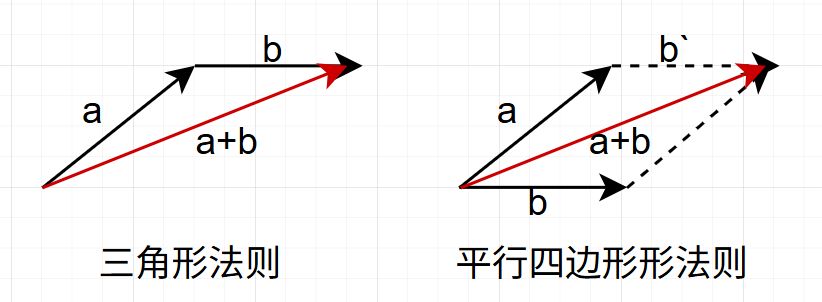
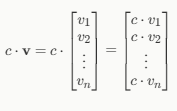
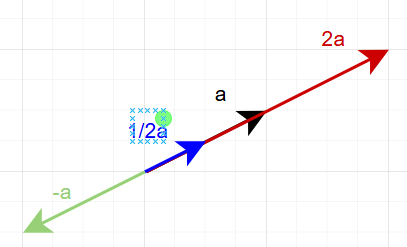
数乘只改变向量的「长度」,不改变它所在直线的方向(负数反转方向但仍在同一条直线上)。这个性质叫做 共线性——数乘前后的两个向量总是在同一条直线上。
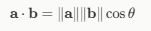
②点积:从投影到相乘
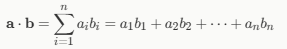
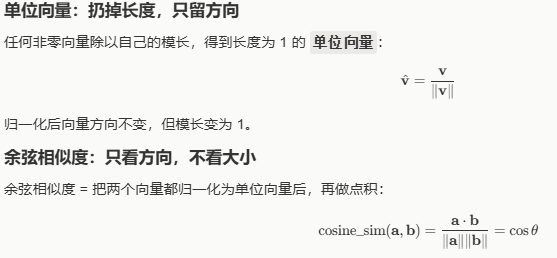
③模长
模长就是向量从原点到终点的「直线距离」——勾股定理在高维空间的推广。
2. 矩阵运算
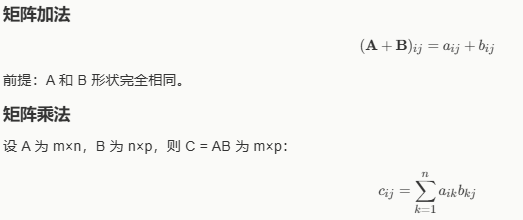
①加法,乘法
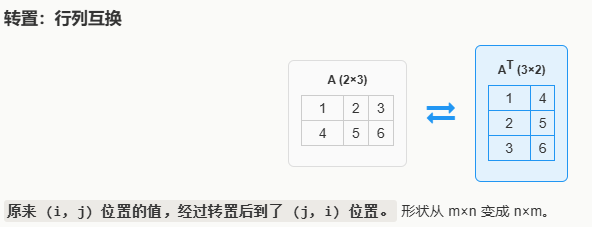
②转置
③奇异值分解(SVD)-- 任意矩阵的拆解术
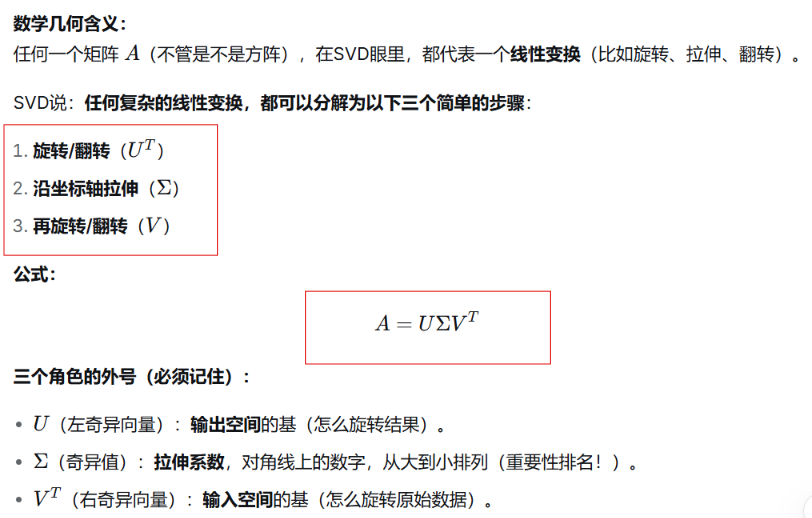
SVD 是一种矩阵分解技术,能将任意一个 m×n 的矩阵 A 分解为三个特定矩阵的乘积:A = U·Σ·Vᵀ。它是线性代数中最核心、应用最广的矩阵分解方法,没有之一。
想象你有一张照片(1000x1000像素)。这张照片里有很多冗余信息(比如大片的蓝天)。SVD能帮你把这张照片拆解成三个小矩阵的乘积,并且能找出这张照片里最重要的“特征成分”。如果你只保留最重要的前50个成分,照片看起来依然清晰,但文件大小只剩原来的5%!这就是数据压缩。

练习一下:
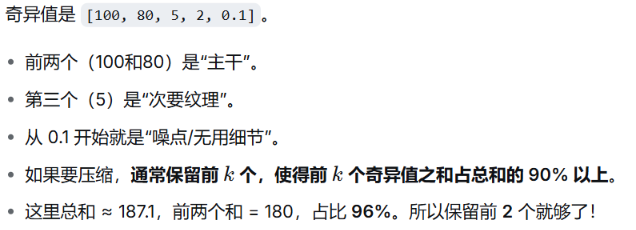
假设我们有一张1000x1000的图片矩阵,做完SVD后,奇异值是 [100, 80, 5, 2, 0.1, ...]。如果我们要压缩图片,只保留最重要的特征,我们应该保留前几个奇异值对应的成分?为什么?
第二层:空间与流形(数据的栖息地)
这是AI最核心的几何直觉。
-
欧几里得空间(平直空间):就是我们熟悉的立体几何。AI的输入数据(如图片的所有像素)被看作高维空间里的一个点。
-
流形(Manifold):这是AI的关键概念!你可以把它理解为“蜷缩在高维空间里的低维曲面”。
-
直观理解:地球上所有人类的照片,理论上只是三维世界(人)在二维平面(相机感光片)上的投影。但所有“人脸照片”在高维像素空间中,并不是随意分布的,它们密集地聚集在一个“人脸流形”上。
-
AI的任务:深度学习就是在学习这个流形的结构。生成式AI(如Stable Diffusion),本质就是学习数据分布的流形,然后从流形上随机采样,生成一张“看起来像真”的新图片。
-
第三层:变换与映射(AI的运算本质)
神经网络的每一层,本质上就是对“形状”进行几何操作。
-
线性变换(仿射变换):即
y = Wx + b。这在几何上就是旋转、缩放、平移和剪切。你可以想象,输入向量(一个形状)经过矩阵乘法,在高维空间中被扭转、拉伸,去贴合目标形状。 -
非线性激活函数(ReLU, Sigmoid):这是“折叠”操作。比如ReLU(
max(0, x)),就是把空间负半轴的所有点“折叠”到零平面上。正是这些“折叠”,使得神经网络能够把极度扭曲、缠结的数据流形(比如原始像素空间)“展开”成线性可分的形状(比如猫和狗的清晰分界线)。
第四层:高维的“超球”与“凸包”(损失与优化)
这是AI学习的“指南针”。
-
损失函数的等高线(碗状或峡谷状):损失函数把模型参数映射到一个“地形”上。最优的参数就在这个地形的“最低谷”。
-
如果是凸函数,地形就像一个碗(凸形状),底部只有一个最低点,传统数学能直接求解。
-
但深度学习的损失函数是非凸的,地形像连绵的群山,布满局部最低点。梯度下降,就像一个小球从山顶滚下,沿着最陡的坡度(梯度方向)寻找最低的“盆地”。
-
-
超球体(正则化的几何意义):L1和L2正则化,在几何上就是在权重空间画一个菱形(L1)或球体(L2)。最优解必须在这个形状之内,这就限制了权重的“体积”,防止模型过拟合(过于扭曲去迎合个别噪点)。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)