AI第一性原理:从一个神经元到ChatGPT的硬核拆解
“我们只能看到不远的前方,但我们已经看到那里有很多需要做的事。”* —— Alan Turing, 1950
人工智能(AI)这个词听起来很高大上,但剥开层层包装纸,底层逻辑其实简单得令人发指——就是一堆矩阵乘法加上非线性变换。本文从第一性原理出发,从一个数学函数开始,一步步拆解到GPT-4级别的大模型,让你真正理解AI"为什么能工作",而不仅仅是"它能做什么"。
📑 目录
- 什么是AI第一性原理?
- 从一个函数说起:机器学习的本质
- 感知机:最简单的神经网络
- 激活函数:为什么线性不够用
- 梯度下降:让机器自己学习
- 反向传播:梯度下降的引擎
- 深度学习:为什么深比宽好
- 卷积神经网络(CNN):图像的语法
- 循环神经网络(RNN):序列的记忆
- Transformer:注意力就是一切
- 大语言模型(LLM):涌现与缩放定律
- 训练的工程学:优化器、正则化与调参
- AI的数学基础:你真的需要知道的那些
- AI的能力边界与哲学思考
- 总结:第一性原理清单
- 参考文献
1. 什么是AI第一性原理?
第一性原理(First Principles)这个概念来自亚里士多德:在每一个系统的探索中,存在第一性原理——它是最基本的命题或假设,不能被省略或删除,也不能被违反。
应用到AI领域,第一性原理就是问:
- AI到底在做什么? → 逼近一个函数
- 怎么逼近? → 最小化损失函数
- 怎么最小化? → 梯度下降
- 梯度怎么算? → 反向传播(链式法则)
- 为什么有效? → 万能逼近定理 + 数据 + 算力
| 层次 | 第一性原理问题 | 核心答案 |
|---|---|---|
| 1 | AI的本质是什么? | 逼近一个从输入到输出的函数 |
| 2 | 怎么找到这个函数? | 定义假设空间(模型架构) |
| 3 | 怎么衡量好坏? | 定义损失函数(目标函数) |
| 4 | 怎么优化? | 梯度下降(沿负梯度方向走) |
| 5 | 梯度怎么算? | 反向传播(链式法则) |
| 6 | 为什么能泛化? | 数据量 + 正则化 + 归纳偏置 |
| 7 | 为什么现在才行? | 数据 + 算力 + 算法三要素 |
表1:AI第一性原理七问
把这七个问题搞清楚,你就掌握了AI的"骨架"。剩下的都是"肌肉"——各种技巧和工程细节。
2. 从一个函数说起:机器学习的本质
机器学习的本质极其简单:给定输入X和目标Y,找到一个函数f,使得f(X) ≈ Y。
就这么简单。所有的深度学习、GPT、Stable Diffusion,归根结底都在做这一件事。
2.1 三种学习范式
| 范式 | 输入 | 目标 | 任务举例 | 类比 |
|---|---|---|---|---|
| 监督学习 | 有标签的数据(X,Y) | 学习 X→Y 的映射 | 图像分类、翻译、回归 | 有答案的练习册 |
| 无监督学习 | 无标签的数据(X) | 发现数据的内在结构 | 聚类、降维、生成 | 没有答案,自己找规律 |
| 强化学习 | 环境状态+奖励信号 | 学习最大化累积奖励的策略 | 游戏AI、机器人控制 | 试错学习,奖惩机制 |
表2:三种机器学习范式
GPT的训练是监督学习(预测下一个token)+强化学习(RLHF对齐人类偏好)的结合。AlphaGo则是监督学习(模仿人类棋谱)+强化学习(自我对弈)的典范。
2.2 机器学习的基本流程
数据 → 模型 → 损失函数 → 优化器 → 更新参数 → 重复
| 步骤 | 做什么 | 关键选择 | 第一性原理 |
|---|---|---|---|
| 1. 收集数据 | 获取训练数据 | 数据量、质量、多样性 | 数据是燃料 |
| 2. 选择模型 | 定义假设空间 | 线性模型、神经网络、决策树 | 假设空间要够大 |
| 3. 定义损失 | 衡量预测与真实的差距 | MSE、交叉熵、对比损失 | 要能求导 |
| 4. 选择优化器 | 求解最小化问题 | SGD、Adam、LAMB | 沿负梯度方向走 |
| 5. 训练 | 迭代更新参数 | 学习率、batch size、epoch | 收敛到好的解 |
| 6. 评估 | 在测试集上验证 | 准确率、F1、BLEU | 衡量泛化能力 |
| 7. 部署 | 实际使用 | 推理延迟、吞吐量 | 工程落地 |
表3:机器学习基本流程
注意第6步——在测试集上评估。如果训练集表现好但测试集差,那就是过拟合(Overfitting)——模型"背答案"了,没有真正学会规律。
2.3 偏差-方差权衡
这是机器学习中最核心的权衡之一:
| 概念 | 含义 | 来源 | 症状 | 解决方法 |
|---|---|---|---|---|
| 偏差(Bias) | 模型的假设与真实规律的差距 | 模型太简单 | 欠拟合:训练和测试都差 | 换更复杂的模型 |
| 方差(Variance) | 模型对训练数据的敏感程度 | 模型太复杂 | 过拟合:训练好测试差 | 正则化、更多数据 |
| 噪声(Noise) | 数据本身的随机性 | 数据质量 | 不可消除 | 数据清洗 |
表4:偏差-方差分解
总误差 = 偏差² + 方差 + 噪声。好的模型在偏差和方差之间找到平衡点——既不能太简单(高偏差),也不能太复杂(高方差)。这就是为什么"模型不是越大越好"。
3. 感知机:最简单的神经网络
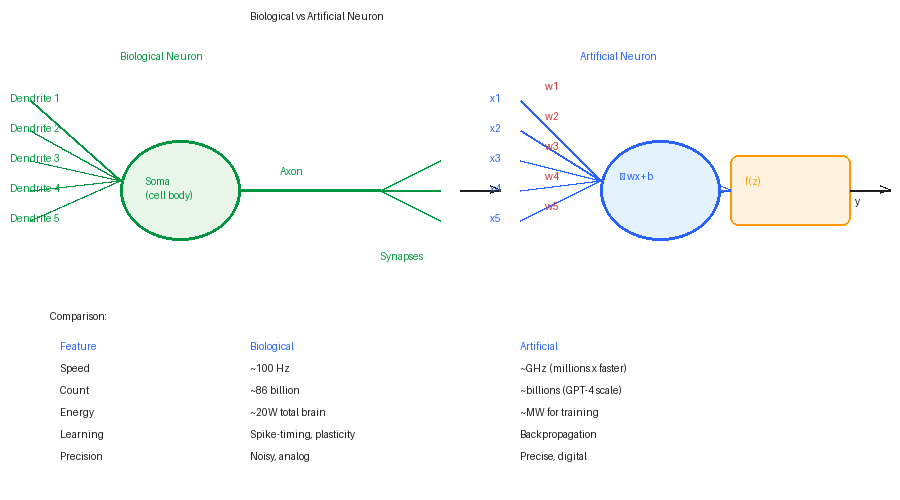
图1:生物神经元vs人工神经元 —— 从碳基到硅基的映射
1943年,McCulloch和Pitts提出了第一个人工神经元模型。1958年,Rosenblatt发明了感知机(Perceptron)——这是神经网络的"Hello World" [1]。
3.1 单个神经元的数学
一个人工神经元做的事情就是:
z = w₁x₁ + w₂x₂ + ... + wₙxₙ + b = Σwᵢxᵢ + b
y = f(z)
其中:
x₁, x₂, ..., xₙ是输入w₁, w₂, ..., wₙ是权重(weights)—— 这是要学习的参数b是偏置(bias)—— 这也是要学习的参数f是激活函数(activation function)y是输出
| 组件 | 数学符号 | 含义 | 类比 |
|---|---|---|---|
| 输入 | x₁…xₙ | 数据特征 | 考试的各科成绩 |
| 权重 | w₁…wₙ | 各特征的重要程度 | 各科的学分权重 |
| 偏置 | b | 基准值 | 加分/扣分项 |
| 加权求和 | z = Σwx + b | 综合评分 | 加权平均分 |
| 激活函数 | y = f(z) | 非线性变换 | 评级(A/B/C/D) |
表5:单个神经元的组件
一个神经元本质上就是一个带偏置的加权求和 + 非线性变换。就这么简单。
3.2 感知机的能力与局限
感知机可以解决线性可分的问题——即能用一条直线(或超平面)把两类数据分开。
| 问题 | 感知机能解决吗? | 说明 |
|---|---|---|
| AND | ✅ 是 | 两个正输入才输出正 |
| OR | ✅ 是 | 任一正输入就输出正 |
| NOT | ✅ 是 | 单输入取反 |
| XOR | ❌ 否 | 无法用直线分开! |
| 复杂模式 | ❌ 否 | 需要多层网络 |
表6:感知机的能力边界
1969年,Minsky和Papert在《Perceptrons》一书中证明了感知机无法解决XOR问题 [2]。这本书直接导致了第一次AI寒冬——投资者撤资,研究者转行。一个简单的数学证明,让整个领域沉寂了十年。
XOR为什么不行?
输入: (0,0)→0, (0,1)→1, (1,0)→1, (1,1)→0
在二维平面上,你无法画一条直线把0和1分开。这就是线性不可分。
解决方案:多层感知机(MLP)——加一个隐藏层就行:
隐藏层: h₁ = σ(w₁₁x₁ + w₁₂x₂ + b₁)
        h₂ = σ(w₂₁x₁ + w₂₂x₂ + b₂)
输出层: y  = σ(w₃₁h₁ + w₃₂h₂ + b₃)
一个隐藏层就能解决XOR——这就是万能逼近定理的起点。
4. 激活函数:为什么线性不够用
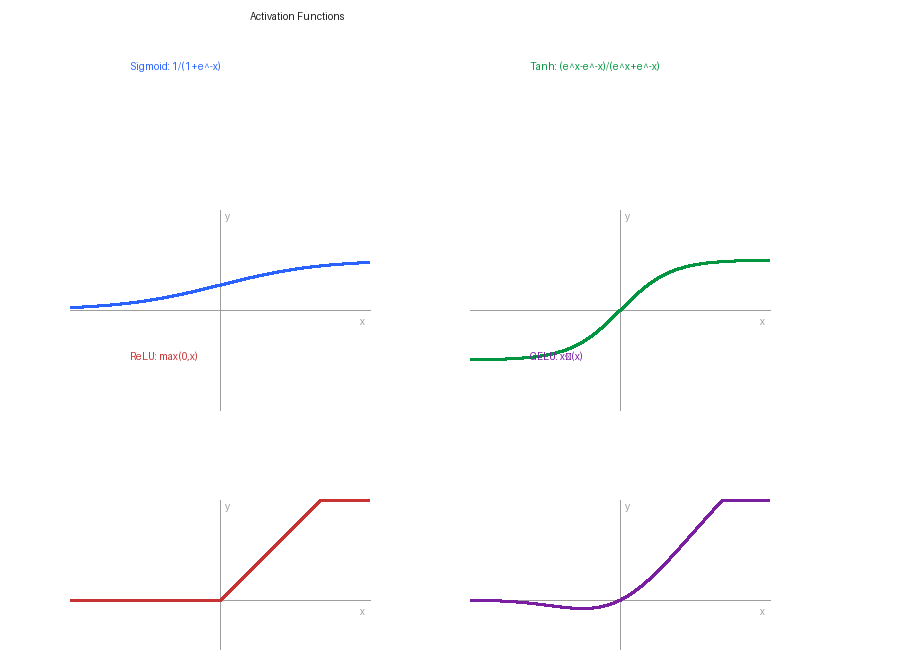
图2:四种常见激活函数 —— 给神经网络注入非线性的"魔法药水"
如果没有激活函数,多层神经网络等价于单层线性变换——因为线性函数的组合还是线性函数:
f(x) = W₂(W₁x + b₁) + b₂ = W'x + b'
所以激活函数的核心作用是引入非线性。
4.1 常见激活函数
| 函数 | 公式 | 值域 | 优点 | 缺点 | 主要应用 |
|---|---|---|---|---|---|
| Sigmoid | 1/(1+e^(-z)) | (0,1) | 输出概率,平滑可导 | 梯度消失、非零中心 | 二分类输出层 |
| Tanh | (ez-e(-z))/(ez+e(-z)) | (-1,1) | 零中心,比Sigmoid好 | 仍有梯度消失 | RNN |
| ReLU | max(0,z) | [0,∞) | 计算简单,缓解梯度消失 | 死亡ReLU | CNN/MLP首选 |
| Leaky ReLU | max(αz,z), α=0.01 | (-∞,∞) | 解决死亡ReLU | 超参数α | ReLU替代 |
| ELU | z if z>0, α(e^z-1) if z≤0 | (-α,∞) | 负值有输出 | 计算稍慢 | 深层网络 |
| GELU | z·Φ(z) | (-∞,∞) | 平滑,效果好 | 计算较慢 | Transformer |
| Swish/SiLU | z·σ(z) | (-∞,∞) | 自门控,效果好 | 计算稍慢 | 现代架构 |
| Softmax | ezᵢ/Σezⱼ | (0,1), 和=1 | 输出概率分布 | 仅用于输出层 | 多分类输出 |
表7:激活函数全家福
现代大模型(GPT、BERT等)几乎清一色用GELU。为什么?因为GELU在0点附近是平滑的(不像ReLU有个尖角),梯度更稳定,训练效果更好。
4.2 梯度消失与梯度爆炸
| 问题 | 原因 | 症状 | 解决方案 |
|---|---|---|---|
| 梯度消失 | Sigmoid/Tanh的导数<1,多层相乘趋近0 | 深层网络学不动,底层参数几乎不更新 | ReLU、残差连接、BatchNorm |
| 梯度爆炸 | 梯度多层相乘趋近∞ | 训练不稳定,loss突然变NaN | 梯度裁剪、权重初始化、LayerNorm |
表8:梯度消失与梯度爆炸
Sigmoid的导数最大只有0.25。如果网络有10层,梯度至少缩小到 0.25¹⁰ ≈ 0.000001——底层的参数几乎学不到任何东西。这就是为什么ReLU(导数要么是0要么是1,不会缩小)在2012年之后成为标配。
4.3 ReLU为什么是革命性的
ReLU(Rectified Linear Unit)的公式简单到令人怀疑:f(z) = max(0, z)
但它的效果惊人:
| 特性 | ReLU | Sigmoid |
|---|---|---|
| 计算速度 | 极快(一次比较) | 慢(指数运算) |
| 梯度 | 0或1(不缩小) | 0~0.25(持续缩小) |
| 稀疏性 | 大约50%的神经元输出为0 | 所有神经元都有输出 |
| 收敛速度 | 快6倍(Krizhevsky 2012) | 慢 |
表9:ReLU vs Sigmoid
AlexNet(2012)用ReLU替代Sigmoid,训练速度快了6倍。这一个改变,直接推动了深度学习的爆发。有时候,最简单的改变带来最大的影响。
5. 梯度下降:让机器自己学习
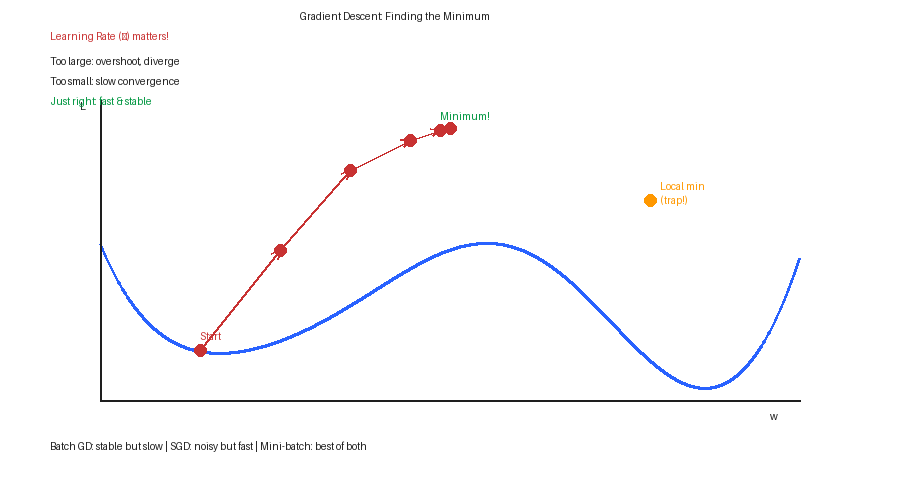
图3:梯度下降过程 —— 像滚下山一样找到最低点
机器学习的核心问题:如何找到最优的参数?
答案:梯度下降(Gradient Descent)——沿着损失函数下降最快的方向走。
5.1 数学原理
参数更新规则:
θ_new = θ_old - η · ∇L(θ)
其中:
θ是模型参数η(eta)是学习率(Learning Rate)∇L(θ)是损失函数对参数的梯度
梯度的几何意义:函数值增长最快的方向。所以负梯度就是下降最快的方向。
5.2 三种梯度下降变体
| 变体 | 每次更新使用的数据 | 优点 | 缺点 | 收敛特点 |
|---|---|---|---|---|
| 批量梯度下降(BGD) | 全部训练数据 | 梯度精确,收敛稳定 | 慢,内存大 | 平滑收敛 |
| 随机梯度下降(SGD) | 单个样本 | 快,能跳出局部最小 | 噪声大,不稳定 | 震荡收敛 |
| 小批量梯度下降(Mini-batch) | 一批样本(32-512) | 平衡速度和稳定性 | 需选batch size | 实际最常用 |
表10:三种梯度下降变体
实际训练中100%用Mini-batch。batch size的选择有讲究:太大(>1024)泛化差,太小(<16)噪声太大。一般32-512是"甜蜜点"。
5.3 学习率的重要性
学习率η是训练中最重要的超参数,没有之一:
| 学习率 | 效果 | 类比 |
|---|---|---|
| 太大(>0.1) | 震荡甚至发散,loss不降反升 | 下山步子太大,从另一边翻过去了 |
| 太小(<0.0001) | 收敛极慢,可能卡在局部最小 | 下山步子太小,天黑了还没到 |
| 刚好(0.001~0.01) | 快速稳定收敛 | 适当步幅,稳步下山 |
| 衰减策略 | 开始大步走,接近目标小步挪 | 先跑后走再慢行 |
表11:学习率的影响
现代训练几乎都用学习率预热+衰减策略:先用很小的学习率"热身"几个epoch(防止初期梯度爆炸),然后逐步增大到目标学习率,最后再缓慢衰减。就像开车:启动→加速→巡航→减速停车。
5.4 损失函数的选择
损失函数衡量"预测有多差":
| 损失函数 | 公式 | 适用任务 | 特点 |
|---|---|---|---|
| 均方误差(MSE) | Σ(y-ŷ)²/n | 回归 | 对异常值敏感 |
| 平均绝对误差(MAE) | Σ | y-ŷ | /n |
| 交叉熵(Cross-Entropy) | -Σy·log(ŷ) | 分类 | 梯度好,训练快 |
| 二元交叉熵(BCE) | -[y·log(ŷ)+(1-y)·log(1-ŷ)] | 二分类 | Sigmoid输出配对 |
| KL散度 | Σp·log(p/q) | 分布匹配 | 不对称 |
| 对比损失 | max(0, margin - d) | 表示学习 | 拉近正样本,推远负样本 |
表12:常见损失函数
为什么分类用交叉熵而不是MSE?因为Sigmoid+MSE的梯度在预测很错的时候反而很小(饱和区),而Sigmoid+交叉熵的梯度在预测很错的时候很大——训练信号更强,收敛更快。
6. 反向传播:梯度下降的引擎
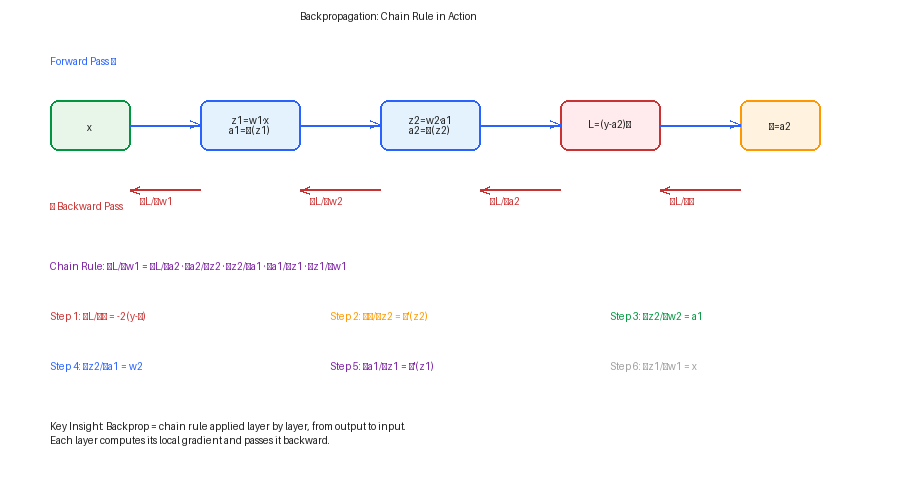
图4:反向传播过程 —— 链式法则的工程实现
反向传播(Backpropagation)是计算梯度的算法。它不是什么新数学,就是微积分里的链式法则(Chain Rule)[3]。
6.1 链式法则
如果 y = f(g(x)),则:
dy/dx = f'(g(x)) · g'(x)
应用到神经网络:
∂L/∂w₁ = ∂L/∂ŷ · ∂ŷ/∂z₂ · ∂z₂/∂a₁ · ∂a₁/∂z₁ · ∂z₁/∂w₁
6.2 反向传播的步骤
| 步骤 | 方向 | 操作 | 说明 |
|---|---|---|---|
| 1 | 前向传播 | 从输入到输出计算每一层的输出 | 得到预测值 ŷ |
| 2 | 计算损失 | L = loss(ŷ, y) | 衡量预测有多差 |
| 3 | 输出层梯度 | ∂L/∂ŷ | 损失对输出的导数 |
| 4 | 反向传播梯度 | 从输出层逐层向前计算 ∂L/∂wᵢ | 链式法则 |
| 5 | 更新参数 | wᵢ ← wᵢ - η · ∂L/∂wᵢ | 梯度下降 |
表13:反向传播五步法
为什么叫"反向"?因为梯度是从输出层向后传播到输入层的。就像追责:产品出了问题(损失大),从最终检测(输出层)追溯到原材料(输入层),每一层都要算清楚自己的"责任"(梯度)。
6.3 计算图与自动微分
现代深度学习框架(PyTorch、TensorFlow)使用自动微分(Automatic Differentiation)来实现反向传播:
| 微分方式 | 原理 | 优点 | 缺点 | 应用 |
|---|---|---|---|---|
| 数值微分 | (f(x+h)-f(x))/h | 简单 | 精度低,慢 | 梯度检查 |
| 符号微分 | 符号表达式求导 | 精确 | 表达式爆炸 | Mathematica |
| 自动微分 | 计算图+链式法则 | 精确,高效 | 需要计算图 | PyTorch/TF |
表14:三种微分方式
自动微分的核心思想:任何复杂函数都可以分解为基本运算(加减乘除、指数、对数等)的组合。每个基本运算的导数我们都知道,用链式法则串起来就行了。PyTorch的
autograd就是这么工作的——你写前向传播,它自动帮你算反向传播。
6.4 梯度检验
怎么确认反向传播的实现是正确的?用梯度检验(Gradient Checking):
数值梯度 ≈ (L(θ+ε) - L(θ-ε)) / 2ε (ε ≈ 10⁻⁷)
比较数值梯度和反向传播计算的梯度,如果相对误差 < 10⁻⁷,说明实现正确。
实际开发中,梯度检验只在debug时用——因为它太慢了(每个参数都要算两次前向传播)。
7. 深度学习:为什么深比宽好
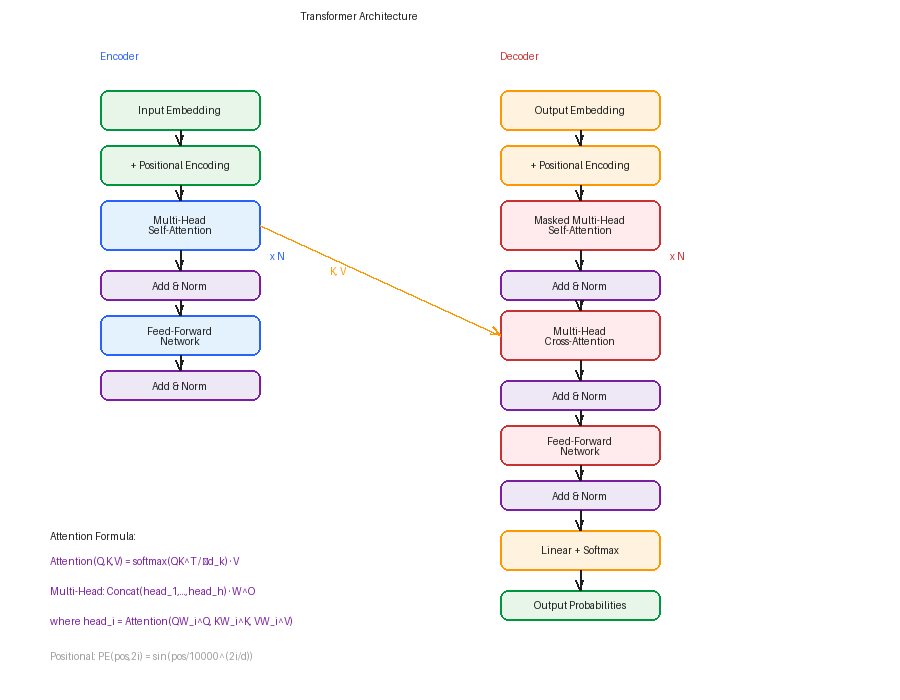
图5:四种神经网络架构 —— 从简单到复杂
"深度学习"中的"深度"指的是网络的层数。为什么深的比宽的好?
7.1 万能逼近定理
| 定理 | 内容 | 含义 |
|---|---|---|
| 万能逼近定理(1989) | 一个有足够多隐藏神经元的单隐层前馈网络可以逼近任意连续函数 | 理论上一层就够了 |
| 深度优势(2016) | 深度网络可以用指数级少的神经元表示同样的函数 | 深比宽高效得多 |
表15:万能逼近定理及其延伸
理论上一层就够了,但那一层可能需要天文数字的神经元。就像理论上你可以用一个超复杂的公式描述任何曲线,但用多段简单的直线拼接(样条曲线)更实际。深度网络就是"多段简单函数的组合"——每一层做一个简单的变换,层层叠加就能表示极其复杂的函数。
7.2 深度 vs 宽度
| 维度 | 深度(层数多) | 宽度(神经元多) |
|---|---|---|
| 表示效率 | 指数级高效 | 需要指数级神经元 |
| 特征层次 | 自动学习层次化特征 | 只学一层特征 |
| 泛化能力 | 更好(归纳偏置强) | 较差(容易过拟合) |
| 训练难度 | 更难(梯度消失) | 相对容易 |
| 参数效率 | 更少参数表示同样函数 | 参数多 |
表16:深度vs宽度
深度学习的强大之处在于自动学习特征层次:第一层学边缘,第二层学纹理,第三层学部件,第四层学物体……这种层次化特征提取,和人类视觉系统的工作方式惊人地相似。
7.3 深度学习的关键技术突破
| 年份 | 技术 | 解决的问题 | 论文 |
|---|---|---|---|
| 2006 | 深度信念网络(DBN) | 预训练解决梯度消失 | Hinton et al. |
| 2010 | ReLU激活函数 | 缓解梯度消失 | Nair & Hinton |
| 2012 | Dropout | 正则化,防过拟合 | Srivastava et al. |
| 2015 | BatchNorm | 加速训练,允许更深网络 | Ioffe & Szegedy |
| 2015 | 残差连接(ResNet) | 允许训练100+层网络 | He et al. |
| 2016 | Adam优化器 | 自适应学习率 | Kingma & Ba |
| 2017 | Transformer | 并行化,替代RNN | Vaswani et al. |
| 2020 | Scaling Laws | 更大=更好(幂律关系) | Kaplan et al. |
表17:深度学习关键技术突破时间线
每一个突破都是为了解决一个具体的问题。ResNet的残差连接(
y = F(x) + x)解决的是"深度网络反而比浅层网络差"的退化问题——通过跳跃连接,梯度可以"跳过"中间层直接传到前面,让训练100层甚至1000层成为可能。
8. 卷积神经网络(CNN):图像的语法
CNN是处理图像的"杀手级"架构。它的核心思想:局部连接 + 权重共享 + 池化。
8.1 CNN的核心组件
| 组件 | 功能 | 关键参数 | 作用 |
|---|---|---|---|
| 卷积层(Conv) | 用滤波器提取局部特征 | 核大小、步长、填充 | 特征提取 |
| 激活层(ReLU) | 引入非线性 | — | 非线性变换 |
| 池化层(Pool) | 降低空间分辨率 | 池化大小、步长 | 降维、平移不变性 |
| 全连接层(FC) | 将特征映射到输出 | 神经元数量 | 分类/回归 |
表18:CNN四大核心组件
8.2 卷积的数学
二维卷积的输出大小计算:
输出大小 = (输入大小 - 核大小 + 2×填充) / 步长 + 1
| 参数 | 符号 | 含义 | 典型值 |
|---|---|---|---|
| 输入大小 | W | 输入特征图的宽度/高度 | 224, 32, 7 |
| 核大小 | K | 卷积核的宽度/高度 | 3, 5, 7 |
| 填充 | P | 输入边缘填充的像素数 | 0, 1, 2 |
| 步长 | S | 卷积核每次移动的像素数 | 1, 2 |
| 输出大小 | O | 输出特征图的宽度/高度 | 计算得出 |
表19:卷积参数
为什么用3×3的小核而不是7×7的大核?两个3×3的卷积层堆叠,感受野等于一个5×5的核,但参数量只有 2×(3²×C²) vs 5²×C² ——少了近一半!VGGNet在2014年证明了这个策略的有效性。
8.3 经典CNN架构演进
| 架构 | 年份 | 层数 | 创新点 | ImageNet Top-5错误率 |
|---|---|---|---|---|
| LeNet-5 | 1998 | 5 | 第一个成功的CNN | — (手写数字) |
| AlexNet | 2012 | 8 | ReLU, Dropout, GPU训练 | 16.4% |
| VGGNet | 2014 | 16/19 | 小卷积核堆叠 | 7.3% |
| GoogLeNet | 2014 | 22 | Inception模块(多尺度) | 6.7% |
| ResNet | 2015 | 152 | 残差连接 | 3.6% |
| EfficientNet | 2019 | 可变 | 复合缩放 | 2.9% |
| Vision Transformer | 2020 | 12+ | 纯Transformer做视觉 | 2.0% |
表20:CNN架构演进
注意到一个趋势:从2020年开始,Transformer开始入侵CV领域。Vision Transformer(ViT)用纯Transformer处理图像,效果超过了CNN——这预示着"一个架构统一所有模态"的可能性。
9. 循环神经网络(RNN):序列的记忆
RNN是处理序列数据(文本、语音、时间序列)的经典架构。核心思想:用隐藏状态记住过去的信息。
9.1 RNN的基本结构
h_t = f(W_hh · h_(t-1) + W_xh · x_t + b)
y_t = W_hy · h_t + b_y
| 时间步 | 输入 | 隐藏状态 | 输出 | 说明 |
|---|---|---|---|---|
| t=1 | x₁ | h₁ = f(Wx₁ + Uh₀) | y₁ | 开始处理 |
| t=2 | x₂ | h₂ = f(Wx₂ + Uh₁) | y₂ | 记住了x₁ |
| t=3 | x₃ | h₃ = f(Wx₃ + Uh₂) | y₃ | 记住了x₁,x₂ |
| t=T | xT | hT = f(WxT + Uh_(T-1)) | yT | 记住了所有历史 |
表21:RNN的时间展开
隐藏状态h_t就像RNN的"记忆"——它理论上记住了从序列开始到现在的所有信息。但实际中,长距离的信息会被"稀释"——这就是梯度消失的后果。
9.2 LSTM:长短期记忆
LSTM(Long Short-Term Memory)通过三个"门"解决了长距离依赖问题 [4]:
| 门 | 公式 | 作用 | 类比 |
|---|---|---|---|
| 遗忘门(f) | f = σ(W_f · [h_(t-1), x_t] + b_f) | 决定丢弃哪些旧信息 | 擦黑板 |
| 输入门(i) | i = σ(W_i · [h_(t-1), x_t] + b_i) | 决定写入哪些新信息 | 写笔记 |
| 输出门(o) | o = σ(W_o · [h_(t-1), x_t] + b_o) | 决定输出哪些信息 | 选择性回答 |
表22:LSTM的三个门
LSTM的关键创新是细胞状态(Cell State)——一条"高速公路",信息可以几乎无损地流过许多时间步。遗忘门控制"高速公路"上丢弃什么,输入门控制加入什么。
9.3 RNN的变体
| 变体 | 特点 | 适用场景 |
|---|---|---|
| 简单RNN | 最基本,梯度消失严重 | 几乎不用了 |
| LSTM | 三个门+细胞状态 | 长序列 |
| GRU | 两个门,比LSTM简单 | 计算资源有限 |
| 双向RNN | 同时看过去和未来 | 文本理解 |
| 多层RNN | 多层堆叠 | 复杂模式 |
表23:RNN家族
GRU(Gated Recurrent Unit)是LSTM的简化版——把遗忘门和输入门合并为一个"更新门",去掉了细胞状态。效果和LSTM差不多,但参数更少、训练更快。在实际应用中,LSTM和GRU各有千秋。
9.4 RNN的根本问题
| 问题 | 原因 | 后果 |
|---|---|---|
| 梯度消失 | 长序列中梯度指数衰减 | 难以学习长距离依赖 |
| 串行计算 | 必须按时间步顺序处理 | 无法并行化,训练慢 |
| 内存瓶颈 | 隐藏状态大小固定 | 信息瓶颈 |
表24:RNN的根本问题
这三个问题最终催生了Transformer——用注意力机制替代循环,彻底解决了并行化和长距离依赖。RNN的"时代"就此落幕。
10. Transformer:注意力就是一切

图6:Transformer架构 —— 2017年以来最具影响力的架构
2017年,Google发表了"Attention Is All You Need"——Transformer架构诞生 [5]。这篇论文改变了整个AI的走向。
10.1 自注意力机制
自注意力(Self-Attention)的核心思想:让序列中的每个位置都能直接"看到"所有其他位置。
Attention(Q, K, V) = softmax(QK^T / √d_k) · V
| 组件 | 全称 | 含义 | 来源 |
|---|---|---|---|
| Q | Query | “我在找什么?” | 输入的线性变换 |
| K | Key | “我有什么?” | 输入的线性变换 |
| V | Value | “我的内容是什么?” | 输入的线性变换 |
| √d_k | 缩放因子 | 防止点积过大导致softmax饱和 | 维度的平方根 |
表25:自注意力的核心组件
直觉理解:想象你在图书馆找书。Query是你脑中的"需求",Key是书的"标签",Value是书的"内容"。你用需求去匹配标签(Q·K),找到最相关的书(softmax),然后读取内容(V)。
10.2 多头注意力
MultiHead(Q,K,V) = Concat(head_1, ..., head_h) · W^O
where head_i = Attention(QW_i^Q, KW_i^K, VW_i^V)
| 头数 | 每个头学什么 | 效果 |
|---|---|---|
| 头1 | 可能学语法关系 | 主语-谓语-宾语 |
| 头2 | 可能学指代关系 | 代词→先行词 |
| 头3 | 可能学语义相似 | 同义词关联 |
| 头4 | 可能学位置关系 | 相邻词关联 |
| … | … | … |
表26:多头注意力的直觉理解
多头注意力让模型从多个"角度"同时理解输入。就像一群专家看同一篇文章——语法专家关注句子结构,语义专家关注含义,风格专家关注用词。
10.3 位置编码
Transformer没有循环结构,天然不包含位置信息。所以需要显式添加位置编码(Positional Encoding):
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
| 位置编码方式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 正弦余弦(原始) | 不同频率的正弦/余弦函数 | 可泛化到更长序列 | 不够灵活 |
| 可学习位置编码 | 作为参数学习 | 灵活 | 不能泛化到训练长度之外 |
| RoPE | 旋转位置编码 | 相对位置感知,可外推 | 计算稍复杂 |
| ALiBi | 线性偏置 | 简单,长序列效果好 | 有衰减效应 |
表27:位置编码方式对比
RoPE(Rotary Position Embedding)是目前大模型的主流选择——它把位置信息编码为旋转角度,天然支持相对位置关系。LLaMA、GPT-NeoX等都用RoPE。
10.4 Transformer vs RNN vs CNN
| 特性 | RNN | CNN | Transformer |
|---|---|---|---|
| 长距离依赖 | 困难(梯度消失) | 有限(感受野) | 直接(注意力) |
| 并行化 | ❌ 串行 | ✅ 完全并行 | ✅ 完全并行 |
| 计算复杂度 | O(n·d²) | O(n·k²·d²) | O(n²·d) |
| 内存 | O(d) | O(n·d) | O(n²) |
| 位置感知 | 天然(时序) | 天然(局部) | 需要位置编码 |
| 主导领域 | 已过时 | 图像(正在被取代) | NLP, CV, 多模态 |
表28:三种序列模型架构对比
Transformer的计算复杂度是O(n²)——序列长度翻倍,计算量翻四倍。这就是为什么长上下文(100K+ tokens)是当前的研究热点。各种"高效Transformer"(Linformer, Performer, Flash Attention)都在试图解决这个问题。
11. 大语言模型(LLM):涌现与缩放定律
11.1 缩放定律(Scaling Laws)
2020年,OpenAI发现了语言模型的缩放定律[6]:
L(N) ∝ N^(-α_N)
L(D) ∝ D^(-α_D)
L(C) ∝ C^(-α_C)
其中L是损失,N是参数量,D是数据量,C是计算量。
| 缩放维度 | 关系 | 含义 | 关键发现 |
|---|---|---|---|
| 参数量(N) | L ∝ N^(-0.076) | 参数翻倍,损失降低约5% | 更大的模型效果更好 |
| 数据量(D) | L ∝ D^(-0.095) | 数据翻倍,损失降低约6% | 更多数据效果更好 |
| 计算量© | L ∝ C^(-0.050) | 计算翻倍,损失降低约3% | 更多算力效果更好 |
| 最优分配 | N ∝ C^0.73, D ∝ C^0.27 | 计算预算应大部分给参数 | 大模型+适量数据 |
表29:缩放定律核心发现
缩放定律的含义是深远的:只要增加参数、数据和算力,模型效果就会持续提升——而且是可以预测的。这就是为什么OpenAI、Google、Meta都在疯狂堆算力——因为数学告诉你,堆就完了。
11.2 涌现能力(Emergent Abilities)
当模型规模超过某个阈值时,会突然出现小模型不具备的能力:
| 涌现能力 | 出现的规模阈值 | 说明 |
|---|---|---|
| 思维链推理(CoT) | ~100B参数 | 分步推理复杂问题 |
| 少样本学习(Few-shot) | ~10B参数 | 给几个例子就能学会新任务 |
| 代码生成 | ~10B参数 | 理解自然语言描述生成代码 |
| 数学推理 | ~100B参数 | 多步数学推理 |
| 指令遵循 | ~10B参数 | 理解并执行复杂指令 |
| 多语言翻译 | ~10B参数 | 未专门训练的语言也能翻译 |
表30:LLM的涌现能力
涌现能力是LLM最令人惊讶的特性——你无法从小模型的表现预测大模型会有这些能力。就像水在99°C和100°C之间突然沸腾一样——质变发生在一个临界点。但也有人质疑:涌现可能只是评估指标的"假象"——换一种衡量方式,涌现可能就消失了。
11.3 主流大模型对比
| 模型 | 参数量 | 训练数据 | 架构 | 关键创新 |
|---|---|---|---|---|
| GPT-3 | 175B | 300B tokens | Decoder-only | 少样本学习 |
| PaLM | 540B | 780B tokens | Decoder-only | Pathways系统 |
| LLaMA | 7B-65B | 1.4T tokens | Decoder-only | 开源,小模型高效 |
| GPT-4 | ~1.8T(传闻) | ~13T tokens | MoE(传闻) | 多模态 |
| Claude 3 | 未知 | 未知 | Decoder-only | 长上下文(200K) |
| Gemini | 多版本 | 多模态 | Decoder-only | 原生多模态 |
| DeepSeek-V3 | 671B | 14.8T tokens | MoE | 开源MoE |
表31:主流大模型对比
参数量不是唯一指标——LLaMA-13B的效果可以媲美GPT-3(175B),因为数据质量和训练方法更重要。这就是"Chinchilla缩放"的核心:用更多数据训练更小的模型,可能比用少量数据训练大模型更高效。
11.4 训练LLM的三个阶段
| 阶段 | 目标 | 数据 | 方法 |
|---|---|---|---|
| 阶段1:预训练 | 学习语言知识 | 互联网文本(数万亿token) | 下一个token预测 |
| 阶段2:指令微调 | 学习遵循指令 | 人工标注的指令-回答对 | 监督微调(SFT) |
| 阶段3:对齐 | 符合人类偏好 | 人类排序的偏好数据 | RLHF/DPO |
表32:LLM训练三阶段
预训练让模型"读过互联网",获得广泛知识;指令微调让模型学会"听人话";对齐让模型"说人话"。这三个阶段缺一不可——没有预训练,模型什么都不懂;没有微调,模型不会遵循指令;没有对齐,模型可能输出有害内容。
12. 训练的工程学:优化器、正则化与调参
12.1 优化器演进
| 优化器 | 更新规则 | 特点 | 年份 |
|---|---|---|---|
| SGD | θ -= η·∇L | 最基础 | 1847 |
| Momentum | v = βv + ∇L; θ -= ηv | 加入"惯性" | 1964 |
| AdaGrad | θ -= η/√(Σg²) · ∇L | 自适应学习率 | 2011 |
| RMSProp | θ -= η/√(EMA(g²)) · ∇L | 修复AdaGrad | 2012 |
| Adam | 结合Momentum和RMSProp | 最常用 | 2015 |
| AdamW | Adam + 解耦权重衰减 | 更好的正则化 | 2019 |
| LAMB | Adam + 层自适应 | 大batch训练 | 2019 |
| Lion | sign-based | 更省内存 | 2023 |
表33:优化器演进
Adam几乎是目前的默认选择。它的核心思想:为每个参数维护独立的学习率——梯度大的参数用小学习率,梯度小的参数用大学习率。就像下山时,陡峭的地方小步走(防止冲过头),平缓的地方大步走(加快速度)。
12.2 正则化技术
| 技术 | 原理 | 效果 | 超参数 |
|---|---|---|---|
| L1正则化 | 损失 += λ·Σ | w | |
| L2正则化 | 损失 += λ·Σw² | 权重衰减 | λ |
| Dropout | 训练时随机丢弃神经元 | 防止共适应 | 丢弃率p |
| BatchNorm | 每层输入归一化 | 加速训练,允许更大LR | momentum |
| LayerNorm | 对每个样本归一化 | Transformer标配 | — |
| 数据增强 | 变换训练数据 | 增加数据多样性 | 各种变换 |
| 早停 | 验证集loss不降时停止 | 防止过拟合 | patience |
| 权重初始化 | Xavier/He初始化 | 保持梯度方差稳定 | — |
表34:正则化技术大全
Dropout的核心思想:训练时随机"关闭"一半的神经元,迫使网络学习冗余的表示——就像考试时随机抽掉几个学生,迫使剩下的学生必须能独立完成任务。测试时所有神经元都参与,但输出乘以(1-p)来补偿。
12.3 训练中的常见问题与解决
| 问题 | 症状 | 诊断方法 | 解决方案 |
|---|---|---|---|
| 过拟合 | 训练loss低,验证loss高 | 画学习曲线 | 更多数据、正则化、Dropout |
| 欠拟合 | 训练和验证loss都高 | 画学习曲线 | 更大模型、更复杂架构 |
| 梯度爆炸 | loss突然变NaN | 监控梯度范数 | 梯度裁剪 |
| 梯度消失 | 底层参数不更新 | 监控各层梯度 | ReLU、残差连接 |
| 学习率过大 | loss震荡不收敛 | 监控loss曲线 | 降低LR |
| 学习率过小 | loss下降极慢 | 监控loss曲线 | 增大LR |
| 数据泄露 | 测试集表现异常好 | 检查数据划分 | 严格划分数据 |
表35:训练中的常见问题诊断
训练深度学习模型就像做饭——火候(学习率)太大了会糊,太小了不熟;食材(数据)不新鲜会出问题;调料(正则化)放多了没味道,放少了太腻。经验和直觉很重要,但也有一些"食谱"(最佳实践)可以参考。
13. AI的数学基础:你真的需要知道的那些
13.1 线性代数
| 概念 | 在AI中的应用 | 为什么重要 |
|---|---|---|
| 向量 | 数据表示、嵌入(Embedding) | 一切数据最终都是向量 |
| 矩阵乘法 | 线性层、注意力机制 | 神经网络的核心运算 |
| 转置 | QK^T计算 | 注意力分数 |
| 点积 | 相似度计算 | 注意力权重 |
| 特征值/特征向量 | PCA降维、稳定性分析 | 理解数据的内在结构 |
| 范数 | 正则化、梯度裁剪 | 控制参数大小 |
表36:线性代数在AI中的应用
13.2 概率与统计
| 概念 | 在AI中的应用 | 为什么重要 |
|---|---|---|
| 概率分布 | 输出层(Softmax)、生成模型 | 模型输出就是概率 |
| 贝叶斯定理 | 后验概率、先验知识 | 不确定性推理 |
| 最大似然估计 | 损失函数推导 | 交叉熵损失的来源 |
| KL散度 | 分布匹配、知识蒸馏 | 衡量两个分布的差异 |
| 期望 | 损失函数的计算 | 平均意义上的优化目标 |
| 采样 | 生成式AI的输出 | 从分布中采样token |
表37:概率统计在AI中的应用
13.3 微积分
| 概念 | 在AI中的应用 | 为什么重要 |
|---|---|---|
| 偏导数 | 梯度计算 | 损失对每个参数的变化率 |
| 链式法则 | 反向传播 | 多层网络的梯度传递 |
| 梯度 | 参数更新方向 | 指引优化方向 |
| 泰勒展开 | 优化器理论 | 近似损失函数曲面 |
| 雅可比矩阵 | 多变量梯度 | 向量化计算 |
| 海森矩阵 | 二阶优化 | 曲率信息 |
表38:微积分在AI中的应用
不需要成为数学家才能做AI——但理解这些概念会让你"知其所以然"。梯度下降就是"沿着最陡的方向下山",反向传播就是"用链式法则算每一步的坡度"。把这两个搞明白,AI的数学核心你就懂了一大半。
14. AI的能力边界与哲学思考
14.1 AI能做什么和不能做什么
| AI擅长 | AI不擅长 |
|---|---|
| 模式识别(图像、语音、文本) | 真正的理解和因果推理 |
| 大规模数据分析 | 常识推理 |
| 生成式任务(写作、绘画、编程) | 创造性思维(目前) |
| 在固定规则下优化 | 处理全新未见的情况 |
| 重复性任务(不疲倦) | 需要身体经验的任务 |
| 统计相关性 | 因果关系 |
表39:AI的能力边界
14.2 关键争论
| 争论 | 正方观点 | 反方观点 |
|---|---|---|
| LLM有理解力吗? | 行为上表现出理解 | 只是统计模式匹配 |
| 会达到AGI吗? | 缩放定律指向AGI | 可能有不可逾越的瓶颈 |
| AI会取代人类工作吗? | 大量重复性工作会被取代 | 新的工作会被创造出来 |
| AI有意识吗? | 功能上可能有 | 没有生物基础 |
| 开源vs闭源 | 促进创新和安全 | 安全风险vs垄断风险 |
表40:AI领域的关键争论
"LLM到底有没有理解力?"这个问题目前没有定论。一个有趣的类比:你不需要理解空气动力学原理就能骑自行车——也许LLM不需要"理解"就能完成大部分任务。但这种"不需要理解的理解"在面对全新场景时可能会失败。
14.3 AI安全与对齐
| 风险类型 | 说明 | 缓解方法 |
|---|---|---|
| 幻觉(Hallucination) | 模型编造不存在的事实 | RAG、事实验证 |
| 偏见(Bias) | 训练数据中的偏见被放大 | 数据清洗、公平性约束 |
| 有害输出 | 生成有害/不适当内容 | RLHF、安全过滤器 |
| 提示注入 | 恶意输入绕过安全限制 | 输入验证、安全训练 |
| 过度优化 | 对指标优化但不符合真实目标 | 多目标优化、人类评估 |
| 权力集中 | 少数公司控制最强大模型 | 开源、监管 |
表41:AI安全风险与缓解
AI对齐(Alignment)的核心问题:如何确保AI系统的目标和人类的目标一致?这听起来简单,但实际上极其困难——因为你很难用数学精确定义"人类的目标"是什么。RLHF是一个尝试,但它也有局限性。
15. 总结:第一性原理清单
把AI的"地基"整理成一个可执行的清单:
| 序号 | 第一性原理 | 一句话总结 | 数学表达 |
|---|---|---|---|
| 1 | 函数逼近 | AI = 找一个函数 | f(X) ≈ Y |
| 2 | 损失最小化 | 衡量预测有多差 | min L(θ) = Σloss(ŷ, y) |
| 3 | 梯度下降 | 沿最陡方向走 | θ -= η·∇L |
| 4 | 链式法则 | 复合函数的导数 | (f∘g)’ = f’·g’ |
| 5 | 非线性激活 | 线性组合不够用 | y = σ(Wx + b) |
| 6 | 层次化特征 | 深度比宽度高效 | h_l = f(W_l · h_(l-1)) |
| 7 | 注意力机制 | 动态加权求和 | softmax(QK^T/√d)·V |
| 8 | 缩放定律 | 更大 = 更好(幂律) | L ∝ N^(-α) |
| 9 | 正则化 | 约束复杂度防过拟合 | L_reg = L + λ·R(θ) |
| 10 | 数据驱动 | 数据决定上限 | 垃圾进,垃圾出 |
表42:AI第一性原理十诫
掌握这十条原理,你就有了理解任何AI论文和产品的"X光眼镜"——不管表面多花哨,底层逻辑都在这十条里。
核心公式速查:
前向传播:    y = f(Wx + b)
损失函数:    L = -Σ yᵢ·log(ŷᵢ)          (交叉熵)
梯度下降:    θ_new = θ_old - η·∇L        (参数更新)
反向传播:    ∂L/∂w = ∂L/∂y · ∂y/∂z · ∂z/∂w  (链式法则)
注意力:      Attn = softmax(QK^T/√d_k)·V  (自注意力)
缩放定律:    L(N,D) ∝ N^(-0.076) · D^(-0.095)
softmax:     σ(zᵢ) = e^zᵢ / Σe^zⱼ        (归一化)
“AI is the new electricity.” —— Andrew Ng
电力在100年前改变了世界的一切。AI正在做同样的事。但和电力一样,你不需要成为电气工程师才能用电——你只需要理解基本原理,就能用它创造价值。
16. 参考文献
[1] Rosenblatt, F. (1958). “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain”. Psychological Review, 65(6), 386-408. DOI: 10.1037/h0042519.
[2] Minsky, M., & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press. ISBN: 978-0262630221.
[3] Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). “Learning representations by back-propagating errors”. Nature, 323(6088), 533-536. DOI: 10.1038/323533a0.
[4] Hochreiter, S., & Schmidhuber, J. (1997). “Long Short-Term Memory”. Neural Computation, 9(8), 1735-1780. DOI: 10.1162/neco.1997.9.8.1735.
[5] Vaswani, A., et al. (2017). “Attention Is All You Need”. Advances in Neural Information Processing Systems (NeurIPS), 30. arXiv: 1706.03762.
[6] Kaplan, J., et al. (2020). “Scaling Laws for Neural Language Models”. arXiv preprint, arXiv:2001.08361.
[7] Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. ISBN: 978-0262035613.
[8] LeCun, Y., Bengio, Y., & Hinton, G. (2015). “Deep Learning”. Nature, 521(7553), 436-444. DOI: 10.1038/nature14539.
[9] He, K., et al. (2016). “Deep Residual Learning for Image Recognition”. Proceedings of the IEEE CVPR, 770-778. DOI: 10.1109/CVPR.2016.90.
[10] Kingma, D. P., & Ba, J. (2015). “Adam: A Method for Stochastic Optimization”. Proceedings of ICLR. arXiv: 1412.6980.
[11] Devlin, J., et al. (2019). “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”. Proceedings of NAACL-HLT, 4171-4186.
[12] Brown, T. B., et al. (2020). “Language Models are Few-Shot Learners”. Advances in Neural Information Processing Systems (NeurIPS), 33. arXiv:2005.14165.
[13] Touvron, H., et al. (2023). “LLaMA: Open and Efficient Foundation Language Models”. arXiv preprint, arXiv:2302.13971.
[14] Ouyang, L., et al. (2022). “Training language models to follow instructions with human feedback”. Advances in Neural Information Processing Systems (NeurIPS), 35. arXiv:2203.02155.
[15] Hoffmann, J., et al. (2022). “Training Compute-Optimal Large Language Models”. Advances in Neural Information Processing Systems (NeurIPS). arXiv:2203.15556. (Chinchilla论文)
[16] Wei, J., et al. (2022). “Emergent Abilities of Large Language Models”. Transactions on Machine Learning Research (TMLR). arXiv:2206.07682.
[17] Dosovitskiy, A., et al. (2021). “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale”. Proceedings of ICLR. arXiv:2010.11929.
[18] Silver, D., et al. (2017). “Mastering the game of Go without human knowledge”. Nature, 550(7676), 354-359. DOI: 10.1038/nature24270.

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)