【大模型基础|微调篇01】—— 后训练之大模型微调(Fine Tuning)详解:SFT、FFT核心流程及常见微调方法详解
后训练之大模型微调(Fine%20Tuning)详解:SFT、FFT 核心流程及常见微调方法详解
很多人一上来就问「微调到底用 LoRA 还是全参」,但连自己卡在后训练的哪个环节、要解决什么问题都没想清楚。选错方法,要么显存不够训不动,要么花了几张卡的钱干了一件本该几百块搞定的事。
这篇文章解决一件事:把大模型微调这件事从「概念」到「选型」讲透。覆盖后训练的整体位置、微调的通用流程、全参与 PEFT 的两条路线,以及 5 种主流方法的原理、超参和适用场景。
一、先定位:微调在「后训练」里的位置
搞清楚微调,得先知道它在整条链路里的坐标。
一个大模型从零到能用,大致走三步:
| 阶段 | 做什么 | 数据 | 典型成本 |
|---|---|---|---|
| 预训练(Pre-training) | 从随机初始化学到语言与世界的通用规律 | 万亿级无标注语料 | 千卡月级 |
| 后训练(Post-training) | 让模型听懂指令、符合人类偏好 | 万~十万级标注数据 | 数卡日级 |
| 推理部署(Serving) | 把训练好的模型高效跑起来 | —— | 看流量 |
后训练是这一篇的主场,它内部又分两段:
- SFT(Supervised Fine-Tuning,监督微调):教模型「按指令办事」。给指令—回答的成对数据,让模型学会遵循格式、回答问题。
- 偏好对齐(Preference Alignment):教模型「把事办好」,输出符合人类偏好。DPO、KTO、RLHF 都在这一段。
🔴 重点:微调属于后训练,它不负责给模型注入全新知识,而是激活和引导模型已具备的能力。指望用微调让 1.8B 模型学会它预训练里根本没有的知识,方向就错了。
二、微调的通用流程
不管选哪种方法,流程都是这四步。差别只在「模型调优」这一环用哪套手段。
2.1 数据准备
- 格式:SFT 用「指令—回答」对,领域适配用纯领域语料。主流格式是 JSONL,每行一条样本。
- 质量:去重、去噪、清洗格式。这一步的收益通常大于调参,脏数据带出来的模型问题,靠调学习率是救不回来的。
- 规模:SFT 通常数千到数万条。数据不是越多越好,几百条高质量样本做出一个垂直助手是完全可行的。
2.2 模型调优
- 选路线:全参微调,还是参数高效微调(PEFT)。
- 配超参:学习率、batch size、训练轮数。LoRA 场景下学习率常在
1e-4量级,全参则在1e-5量级。 - 盯指标:训练 loss 是否平稳下降、验证集指标是否同步改善。训练 loss 降但验证 loss 抬头,是过拟合的信号。
2.3 评估迭代
- 自动化:分类任务看 Accuracy / F1,生成任务看 ROUGE / BLEU,垂直领域还可以用评测集(如 C-Eval、MMLU 或自建集)。
- 人工抽验:重点看逻辑性、事实性、安全性。生成任务尤其不能只看自动指标。
- 迭代:根据评估结果补数据或调超参,重新训练。
2.4 部署落地
- 压缩:量化(AWQ / GPTQ / FP8)、蒸馏。
- 加速:用 vLLM / SGLang 这类推理引擎替代原生 Transformers。
- 监控:线上收集 bad case,必要时做第二轮微调。
三、两条路线:全参微调 vs 参数高效微调
微调的本质是「调整参数以适配任务」。按调整参数的范围,分成两大类。
| 维度 | 全参微调(Full FT / FFT) | 参数高效微调(PEFT) |
|---|---|---|
| 训练参数 | 模型全部参数 | 仅新增的少量参数,通常 < 1% |
| 显存需求 | 高,7B 模型通常要数张 A100 | 低,单卡可跑 7B |
| 灾难性遗忘风险 | 较高 | 低,主干冻结 |
| 效果上限 | 略高 | 优质数据下差距很小 |
| 部署 | 直接产出完整权重 | 需合并权重或额外加载 adapter |
| 适合谁 | 大厂、核心任务、数据充足 | 中小企业、个人、垂直领域 |
⚠️ 注意:「PEFT 效果一定差」是个误解。在数据质量过关的前提下,LoRA 与全参微调的效果差距往往小到业务上分不出来,但成本差一个数量级。除非你有明确证据表明全参更好,否则从 PEFT 起步。
四、5 种主流方法详解
4.1 LoRA —— 最常用的轻量微调
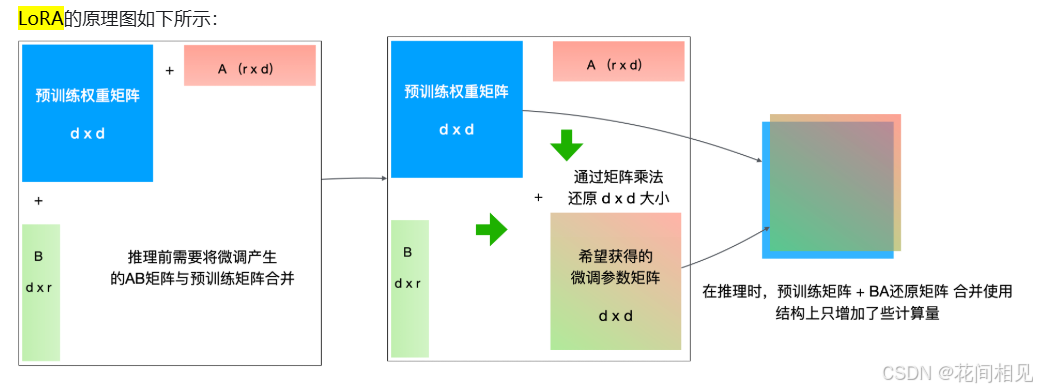
核心原理:冻结原模型权重,在旁路插入两个低秩矩阵 A 和 B,只训练这两个小矩阵。前向时把 B × A 加到原权重上。
设原权重矩阵 W 维度为 d × d。不做全量更新,而是学一个低秩增量:
W_final = W + (α / r) · B · A
其中 A 是 r × d(降维),B 是 d × r(升维),r 远小于 d。
举个例子:要更新一个 1000×1000 的矩阵,直接更新要 1,000,000 个参数;LoRA 取 r=8,只需训练 1000×8 + 8×1000 = 16,000 个参数,压缩了 98% 以上。r 越小省得越多,但表达能力也越弱。
关键超参:
| 参数 | 作用 | 常见取值 |
|---|---|---|
r(rank) | 低秩矩阵的秩,决定表达能力 | 8 / 16 / 32 / 64 |
α(alpha) | 缩放系数,与 r 共同决定缩放比 α/r | 通常为 r 的 1~2 倍 |
关于 α 和 r 的关系,需要澄清一个常见说法:「α 等于 rank」既不准确也不是定论。真正起作用的是比值 α/r,它决定了 LoRA 增量对原权重的实际影响幅度。业界常见做法是 α = 2r(如 r=16, α=32),而 ms-swift 的默认值是 r=8, α=32,即 α/r = 4。这个比值没有普适最优解,需要结合数据量和任务难度调。
优点:训练参数少、单卡可训、可合并权重、部署无额外开销。
缺点:依赖低秩假设;对需要大幅改变模型行为的复杂任务,效果可能不如全参。
4.2 QLoRA —— 更省显存的 LoRA
核心原理:在 LoRA 基础上,先把基座模型量化到 4bit 再训练 LoRA 分支。基座权重以 4bit 常驻显存,只有 LoRA 分支是训练精度。
关键技术是双量化(Double Quantization):连量化本身用到的缩放因子也再量化一次,进一步压缩。
在 ms-swift 中,QLoRA 不是靠 --load_in_4bit 开关(3.12 的参数表里没有这个参数),而是通过量化参数组合实现:
swift sft \
    --model Qwen/Qwen2.5-7B-Instruct \
    --train_type lora \
    --quant_method bnb \
    --quant_bits 4 \
    --bnb_4bit_quant_type nf4
参数含义以官方文档为准:
quant_method可选bnb / hqq / eetq / quanto / fp8,quant_bits与bnb_4bit_quant_type(nf4/fp4,默认nf4)控制量化细节。
与 LoRA 的区别:QLoRA = 量化 + LoRA,显存占用更低,代价是量化精度损失。对精度极度敏感的任务(如医疗诊断)要谨慎评估。
4.3 Adapter Tuning —— 模块化插入
核心原理:在 Transformer 层之间插入独立的适配器模块,结构通常是「降维 → 非线性激活 → 升维」。训练时只更新适配器。
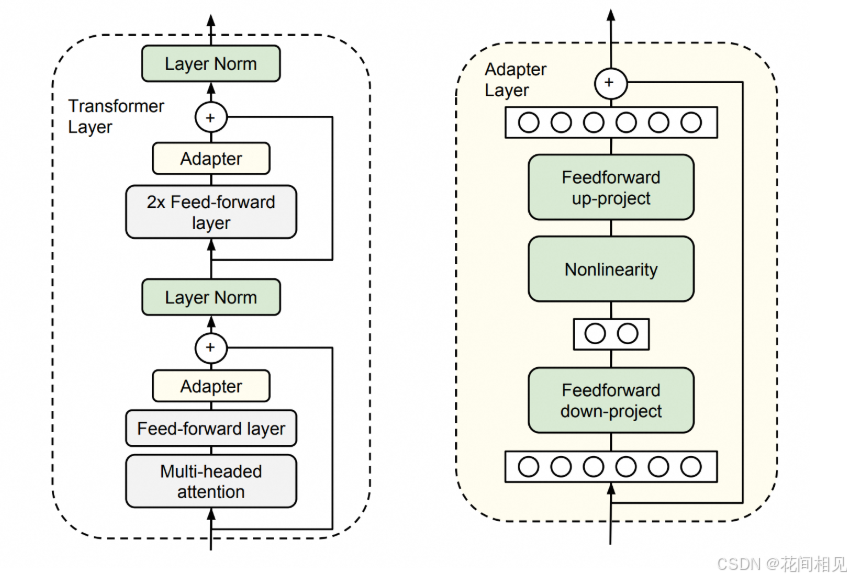
优点:模块化,可插拔,多任务可共用主干。
缺点:改变了模型结构,部署时必须加载适配器层,无法像 LoRA 那样无损合并。
4.4 Prefix Tuning —— 在每层前面加前缀
核心原理:在每层 Transformer 的注意力计算前,拼接一段可学习的前缀向量。主干和输入嵌入都冻结。
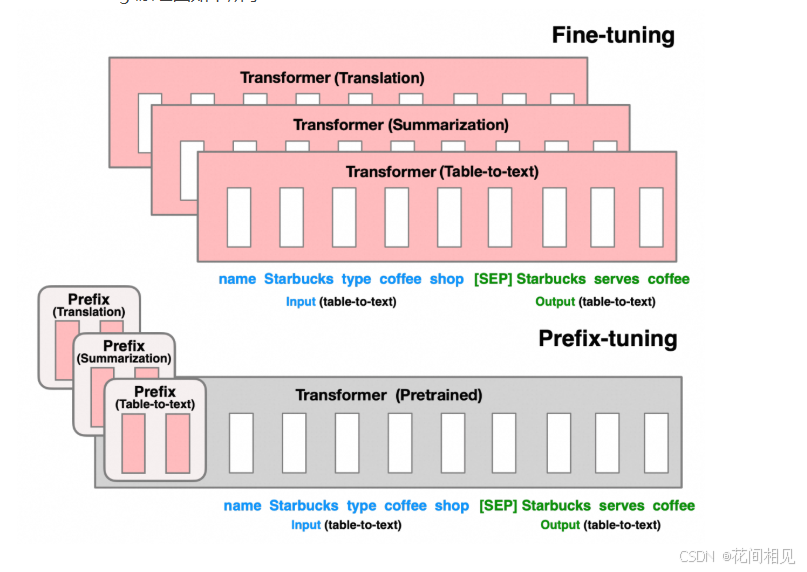
关键区别:前缀是贯穿所有层的,因此表达能力比只在输入层加向量的 Prompt Tuning 更强。
优点:不改模型结构,生成任务效果较好,多个任务可共享主干、只换前缀。
缺点:前缀长度需要调(短了效果差、长了占上下文),占用宝贵的上下文窗口。
4.5 Prompt Tuning —— 只在输入层加提示
核心原理:与 Prefix Tuning 类似,但可学习向量只在输入层添加,不贯穿各层,参数量更少。
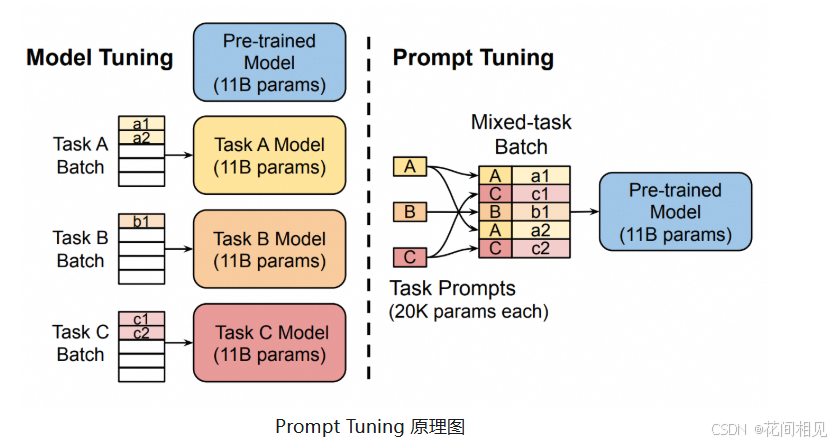
优点:参数最少、部署最简单。
缺点:对提示初始化敏感;生成任务效果通常不如 LoRA / Prefix Tuning,更擅长分类这类判别式任务。
五、对比与选型
| 方法 | 训练参数占比 | 显存 | 结构改动 | 核心优势 | 推荐场景 |
|---|---|---|---|---|---|
| LoRA | 0.1%~1% | 低 | 无(可合并) | 效果与成本平衡 | 绝大多数场景首选 |
| QLoRA | 0.1%~1% | 极低 | 无(量化+LoRA) | 低显存跑大模型 | 单卡、30B+ 模型 |
| Adapter | 1%~5% | 中低 | 有(新增模块) | 模块化、多任务 | 多任务并存 |
| Prefix Tuning | 5%~10% | 中 | 无 | 生成任务较好 | 摘要、对话生成 |
| Prompt Tuning | 最少 | 极低 | 无 | 参数最少 | 文本分类等判别任务 |
选型口诀:
- 拿不准就选 LoRA,性价比最高;
- 显存不够上 QLoRA;
- 分类任务试 Prompt Tuning;
- 生成任务可试 Prefix Tuning;
- 多任务共享主干用 Adapter。
六、常见误区
❌ 误区 1:微调能给模型补知识
微调的主作用是对齐格式与风格、激活已有能力。要注入新知识,优先考虑 RAG;微调更适合「教它怎么答」而不是「教它知道什么」。
❌ 误区 2:数据越多越好
几百条脏数据不如几十条干净的。数据质量、覆盖面、格式一致性,比堆量重要得多。
❌ 误区 3:α 必须等于 rank
α 单独看没有意义,起作用的是 α/r。不同框架默认值不同,照抄别的项目的数字前,先确认它的 r 是多少。
❌ 误区 4:全参一定比 LoRA 强
在数据质量达标时,两者业务效果的差距常常在噪声范围内,但成本差一个数量级。先用 PEFT 验证可行性,确有瓶颈再上全参。
❌ 误区 5:只看训练 loss
训练 loss 一路下降不代表模型变好,那可能只是记住了训练集。必须留出验证集,并做人工抽验。
七、总结:你真正需要记住的 N 件事
- 微调属于后训练,承接预训练、服务部署,核心是对齐而非补知识。
- 通用流程四步:数据准备 → 模型调优 → 评估迭代 → 部署落地,收益最大的一步是数据。
- 两条路线:全参微调效果上限略高但成本高;PEFT 成本低、遗忘风险小,是绝大多数场景的起点。
- LoRA 的关键是
α/r比值,不是α或r的绝对值;默认值随框架而变,别照抄。 - QLoRA 靠量化基座省显存,在 ms-swift 3.12 里用
--quant_method bnb --quant_bits 4实现。 - 选型顺序:LoRA → QLoRA → Prompt/Prefix/Adapter,按显存、任务类型、是否多任务逐层筛选。
验证清单
- 数据集已去重、清洗,格式为合法 JSONL,每行一条样本
- 已划分验证集,训练时能观察到验证指标
- LoRA 训练前确认了
r与α的取值,并记录了α/r比值 - 训练完成后做过人工抽验,而非只看 loss 曲线
- 若用 QLoRA,确认量化配置与精度影响可接受
- 导出时确认权重已合并(部署场景)或 adapter 已随行
参考资源
- ms-swift 官方文档(命令行参数):https://swift.readthedocs.io/en/v3.12/Instruction/Command-line-parameters.html
- ms-swift 自定义数据集:https://swift.readthedocs.io/en/v3.12/Customization/Custom-dataset.html
- LoRA 论文(Hu et al., 2021):https://arxiv.org/abs/2106.09685
- QLoRA 论文(Dettmers et al., 2023):https://arxiv.org/abs/2305.14314
- Hugging Face PEFT 文档:https://huggingface.co/docs/peft
标签
#大模型微调 #FineTuning #SFT #LoRA #QLoRA #PEFT #后训练 #新手教程

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 7
 0
- 0


 已为社区贡献23条内容

所有评论(0)