kubernetes学习(八)存储
1、ConfigMap(配置信息存储)
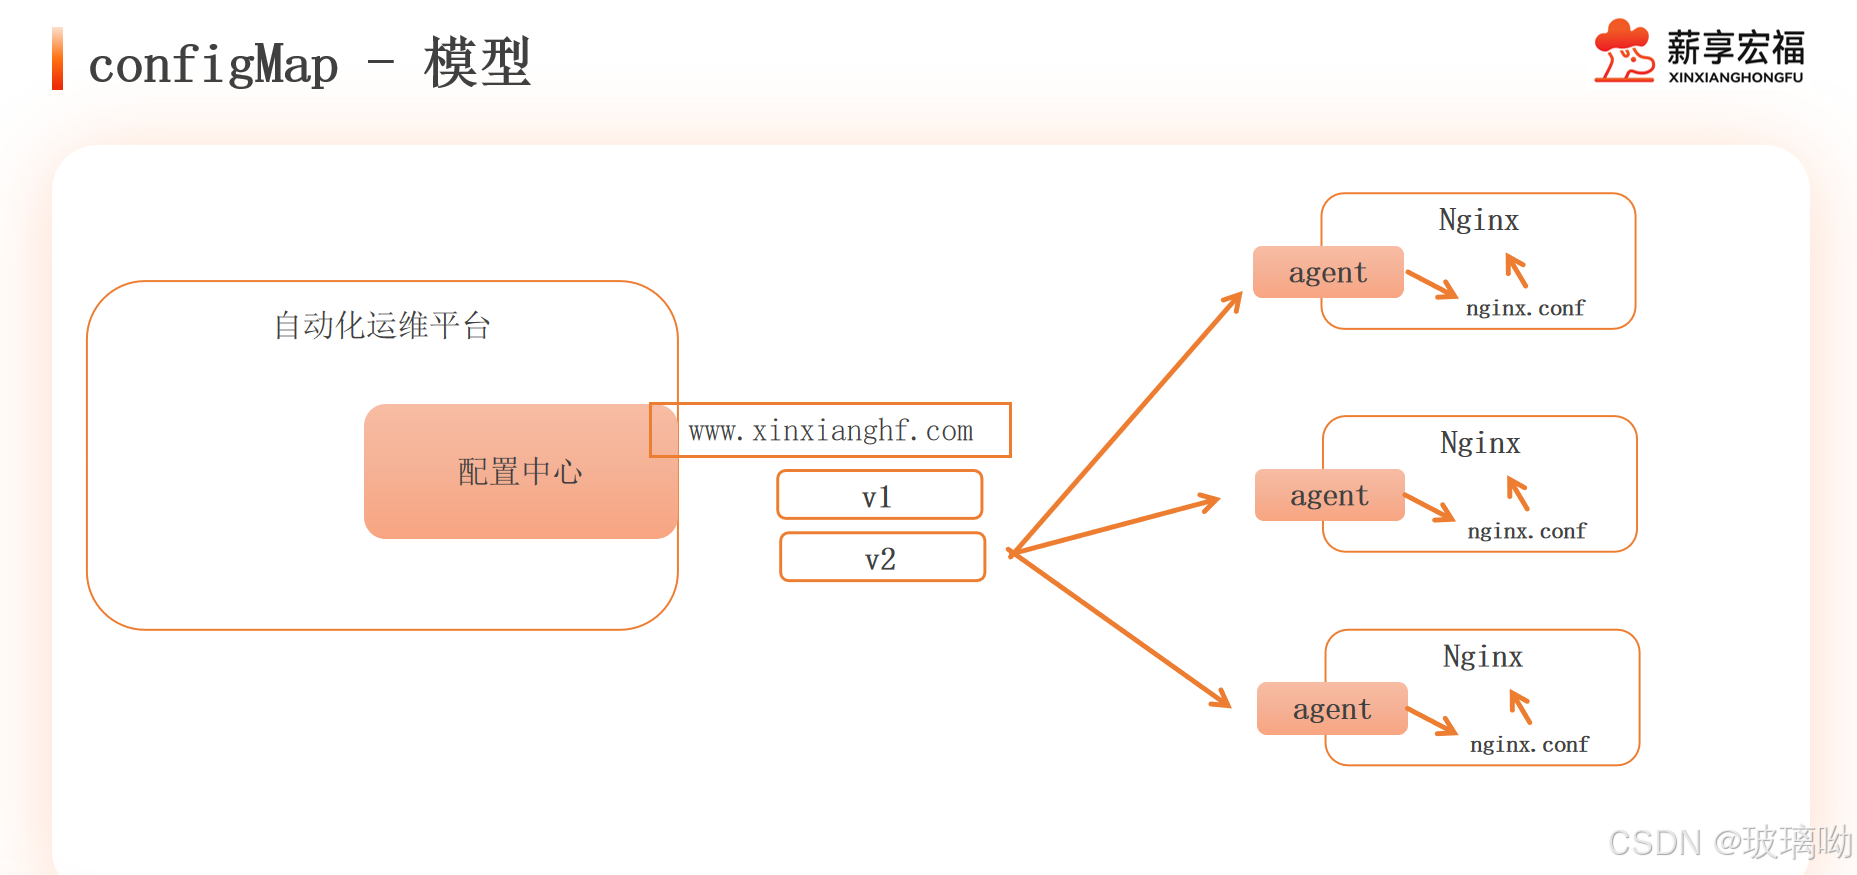
看图,三台nginx,他们在同一业务、环境下,配置信息也应该一样。某天需要修改nginx配置,假设nginx有300台,难道要一台一台修改吗?这时候引出了配置中心ConfigMap(cm),(如果不能满足需求可以开发自定义配置中心)
首先在每个节点上安装一个agent端,agent端的作用就是监控配置中心的资源是否发生更新动作,如果有agent端就会去配置中心下载最新的配置文件来替换当前的,然后触发nginx重载,使配置生效。如果配置更新了新版本的话比如v3,还可以经agent端指向到新版本上进行更新与重载
cm功能在k8s 1.2版本中引入,许多应用程序会从配置文件、命令行参数或环境变量中读取配置信息。ConfigMap API给我们提供了向容器中注入配置信息的机制,cm可以被用来保存单个属性,也可以用来保存整个配置文件或者JSON二进制等对象
ConfigMap的创建方式
cm的创建方式也分为声明式和命令式,但是由于cm通常变动频繁、需要临时配置调试并且配置内容大多来自外部文件。导致声明式创建方式写yaml清单有点繁琐,所以命令式创建较为常用。
先看下命令式的创建,分为四种,常用的需要学习,非常用作为补充了解,避免看到了不认识
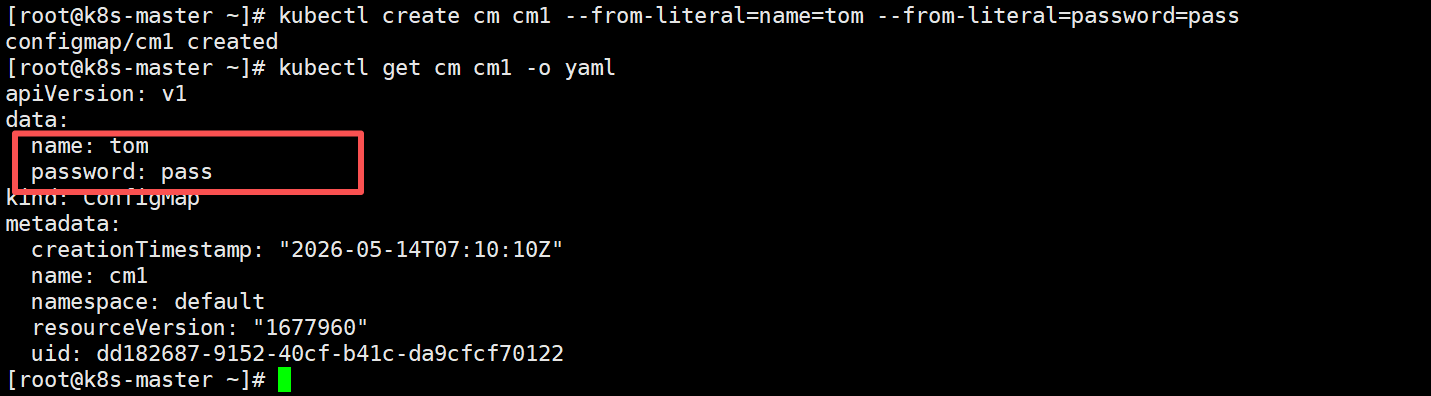
字面值创建(常用)
kubectl create configmap <cmName> --from-literal=name=tom --from-literal=password=pass

#这种方式创建值是一对一对的
文件创建(常用)
kubectl create configmap <cmName> --from-file=<fileName>

#这种方式创建,文件名会变成“键”,文件内容会变成“值”,文件内容要一行一行的写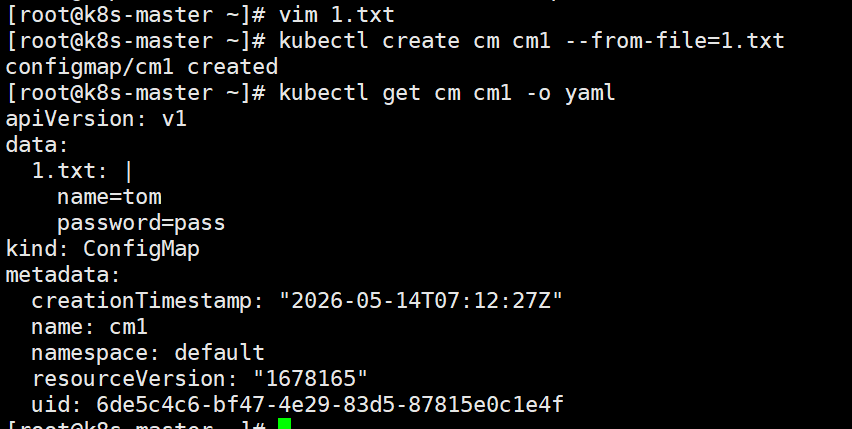
目录创建
kubectl create cm <cmName> --from-file=<dirPath>

#此方式创建,目录下的每个文件名作为键,文件内容作为值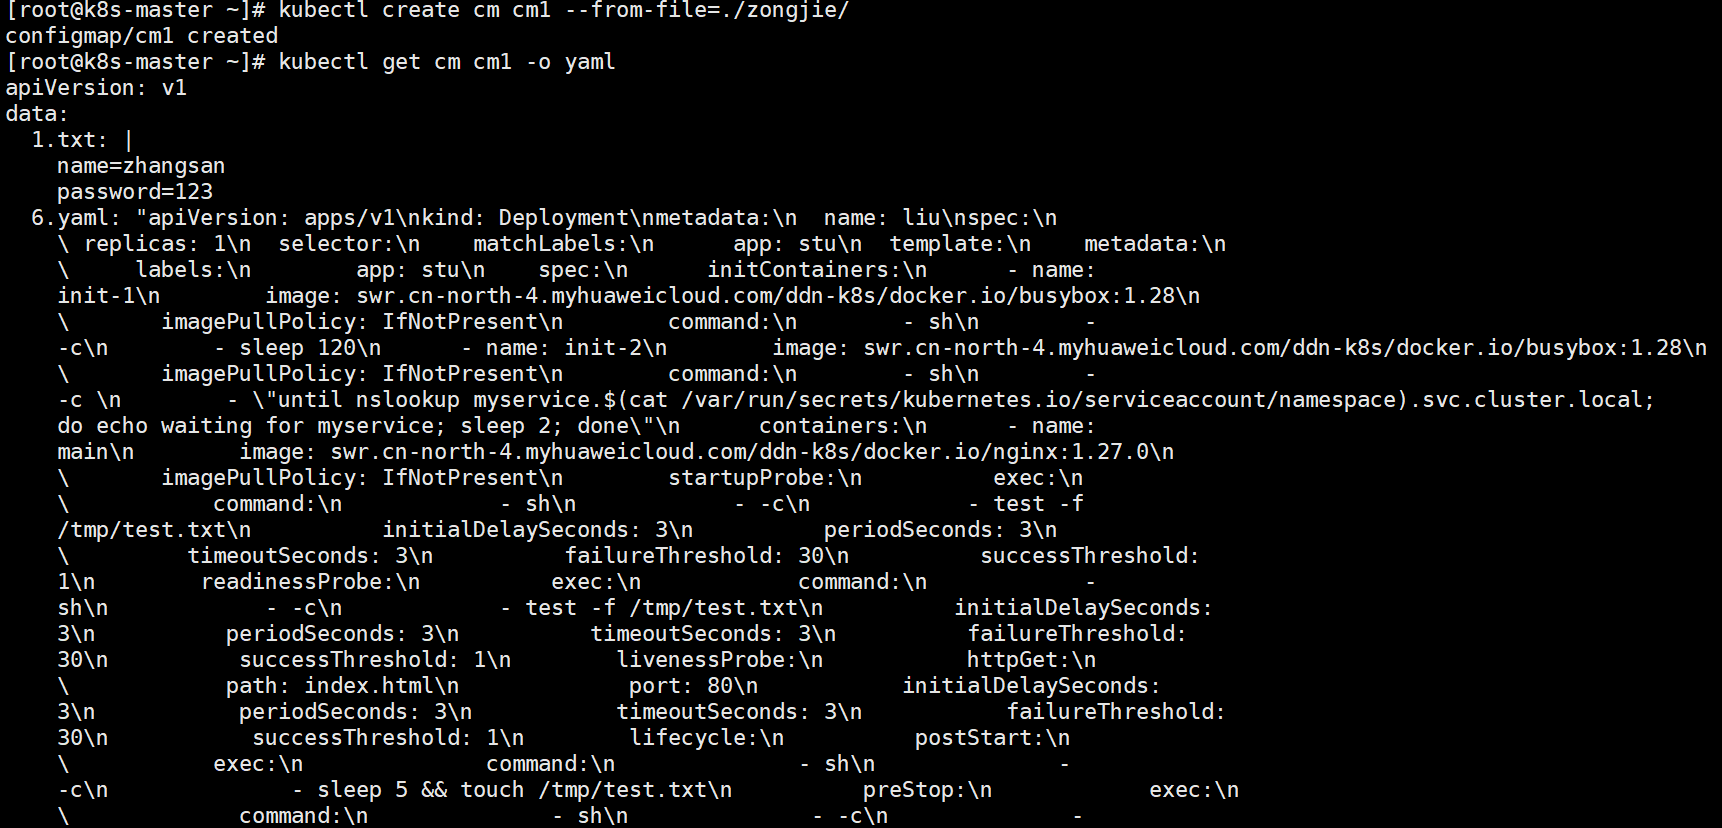
env文件创建
kubectl create cm <cmName> --from-env-file=<fileName>

#此方式乍一看和从文件创建一样,但是这个方式创建的cm,它是以文件中内容为键值的,而不是文件名为“键”,内容为“值”,仔细看可以看出区别

#所以从以文件为基础创建cm的话,文件内容键值必须以键值对方式,一行一行的写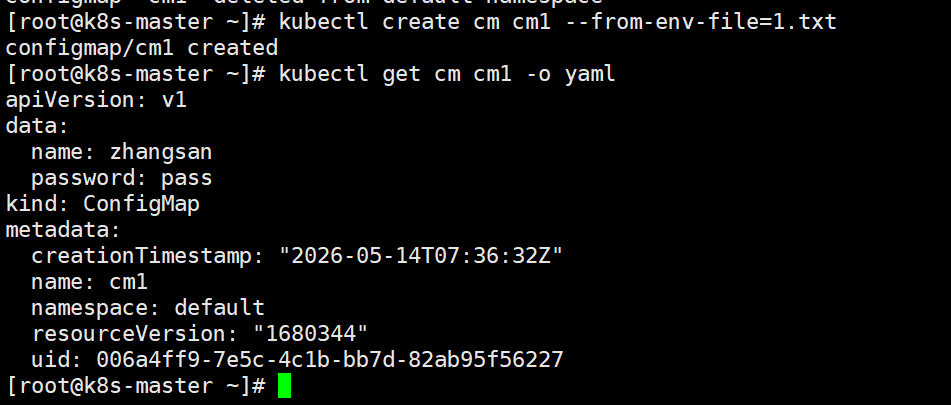
基础yaml格式
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  name: jim
  password: pass
多行字符串格式
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  app.conf: |
    database.host=mysql.local
    database.port=3306
    logs.level=INFO
  script.sh: |
    #!/bin/bash
    echo "Hello World"
复杂数据格式
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  config.json: |
    {
      "name": "tom",
      "debug": true,
      "timeout": 30
    }
ConfigMap的使用方式
注入机制是k8s提供的一种将配置信息注入容器应用的机制。它分为三种使用方式,
作为环境变量注入
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  name: jim
  password: pass

---

apiVersion: v1
kind: ConfigMap
metadata:
  name: cm2
data:
  logs_level: INFO
  debug_level: BUG

---

apiVersion: v1
kind: Pod
metadata:
  name: test-cm
spec:
  containers:
  - name: test-cm-container
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - sh
    - -c
    - env
    env:  # 定义容器的环境变量
    - name: USERNAME    #变量名
      valueFrom:    #环境变量引用
        configMapKeyRef:      #指定变量从ConfigMap中引用
          name: cm1    #指定引用的ConfigMap名称
          key: name    #这个key后面跟的是键名,告诉我们值要去哪个键找。实际是引用键后面的值
    - name: PASSWORD
      valueFrom:
        configMapKeyRef:
          name: cm1
          key: password
    envFrom:    # 使用ConfigMap将多个键值对作为环境变量传递
    - configMapRef:
        name: cm2
  restartPolicy: Never  #Pod的重启策略:不会自动重启,不加这个的话容器运行结束会不断的重启。因为pod的重启策略是Always,不管什么原因结束pod他都会重启
创建对象,可以看到两个cm被创建了出来,pod执行完env命令后变成了完成状态,pod日志可以发现容器执行env命令的打印结果,变量都已经添加进去了
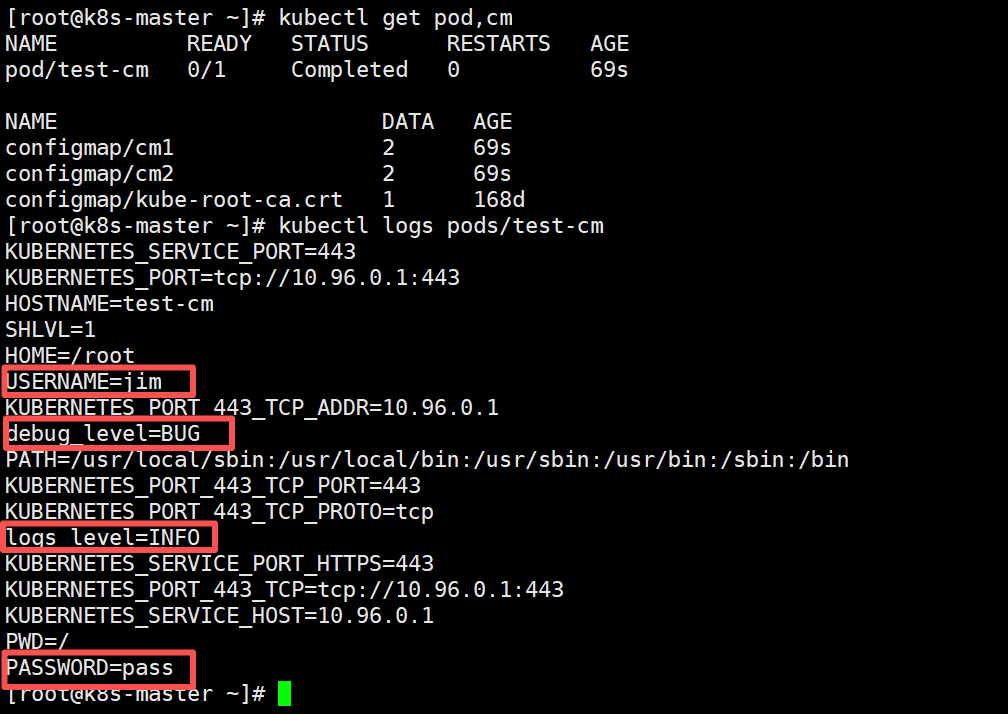
从清单中可以看到pod引用环境变量的方式有两种env和envFrom。两种的区别就是
env:灵活,精准,将值取出给要赋予的变量,可以看到引用变量的时候键名也可以更改
envFrom:它的使用场景一般在cm中所有的键都成为环境变量是使用,范围更广,省事儿
两种方式按需使用
作为命令行参数使用
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  name: tom
  password: pass

---

apiVersion: v1
kind: Pod
metadata:
  name: test-cm
spec:
  containers:
  - name: test-cm-contianer
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - sh
    - -c
    - echo $USERNAME $PASSWORD
    env:
    - name: USERNAME
      valueFrom:
        configMapKeyRef:
          name: cm1
          key: name
    - name: PASSWORD
      valueFrom:
        configMapKeyRef:
          name: cm1
          key: password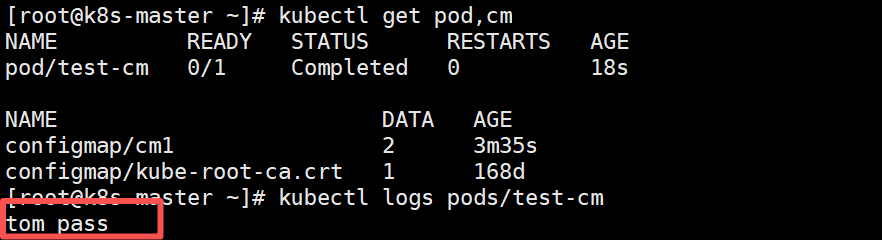
作为挂载卷使用
apiVersion: v1
kind: ConfigMap
metadata:
  name: cm1
data:
  name: tom
  password: pass

---

apiVersion: v1
kind: Pod
metadata:
  name: test-cm
spec:
  containers:
  - name: test-cm-container
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - sh
    - -c
    - sleep 3600
    volumeMounts:    #定义容器中的挂载卷
    - name: cm-volume    #挂载的卷的名称
      mountPath: /etc/config    #卷挂载到容器内的路径
  volumes:    #定义pod中使用的卷
  - name: cm-volume  #挂载卷的名字
    configMap:        #卷的数据来源
      name: cm1
  restartPolicy: Never
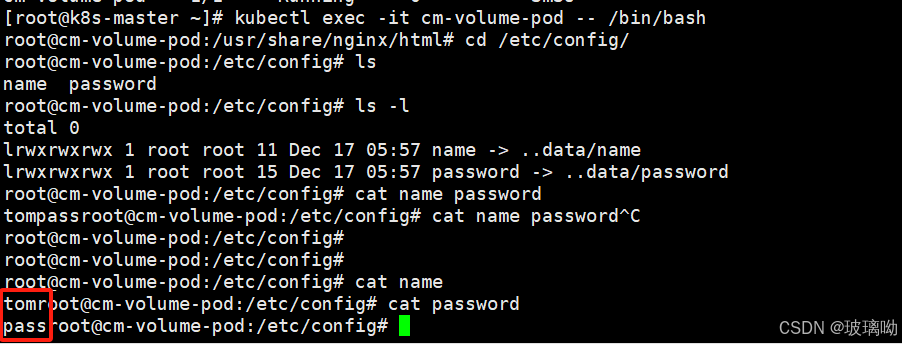
启动资源对象后进入pod,cd /etc/config会有两个文件,key就是文件名,values就是文件内容。
这里需要说明一点是,cm作为卷挂载时,本质就是把 data 中的每个键变成一个文件。 而 --from-file 创建cm时,也是把每个文件名变成一个键(key)。它们的设计哲学是相通的:文件名/键名 → 文件,文件内容/键值 → 文件内容,
简单说:Volume 挂载时的"键",就相当于从文件创建时的"文件名"。
作为挂载卷的热更新
还是这张图,可以看到cm作为卷挂载的时候,查看了文件的详细信息。发现这两个文件是以软连接的方式存在的,为什么会这样?
在本章开始我就描述了一个场景:后端服务,其配置文件通过配置中心进行动态管理。配置中心的更新方式是直接覆盖目标文件(而非共享读取)。假设服务的配置文件是一个软链接,它指向真实的配置文件。当配置中心更新配置时,它会直接覆盖这个软链接所指向的真实文件。在覆盖操作执行的那一瞬间,如果服务正在读取该配置文件,可能会读取到不完整或损坏的数据
为了解决上述问题,k8s设计了基于软链接原子切换的热更新机制:
初始状态:一个软链接指向第一个配置文件(且只有这一个链接指向它)。
热更新流程:
-
配置中心将新配置写入第二个新文件
-
将软链接的指向原子性地切换到第二个文件
-
删除第一个文件(旧配置)
为什么这样做有效:
-
切换链接指向是原子操作,不会出现"读到一半被覆盖"的情况
-
正在读取旧配置的服务进程,由于已经打开了旧文件的文件句柄,即使文件被删除也能正常读完
-
新请求打开软链接时,会得到新配置文件
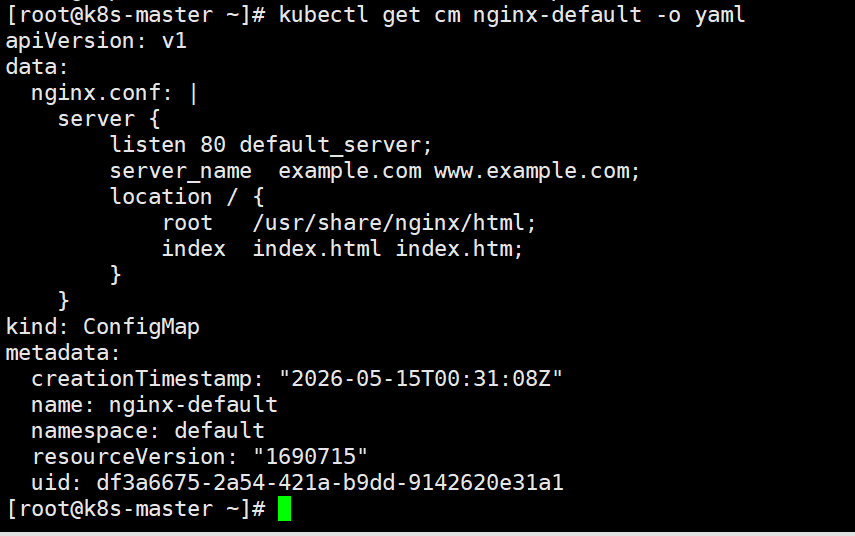
好,理论结束,开始实践,将nginx配置导入到一个文件中,创建cm对象
vim nginx.conf
server {
    listen 80 default_server;
    server_name  example.com www.example.com;
    location / {
        root   /usr/share/nginx/html;
        index  index.html index.htm;
    }
}
再创建一个deployment控制器,调用cm作为挂载卷
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cm-deploy
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stu
  template:
    metadata:
      labels:
        app: stu
    spec:
      containers:
      - name: cm-nginx
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/nginx:1.27.0
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: config-volume
          mountPath: /etc/nginx/conf.d/
      volumes:
      - name: config-volume
        configMap:
          name: nginx-default
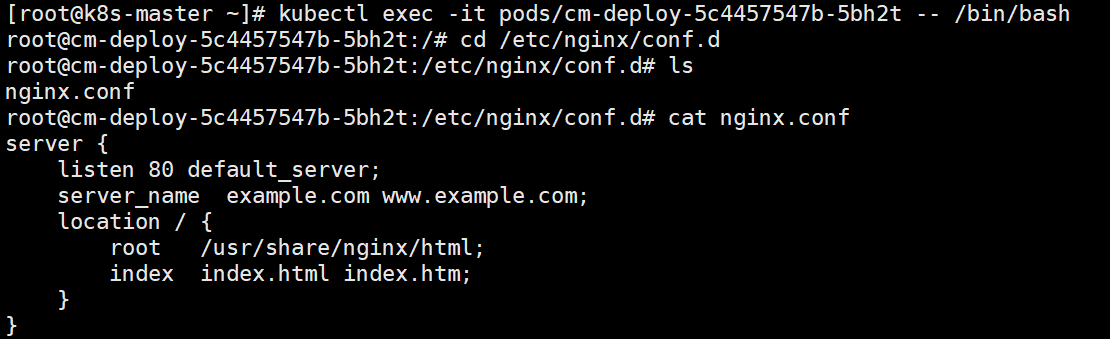
进入pod内查看默认文件,可以看到调用是成功的
写个死循环一直cat默认文件
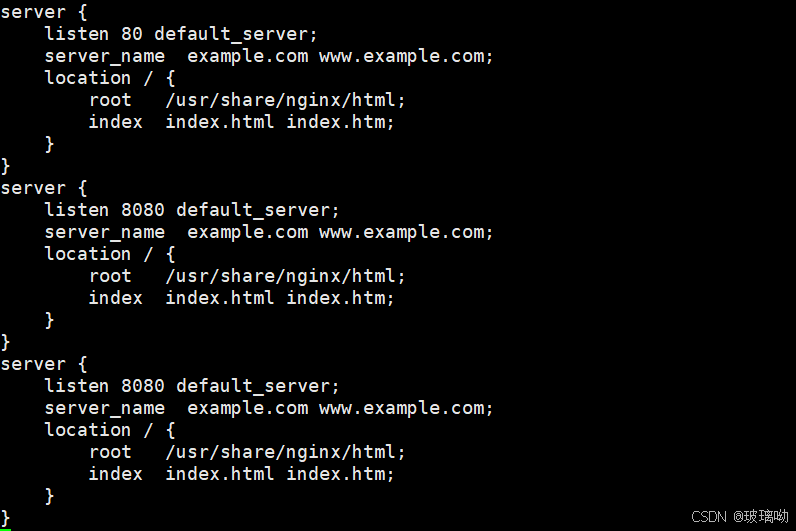
while true ;do cat /etc/nginx/conf.d/nginx.conf ;sleep 2 ;donekubectl edit修改cm,将监听端口改为8080试试看,观察pod内部是否能够热更新成功。需要一点时间来进行更新,并不是瞬时操作,他需要自己去安排。比如有1000个pod,配置一旦改变了这1000个pod都需要改变,此刻服务器io压力是巨大的
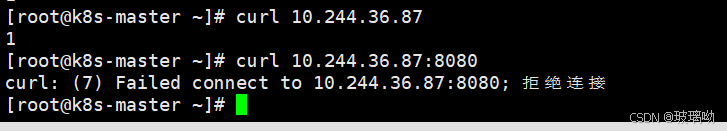
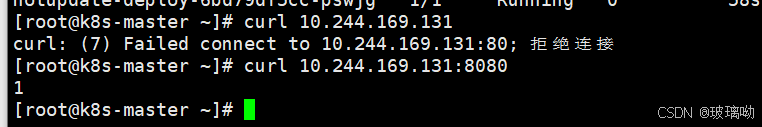
访问一个pod测试下是可以访问成功的,但是8080访问失败,因为pod内的nginx容器没有重启,新配置未应用,访问的还是80端口。nginx不支持这种监控文件变化重启自身的操作,所以k8s给了一个接口
作为挂载卷的热更新方法
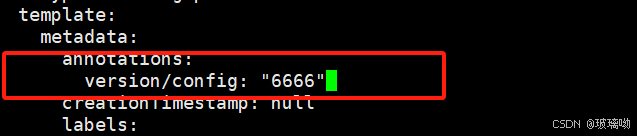
deployment.sepc.template.annotations
注意一点,控制器级别的annotations修改是不会重建pod的,pod级别修改才行
更新cm目前并不会触发相关pod的滚动更新,可以通过kubectl edit修改annotations的方式强制触发滚动更新,如果没有这个字段就加上即可
它的原理是,Deployment 控制器会监控其 Pod 模板(spec.template)的变更。当修改了 spec.template.metadata.annotations 中的任意内容(比如加一个时间戳),Deployment 控制器会认为这是一个新的、期望的状态,于是就会执行一次滚动更新,创建新 Pod,销毁旧 Pod。
新 Pod 启动时,会重新从 ConfigMap 拉取最新的配置,然后 Nginx 容器启动并加载最新配置,但是有点不方便的是,新Pod启动后,IP也会随之改变。每次修改完配置后都要改一下这个参数,感觉不是很好用
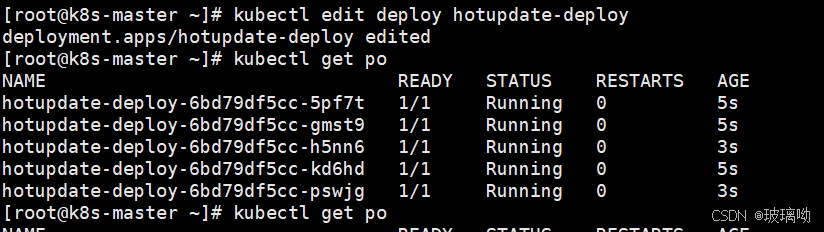
修改之后立马pod立马进行了重启,再次访问8080试下
作为挂载卷禁止更新
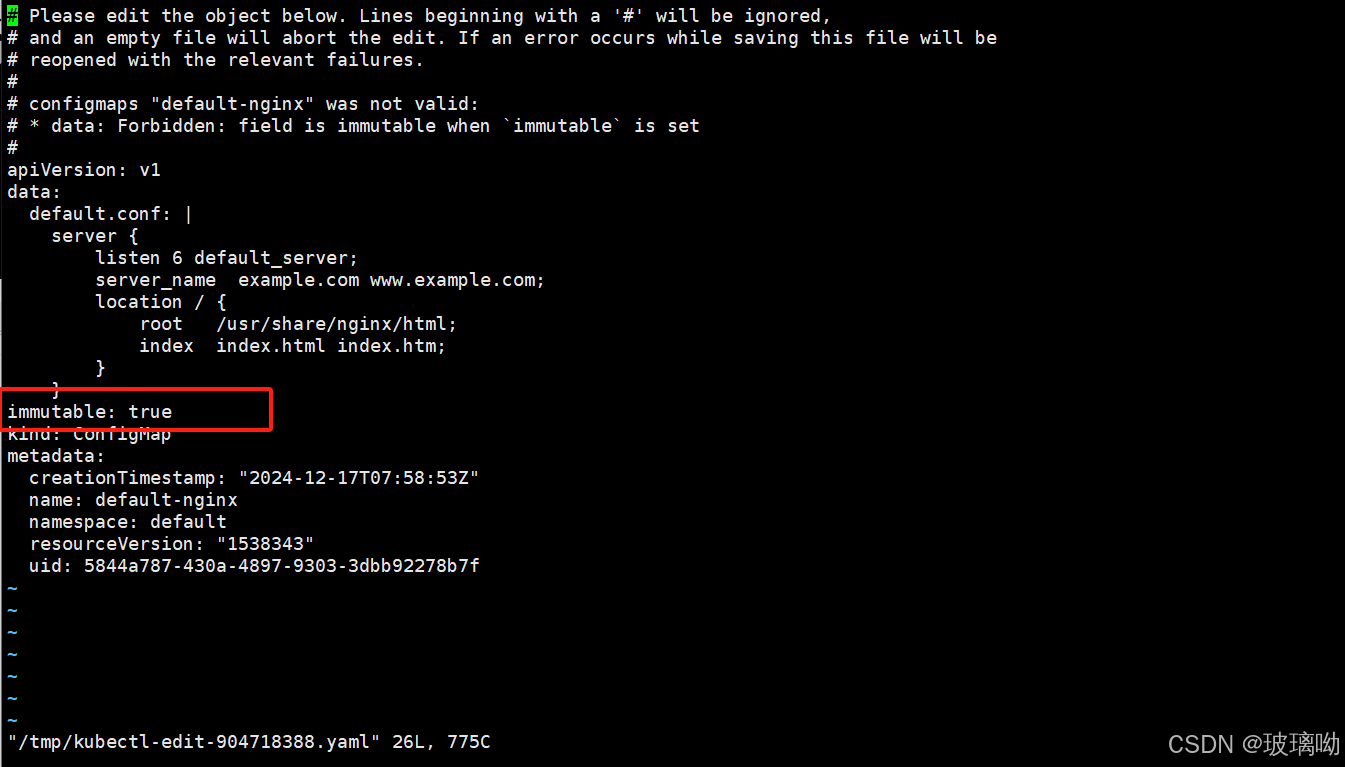
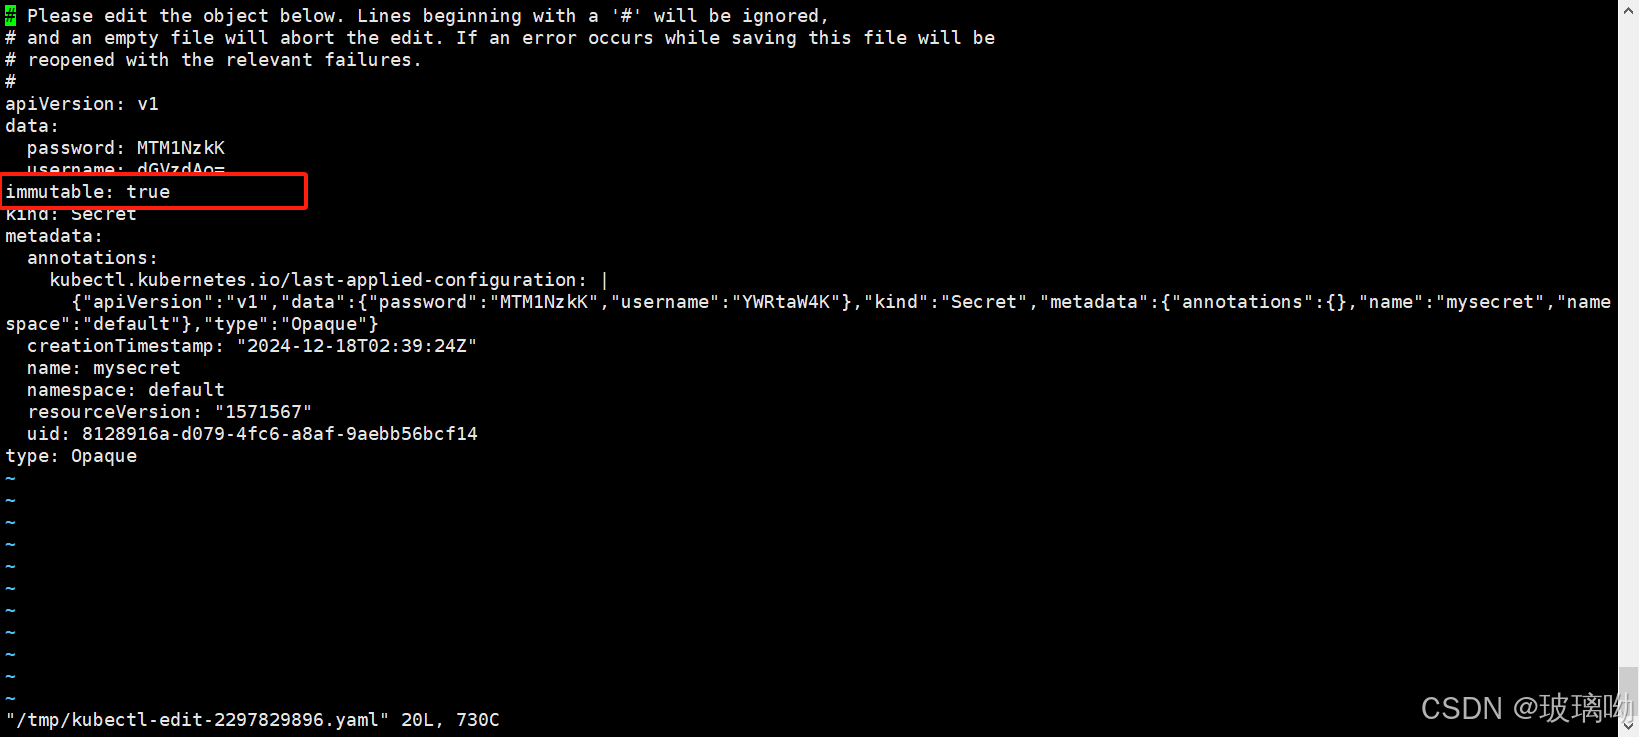
configmap.immutable
k8s给不可改变的cm和secret提供了一个可选配置,可以设置各个secret和cm为禁止修改。对于大量使用cm的集群(至少成千上万各不相同的cm供pod挂载),禁止修改他们的数据有以下好处
- 防止意外(或非预期的)更新导致应用程序中断
- 通过将cm标记为禁止修改来关闭kube-apiserver对其的监视,从而显著降低kube-apiserver的负载提升集群性能
这个选项是不可逆的,添加这个字段后cm无法做任何修改,删除这个参数也做不到,只能删除cm对象,重新建立
2、Secret(敏感信息存储)
secret对象类型以编码的方式用来保存敏感信息,例如密码、OAuth令牌和SSH密钥。将这些信息放在secret中比放在pod的定义或者容器镜像中来说更加安全和灵活,是编码不是加密
secret特性有三个
- k8s通过仅仅将secret分发到需要访问secret的pod所在机器节点来保障其安全性
- secret只会存储在节点的内存中,永不写入物理存储,这样从节点删除secret时就不需要擦除磁盘数据
- 从k8s 1.7开始,etcd会以加密形式存储secret,一定程度保证了secret安全性
演示下编码
[root@k8s-master ~]# echo test |base64
dGVzdAo=
[root@k8s-master ~]# echo dGVzdAo= |base64 -d
test
[root@k8s-master ~]#

如果解码没有编码过的数据会报错

[root@k8s-master ~]# echo 666 |base64 -d
뭢ase64: 输入无效
[root@k8s-master ~]#
Secret的类型
创建 Secret 时,你可以使用 Secret 资源的 type 字段,或者与其等价的 kubectl 命令行参数(如果有的话)为其设置类型。 Secret 类型有助于对 Secret 数据进行编程处理。
Kubernetes 提供若干种内置的类型,用于一些常见的使用场景。 针对这些类型,Kubernetes 所执行的合法性检查操作以及对其所实施的限制各不相同
| 类型 | 作用 |
Opaque | 用户定义的任意数据,默认 |
kubernetes.io/service-account-token | 服务账号令牌 |
kubernetes.io/dockercfg | ~/.dockercfg 文件的序列化形式 |
kubernetes.io/dockerconfigjson | ~/.docker/config.json 文件的序列化形式 |
kubernetes.io/basic-auth | 用于基本身份认证的凭据 |
kubernetes.io/ssh-auth | 用于 SSH 身份认证的凭据 |
kubernetes.io/tls | 用于 TLS 客户端或者服务器端的数据 |
bootstrap.kubernetes.io/token | 启动引导令牌数据 |
这里就先将各种类型列出来,作为补充了解,方便后续碰到相关的进行查找,我们本章主要讲的就是opaque默认类型,同时也是最通用和常用的类型
Opaque
先来做一个最简单的演示,来看下secret所达成的效果
#用户和密码先进行编码

[root@k8s-master ~]# echo admin |base64
YWRtaW4K
[root@k8s-master ~]# echo 12345 |base64
MTIzNDUK


apiVersion: v1
kind: Secret
metadata:
  name: mysecret
type: Opaque
data:
  username: YWRtaW4K
  password: MTIzNDUK

#secret中,values会自动进行解码,所以一旦使用Opaque类型切记要先进行数据编码,不然解码会出错
可以用kubectl describe查一下,secret的数据段是看不到的,但是cm可以
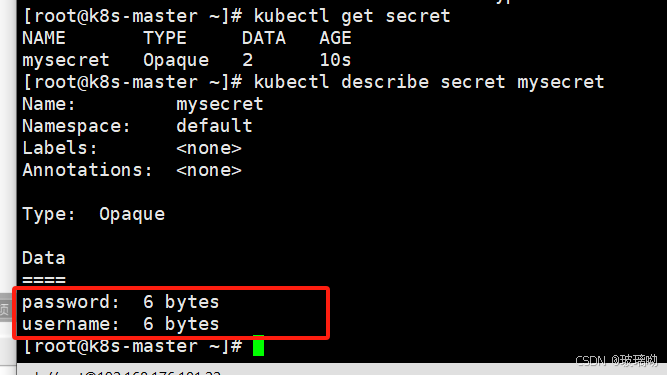
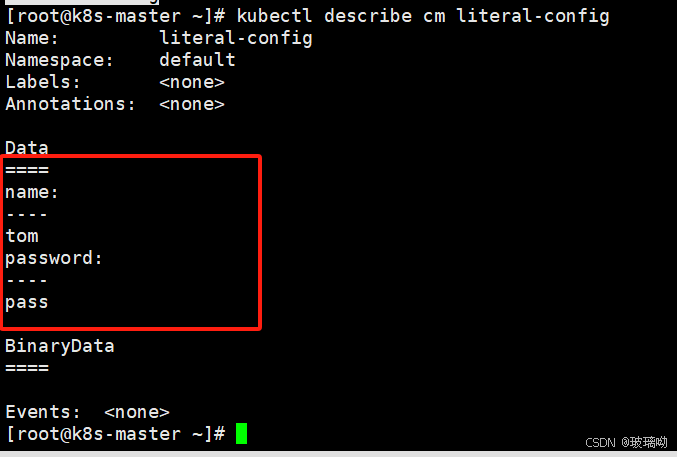
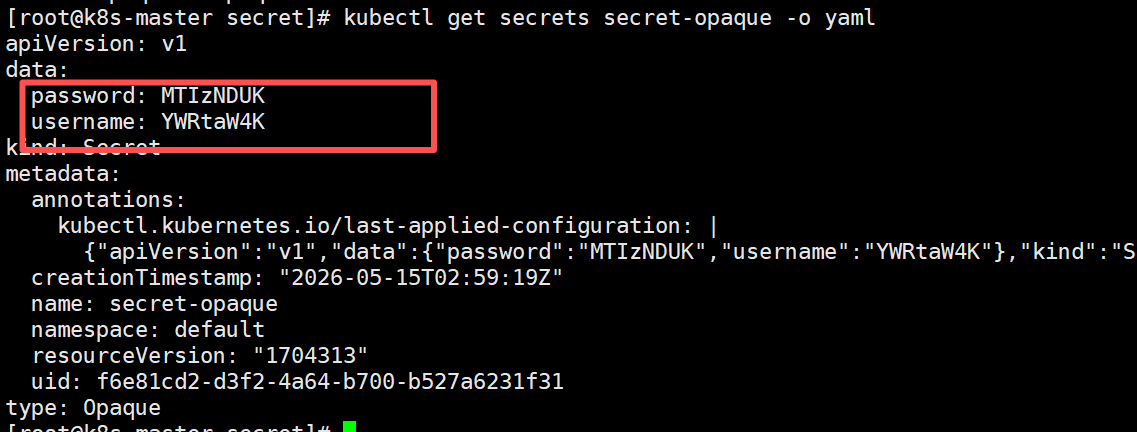
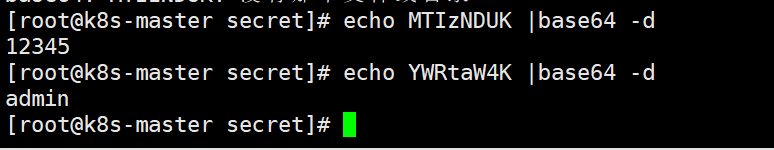
想要获取数据段用-o yaml方式,可以看到是编码形式显示的,然后使用base64解码就得到了想要的结果
作为环境变量注入
apiVersion: apps/v1
kind: Deployment
metadata:
  name: opaque-secret-env-deploy
  labels:
    app: opaque-secret-env
spec:
  replicas: 5
  selector:
    matchLabels:
      app: op-se-env-pod
  template:
    metadata:
      labels:
        app: op-se-env-pod
    spec:
      containers:
        - name: myapp-container
          image: nginx:v1
          imagePullPolicy: IfNotPresent
          env:
            - name: TEST_USER
              valueFrom:
                secretKeyRef:
                  name: mysecret
                  key: username
            - name: TEST_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: mysecret
                  key: password
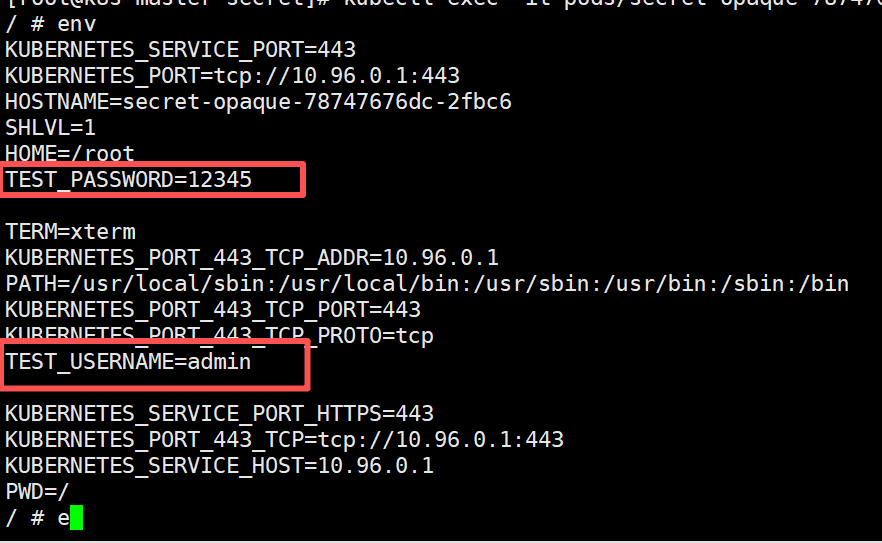
随便进入一个pod可以看到容器内环境变量已经添加了代码中引入的变量,并且都已经进行了解码
作为挂载卷使用
apiVersion: apps/v1
kind: Deployment
metadata:
  name: secret-opaque-volume
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stu
  template:
    metadata:
      labels:
        app: stu
    spec:
      containers:
      - name: opaque-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
        imagePullPolicy: IfNotPresent
        command:
        - sh
        - -c
        - sleep 3600
        volumeMounts:
        - name: secret-volume
          mountPath: "/data"
      volumes:
      - name: secret-volume
        secret:
          secretName: secret-opaque
进入pod容器内部,看下挂载卷,在顺便看下/data/..data/目录下的源文件,发现源文件是一个644权限
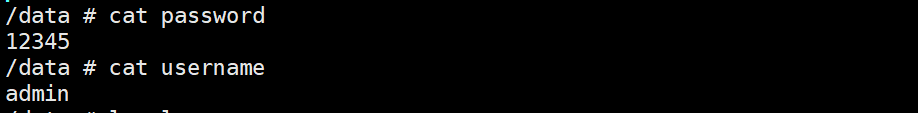
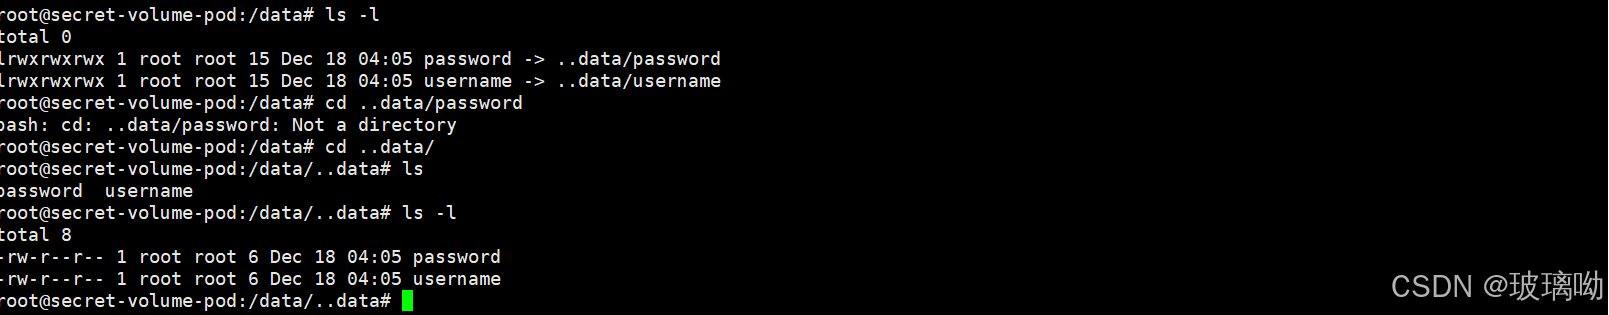
既然是管理安全的那就只让一个人看就好了,将它修改下权限修改挂载卷的权限
需要在运行的控制器中将defaultMode字段进行修改,默认是420,此字段在deployment.spec.tamplate.spec.volumes.secret.defaultMode
修改后会发现所有的pod都进行了重建。因为k8s中对 Pod.Spec 的更新做了一些限制,防止某些字段被修改,所以不允许在 Pod 已经运行后修改。defaultMode 是与卷权限相关的配置,属于卷配置的一部分,因此一旦 Pod 创建后,卷相关的设置不允许更新
apiVersion: apps/v1
kind: Deployment
metadata:
  name: secret-opaque-volume
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stu
  template:
    metadata:
      labels:
        app: stu
    spec:
      containers:
      - name: opaque-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
        imagePullPolicy: IfNotPresent
        command:
        - sh
        - -c
        - sleep 3600
        volumeMounts:
        - name: secret-volume
          mountPath: "/data"
      volumes:
      - name: secret-volume
        secret:
          secretName: secret-opaque
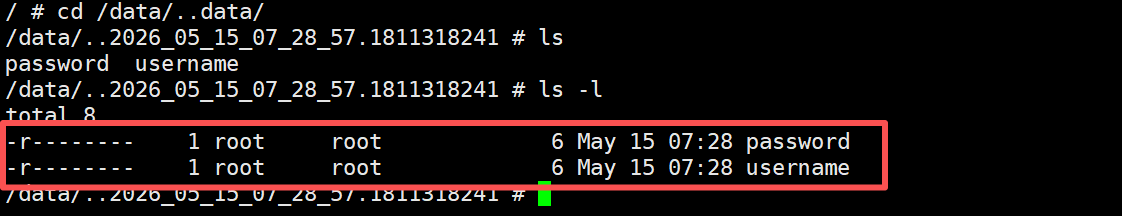
          defaultMode: 256    #十进制数字,转换八进制后,会变成400权限,不加这个字段会默认填充,默认值是420,也就是644权限
可以看到挂载卷权限已被修改
指定某个键进行挂载
apiVersion: apps/v1
kind: Deployment
metadata:
  name: secret-opaque-volume
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stu
  template:
    metadata:
      labels:
        app: stu
    spec:
      containers:
      - name: opaque-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
        imagePullPolicy: IfNotPresent
        command:
        - sh
        - -c
        - sleep 3600
        volumeMounts:
        - name: secret-volume
          mountPath: "/data"
      volumes:
      - name: secret-volume
        secret:
          secretName: secret-opaque
          defaultMode: 256
          items:
          - key: username
            path: 1/username

#itemes.path:这个字段,他是以mountPath字段中写的路径为基础的相对路径,且必须是相对路径。items.path的意思就是/data/1/username,文件名就是键,内容就是值。

#挂载的同时可以更改键名,username可任意修改为符合要求的键名,

#如果想直接挂载到mountPath字段路径下,就在path字段中写键名即可,无需写任务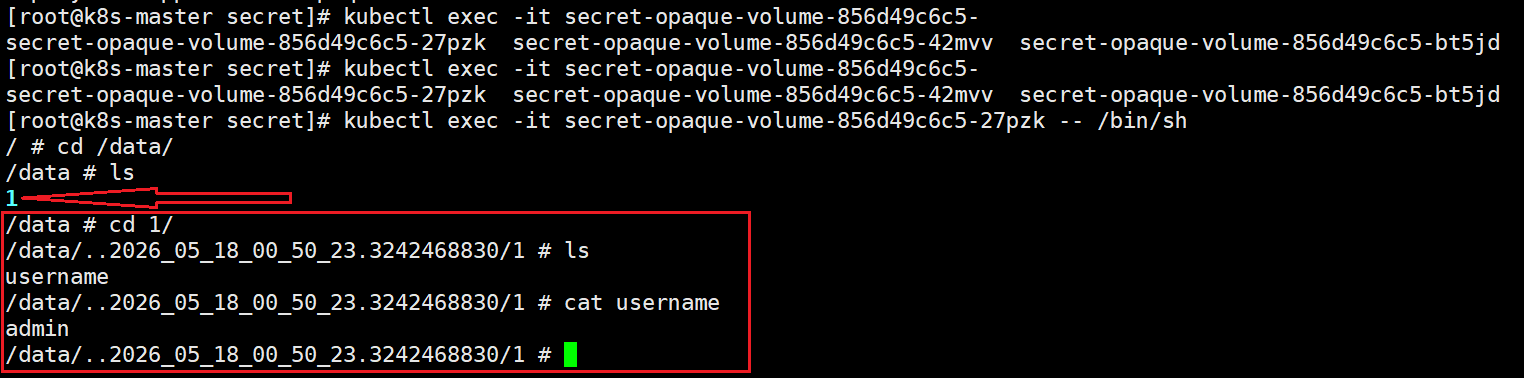
看下挂载的值没有问题。再看下文件类型,它和cm不一样,是一个标准的文件类型而不是一个链接文件,这就意味着它不支持热更新。不信的话可以修改被挂载的secret试一下
作为卷挂载热更新
上面的栗子不支持热更新,这里把热更新实验一下。还是上面的代码
apiVersion: apps/v1
kind: Deployment
metadata:
  name: secret-opaque-volume
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stu
  template:
    metadata:
      labels:
        app: stu
    spec:
      containers:
      - name: opaque-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
        imagePullPolicy: IfNotPresent
        command:
        - sh
        - -c
        - sleep 3600
        volumeMounts:
        - name: secret-volume
          mountPath: "/data"
      volumes:
      - name: secret-volume
        secret:
          secretName: secret-opaque
          defaultMode: 256
          items:
          - key: username
            path: sername    #唯一不同的是这里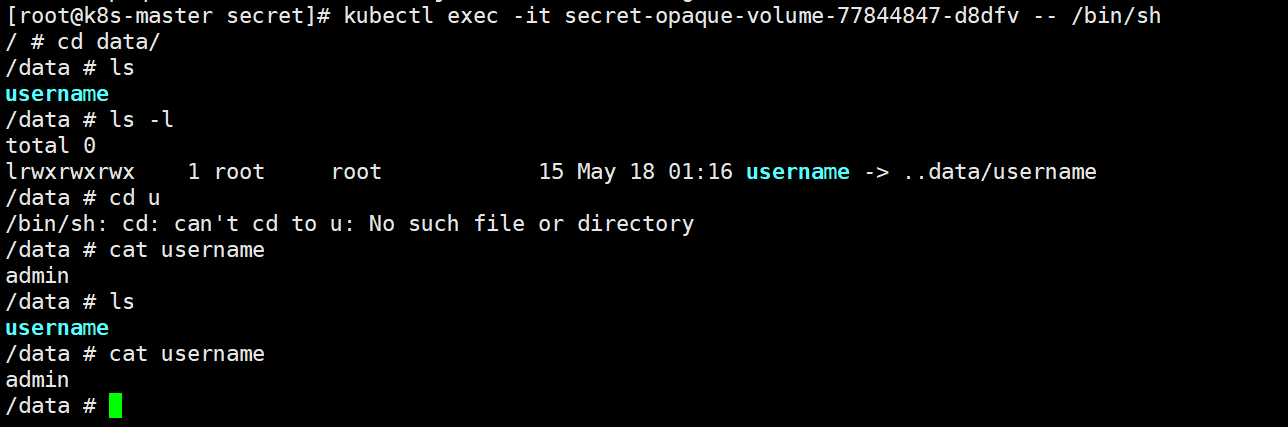
看到区别了么?当挂载路径在根目录的时候,文件会变成链接文件,这时候才支持热更新。
也就是说,如果希望挂载卷后续支持更新就挂载到mountPath字段的路径下,不更新就新建子目录进行挂载
对信息进行更新测试一下,记住sedret中要修改的信息都要先进性编码

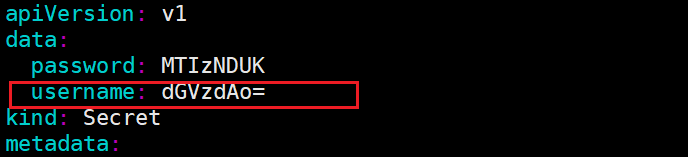
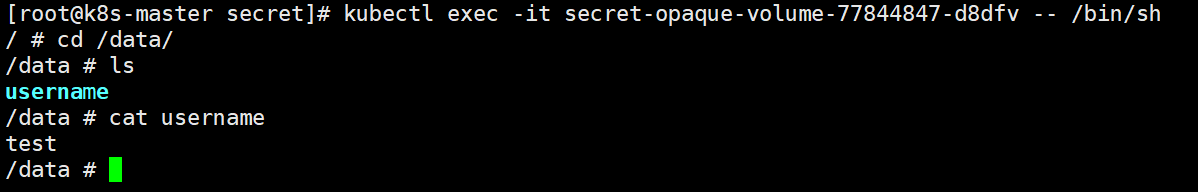
更新成功,更新过程比较久,不到一分钟
作为卷挂载禁止更新
它和cm一样有禁止更新的操作,此操作不可逆
3、Downward API(集群信息存储)
严格来说Downward API并不是存储,它只是借用了挂载文件的形态,让你能在容器里像读文件一样方便地读到自己的元数据,但它不具备存储的任何核心特性(持久化、大容量、可写),但是为了方便理解,就归类为存储
Downward API 是 Kubernetes 提供的一种机制,让 Pod 里的容器在不直接调用 Kubernetes API 的情况下,也能获取到自身的元数据(Metadata)和状态信息。
ps:这个不直接调用kubernetes API意思是,代码中没有向 kubernetes.default.svc 或 API Server 的 Pod IP 发起任何网络请求,数据来源是本地环境变量或文件(这两个东西可以AI一下,有功夫可以深入了解,本章就不多做解释了)
这些信息可作为环境变量注入到容器中或者挂载到容器中,以便容器可以获取有关其运行环境的各种信息,如pod名称、命名空间、标签等。说白了就是将pod的信息暴露给容器使用
downward API中的字段分为Pod和容器资源两个级别,我列个表格出来,方便各位同志查找
| podfieldRef(Pod级别) | 备注 | env | volume |
| metadata.name | pod名称 | √ | √ |
| metadata.namespace | pod的命名空间 | √ | √ |
| metadata.uid | Pod 的唯一 ID | √ | √ |
| metadata.annotations['<KEY>'] | Pod单个注解 <KEY> 的值 | √ | √ |
| metadata.labels['<KEY>'] | Pod单个标签 <KEY> 的值 | √ | √ |
| spec.serviceAccountName | Pod的安全服务账号名称 | √ | × |
| spec.nodeName | Pod运行时所处的节点名称 | √ | × |
| status.hostIP | Pod 所在节点的主 IP 地址 | √ | × |
| status.hostIPs | 当前pod所在节点双栈IP | √ | × |
| status.podIP | Pod 的主 IP 地址(通常为IPv4) | √ | × |
| status.podIPs | 当前pod双栈IP | √ | × |
| metadata.labels | pod所有标签 | × | √ |
| metadata.annotations | pod全部注解 | × | √ |
| resourceFieldRef(容器资源级别) | 备注 | env | volume |
| limits.cpu | 容器的 CPU 限制值 | √ | √ |
| limits.memory | 容器的内存限制值 | √ | √ |
| limits.ephemeral-storage | 容器的临时存储的限制值 | √ | √ |
| requests.cpu | 容器的 CPU 请求值 | √ | √ |
| requests.memory | 容器的内存请求值 | √ | √ |
| requests.ephemeral-storage | 容器的临时存储的请求值 | √ | √ |
| limits.hugepages-* | 容器的巨页限制值 | 官网扒的,后续补充 | |
| resource: requests.hugepages-* | 容器的巨页请求值 | 官网扒的,后续补充 | |
如果没有为容器指定 CPU 和内存限制时尝试使用 Downward API 暴露该信息,那么 kubelet 默认会根据 节点可分配资源 计算并暴露 CPU 和内存的最大可分配值
作为环境变量注入
apiVersion: v1
kind: Pod
metadata:
  name: downwards
  labels:
    app: stu
  annotations:
    version: "v1"
spec:
  containers:
  - name: downwards-container
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - env
    env:
    - name: POD_NAME
      valueFrom:
        fieldRef:
          fieldPath: metadata.name
    - name: POD_NAMESPACE
      valueFrom:
        fieldRef:
          fieldPath: metadata.namespace
    - name: POD_UID
      valueFrom:
        fieldRef:
          fieldPath: metadata.uid
    - name: POD_LABELS
      valueFrom:
        fieldRef:
          fieldPath: metadata.labels['app']    #单个标签的意思就是只能选择一个标签键
    - name: POD_ANNOTATIONS
      valueFrom:
        fieldRef:
          fieldPath: metadata.annotations['version']    #同上
    - name: POD_SERVICEACCOUNTNAME
      valueFrom:
        fieldRef:
          fieldPath: spec.serviceAccountName
    - name: POD_PODIP
      valueFrom:
        fieldRef:
          fieldPath: status.podIP
    - name: POD_HOSTIP
      valueFrom:
        fieldRef:
          fieldPath: status.hostIP
    - name: POD_NODENAME
      valueFrom:
        fieldRef:
          fieldPath: spec.nodeName
    - name: LIMITS__CPU
      valueFrom:
        resourceFieldRef:
          resource: limits.cpu
    - name: LIMITS_MEMORY
      valueFrom:
        resourceFieldRef:
          resource: limits.memory
    - name: LIMITS_STORAGE
      valueFrom:
        resourceFieldRef:
          resource: limits.ephemeral-storage
    - name: REQUEST_CPU
      valueFrom:
        resourceFieldRef:
          resource: requests.cpu
    - name: REQUEST_MEMORY
      valueFrom:
        resourceFieldRef:
          resource: requests.memory
    - name: REQUEST_STORAGE
      valueFrom:
        resourceFieldRef:
          resource: requests.ephemeral-storage
  restartPolicy: Never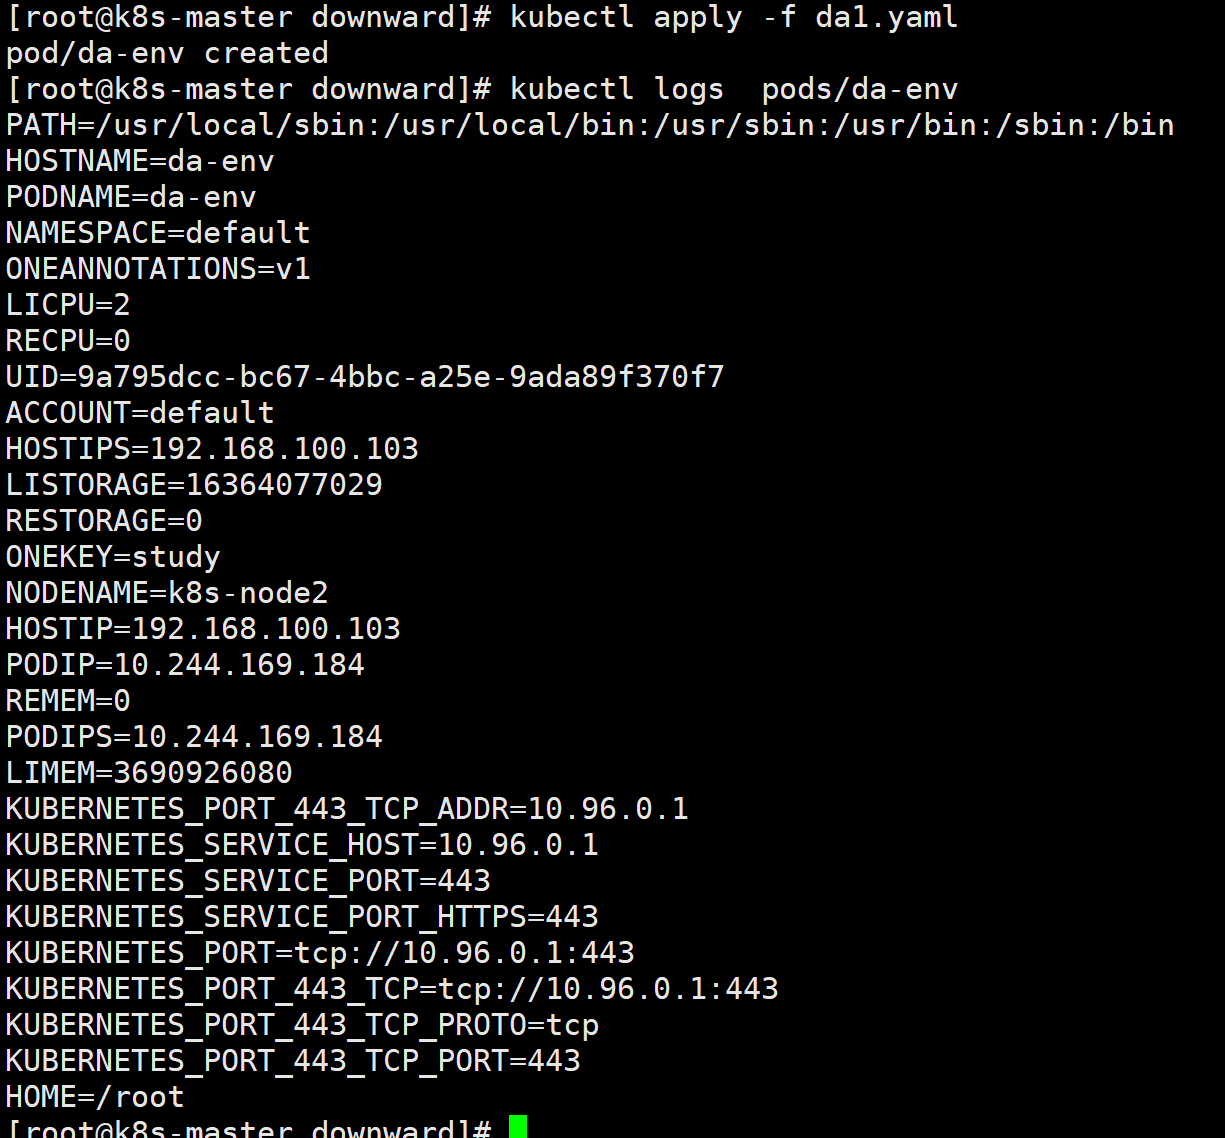
图中可以看到将pod的信息都暴露给了容器运行,只关注命名空间,podIP和pod名称就行,剩下的后面才会学到
作为卷挂载使用
apiVersion: v1
kind: Pod
metadata:
  name: da-volume
  labels:
    good: study
    day: up
  annotations:
    one: "v1"
    two: "v2"
spec:
  containers:
  - name: da-volume-container
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command: ["sleep","3600"]
    volumeMounts:
    - name: da-volume
      mountPath: /etc/podinfo
  volumes:
  - name: da-volume
    downwardAPI:
      items:
      - path: podname
        fieldRef:
          fieldPath: metadata.name
      - path: namespace
        fieldRef:
          fieldPath: metadata.namespace
      - path: uid
        fieldRef:
          fieldPath: metadata.uid
      - path: oneannotations
        fieldRef:
          fieldPath: metadata.annotations['one']
      - path: onelabels
        fieldRef:
          fieldPath: metadata.labels['good']
      - path: allannotations
        fieldRef:
          fieldPath: metadata.annotations
      - path: alllabels
        fieldRef:
          fieldPath: metadata.labels
      - path: licpu
        resourceFieldRef:
          containerName: da-volume-container
          resource: limits.cpu
      - path: limem
        resourceFieldRef:
          containerName: da-volume-container
          resource: limits.memory
      - path: listorage
        resourceFieldRef:
          containerName: da-volume-container
          resource: limits.ephemeral-storage
      - path: recpu
        resourceFieldRef:
          containerName: da-volume-container
          resource: requests.cpu
      - path: remem
        resourceFieldRef:
          containerName: da-volume-container
          resource: requests.memory
      - path: restorage
        resourceFieldRef:
          containerName: da-volume-container
          resource: requests.ephemeral-storage
  restartPolicy: Never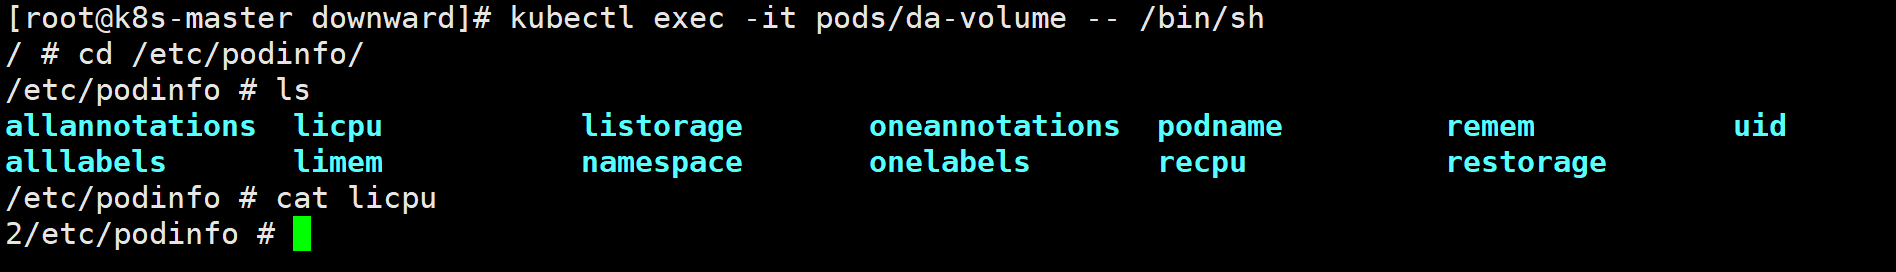
可以看到相关信息都以卷的形式挂载到了/etc/podinfo下面变成了文件。
DownwardAPI 扩展
上面的实验案例是将pod和容器的元数据传递给了他们内部运行的进程。但是这种方式仅仅只暴露自身pod的元数据给容器,且只有部分元数据可以暴露,也无法做到跨pod引用数据
所以基于官方的apiserver接口就登场了,直接从接口拿数据,而不是通过官方提供的机制取数据
这个实验暂时不要理解,照做就行,后面学到安全再回来看,一切都会理解的,这里先做出来是为了让同志们知道还有别的方法获取pod信息
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: test-api
subjects:
  - kind: ServiceAccount
    name: test-api
    namespace: default
roleRef:
  kind: ClusterRole
  name: cluster-admin
  apiGroup: rbac.authorization.k8s.io
kubectl create sa test-apiapiVersion: v1
kind: Pod
metadata:
name: curl
spec:
serviceAccountName: test-api
containers:
- name: curl-container
image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/yauritux/busybox-curl:latest
imagePullPolicy: IfNotPresent
command: ["sleep","3600"]
#镜像我换了新的busybox,因为带curl命令kubectl exec -it <podName> -- /bin/sh
进入容器执行下方三条命令
TOKEN=$(cat /var/run/secrets/kubernetes.io/serviceaccount/token)
CAPATH="/var/run/secrets/kubernetes.io/serviceaccount/ca.crt"
NS=$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace)
准备工作做完后执行此命令,就可以从接口中访问当前命名空间所有pod的任何信息
curl -H "Authorization: Bearer $TOKEN" --cacert $CAPATH https://kubernetes/api/v1/namespaces/$NS/pods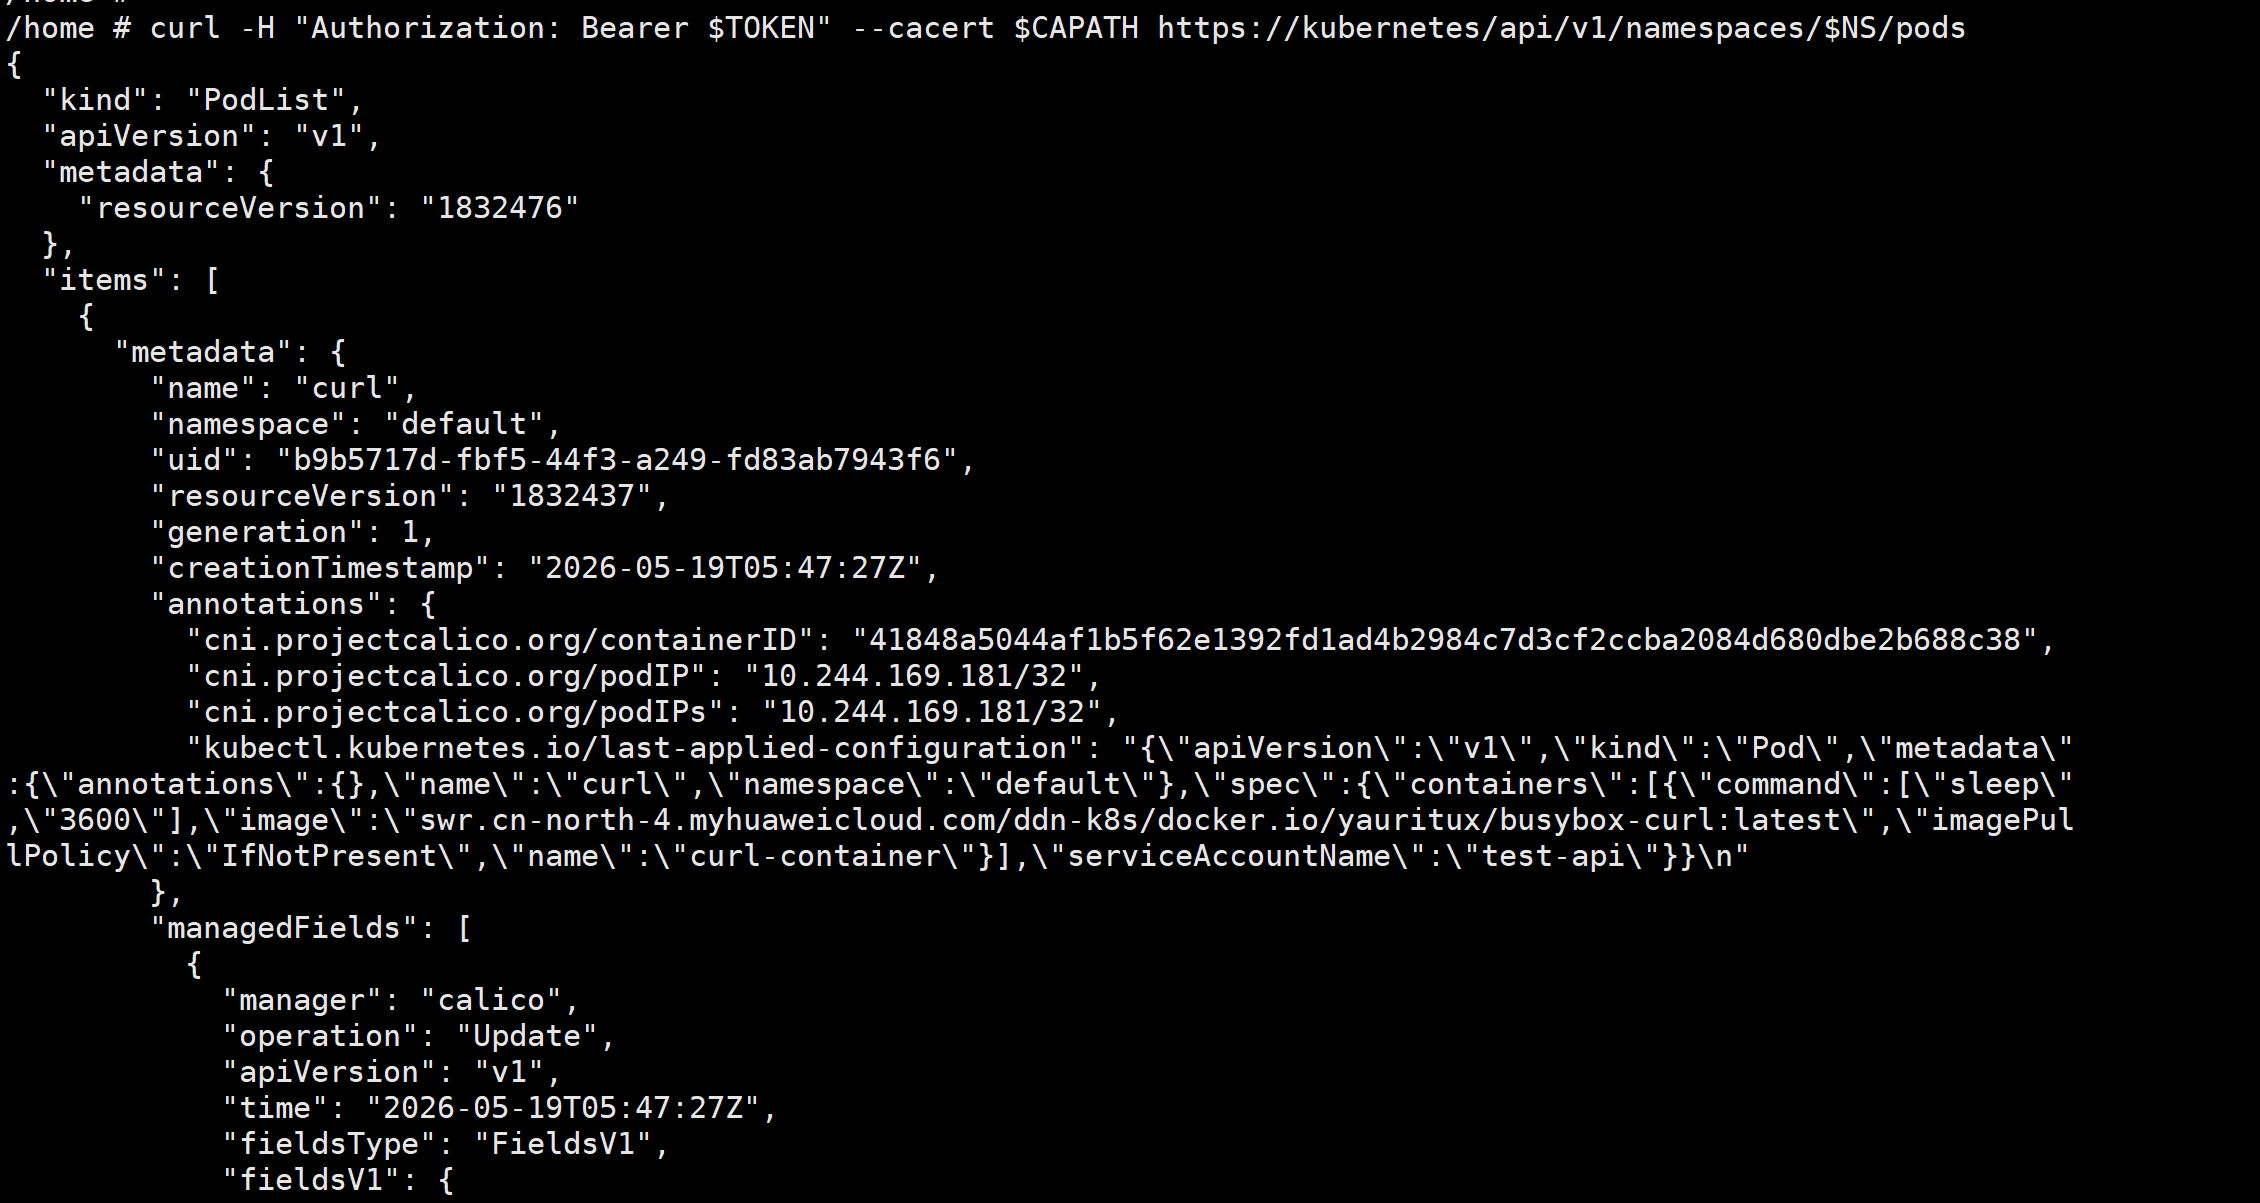
4、volume(数据持久化)
容器磁盘上的文件声明周期是短暂的,这就使得在容器中运行重要应用时会出现一些问题。首先当容器崩溃时,kublet会重启它,但是容器中的文件将丢失,且会以容器镜像最初的状态重新启动容器。其次在pod中同时运行多个容器时,这些容器之间通常需要共享文件,k8s中的volume就很好的解决了这些问题
kubernetes官方提供了很多类型的卷,并且很多卷类型在新版本中已经被弃用或者移除了。这里只演示几种常用的卷
emptyDir
对于定义了 emptyDir 卷的 Pod,在 Pod 被指派到某节点时此卷会被创建。 就像其名称所表示的那样,emptyDir 卷最初是空的。尽管 Pod 中的容器挂载 emptyDir 卷的路径可能相同也可能不同,但这些容器都可以读写 emptyDir 卷中相同的文件。 当 Pod 因为某些原因被从节点上删除时,emptyDir 卷中的数据也会被永久删除。
apiVersion: v1
kind: Pod
metadata:
  name: volume
spec:
  containers:
  - name: nginx
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/nginx:1.27.0
    imagePullPolicy: IfNotPresent
    volumeMounts:
    - name: logs-volume
      mountPath: /var/log/nginx
  - name: busybox
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - tail
    - -f
    - /logs/access.log
    volumeMounts:
    - name: logs-volume
      mountPath: /logs
  volumes:
  - name: logs-volume
    emptyDir: {}
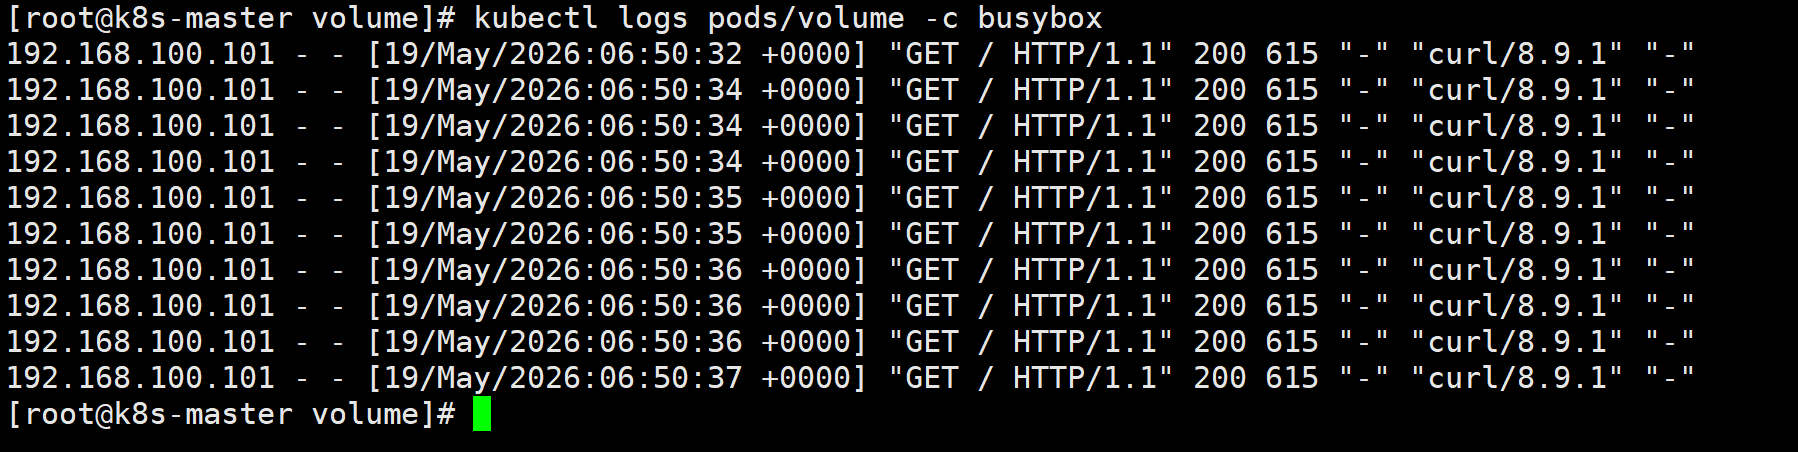
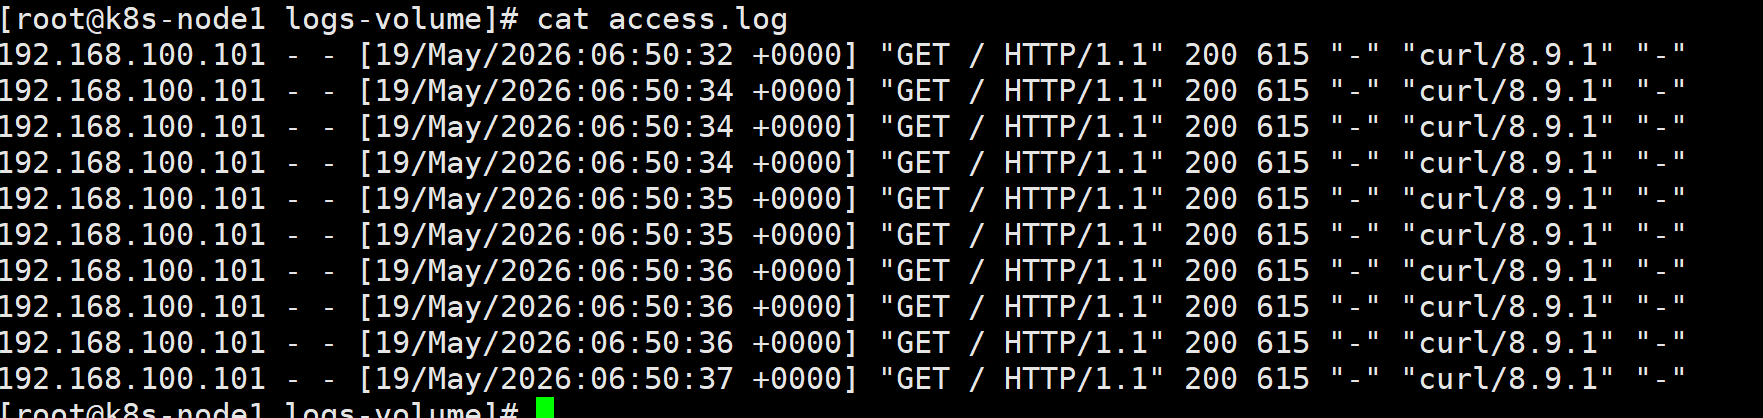
curl对podIP进行访问,然后查看busybox日志就出现了nginx的访问成功的记录,access.log这个文件busybox肯定是没有的,这是nginx记录访问成功的日志文件,这就证明了两个容器时共享一个挂载卷的
kubelet的工作目录(root-dir参数控制)默认为/var/lib/kubelet,会为每个使用了emptyDir:{}的pod创建一个目录,这个目录处于pod所在节点,格式为
/var/lib/kubelet/pods/{podid}/volumes/kubernetes.io~empty-dir/
所有放在emptyDir的数据,最终都是落在了上述路径中,可以看下文件内容或在文件中添加一些字符,再去pod查看日志确定准确性

#用内存作为emptyDir卷,特定场景使用手段,不做演示,代码放在这里了解即可
apiVersion: v1
kind: Pod
metadata:
  name: test-pd
spec:
  containers:
  - image: registry.k8s.io/test-webserver
    name: test-container
    volumeMounts:
    - mountPath: /cache
      name: cache-volume
  volumes:
  - name: cache-volume
    emptyDir:
      sizeLimit: 500Mi
      medium: Memory

ps:谁会用内存当持久卷用?知不知道内存多贵?
hostPath(常用)
hostPath卷将主机节点文件系统中的文件或目录挂载在集群中,hostPath用途如下
- 运行一个需要访问节点级系统组件的容器 (例如一个将系统日志传输到集中位置的容器,使用只读挂载
/var/log来访问这些日志) - 让存储在主机系统上的配置文件可以被静态pod以只读方式访问;与普通 Pod 不同,静态 Pod 无法访问 ConfigMap。
除了必须的path字段,用户还可以为hostPath卷指定type,因为类型太多不一一举例,就选个常用的类型来进行实验
| 空字符串(默认)用于向后兼容,这意味着在安装 hostPath 卷之前不会执行任何检查。 |
DirectoryOrCreate | 如果在给定路径上什么都不存在,那么将根据需要创建空目录,权限设置为 0755,具有与 kubelet 相同的组和属主信息。 |
Directory | 在给定路径上必须存在的目录。 |
FileOrCreate | 如果在给定路径上什么都不存在,那么将在那里根据需要创建空文件,权限设置为 0644,具有与 kubelet 相同的组和所有权。 |
File | 在给定路径上必须存在的文件。 |
Socket | 在给定路径上必须存在的 UNIX 套接字。 |
CharDevice | (仅 Linux 节点) 在给定路径上必须存在的字符设备。 |
BlockDevice | (仅 Linux 节点) 在给定路径上必须存在的块设备。 |
使用hostPath有几点需要注意
- 由于每个节点上的环境都不同,具有相同配置的pod在不同节点上的行为可能会有所不同,(例如用Template创建的pod和单独写的pod就会不同)
- 当k8s按照计划添加资源感知调度时,将无法考虑hostPath使用的资源
- 当k8s使用
hostPath挂载主机上的目录时,容器能否写入取决于宿主机上那个目录原本的权限。如果它在宿主机上只有 root 能写,那么容器里也必须以 root 运行(并且是特权模式),或者你必须事先在主机上放宽权限,否则容器会写失败
apiVersion: v1
kind: Pod
metadata:
  name: hostpath
spec:
  containers:
  - name: hostpath-container
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command: ["sleep","3600"]
    volumeMounts:
    - name: hostpath-volume
      mountPath: /tmp/testpod
  volumes:
  - name: hostpath-volume
    hostPath:
      type: Directory
      path: /data    #这个/data是最后pod分配节点的/data,不是master的/data
        type: Directory
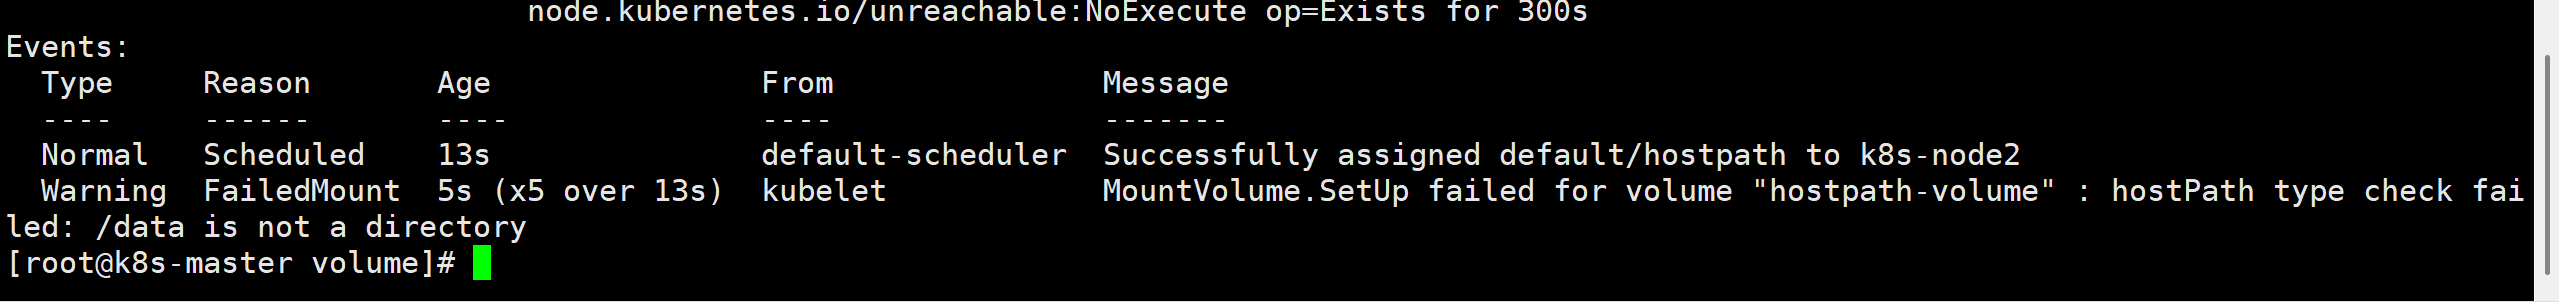
启动对象发现过了很久还没有创建好,kubectl describe查一下。看到报错说/data不是一个目录,为什么?因为directory类型要求挂载的目录必须存在,而我没有创建
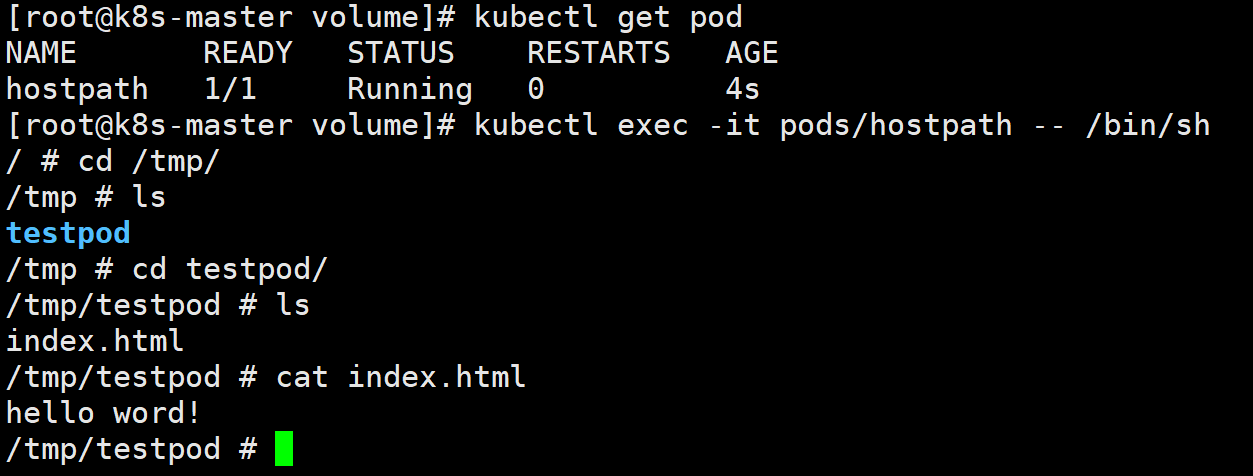
在所有节点都创建一个/data目录,因为不知道pod会调度到哪个节点,并在里面加个文件,删除pod再次创建
可以看到成功了,或者用DirectoryOrCreate类型都可以,前提是没有这么个目录
5、PV/PVC
- PV(Persistent Volume):持久化卷,是集群中的一块存储,可以由管理员事先供应,或者使用存储类(Storage Class)来动态供应。它是一种抽象的存储资源,独立于使用它的 Pod。例如,它可以是一块网络存储(如 NFS、Ceph 等)或者云存储(如 AWS EBS、Azure Disk 等)在 Kubernetes 集群中的抽象表示。
- PVC(Persistent Volume Claim):持久化卷声明,是用户对于存储的请求。它类似于用户向存储系统 “申请” 一定量的存储资源,比如指定存储的大小、访问模式(如只读、读写)等要求。
关系阐述
- PVC 是对 PV 的请求:用户通过创建 PVC 来请求存储资源,PVC 定义了所需要的存储资源的规格和特性。例如,一个 PVC 可能会声明需要 10G大小的存储,并且是读写模式(ReadWriteOnce)。Kubernetes 会根据这个请求在已有的 PV 中查找或者动态创建符合要求的 PV 来绑定这个 PVC。
- PV 和 PVC 的绑定关系:当 PVC 的请求与 PV 的属性相匹配时(如存储大小、访问模式等条件满足),它们就会绑定在一起。这种绑定是一对一的关系,一个 PVC 只能绑定一个 PV,一个 PV 也只能被一个 PVC 绑定。绑定之后,Pod 就可以通过 PVC 来使用对应的 PV 所提供的存储资源。例如,一个运行数据库的 Pod 可以通过挂载一个绑定了合适 PV 的 PVC 来将数据持久化存储到对应的存储介质中。
- 生命周期的关联:PVC 的生命周期通常会受到与其绑定的 PV 的影响。如果 PV 被删除或者不可用,与之绑定的 PVC 的状态也会受到影响。例如,如果 PV 对应的存储设备出现故障,PVC 所代表的存储请求就无法正常满足,可能会导致使用该 PVC 的 Pod 出现存储相关的问题。同时,当 PVC 被删除时,与之绑定的 PV 可能会根据其回收策略(如保留、删除、回收)来进行相应的处理
所以这个逻辑是 PV 持久卷的背后是实体存储,PVC 和 Pod 是进行绑定的,而 PVC 和 PV 进行了匹配,所以等于 Pod 使用了背后的存储,如下图
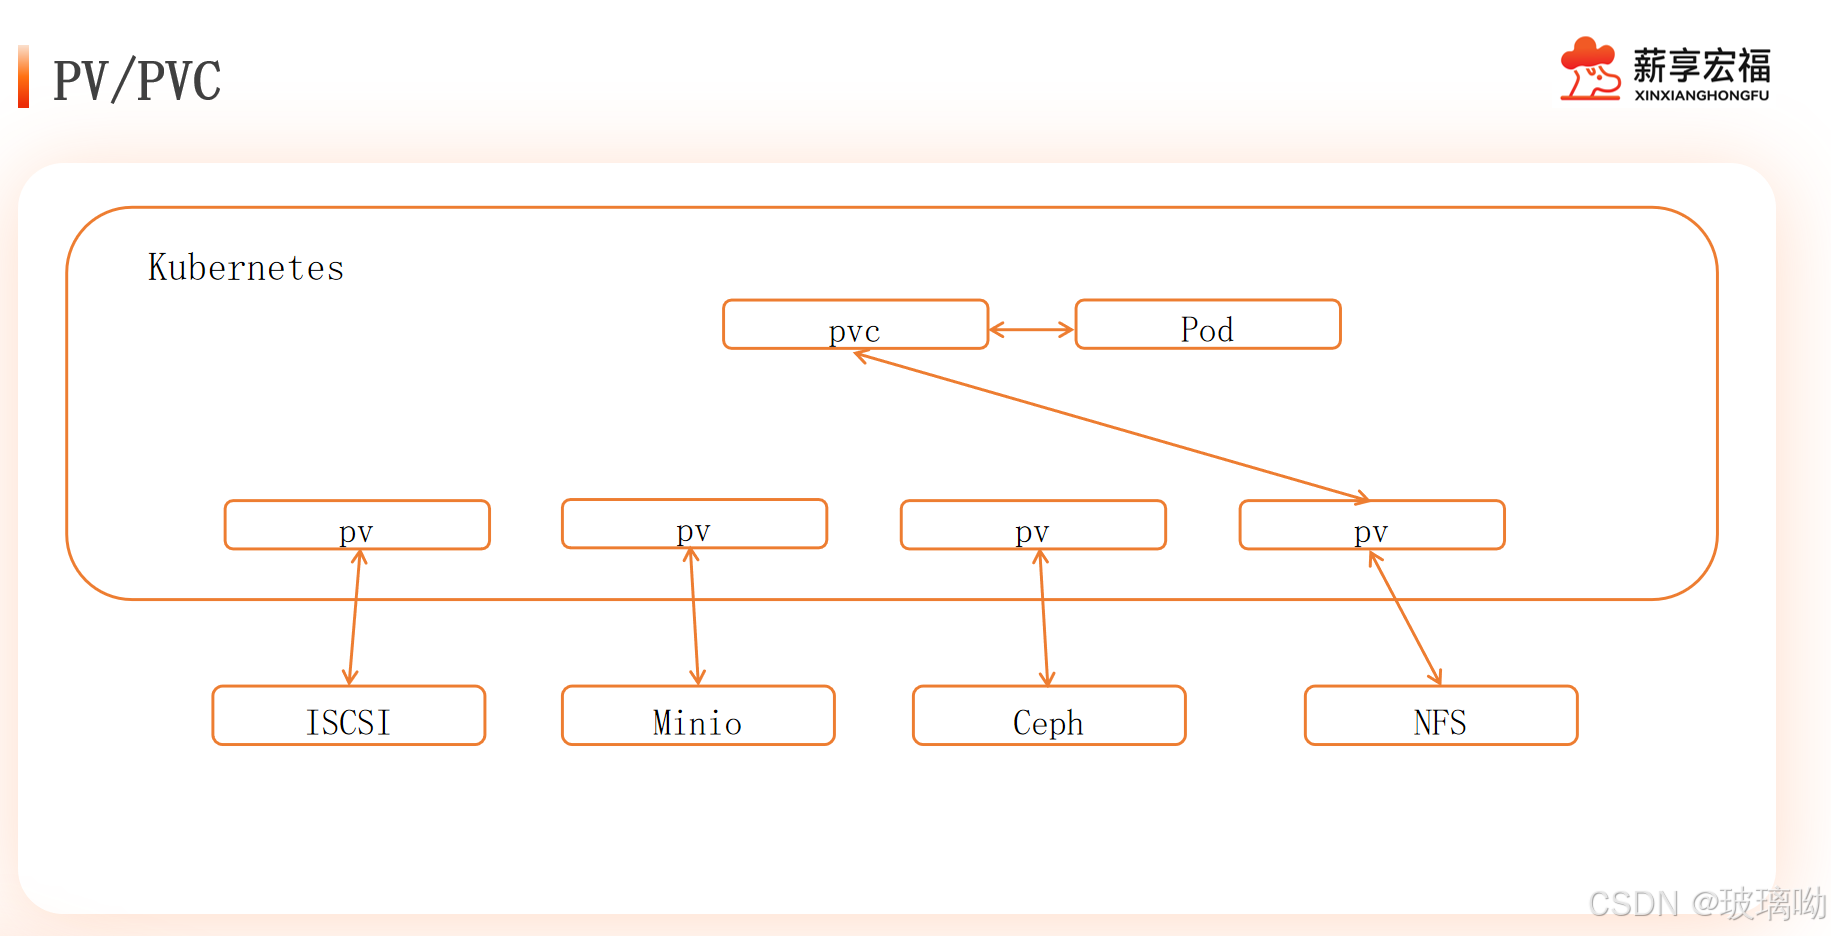
关联条件
- 容量:PV的值不小于PVC要求,可以大于最好一致
- 读写策略:完全匹配
- 单节点读写--ReadWriteOnce--RWO
- 多节点只读--ReadOnlyMany--ROX
- 多节点读写--ReadWriteMany--RWX
- 存储类:PV的类与PVC的类必须一致,不存在包容降级关系(包容降级这个指的是公司中自定义的存储等级。比如公司有3个等级的存储,pvc写了匹配1级的,就不会降级匹配)
存储类型不一定都支持三种读写策略,比如iscsi不支持RWX
PV回收策略
假设现在需要杀死一个pod,pvc就成为了孤立的存在,pvc不死pv不会被释放。这种情况下数据不想保留,就可以将pvc杀死。pvc死掉之后相应的pv没有人去关联它了,这时需要pv自行处理。分为三种情况
- Retain(保留): 手动回收。就是pv处于未就绪状态,现在一个pvc要来进行关联(符合条件情况下),pv不允许绑定,因为pv内部很可能存在高价值的数据,允许绑定会将高价值数据覆盖掉。这时要由运维人员将数据备份,在手动恢复它为可用状态
- Recycle(回收):简单擦除。当pod和pvc被杀死且pv没有被关联,它会拉取一个特定镜像来创建pod。这个pod的作用就是执行
rm -rf /thevolume/*删除上一个留下的数据,这个不推荐用,一方面是拉镜像是国外的镜像源,这个镜像源还不能在pvc清单中配置,比较费劲。另方面是此功能官方在1.14版本就准备废弃掉了,转而推荐动态供应storagteClass - Delete(删除): 删除存储卷。pod和pvc被杀起且pv没有被关联,就会把自己清理掉,这个pv就不存在了
当前只有 nfs 和 hostPath 卷类型支持回收(Recycle),但是nfs不支持delete策略
PV状态
- Avaliable(可用):空闲资源还没有被任何声明(PVC)所绑定
- Bound(已绑定):卷已经被PVC绑定
- Relaeased(已释放):PVC被删除,但是资源还未被集群重新声明
- Failed(失败):该卷的自动回收失败
命令行会显示绑定到PV的PVC的名称
PV/PVC的创建
理论结束,开始实践。此次实验用nfs当作pv,因为NFS的优点是配置简单、成本低,支持多Pod读写共享(比如用于存放配置文件或日志),在自建机房或本地开发测试环境:NFS(网络文件系统)和Local PV(本地存储)最为常见,适合对性能要求不高的场景,
首先要部署一个nfs服务器来作为pv使用,可以新开一个虚拟机或者在master节点安装
#搭建nfs服务器,每个节点都安装
yum -y install nfs-utils rpcbind
systemctl start rpcbind
systemctl start nfs-server.service

#因为服务名称错误导致启动nfs报错的同志,用systemctl list-unit-files |grep -i nfs过滤

回到master节点,我选了此节点作为nfs服务器

mkdir /nfsdata
useradd nfsnobody
chmod 666 /nfsdata
chown nfsnobody /nfsdata
cd /nfsdata

#为了更好呈现pvc效果,多建几个目录进行pv制作,并且每个目录下都有内容
for i in {1..10} ;do mkdir $i ;echo $i > $i/index.html ;done

vim /etc/exports
/nfsdata/1 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/2 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/3 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/4 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/5 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/6 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/7 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/8 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/9 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/10 *(rw,no_root_squash,no_all_squash,sync)

exportfs -r

showmount -e <hostIP>    #查看共享

#可以在集群中其他节点测试挂载nfs目录
mount -t nfs <nfsServerIP:/path> <localPath>

#这样就模拟了十个nfs的共享存储,并且将十个目录以读写权限共享给所有客户端,保留客户端 root 权限(无映射限制),并确保数据同步写入磁盘
将nfs抽象为PV
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv1
spec:
  capacity:
    storage: 0.9Gi
  accessModes:
  - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/1
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv2
spec:
  capacity:
    storage: 500Mi
  accessModes:
  - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/2
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv3
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/3
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv4
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy:  Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/4
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv5
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/5
    server: 192.168.100.101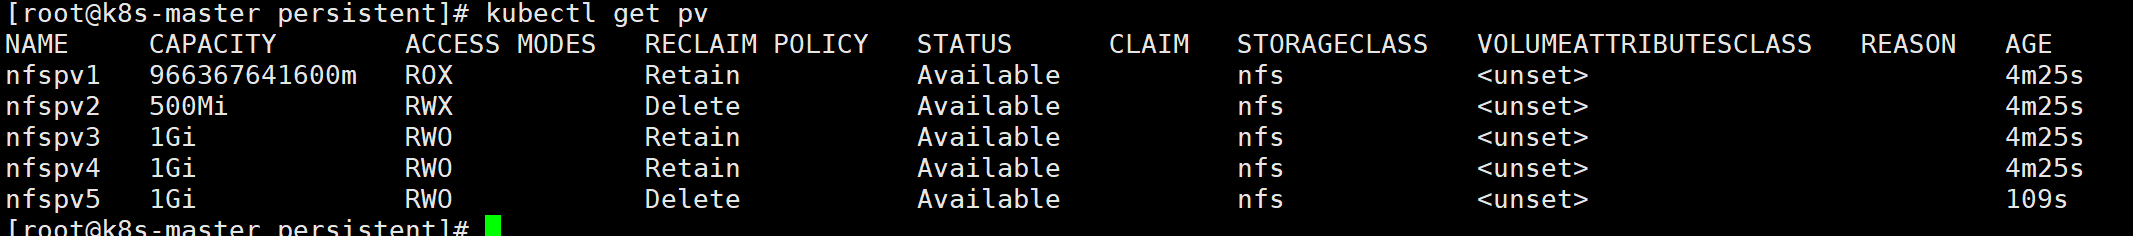
创建无头服务,给等下的控制器使用
apiVersion: v1
kind: Service
metadata:
  name: nginx
spec:
  clusterIP: None # 配置为无头服务(Headless Service),允许直接访问 Pod
  ports:
    - name: web
      port: 80
  selector:
    app: nginx
创建PVC,设置PV筛选条件来选择PV使用
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  serviceName: nginx # 关联的 Service 名称,且service必须是 Headless Service
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
        - name: nginx-container
          image: nginx:one
          imagePullPolicy: IfNotPresent
          volumeMounts:
            - name: www
              mountPath: /usr/share/nginx/html
  volumeClaimTemplates: # 定义持久化卷模板
    - metadata:
        name: www # PVC 名称,需与 volumeMounts 一致
      spec:
        accessModes:
          - ReadWriteOnce
        storageClassName: nfs
        resources:
          requests:
            storage: 1Gi

#一般pvc是配合sfs使用,pod分配的pv也是一致,假设想pod分别用不同规格的pv可以用另种方式。先写pvc,但是pvc名称一定要和sfs产生的pod名称完全一致,pod会自动按序号挂载同名pvc,所以还是可以工作的。但这样失去了动态创建的便利性

apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: www-pod-0
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: nfs
  resources:
    requests:
      storage: 1Gi  # pod-0 用 1G
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: www-pod-1
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: nfs
  resources:
    requests:
      storage: 2Gi  # pod-1 用 2G
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: www-pod-2
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: nfs
  resources:
    requests:
      storage: 3Gi  # pod-2 用 3G
---
# 2. StatefulSet 中不使用 volumeClaimTemplates,改用 volumes 手动指定
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: nginx-statefulset
spec:
  serviceName: nginx-svc
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx-container
        image: nginx:latest
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates: []   #volumeClaimTemplates留空
代码中要求控制器创建三个Pod,三个Pod都需要挂载存储卷,所以它会根据清单创建三个PVC,按照PVC声明自动匹配满足条件的PV,这就是整个清单的逻辑了。
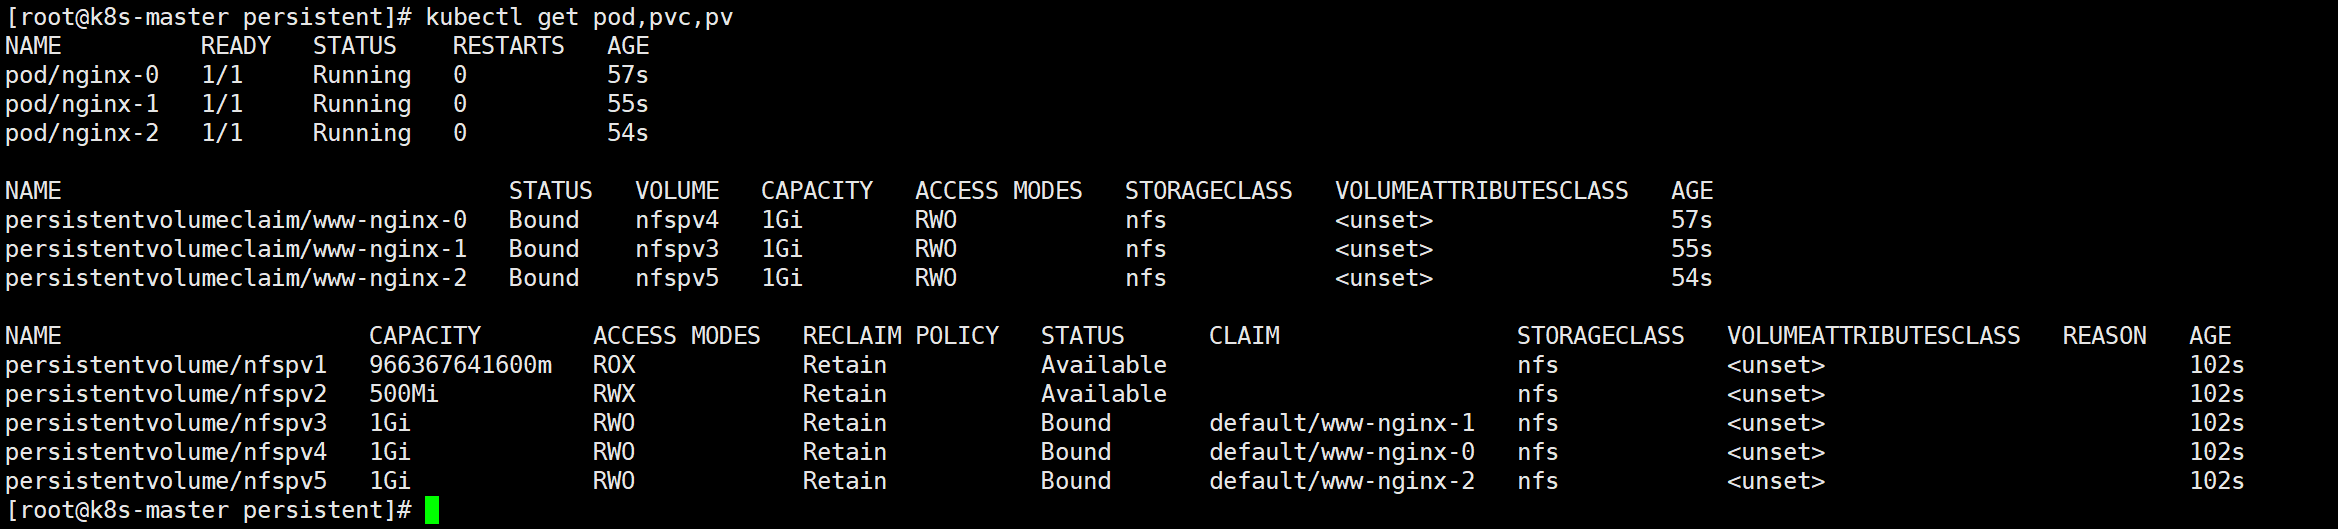
从上图的的查询信息可以非常清晰的看到Pod、PVC和PV的状态及绑定情况。
稍微提一句,pod和PV的绑定并不是pod1绑定PV1这种按顺序来的这里涉及到了预选和优选算法
- 预算算法:必须满足我的最低要求,有多个预选的情况下在预选的基础上优选
- 优选算法:就是打分,海选之后晋级。如果预选全部一样,那就随机选择
PV的回收
实验结束后删除控制器,可以看到控制器和pod已经被删除了,但是pvc和pv还是有绑定关系的。因为它害怕当前pod的持久化文件被自动抹除,所以PVC不会进行自动删除。
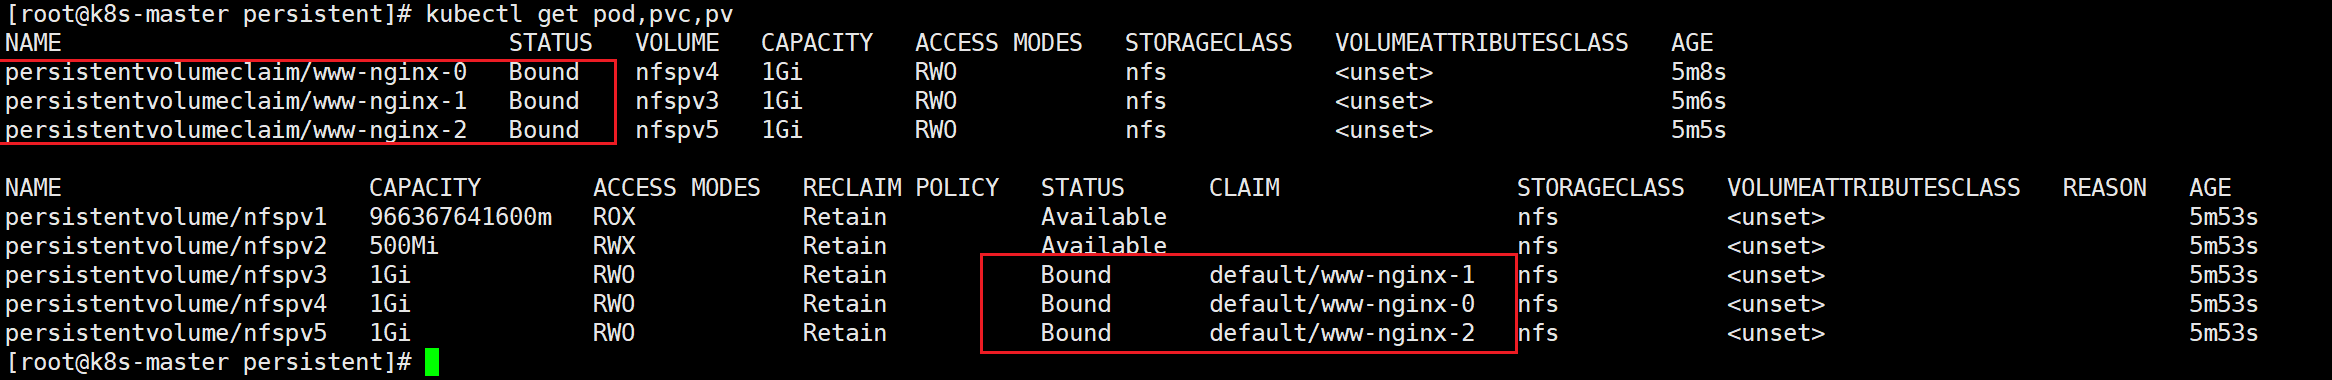
看上图,前面提过pod死亡后pvc成为了孤立状态,并且和pv是绑定的。所以pvc是需要手动进行删除来释放PV的
如果不对PV进行释放,根据同一个清单重新创建pod会发生什么呢?试一下

看上图,再次创建pod时,然后访问web-0还是之前的页面,这说明pod又自动挂载了pvc。因为控制器名字没变,其次pv模板的名字没变,所以pvc会复用之前的配置
所以工作中如果不确定数据后期会不会再次使用的话,只删除StatefulSet控制器即可,保留pvc
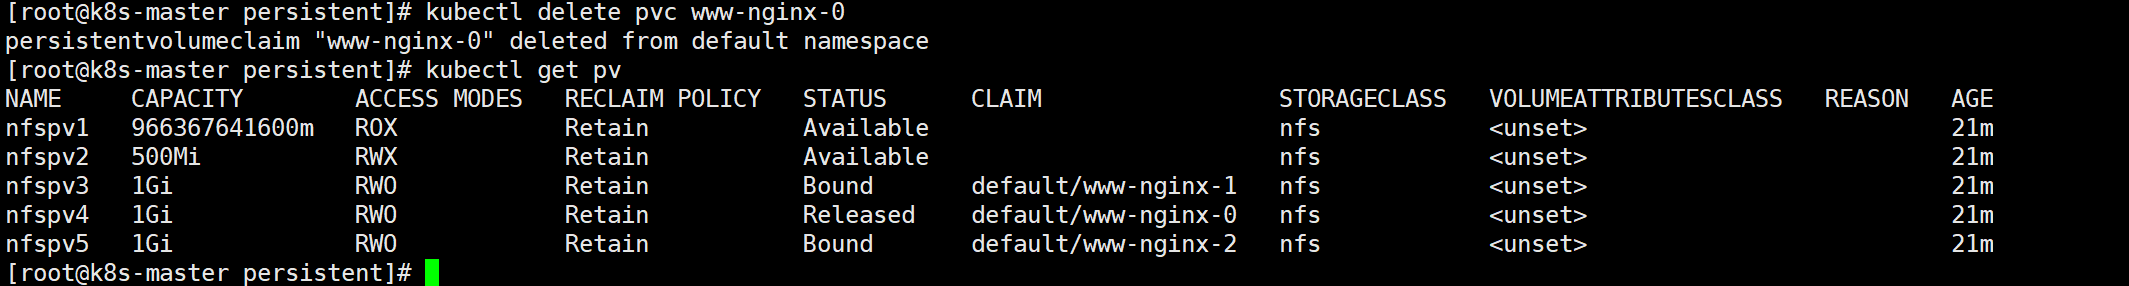
上图,对nginx-0的这个pvc进行了删除,理论上绑定pv的声明都被删除了,那么pv应该被释放对吗?
但是nginx-0的pv删除后pv虽然处于一个Relaeased已释放的这么一个状态,但是数据仍然保留,pv尚未被重新分配或清理。如果想清理数据就需要手动删除nfs共享目录的数据,想真正释放pv让它被使用需要修改pv的这么一个地方
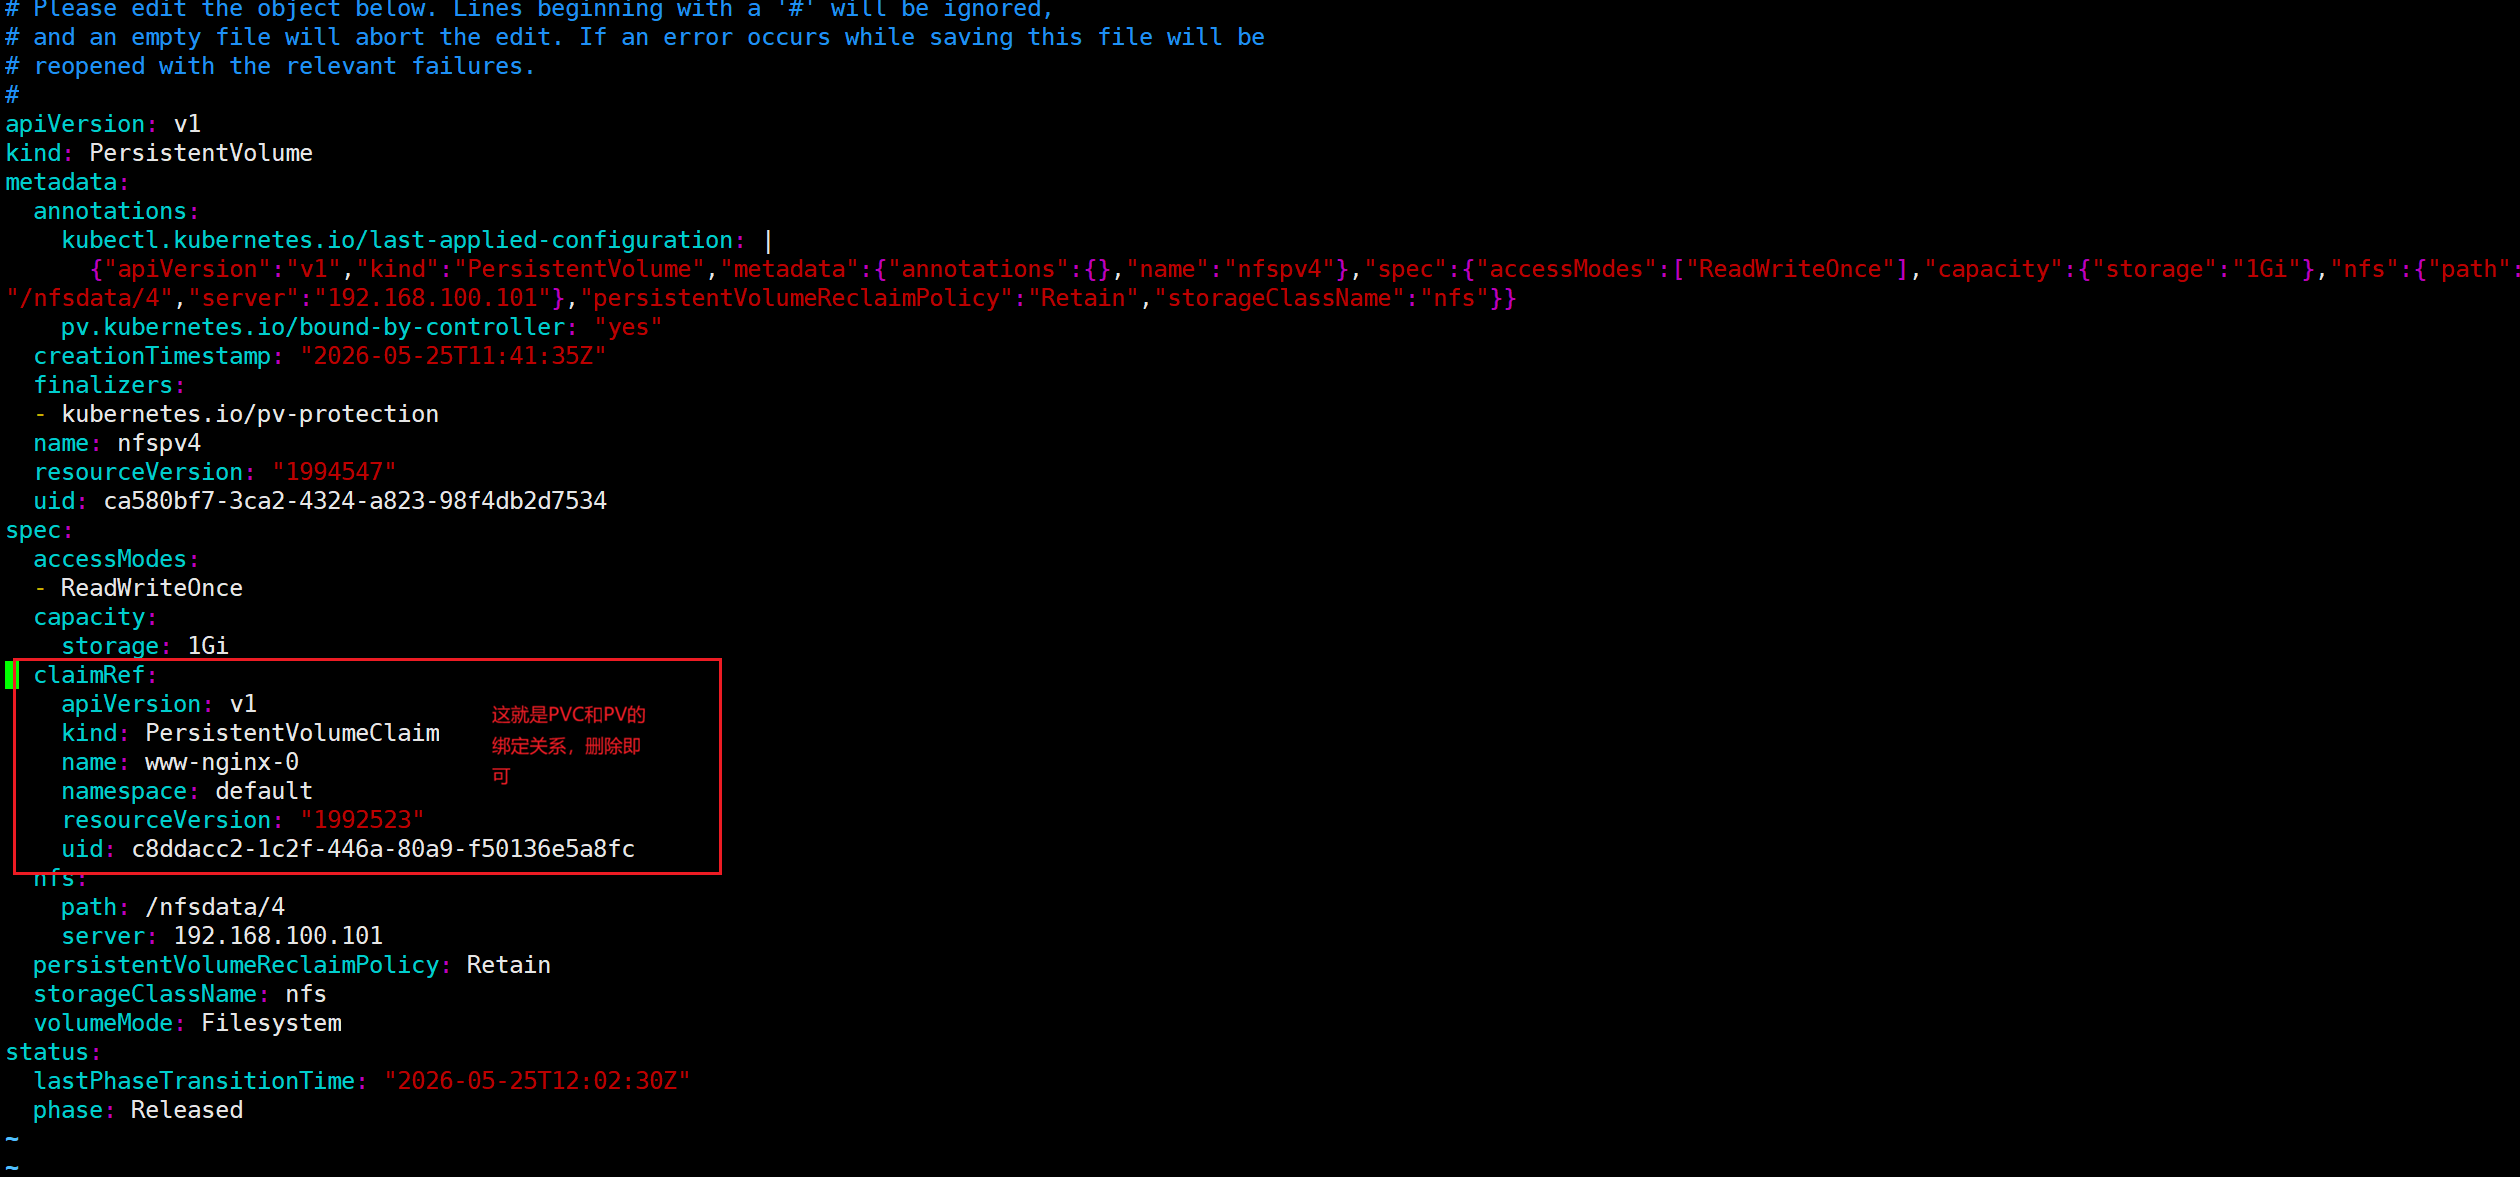
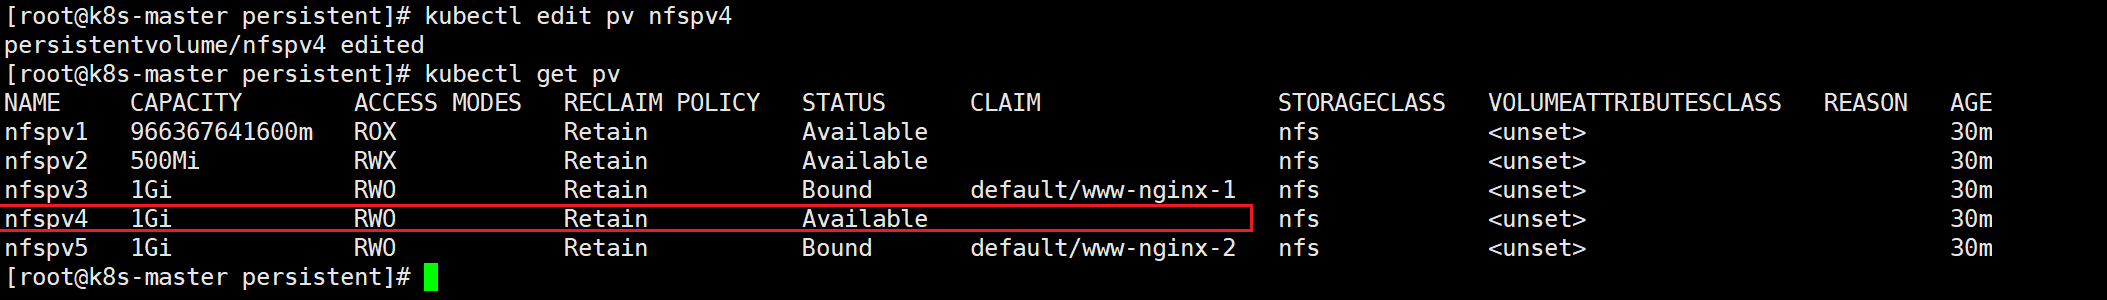
再来看pv就处于可用了的状态了
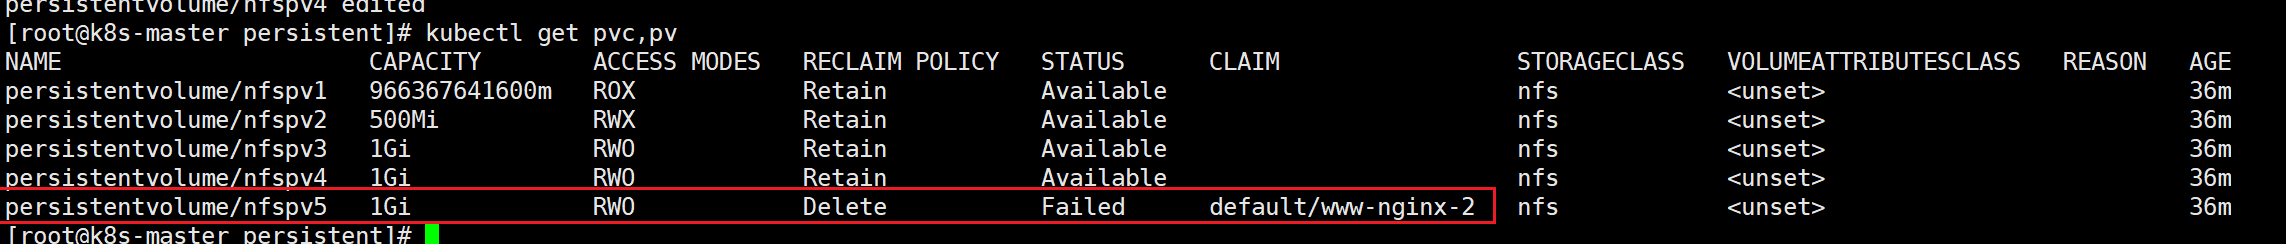
再删除nginx-2,PV状态是回收失败。因为前面提到过nfs不支持delete策略,也可以用这种方式进行pv的回收
storageClass(存储类)
它实现动态申请存储的机制,这种方式已经趋近于主流方式
StorageClass是一种资源对象,用于定义持久卷(PersistentVolume)的动态供给(DynamicProvisioning)策略。StorageClass允许管理员定义不同类型的存储,并指定如何动态创建持久卷以供应用程序使用。这使得k8s集群中的存储管理更加灵活和自动化.
- 静态PV:静态 PV 是由集群管理员提前创建的,通常用于某些需要明确控制存储资源的场景。需要管理员手动创建 PV 资源,并指定存储细节(如存储大小、存储类型、访问模式等。虽然满足要求,但并不是最好的。假设申请1.98T的PV。存储部门不可能这样划分的,它会给你2T,这样就造成了资源的浪费
- 动态PV:云存储服务会直接将他的服务抽象到集群内部形成一个PV,这个PV可以理解为一个通道。然后直接写PVC,在通过PVC清单要求的容量大小、类型自动划分
所以StorageClass更多是配合云厂商实现,毕竟只有大厂才有专业的存储部门,存储类就是指不同厂商的存储服务。
当然公司内部也可以自己搭建块存储的服务。有相应的软件提供支持,包括但不限于,比如lognhorn为分布式存储提供支持,nfs-client-provisioner为中心化存储提供支持
我这里就要用nfs-client-provisioner软件,nfs实在太老了,动态分配存储并不符合k8s的标准,所以需要这个第三方软件来实现,用它来模拟一个云厂商的StaaS(存储即服务)
这个软件镜像是开源的,可以再github上搜索或者用这个国内镜像站,很全面很好用渡渡鸟镜像同步站 https://docker.aityp.com/
#搭建nfs服务器,每个节点都安装
yum -y install nfs-utils rpcbind
systemctl start rpcbind
systemctl start nfs-server.service

#回到master节点
mkdir /nfsdata
useradd nfsnobody
chmod 666 /nfsdata
chown nfsnobody /nfsdata
cd /nfsdata


vim /etc/exports
/nfsdata/share *(rw,no_root_squash,no_all_squash,sync)
#创建命名空间
kubectl create ns nfs-storageclass
#创建控制器,模拟k8s的动态存储分配器nfs-client-provisioner,创建一个存储类
apiVersion: apps/v1
kind: Deployment
metadata:
name: nfs-client-provisioner
namespace: nfs-storageclass
spec:
replicas: 1
selector:
matchLabels:
app: nfs-client-provisioner
strategy:
type: Recreate
template:
metadata:
labels:
app: nfs-client-provisioner
spec:
serviceAccountName: nfs-client-provisioner
containers:
- name: nfs-client-provisioner
image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/gmoney23/nfs-client-provisioner:latest
volumeMounts:
- name: nfs-client-root
mountPath: /persistentvolumes
env:
- name: PROVISIONER_NAME
value: k8s-sigs.io/nfs-subdir-external-provisioner
- name: NFS_SERVER
value: 192.168.176.101
- name: NFS_PATH
value: /nfsdata/share
volumes:
- name: nfs-client-root
nfs:
server: 192.168.176.101
path: /nfsdata/share
#创建sa,这个后面安全的章节会学到, 现在不用看懂,后面安全章节会学到,那时候再回来看就豁然开朗了,我这里先写出来是为了让同志们知道有这么个方法
apiVersion: v1
kind: ServiceAccount
metadata:
  name: nfs-client-provisioner
  namespace: nfs-storageclass
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: nfs-client-provisioner-runner
rules:
  - apiGroups: [""]
    resources: ["nodes"]
    verbs: ["get", "list", "watch"]
  - apiGroups: [""]
    resources: ["persistentvolumes"]
    verbs: ["get", "list", "watch", "create", "delete"]
  - apiGroups: [""]
    resources: ["persistentvolumeclaims"]
    verbs: ["get", "list", "watch", "update"]
  - apiGroups: ["storage.k8s.io"]
    resources: ["storageclasses"]
    verbs: ["get", "list", "watch"]
  - apiGroups: [""]
    resources: ["events"]
    verbs: ["create", "update", "patch"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: run-nfs-client-provisioner
subjects:
  - kind: ServiceAccount
    name: nfs-client-provisioner
    namespace: nfs-storageclass
roleRef:
  kind: ClusterRole
  name: nfs-client-provisioner-runner
  apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: leader-locking-nfs-client-provisioner
  namespace: nfs-storageclass
rules:
  - apiGroups: [""]
    resources: ["endpoints"]
    verbs: ["get", "list", "watch", "create", "update", "patch"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: leader-locking-nfs-client-provisioner
  namespace: nfs-storageclass
subjects:
  - kind: ServiceAccount
    name: nfs-client-provisioner
    namespace: nfs-storageclass
roleRef:
  kind: Role
  name: leader-locking-nfs-client-provisioner
  apiGroup: rbac.authorization.k8s.io
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: nfs-client
provisioner: k8s-sigs.io/nfs-subdir-external-provisioner
parameters:
  pathPattern: ${.PVC.namespace}/${.PVC.name}
  onDelete: delete
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
name: test-claim
annotations:
spec:
accessModes:
- ReadWriteMany
resources:
requests:
storage: 1Mi
storageClassName: nfs-client
---
apiVersion: v1
kind: Pod
metadata:
name: test-pod
spec:
containers:
- name: test-container
image: nginx:one
imagePullPolicy: IfNotPresent
volumeMounts:
- name: nfs-pvc
mountPath: /usr/share/nginx/html
restartPolicy: Never
volumes:
- name: nfs-pvc
persistentVolumeClaim:
claimName: test-claim

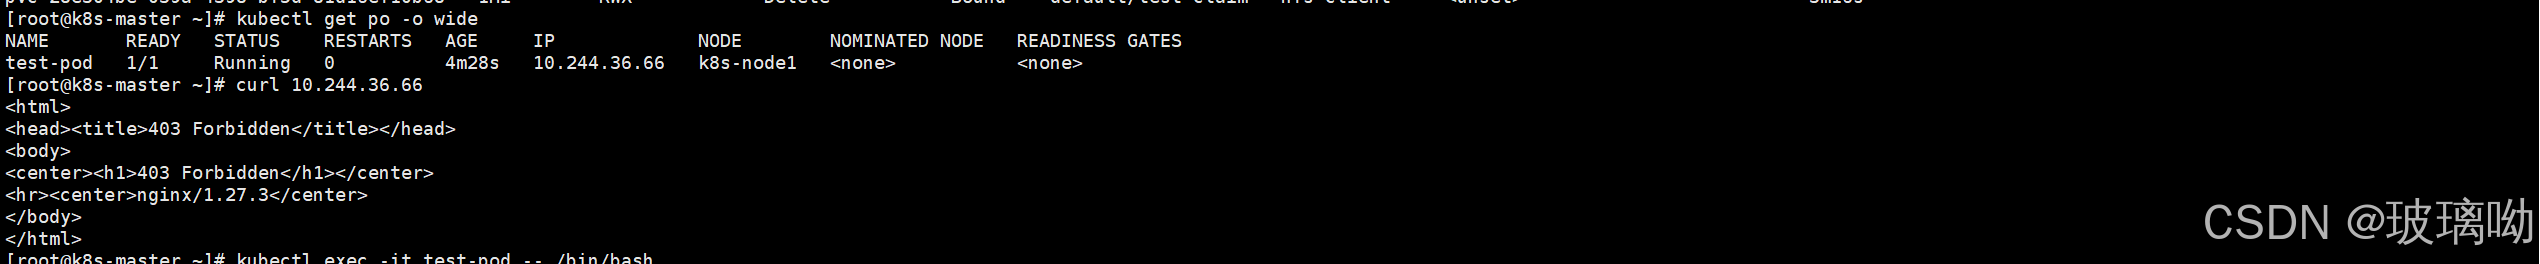

访问pod被拒绝,因为原本的index.html文件被挂载的存储覆盖了,去目录自己随便写个就行
删除pod后PV/PVC都会消失
6、StatefulSet和无头服务
在上面“PV/PVC创建”章节中,出现了之前提过的控制器和服务:StatefulSet和Headless Service。之前没进行实验是因为要结合PV/PVC进行。下面具体展开介绍
前面说了pod控制器,pod控制器分为两种类型
- 批处理任务:Job、CronJob
- 守护进程:ReplicationController、RepolicaSet、Deployment、DaemonSet、StatefulSet
守护进程类型控制器还分为两种:
- 控制无状态服务:ReplicationController、RepolicaSet、Deployment、DaemonSet
- nginx就是典型的无状态应用。实例之间相互独立,没有唯一身份或持久数据的需求。任意实例可以随时被替换,且数据可以丢失就。比如日志丢失不会导致服务出问题。
- 控制有状态服务:StatefulSet
- 而mysql就是典型的有状态应用。比如mysql集群,从两个高可用的mysql拿走一个,过段时间在放回进群内,它肯定不能使用了,因为数据没有同步。StatefulSet 提供了对有状态应用所需的特性支持,例如持久存储、固定网络标识和有序部署/删除等。
StatefulSet的特性
- 有序创建;有序回收
- 数据持久化Pod级别
- 稳定的网络访问方式
有序创建
#依旧是部署nfs服务
yum -y install nfs-utils rpcbind
systemctl start rpcbind
systemctl start nfs-server.service

#回到master节点,我选了此节点作为nfs服务器
mkdir /nfsdata
useradd nfsnobody
chmod 666 /nfsdata
chown nfsnobody /nfsdata
cd /nfsdata

for i in {1..10} ;do mkdir $i ;echo $i > $i/index.html ;done

vim /etc/exports
/nfsdata/1 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/2 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/3 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/4 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/5 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/6 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/7 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/8 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/9 *(rw,no_root_squash,no_all_squash,sync)
/nfsdata/10 *(rw,no_root_squash,no_all_squash,sync)

exportfs -r

showmount -e <hostIP>    #查看共享

#可以在集群中其他节点测试挂载nfs目录
mount -t nfs <nfsServerIP:/path> <localPath>
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv1
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/1
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv2
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadOnlyMany
  persistentVolumeReclaimPolicy: Delete
  storageClassName: nfs
  nfs:
    path: /nfsdata/2
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv3
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: nfs
  nfs:
    path: /nfsdata/3
    server: 192.168.100.101
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfspv4
spec:
  capacity:
    storage: 1Gi
  accessModes:
  - ReadWriteMany
  persistentVolumeReclaimPolicy: Recycle
  storageClassName: nfs
  nfs:
    path: /nfsdata/4
    server: 192.168.100.101
---
apiVersion: v1
kind: Service
metadata:
  name: pvsv
spec:
  clusterIP: None
  ports:
  - name: web
    port: 6666
  selector:
    app: nginx
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: nginx
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nginx
  serviceName: pvsv
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/nginx:1.27.0
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: suibian
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: suibian
    spec:
      accessModes:
      - ReadWriteOnce
      storageClassName: nfs
      resources:
        requests:
          storage: 1Gi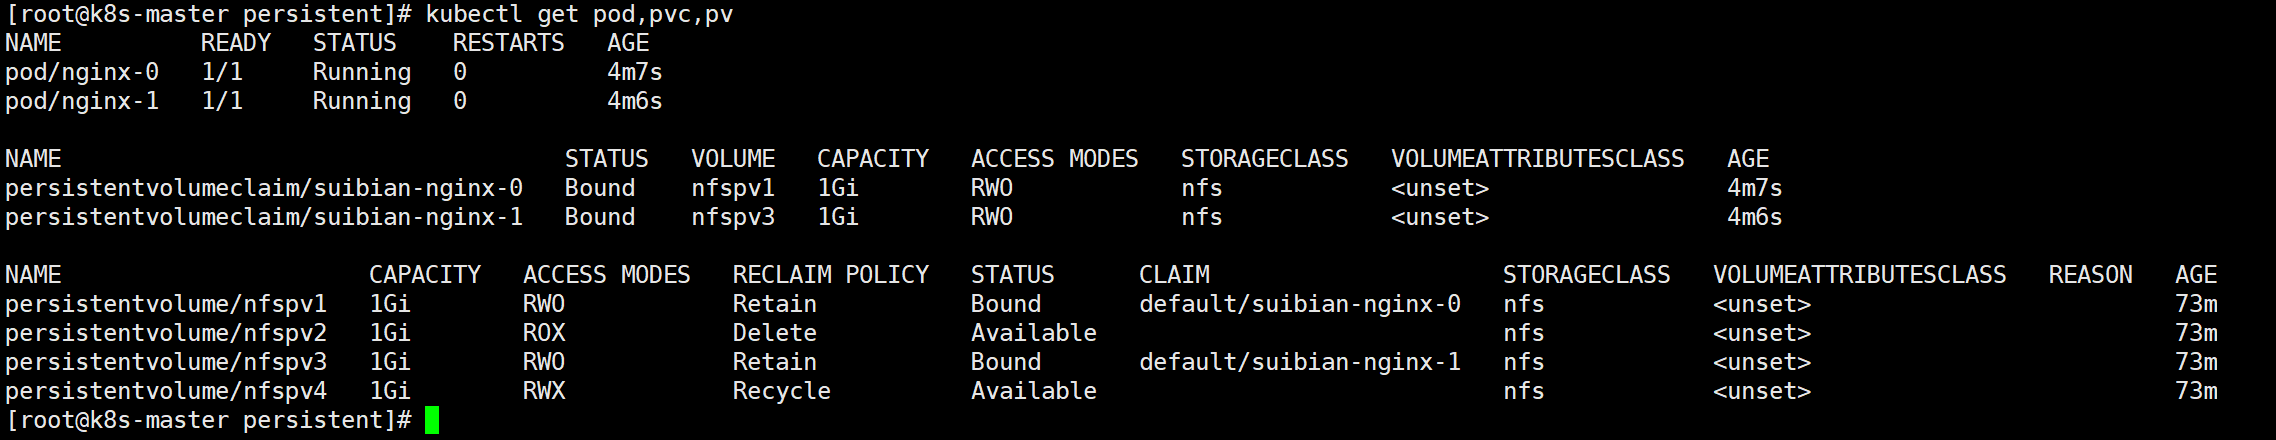
可是同志们,我现在有个问题,我想扩容一下nginx pod数量,是否可行呢?试一下
#调整控制器副本数量
kubectl scale <controllerKind> <controllerName> --replicas=<Number>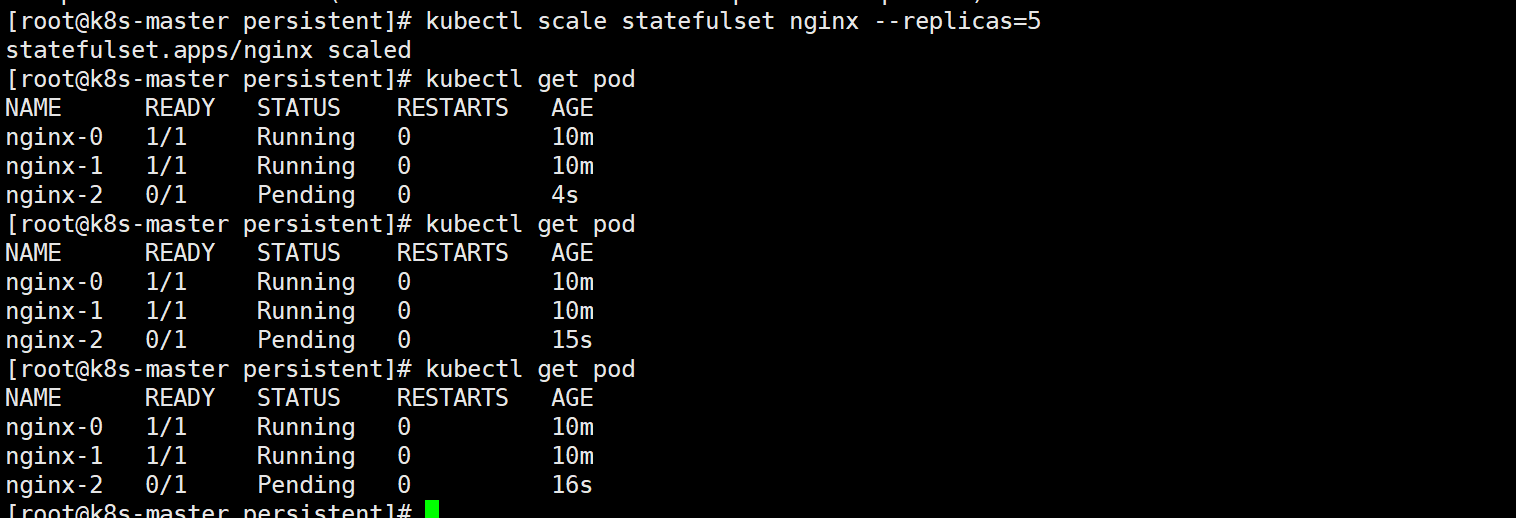
从上图看,pod名字很奇怪哈,不像其他控制器一样后面跟的是哈希值,而是从0开始按序往下。到了处于pending状态的nginx-2停了。这就是有序创建的特性,等待上一个pod处于running状态后,停才会继续创建下一个pod,这就是有序创建;有序回收就是倒着来
再来看pod,出现了Pending待处理的这么一个状态,describe看下pod创建过程
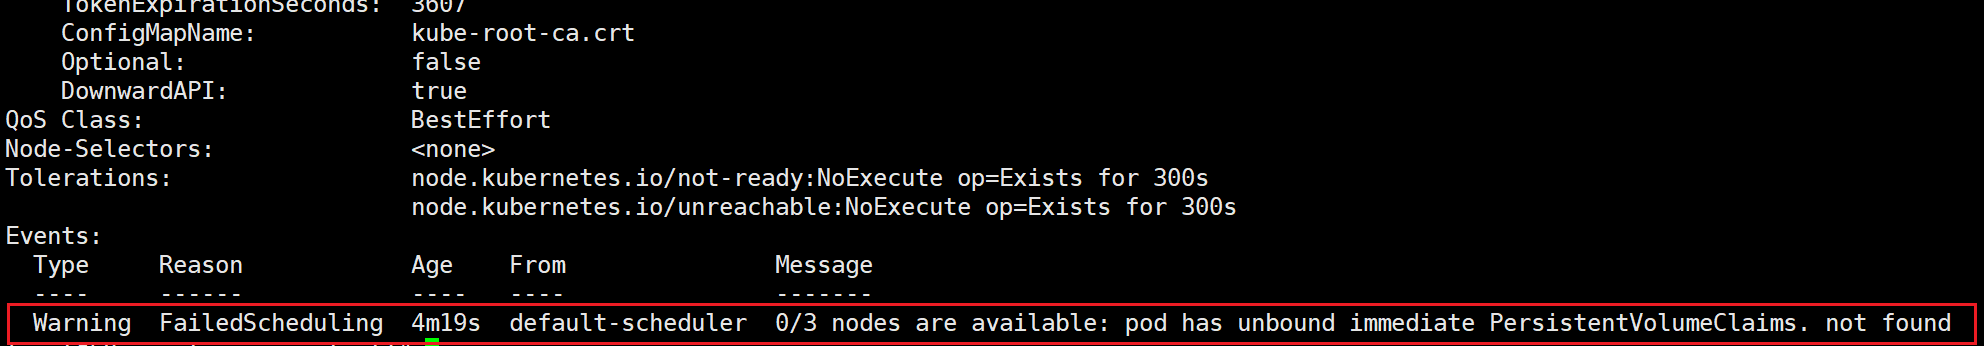
从上图来看,有个告警报错,这个报错的来源是默认调度器,说的是有三个节点可用,但是pod没有办法调度到任何节点。因为系统找不到可用的pv来绑定pvc。
为什么PVC无法绑定到PV了?看下代码,PVC要求有三点,类型要是nfs、大小1GB、单节点读写
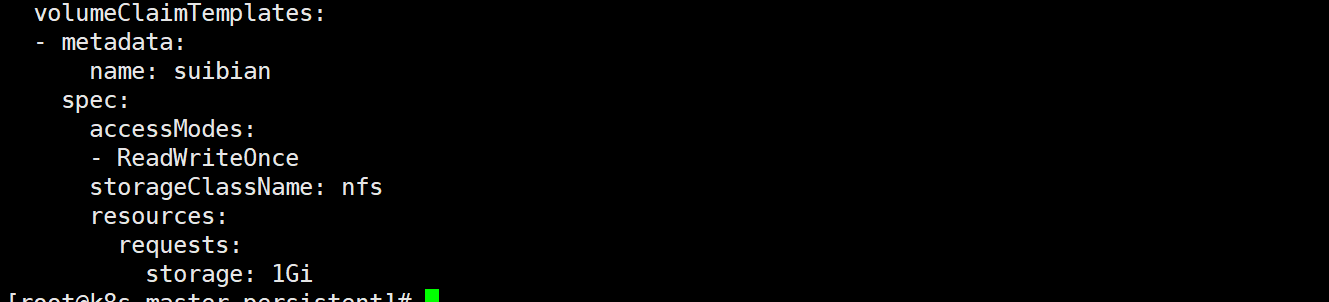
再看创建好的4个pv情况,只有两个单节点读写的pv,从ngxin-2开始的pod创建后pvc找不到合适的pv了,所以一直处于一个待处理状态

数据持久化Pod级别
随便访问一个pod,访问nginx-0好了,可以看到主页内容是1
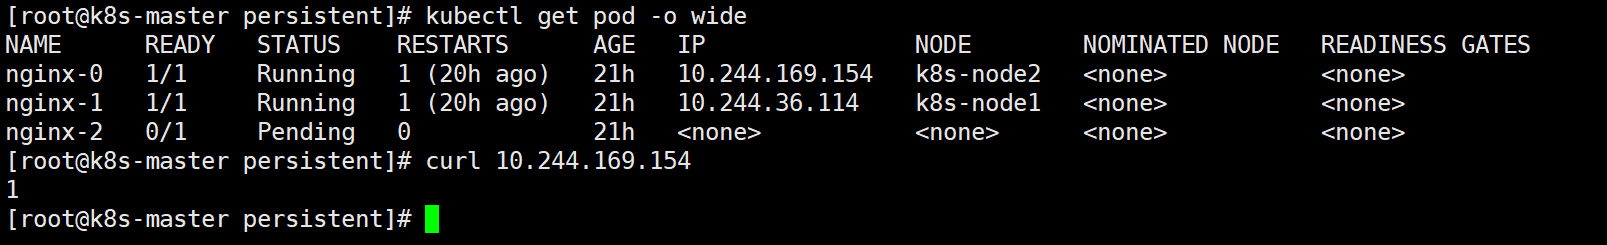
进入容器内给主页添加一些内容然后删除pod
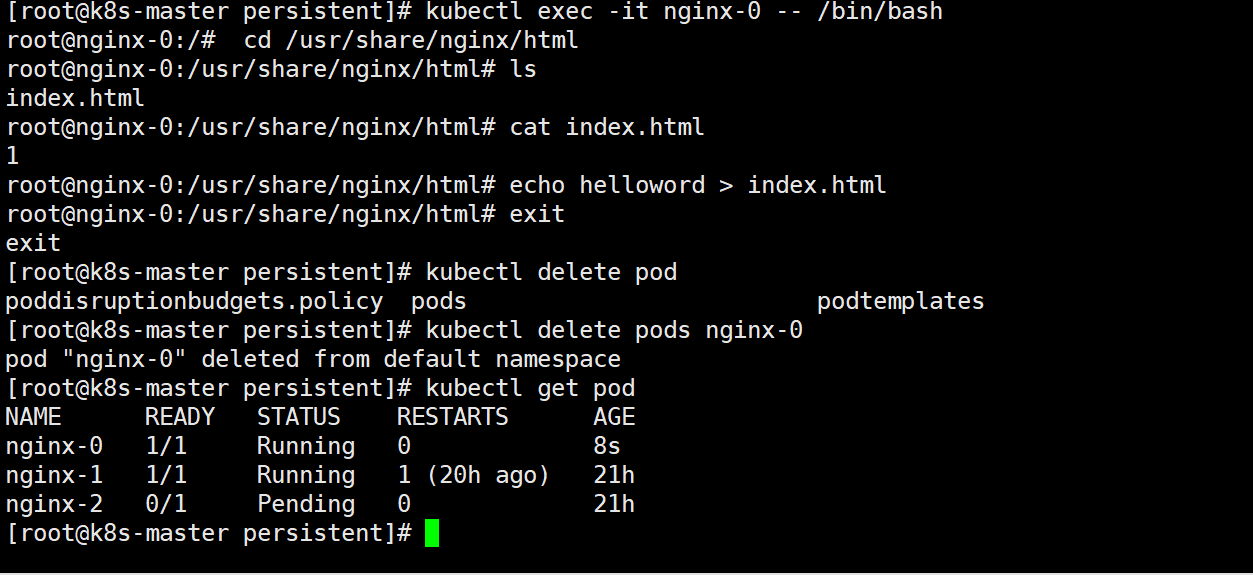
等到pod重建后再去访问nginx-0看结果,就会发现访问内容还是一样的。通过ip和创建时间就知道这是完全的重建的新的pod
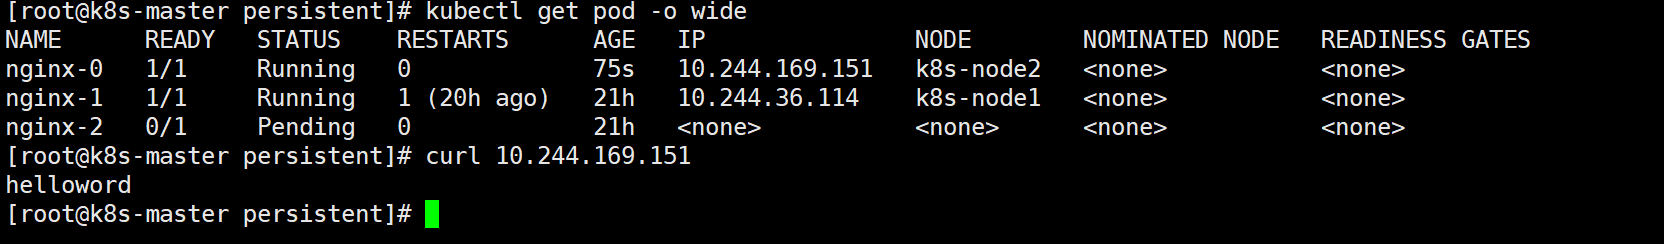
实现过程来分析下:pod绑定pvc,pvc绑定pv,pv绑定nfs实体存储。
虽然pod被删除了,但是pvc和pv的绑定是没有变化的,当同样一个pod出现,绑定同样一个pvc,那后端的数据肯定是一致的
从实验可以看出来这个数据的持久化是pod级别的,将pod杀死在创建一个新的数据也一致
稳定的网络访问方式
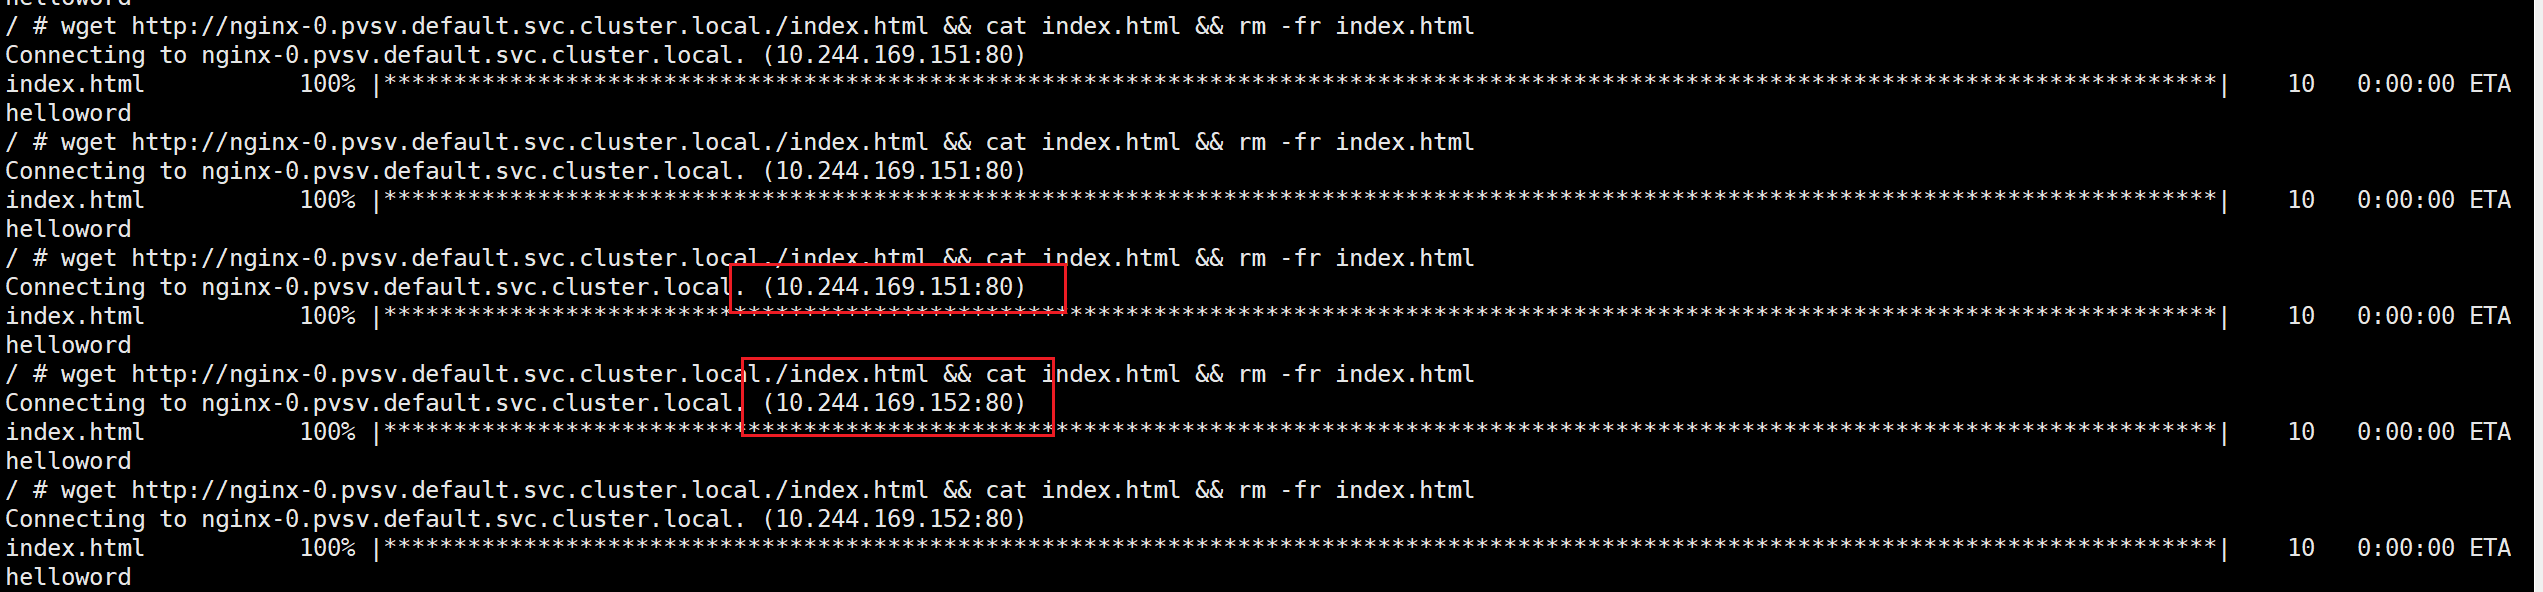
通过上面的数据持久化实验会发现,虽然数据一致了,但是IP进行了变更。通过IP访问Pod很显然这不是一个稳定的方式。但是有另个方式:域名(比如www.baidu.com)
做个实验,随便写个pod。
apiVersion: v1
kind: Pod
metadata:
  name: test
spec:
  containers:
  - name: test-c
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/busybox:1.28
    imagePullPolicy: IfNotPresent
    command:
    - "sleep"
    - "3600"
启动对象,进入pod内部
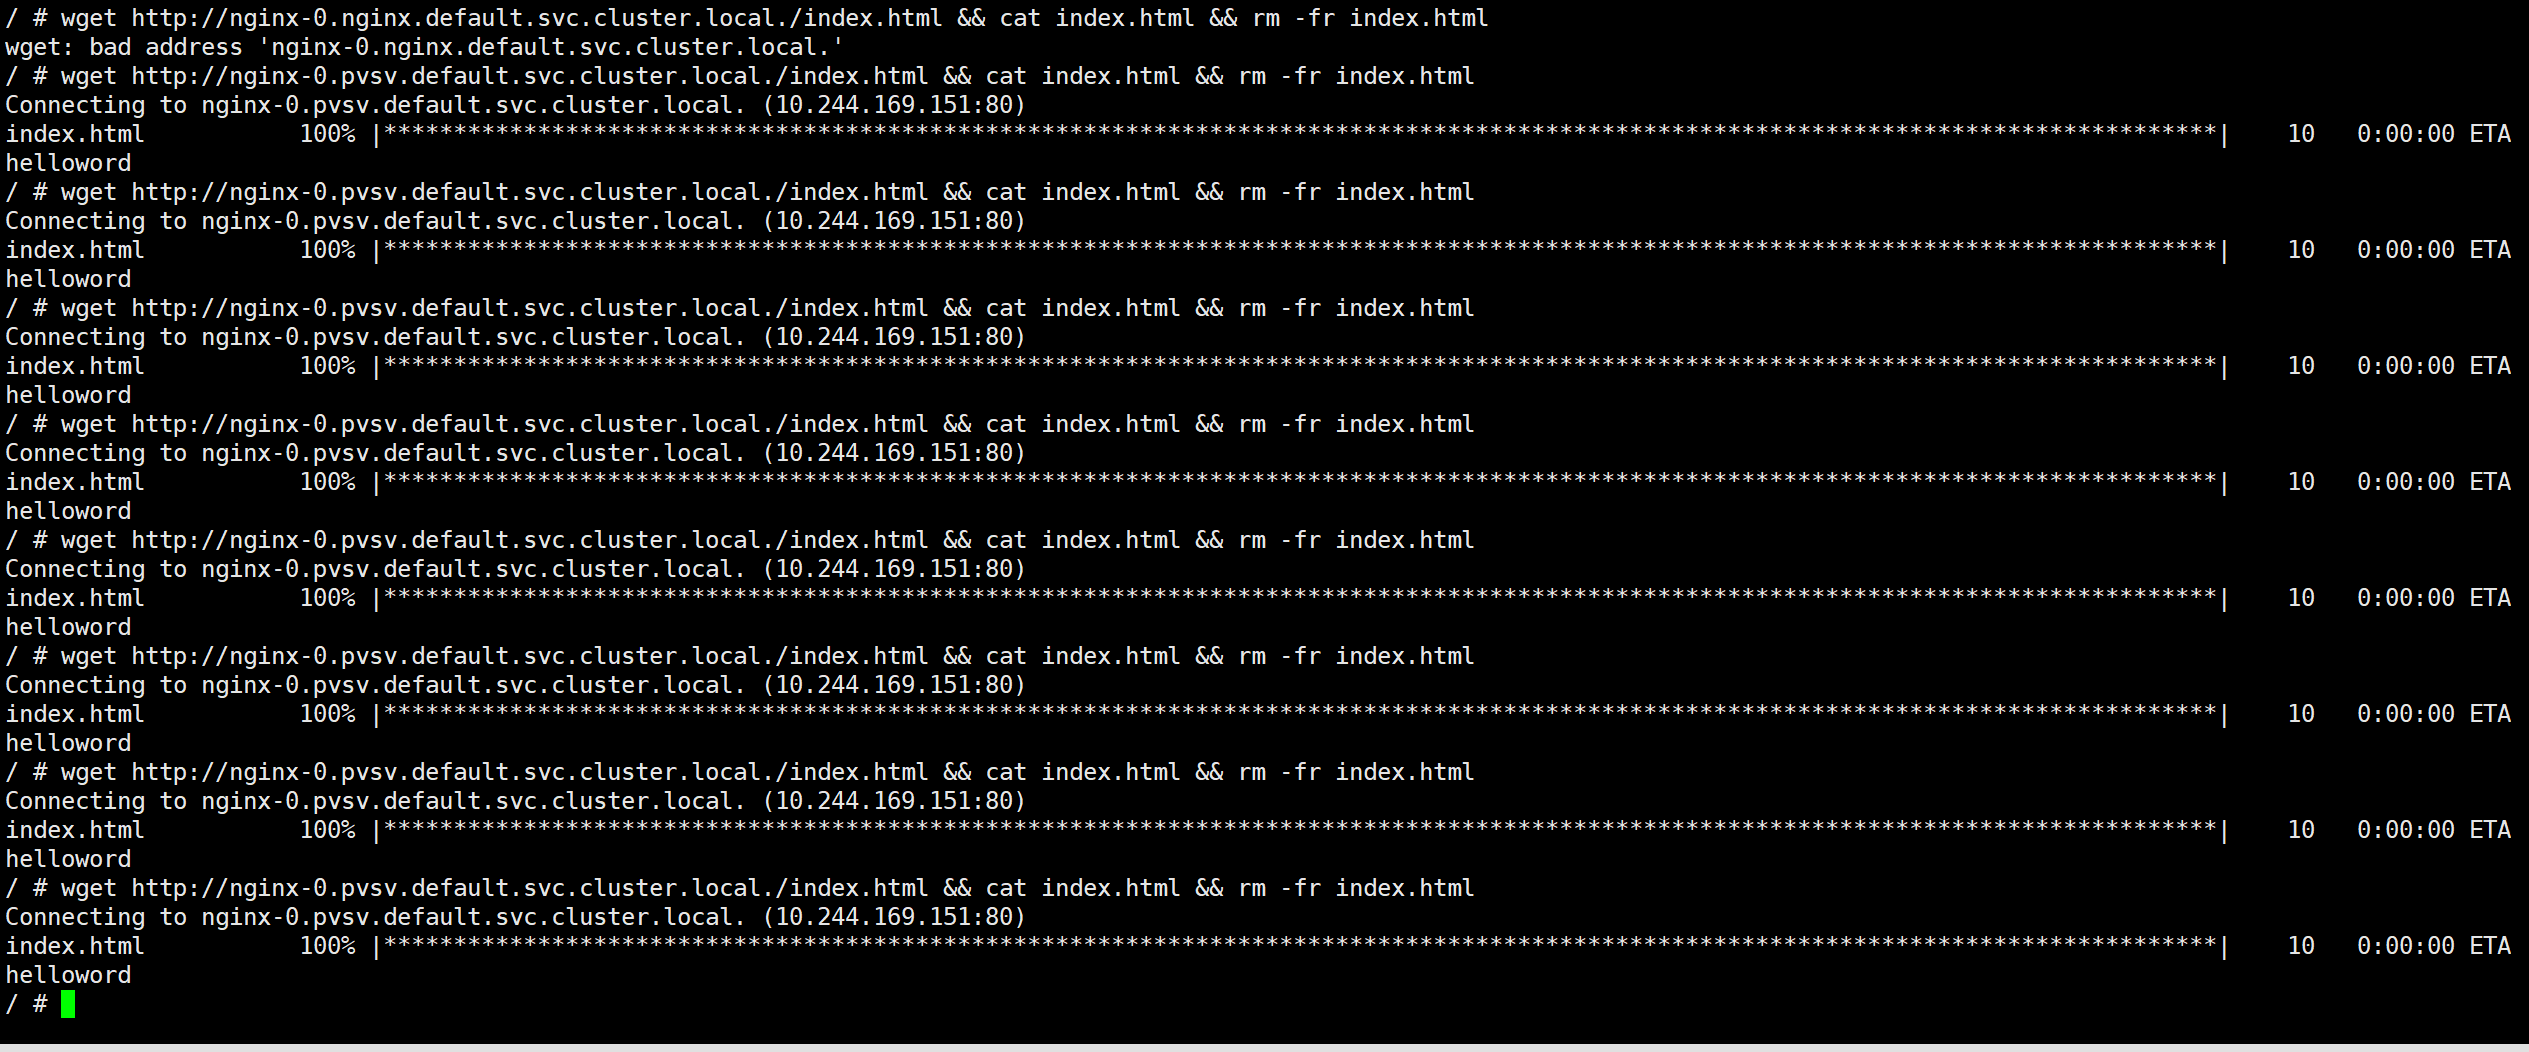
wget http://nginx-0.pvsv.default.svc.cluster.local./index.html && cat index.html && rm -fr index.html

#之前访问域名都是从svc的名字开始,但这样不能准确访问到web-0的内容,因为svc会轮训负载。所以最前面加了web-0,用域名精准访问
ok没问题,访问的是同一个主页,现在还不能说明问题
删除nginx-0后,待nginx-0重建后访问看看,如下图所示,访问的是同个域名但是可以发现pod的ip是变了的,佐证了域名的稳定性访问
无头服务(Headless Services)
生产环境中有时并不需要负载均衡,也不需要ServiceIP。遇到这种情况,可以通过显式设置集群 IP(spec.clusterIP)的值为 "None" 来创建无头服务(Headless Service)。可以使用无头 Service 与其他服务发现机制交互,而不必绑定到 Kubernetes 的实现
它是一种特殊的Service类型,它的核心特点是:不分配 ClusterIP,也不做负载均衡。只告诉你所有Pod的真实地址。还能给每个Pod一个永久的DNS名字(稳定的网络标识),此服务虽说不是为了SFS控制器而生,但是其最核心、最经典的功能(稳定的网络标识),必须依赖StatefulSet才能实现
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: deploy-demo
spec:
  replicas: 3
  selector:
    matchLabels:
      app: deploy
  template:
    metadata:
      labels:
        app: deploy
    spec:
      containers:
      - name: deploy-demo-container
        image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/docker.io/nginx:1.27.0
        imagePullPolicy: IfNotPresent
apiVersion: v1
kind: Service
metadata:
name: headless
spec:
clusterIP: None
ports:
- name: web
port: 6666
selector:
app: suibian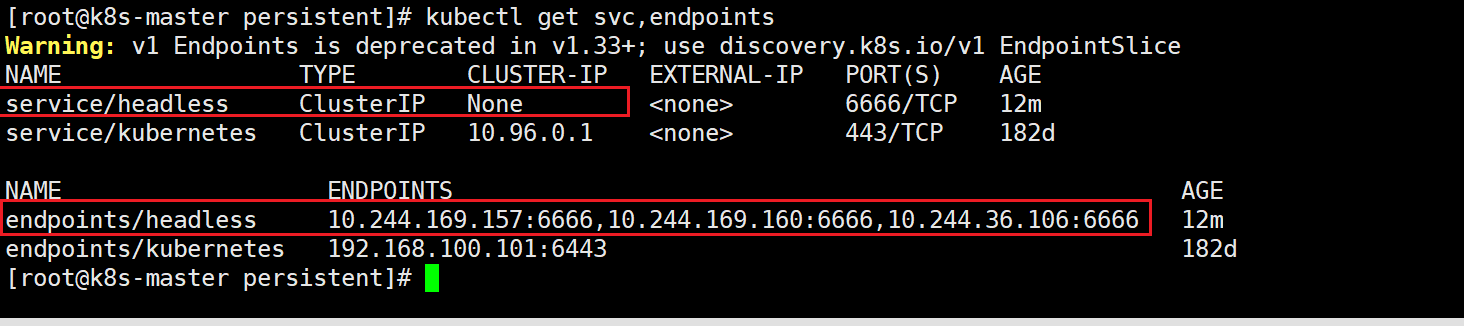
无头 Service 不会获得集群 IP,kube-proxy 不会处理这类 Service, 而且平台也不会为它们提供负载均衡或路由支持。但是和svc同名的endpoint却是有记录的
前面提到过SVC底层实现是将SVC的标签选择器匹配到的podIP记录到端点中,再由kube-proxy将规则维护至ipvs中,由每个节点的kube-proxy进程为SVC实现VIP的效果。但是现在clusterIP为空,没了VIP,endpoint还记录端点信息有什么用呢?
写DNS记录
之前说到过SVC的默认域名为svcName.namespace.svc.cluster.local.从这个规则的域名可以解析出svc的clusterIP,但是现在svc是无头服务,没有了clusterIP解析他有什么意义呢
先通过集群DNS Pod来解析下,看看结果
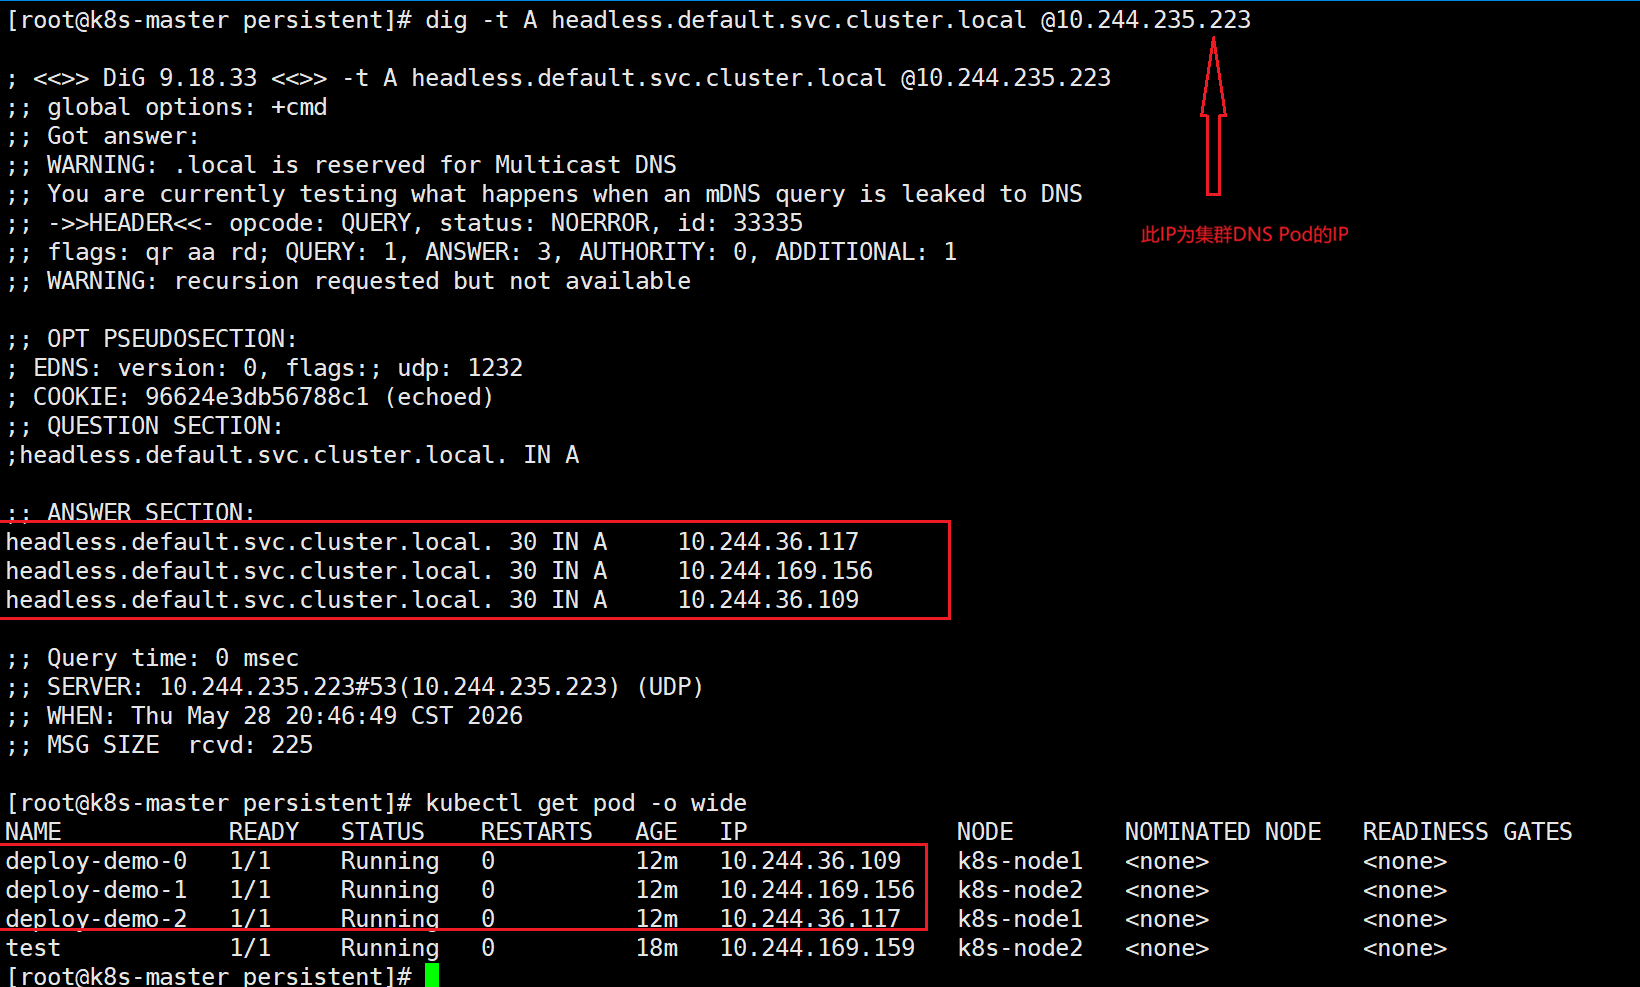
可以看到SVC关联的Pod的IP和域名都被解析了出来,这不是重点,重点是SFS用唯一的取名方式给了每个Pod独一无二的域名
Pod域名就是在SVC域名前面加上Pod名称,其他控制器用控制器名字加哈希值来给Pod取名 ,随着Pod被重建,Pod名称也会变化。但是SFS始终是名称加序数这种有序创建的方式进行取名,这就代表了一旦根据SFS控制器的Pod被创建,Pod的域名就已经被固定了,即使Pod被删除重建,名称依然不变。这种方式为数据库、消息队列等有状态应用提供稳定的网络身份
解析一下Pod域名就知道结果如何
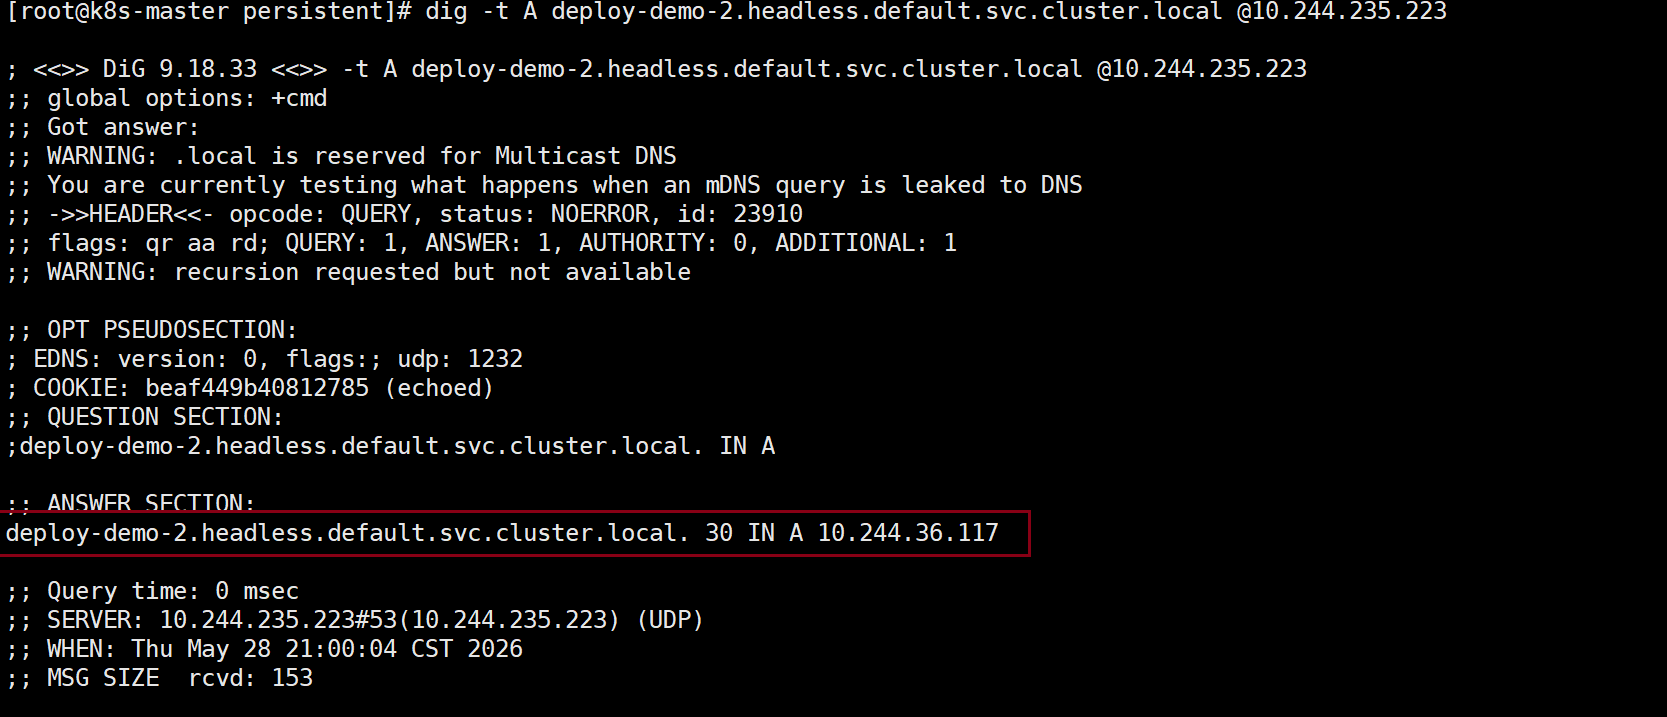
域名和IP被解析出来了,把deploy-demo-2删掉,在进行解析看看
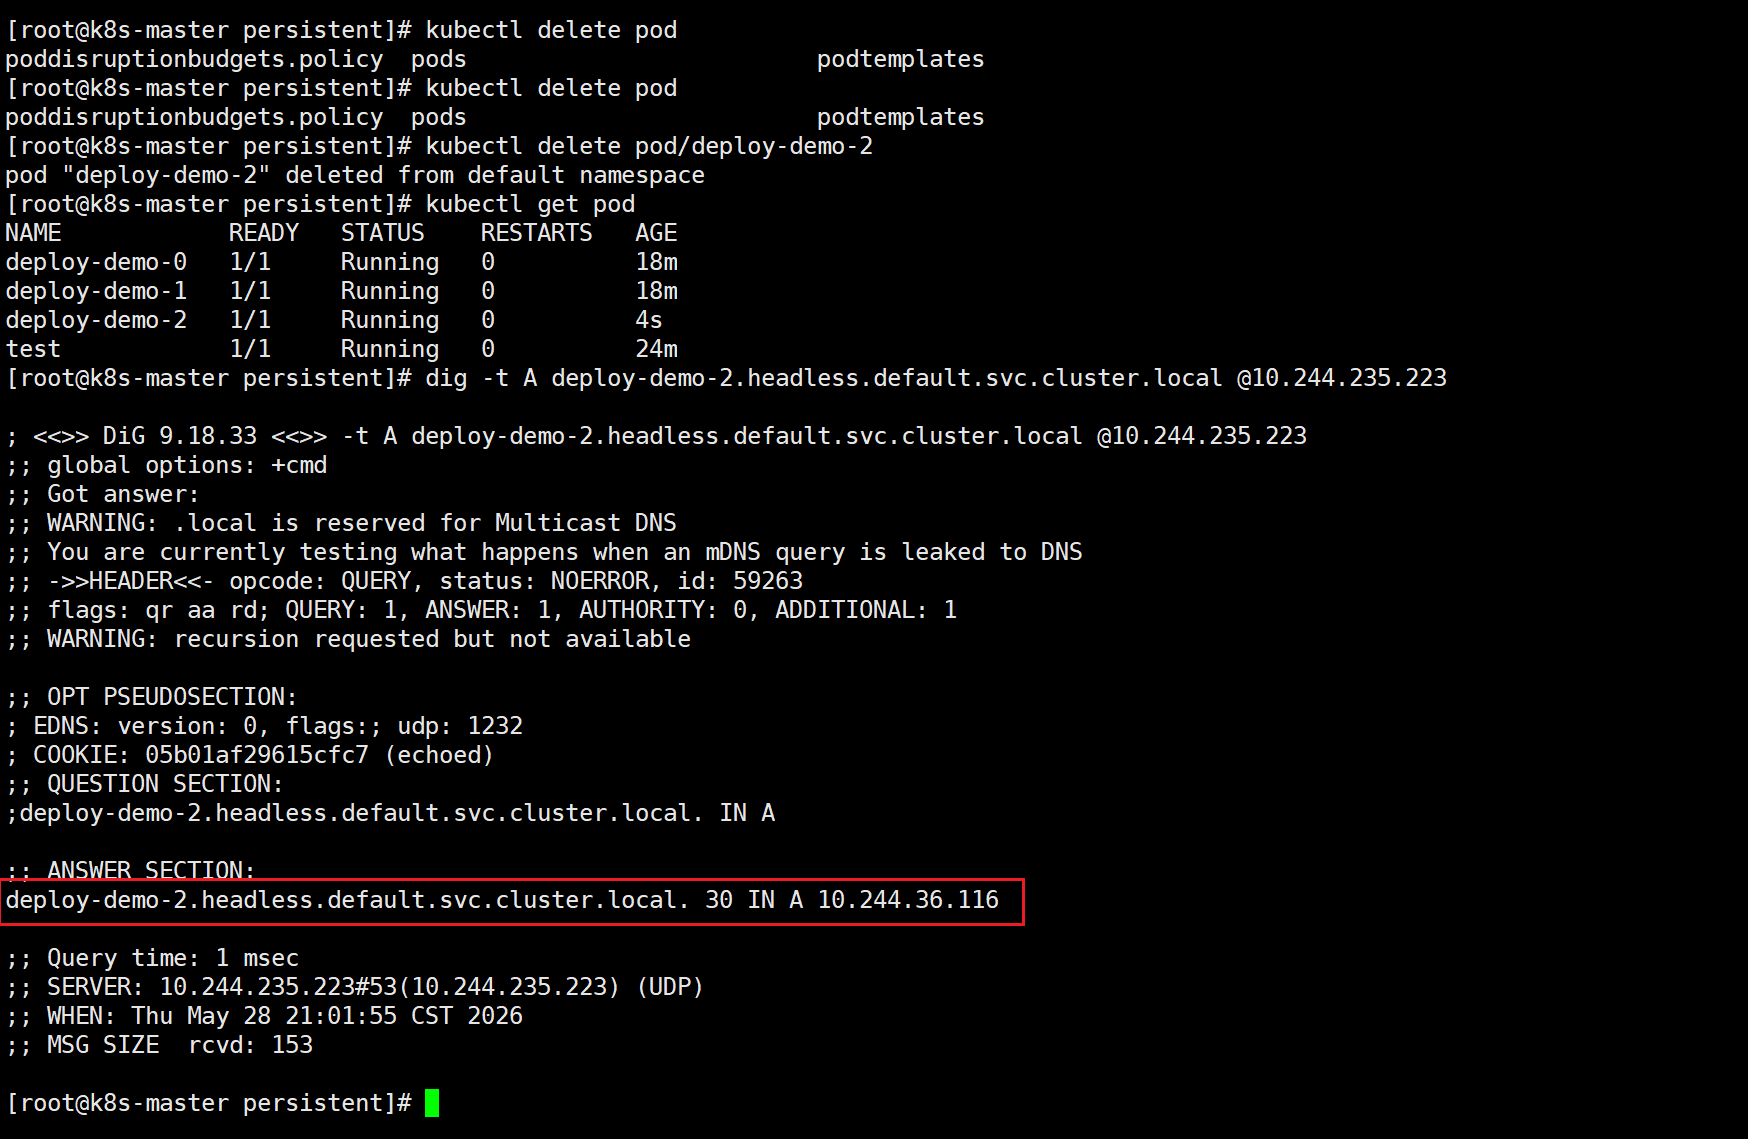
只有IP变了,域名依旧不变,侧面证明了稳定的网络身份
总结
StatefulSet 负责给每个 Pod 起固定的名字(比如 db-0),PVC 负责给每个 Pod 绑定专属的存储,无头服务负责让 Pod 之间能通过固定的域名(比如 db-0.db-svc)互相找到。
可以这样理解它们的分工:
-
StatefulSet + PVC:解决 “我的数据不能丢”。即使 Pod 删了重建,它还能找到自己原来的那个存储(PVC),不会拿错别人的数据。
-
StatefulSet + 无头服务:解决 “我的同伴在哪里”。数据库集群里(比如主从复制),Pod 需要通过一个永远不变的地址(域名)去找到其他 Pod,而不是靠可能会变的 IP。
如果去掉无头服务:
你只知道 db-0 这个名字,但找不到它的访问地址,其他 Pod 也就没法跟它通信了。
一个极简类比:
-
StatefulSet:固定的工号(
员工-001)。 -
PVC:专属的带锁工位抽屉(重启回来还是打开自己的抽屉)。
-
无头服务:内部通讯录(直接拨
员工-001就能找到他,不管他换了多少次座位/IP)。
结论: 单机版有状态应用(比如一个 MySQL 不用主从)可以只用 StatefulSet + PVC。但只要涉及到集群、主从、互相发现(比如 Kafka、ZK、Redis 集群),就必须加上无头服务。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 33
 0
- 0


 已为社区贡献1条内容

所有评论(0)