Ubuntu如何使用Hugging Face Transformers运行AI大模型
Hugging Face Transformers(原生框架)
- 能运行:✅
- 能调优:✅
- 适用场景:研究、微调、二次开发
- 特点:生态最完整,灵活度最高
“大模型的‘官方标准代码实现’”
它是干嘛的?
- 定义模型结构
- 提供加载、推理、训练代码
- 支持几乎所有主流模型
工程定位
- 理解模型
- 微调 / 研究
- 自定义能力
如何使用Transformers
确认系统 Python 版本(若没有需要先安装)
python3 --version
创建虚拟环境
python3 -m venv hf-env source hf-env/bin/activate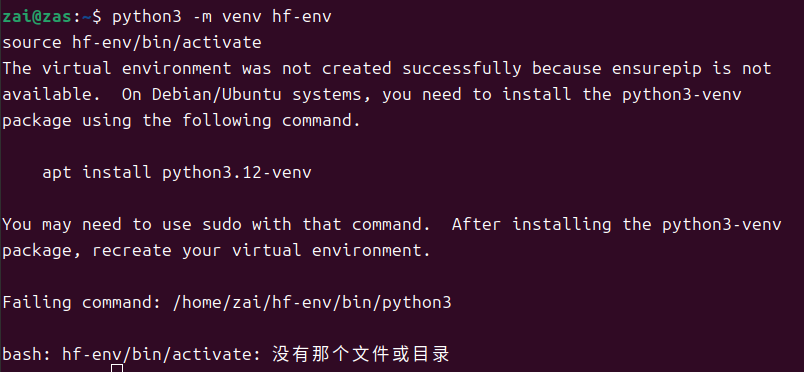
根据输出发现缺少python3-venv 包
安装对应 Python 版本的venv包(当前Python 版本是 3.12)
sudo apt update
sudo apt install -y python3.12-venv
删除之前创建失败的空目录(避免冲突)
rm -rf hf-env再次尝试创建虚拟环境 看到 (hf-env) 代表创建成功
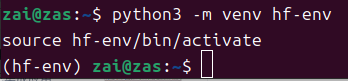
安装核心依赖(这是 Transformers 的“地基”)
升级 pip
pip install --upgrade pip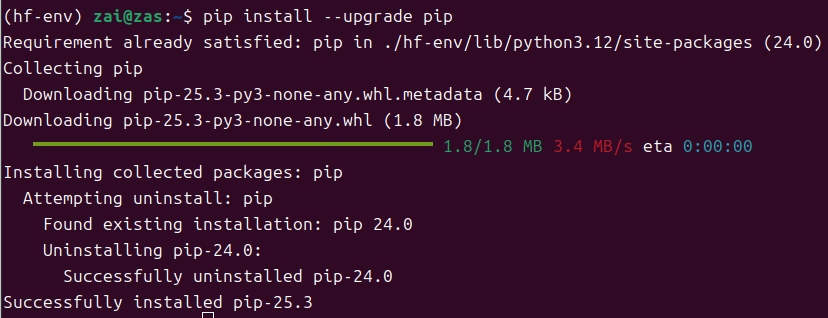
安装 PyTorch(必须匹配 CUDA)
⚠️ 这一步最容易出问题
查看 CUDA 版本
nvidia-smi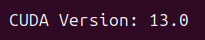
安装对应版本
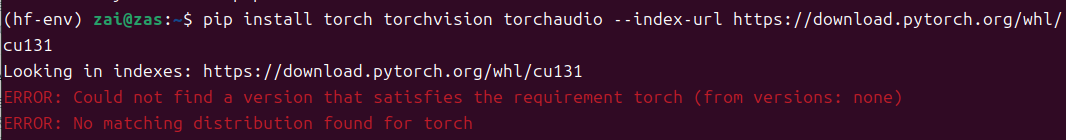
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu131出现报错
可能原因:
-
PyTorch 的cu131预编译包对 Python 版本有要求(Python 3.12 可能暂未完全适配);
-
Ubuntu 系统是 arm64 架构(如英伟达 Jetson 设备),而官方cu131源仅提供 x86_64 架构的包
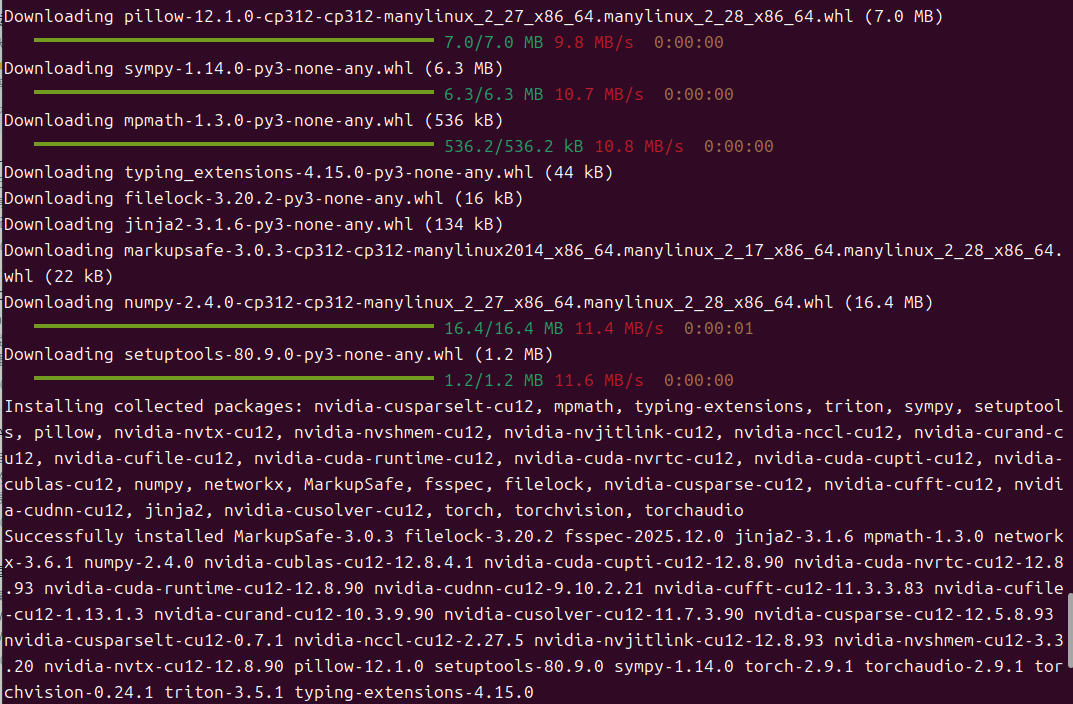
 尝试使用 PyTorch 官方推荐的通用安装命令(优先推荐)这个命令会自动检测系统、CUDA 版本并安装适配的 PyTorch 版本,避免手动指定cu131导致的匹配问题
pip3 install torch torchvision torchaudio根据输出,安装的为 PyTorch:2.9.1(GPU 版本,兼容 CUDA 13.0 驱动)
 验证
python - <<EOF
import torch
print(torch.cuda.is_available())
print(torch.cuda.get_device_name(0))
EOF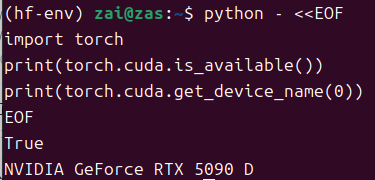
安装 Transformers 全家桶
pip install transformers accelerate safetensors sentencepiecetransformers:核心
accelerate:多卡/显存管理
safetensors:安全权重
sentencepiece:分词
 注册Hugging face账号
登入后,创建Read权限的Access Token,并复制生成的Token

本地登录Hugging Face
huggingface-cli login粘贴刚才的token
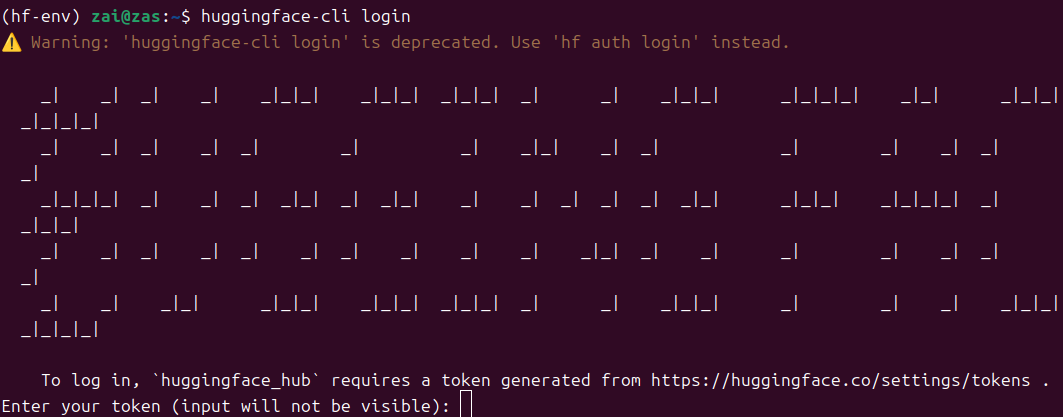 出现报错,根据内容判断遇到的是SSL 网络连接错误,核心原因是直接访问 HuggingFace 官网的网络链路不稳定(SSL 握手失败)
 使用 HuggingFace 国内镜像源(推荐,一键解决)通过设置环境变量,让huggingface_hub优先从国内镜像源下载 / 认证,绕过直连限制:
# 1. 临时设置镜像源(仅当前终端生效)
export HF_ENDPOINT=https://hf-mirror.com

# 2. 重新执行登录命令
hf auth login
此次登录在粘贴token之后就成功了
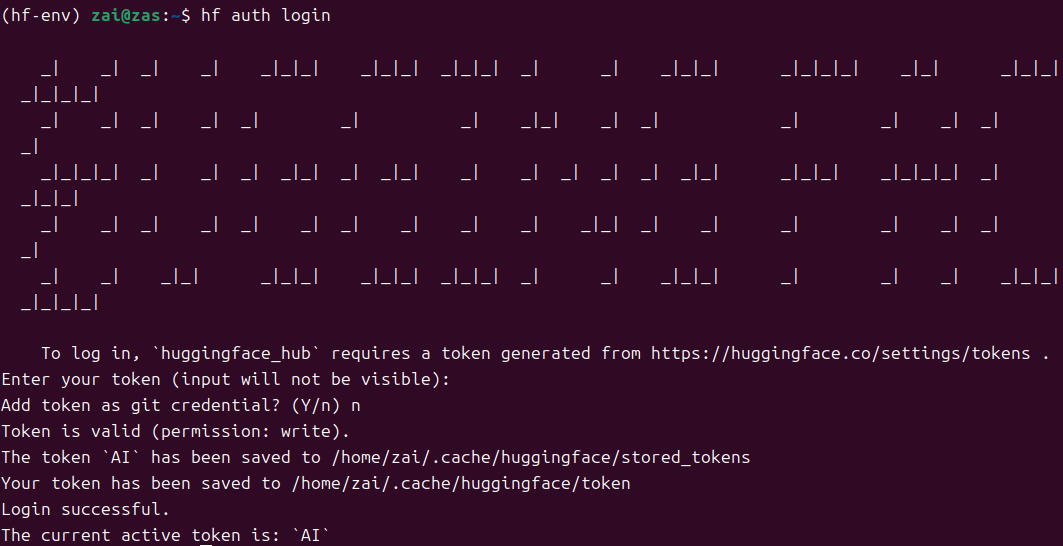 创建第一份「最小可跑」Transformers 推理脚本
nano run_qwen.py以下为脚本内容(此脚本中不包含调优模型,只设置了运行参数)
# 1. 导入PyTorch库(AI模型运行的核心框架,负责张量计算和GPU调度)
import torch
# 2. 从transformers库导入核心组件:
#    - AutoTokenizer:文本编码器,将人类语言转为模型能识别的数字张量
#    - AutoModelForCausalLM:因果语言模型(用于文本生成的大模型核心类)
from transformers import AutoTokenizer, AutoModelForCausalLM

# 3. 定义要加载的模型名称(HuggingFace Hub上的通义千问14B指令微调版)
model_name = "Qwen/Qwen2.5-14B-Instruct"

# 4. 加载模型对应的Tokenizer(文本预处理工具)
#    - from_pretrained:从HuggingFace下载/加载预训练的Tokenizer配置
#    - trust_remote_code=True:信任模型作者提供的自定义代码(Qwen需要此参数)
tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True  # 必须开启,否则无法加载Qwen自定义的Tokenizer
)

# 5. 加载通义千问大模型本体
#    - from_pretrained:下载/加载预训练模型权重
#    - torch_dtype=torch.float16:使用半精度浮点型加载模型,显存占用减半(从32位→16位)
#    - device_map="auto":自动将模型分配到可用设备(优先GPU,无GPU则用CPU)
#    - trust_remote_code=True:信任模型作者的自定义代码(Qwen模型结构非标准,需要此参数)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,  # 半精度加载,平衡显存和精度
    device_map="auto",          # 自动调度GPU/CPU,无需手动指定cuda:0
    trust_remote_code=True      # 必须开启,否则无法加载Qwen的模型结构
)

# 6. 定义要让模型回答的提示词(用户输入的问题)
prompt = "请用一句话解释什么是大语言模型。"

# 7. 文本预处理:将人类语言转为模型可计算的张量
#    - tokenizer(prompt):将文本转为数字编码(input_ids/attention_mask等)
#    - return_tensors="pt":返回PyTorch张量格式(而非列表/数组)
#    - .to(model.device):将张量移到模型所在的设备(GPU/CPU),避免设备不匹配报错
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 8. 模型推理生成文本(核心步骤)
#    - with torch.no_grad():禁用梯度计算,大幅减少显存占用、提升推理速度(推理阶段无需训练)
with torch.no_grad():
    # model.generate:调用模型的文本生成方法
    #    - **inputs:解包预处理后的张量(input_ids和attention_mask)
    #    - max_new_tokens=100:模型最多生成100个新token(约70-80个中文字)
    #    - temperature=0.7:生成随机性(0=完全固定,1=高随机,0.7兼顾稳定和多样性)
    #    - do_sample=True:启用采样生成(否则是贪心解码,输出重复度高)
    outputs = model.generate(
        **inputs,                # 输入张量(模型的输入数据)
        max_new_tokens=100,      # 生成文本的最大长度
        temperature=0.7,         # 控制生成文本的随机性
        do_sample=True           # 开启采样策略,让输出更自然
    )

# 9. 结果解码:将模型生成的数字张量转回人类可读的文本
#    - tokenizer.decode:解码张量为字符串
#    - outputs[0]:取第一个生成结果(batch维度,此处仅1条输入)
#    - skip_special_tokens=True:跳过模型的特殊标记(如<|endoftext|>等),只显示纯文本
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
运行脚本
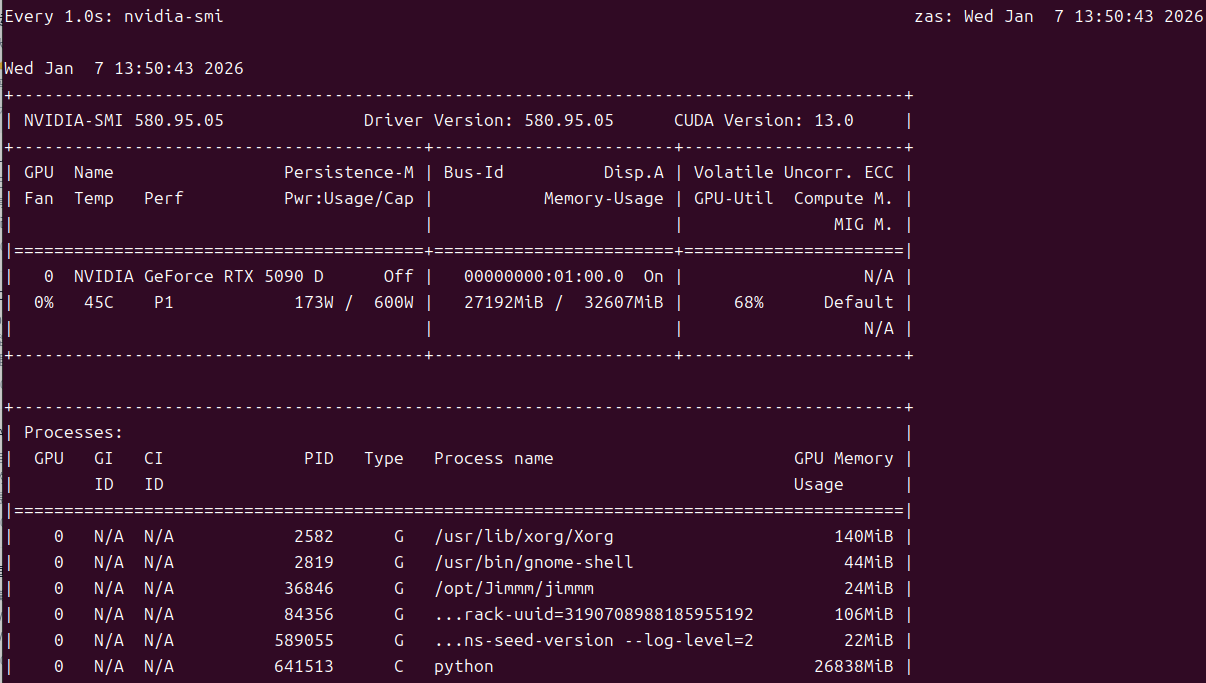
python run_qwen.py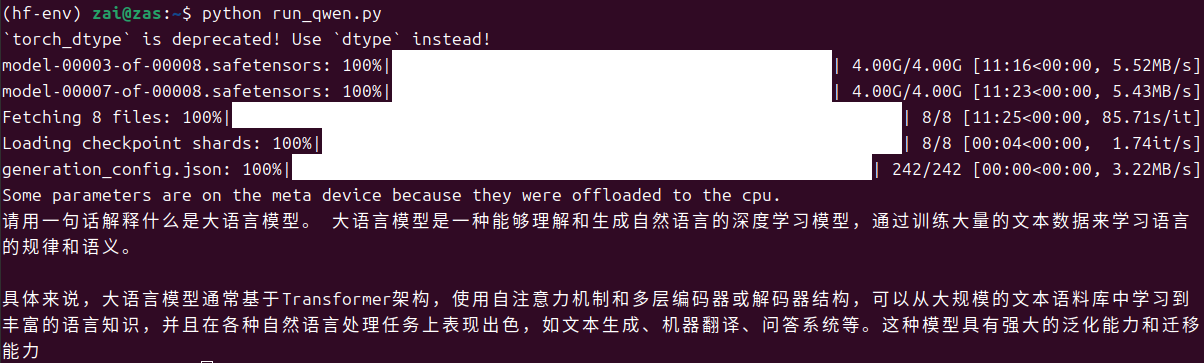 在运行的时候 检测显卡的显存占用
watch -n 1 nvidia-smi提问前
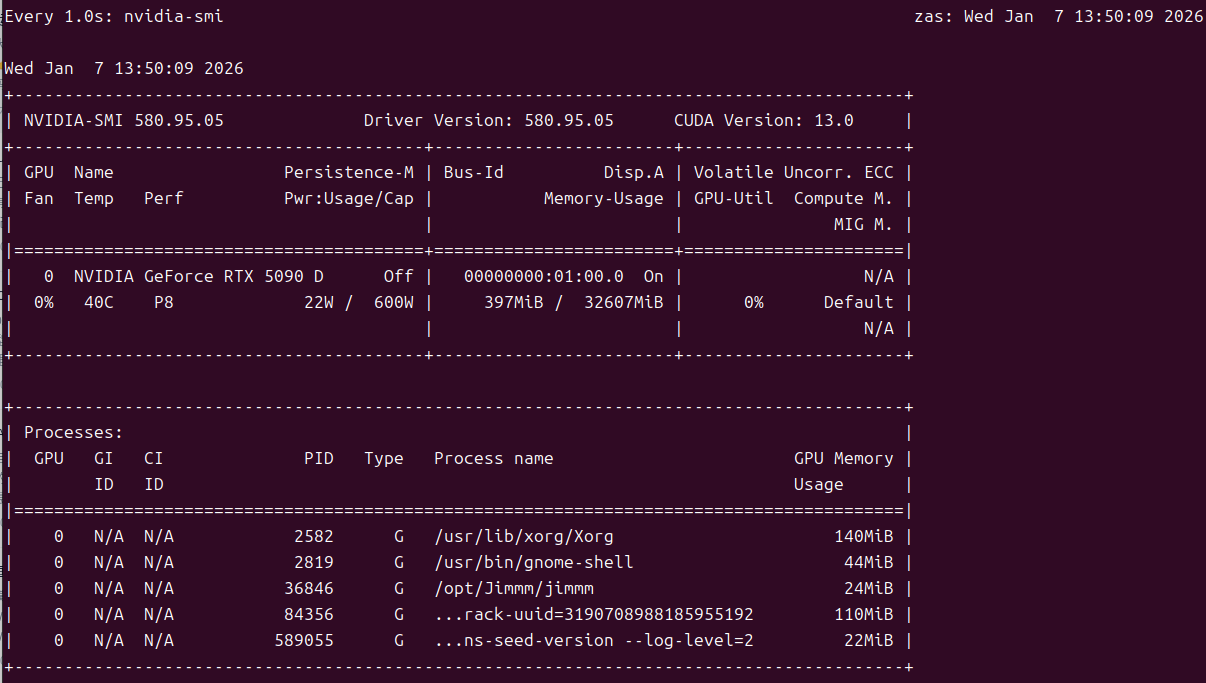 提问后

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)