企业AI落地避坑指南:Coze、Dify还是自研?技术选型实战经验
·
本文分享企业AI落地过程中的技术选型经验,帮助技术团队少走弯路。作者来自Moments团队,专注企业AI落地实战。
前言
2025年,几乎每个企业都在谈AI落地。但真正做过的人都知道,从Demo到生产环境,中间隔着无数个坑。
本文将从技术选型角度,分享Moments在多个企业AI项目中的实战经验。
一、技术选型的三条路线
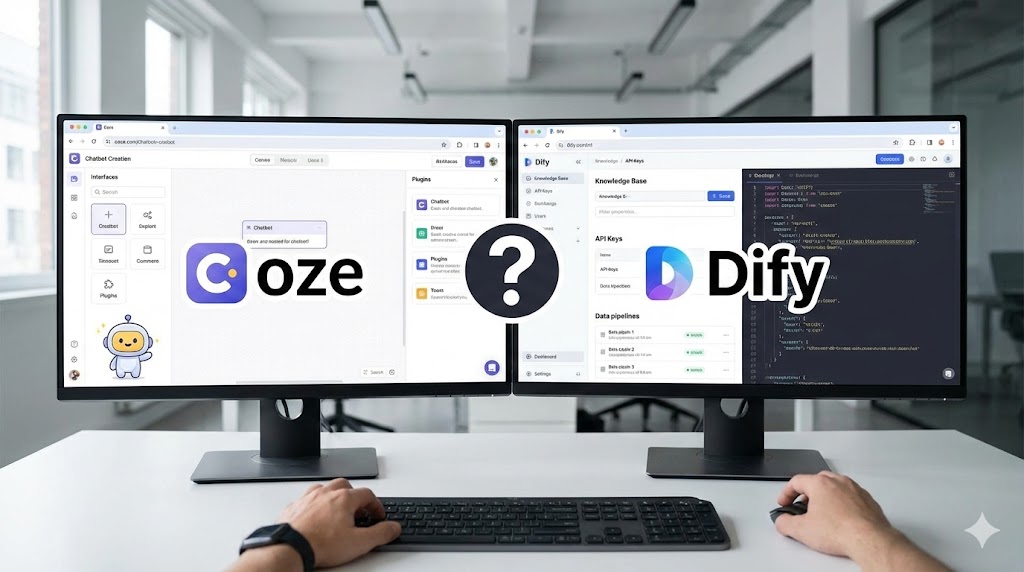
1.1 低代码平台路线:Coze / Dify
适用场景:
- 快速验证业务场景
- 团队技术能力有限
- 预算有限,希望快速上线
Coze(字节跳动):
优点: - 国内访问快,中文支持好
- 与飞书、抖音生态集成
- 可视化工作流编排
缺点: - 数据安全顾虑(第三方托管)
- 复杂场景定制能力有限
- 企业级功能较少
Dify:
优点:
- 开源可私有化部署
- 功能全面,更新活跃
- 社区生态好
缺点: - 私有化需要运维能力
- 高并发场景需要优化
- 企业级支持需付费
1.2 框架开发路线:LangChain / LlamaIndex
适用场景:
- 有一定开发能力的团队
- 需要深度定制
- 对性能有要求
LangChain 示例
from langchain.chains import RetrievalQA
from langchain.vectorstores import FAISS
构建检索增强生成(RAG)
qa_chain = RetrievalQA.from_chain_type(
llm=llm,
chain_type=“stuff”,
retriever=vectorstore.as_retriever()
)
```
选择建议:
- LangChain:通用场景,生态丰富
- LlamaIndex:文档处理为主,RAG场景
1.3 全自研路线
适用场景:
- 大型企业,有专门AI团队
- 核心业务场景,安全要求极高
- 需要极致性能优化
成本提醒: - 开发周期:3-6个月起
- 团队配置:至少2-3名AI工程师
- 持续投入:模型更新、运维迭代
二、常见踩坑经验
2.1 坑一:忽视数据质量
很多团队一上来就选模型、搭框架,却忽略了最基础的数据问题。
实战建议:
- 先花1-2周梳理数据现状
- 建立数据清洗pipeline
- 制定数据标注标准
2.2 坑二:过度追求模型能力
GPT-4不一定是最好的选择。
选模型的正确姿势:
| 场景 | 推荐模型 | 原因 |
|---|---|---|
| 简单问答 | GPT-3.5/GLM-4 | 成本低、速度快 |
| 复杂推理 | GPT-4/Claude | 准确率高 |
| 中文场景 | GLM-4/Qwen | 中文理解更好 |
| 私有部署 | Qwen/DeepSeek | 开源可控 |
2.3 坑三:忽视工程化
AI项目不只是调API,工程化同样重要:
- 监控告警:模型响应时间、错误率
- 版本管理:Prompt版本、模型版本
- 灰度发布:新版本先小流量验证
- 成本控制:Token消耗监控、限流策略
三、Moments的方法论
在Moments(AI落地实战派),总结了一套"三步走"方法:
Step 1:场景诊断
- 明确业务痛点
- 评估AI可行性
- 确定成功指标
Step 2:快速验证
- 2周内出MVP
- 真实用户测试
- 收集反馈迭代
Step 3:生产落地
- 工程化改造
- 性能优化
- 持续运营
四、总结
AI落地不是一蹴而就的事情。选对技术路线,避开常见的坑,才能让AI真正为业务创造价值。
关键要点:
- 根据团队能力和业务场景选择技术路线
- 数据质量 > 模型能力
- 重视工程化和持续运营
如果你正在做AI落地,欢迎交流:
- 官网:moments.top
- 定位:AI落地实战派

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)