华为杯ICT AI赛道 第9章 第九章 循环神经网络
学习要点
❖ 什么是RNN?
❖ LSTM的内部结构及变种?
❖ 循环神经网络的特性?分别有什么优点和缺点
❖ 可以对循环神经网络有简单的应用?
9.1 循环神经网络(RNN)
三种神经网络
神经网络的几种主要分类方式,根据网络中信息流动的方向和结构,将神经网络分成了三类,并给出了各自的代表模型和应用领域。
1. 前馈神经网络 (Feedforward Neural Networks)
-
结构特点: 信息从输入层单向、逐层向前流动到输出层,没有环路或反馈连接。
-
示意图: 输入→Net→⋯→Net→输出输入 \rightarrow Net \rightarrow \dots \rightarrow Net \rightarrow 输出输入→Net→⋯→Net→输出
-
代表模型:
-
多层感知机 (MLP)
-
卷积神经网络 (CNN)
-
2. 反馈神经网络 (Recurrent Neural Networks, RNN)
-
结构特点: 网络中包含循环或反馈连接。当前时刻的输出或隐藏层状态会作为下一时刻的输入,使网络具有记忆能力,适合处理序列数据。
-
示意图: 包含一个
hidenNet(隐藏层状态)向mainNet(主网络)的反馈循环。 -
代表模型:
-
循环神经网络 (RNN)
-
长短期记忆网络 (LSTM)
-
Hopfield 网络
-
玻尔兹曼机
-
3. 图网络 (Graph Neural Networks, GNN)
-
结构特点: 直接在图结构数据上进行操作,图中的节点(Node)和边(Edge)代表实体及其关系。
-
示意图: 一个由节点和边连接而成的网络图。
-
应用领域:
-
知识图谱
-
社交网络
-
城市交通
-
总结: 该图清晰地总结了前馈、反馈和图网络这三种基本的神经网络类型及其核心代表模型和适用范围,它们是深度学习领域的主要结构范式。
序列数据处理任务
列举了自然语言处理 (NLP)、语音识别和股市预测这三个领域及其具体的应用示例,这些都是人工智能和深度学习技术的重要应用方向。
1. 自然语言处理 (NLP)
自然语言处理(NLP)旨在让计算机理解、解释和生成人类语言。图片中展示了三个子任务:
-
(单词预测): 计算机根据上下文预测下一个合适的词,例如在“人之初,性本善,性相**(近)**,习相远”中预测“近”。
-
翻译: 将一种语言自动翻译成另一种语言,例如将“我在学人工智能”翻译成 “I’m learning artificial intelligence”。
-
语义理解: 计算机理解句子的真实含义,尤其是存在歧义时。
-
示例: “我的手机昨天丢了,你能帮我买128G的苹果吗?”
-
这里的关键是理解“苹果”不是指水果,而是指**“苹果手机(iPhone)”**,并且与“128G”的容量单位相关。
-
2. 语音识别 (Voice Recognition)
-
定义/目标: 将人类的语音信号转换成可识别的文本。
-
配图: 一张带有“voice recognition”文字和声波图的图像,直观地代表了语音信号处理的过程。
3. 股市预测 (Stock Market Prediction)
-
目标: 利用历史数据、新闻、社交媒体等信息,通过机器学习模型预测股票价格或市场趋势。
-
配图: 一张显示金融图表和K线图(红色和绿色)的图像,背景是二进制数据流,代表了利用数据分析进行金融预测的场景。
总结: 图片概括了人工智能在人机交互(NLP和语音) 以及数据分析和决策(股市预测) 这两大核心应用方向上的具体任务和挑战。
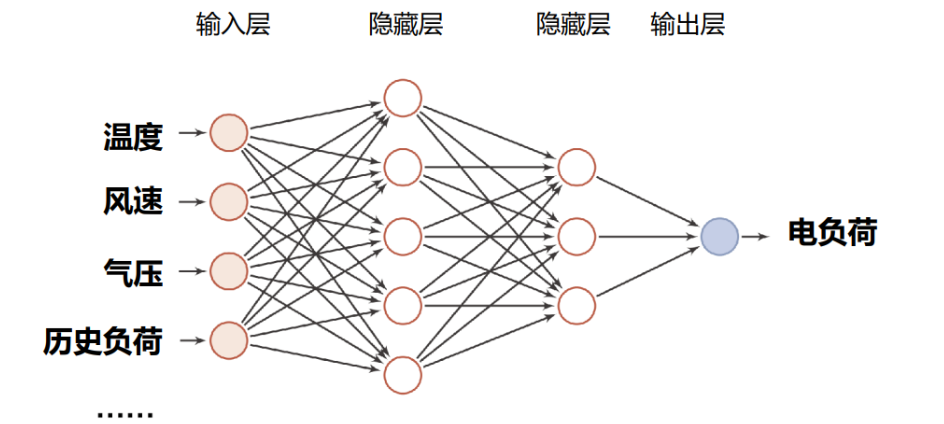
多层感知机(以建筑用电负荷为例)
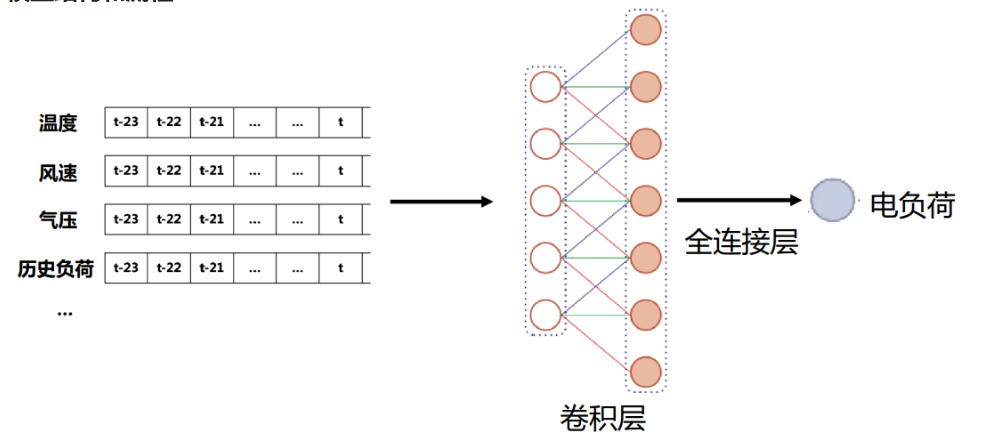
卷积神经网络(以建筑用电负荷为例)
一个基于卷积神经网络(CNN)的时间序列预测模型的简化结构,其目的是预测电负荷(Electric Load)。
模型结构和流程
-
输入数据(左侧):
-
模型接收多种时间序列数据作为输入。
-
每一行代表一个特征维度,例如:
-
温度
-
风速
-
气压
-
历史负荷
-
… (可能还有其他特征)
-
-
数据是以时间窗的形式输入的,例如从 t−23t-23t−23 时刻到 ttt 时刻的连续历史数据。
-
-
特征提取层(中间):
- 卷积层: 接收输入数据。在时间序列分析中,卷积操作通常用于捕捉不同特征维度在局部时间窗口内的相关性和时序特征。图中展示了输入节点(白色的圆圈)到卷积层节点(棕色的圆圈)的局部连接(不同颜色的线代表权重)。
-
预测层(右侧):
-
全连接层: 接收卷积层提取的特征。全连接层负责将这些抽象特征映射到最终的预测值。
-
输出: 最终预测的目标是电负荷。
-
总结
该图描述了一个利用 CNN 进行短期或中期时间序列预测的系统。它通过以下方式工作:
-
输入多维特征: 结合了天气数据(温度、风速、气压)和自身历史数据(历史负荷)。
-
使用卷积层: 利用 CNN 强大的局部特征提取能力,捕捉多变量时间序列中时间和特征之间的局部依赖关系。
-
使用全连接层: 将提取的特征整合,最终回归或分类出未来时刻的电负荷。
这种模型在电力系统、交通流量预测等需要考虑多维时序特征的领域非常常见。
RNN的结构
介绍了循环神经网络 (Recurrent Neural Network, RNN) 的定义、核心思想及其基本结构和工作方式。
1. 定义和核心思想
-
循环神经网络 (RNN): 是一种特殊类型的反馈神经网络,专门用于处理序列数据。
-
核心思想:
-
利用循环结构(即反馈连接)。
-
网络能捕捉和利用序列中的顺序依赖性信息(即前后的关联)。
-
2. RNN 的基本单元和工作方式
-
基本单元: RNN 的基本单元是一个具有循环连接的神经网络层。这种循环连接允许网络在处理每个时间步的数据时,能利用之前时间步的信息(即具有“记忆”功能)。
-
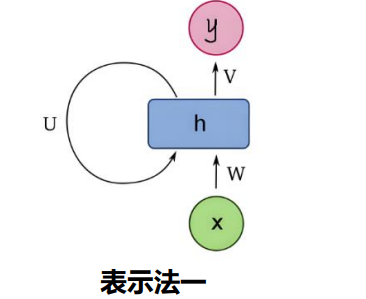
表示法 (左侧图示):
-
xxx (绿色圆圈) 代表输入。
-
hhh (蓝色方框) 代表内部状态/隐藏状态。
-
yyy (粉色圆圈) 代表输出。
-
U,W,VU, W, VU,W,V 代表连接不同部分(输入、隐藏状态、输出)的权重矩阵。
-
循环箭头:表示 hhh 的值会反馈给自身,在下一个时间步作为输入的一部分。
-
-
-
具体工作流程:
-
RNN 在每个时间步都会接收一个输入 (xtx_txt)。
-
同时产生一个输出 (yty_tyt)。
-
其内部状态(隐藏状态 hth_tht) 会被更新并传递到下一个时间步 (ht+1h_{t+1}ht+1)。
-
总结: RNN 是一种通过自身循环连接实现对序列数据中时序依赖关系进行建模的神经网络,使其适用于语言、语音等需要考虑上下文信息的任务。
RNN发展简史
列出了循环神经网络(RNN) 发展历程中的几个重要的里程碑和关键人物:
-
1933年 (Rafael Lorenre de No, 西班牙神经生物学家):
-
发现大脑皮层的解剖结构允许刺激在神经回路中循环传递。
-
提出回荡回路假说。
-
-
1982年 (John Hopfield, 美国学者):
- 建立了具有结合存储能力的神经网络,即Hopfield网络。
-
1986年 (Michael I. Jordan):
- 基于 Hopfield 网络建立了新的循环神经网络,即Jordan网络。
-
1990年 (Jeffrey Elman):
- 提出了第一个全连接的循环神经网络,通常称为简单循环神经网络 (SRN)。
-
1990年 (Paul Werbos):
- 提出了循环神经网络的随时间反向传播算法 (BPTT),这是训练 RNN 的关键算法。
-
1991年 (Sepp Hochreiter):
-
发现了循环神经网络的长期依赖问题,并引入了大量优化。
-
由此产生了后续一系列解决长期依赖问题的模型,包括:
-
神经历史压缩器 (NHC)
-
长短期记忆网络 (LSTM)
-
门控循环单元 (GRU)
-
回声状态网络 (ESN)
-
独立循环神经网络 (indRNN) 等。
-
-
总结: 该图清晰地展示了从生物学假说(1933年)到早期模型(Hopfield, Jordan, SRN)再到训练算法(BPTT),最后到解决核心问题(长期依赖)并诞生现代高效模型(LSTM, GRU)的RNN技术演进脉络。
从前馈神经网络到RNN
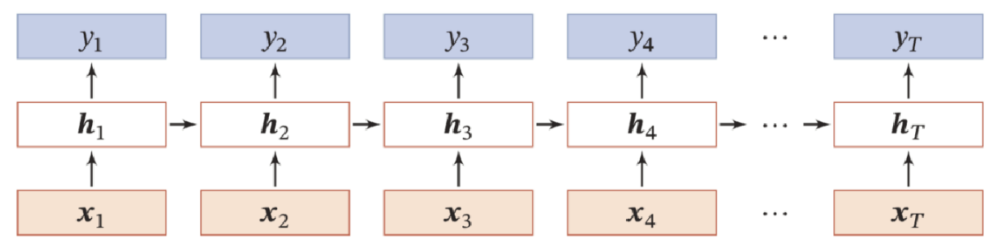
RNN的三种表示
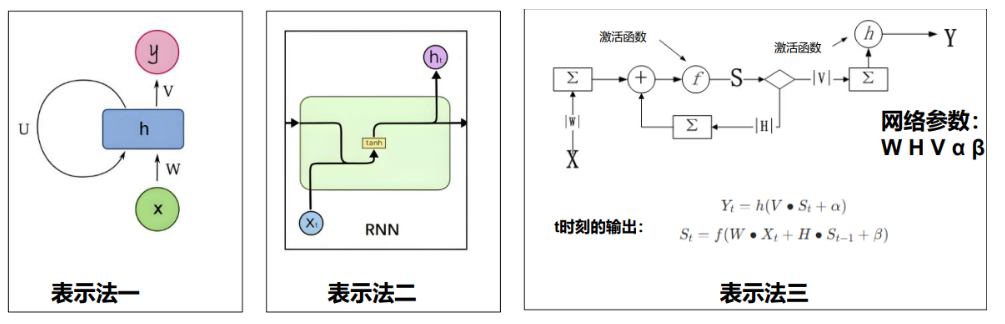
展示了循环神经网络(RNN) 的三种不同表示方法,它们都是用来描述 RNN 在处理序列数据时如何在时间维度上传递信息的。
1. 表示法一:简洁图示 (左侧)
-
这是一个最简洁的 RNN 单元图。
-
xxx (绿色圆圈): 当前时间步的输入。
-
hhh (蓝色方框): 当前时间步的隐藏状态(或内部状态)。
-
yyy (粉色圆圈): 当前时间步的输出。
-
循环箭头: 表示隐藏状态 hhh 会被反馈给自己,作为下一时间步的输入的一部分,体现了 RNN 的循环结构和记忆功能。
-
U,W,VU, W, VU,W,V: 代表输入到隐藏层、隐藏层到隐藏层、隐藏层到输出层的权重矩阵。
2. 表示法二:展开图示 (中间)
-
这是一个时间步内的 RNN 单元结构图,展示了信息是如何在单元内部流动的。
-
XtX_tXt: 当前时间步的输入。
-
ht−1h_{t-1}ht−1: 来自上一个时间步的隐藏状态。
-
hth_tht: 当前时间步计算出的新的隐藏状态。
-
核心计算: 隐藏状态的更新通常涉及一个激活函数 (如 tanh),将当前输入和前一隐藏状态的加权和进行非线性转换。
-
图中的箭头清晰地展示了 XtX_tXt 和 ht−1h_{t-1}ht−1 进入 RNN 框体,经过计算后产生新的 hth_tht 并作为下一时间步的输入。
3. 表示法三:详细计算流程和公式 (右侧)
-
这是一个计算图,展示了 RNN 内部的详细数学运算。
-
计算流程:
-
隐藏状态 StS_tSt 的计算: 包含输入 XXX 的加权和 (Σ∣W∣X\Sigma |W| XΣ∣W∣X)、上一个隐藏状态 HHH 的加权和 (Σ∣H∣St−1\Sigma |H| S_{t-1}Σ∣H∣St−1) 以及偏置 β\betaβ,然后经过激活函数 fff 得到 StS_tSt。
-
输出 YtY_tYt 的计算: 将隐藏状态 StS_tSt 的加权和 (Σ∣V∣St\Sigma |V| S_tΣ∣V∣St) 加上偏置 α\alphaα,然后经过激活函数 hhh 得到 YtY_tYt。
-
-
t 时刻的输出公式:
-
Yt=h(V∙St+α)Y_t = h(V \bullet S_t + \alpha)Yt=h(V∙St+α)
-
St=f(W∙Xt+H∙St−1+β)S_t = f(W \bullet X_t + H \bullet S_{t-1} + \beta)St=f(W∙Xt+H∙St−1+β)
-
其中,St−1S_{t-1}St−1 是上一个时间步的隐藏状态,XtX_tXt 是当前输入。
-
-
网络参数:
-
WWW:输入到隐藏层的权重。
-
HHH:隐藏层到隐藏层的循环权重(在表示法一中是 WWW 或 UUU 的一部分)。
-
VVV:隐藏层到输出层的权重。
-
α\alphaα 和 β\betaβ:偏置项。
-
总结: 这三种表示法从宏观到微观、从概念到数学,全面地描述了一个基本 RNN 单元的工作原理,即它如何通过循环连接将当前输入与历史信息(St−1S_{t-1}St−1)结合起来,计算出新的状态和当前输出。
RNN按序列展开
RNN分类
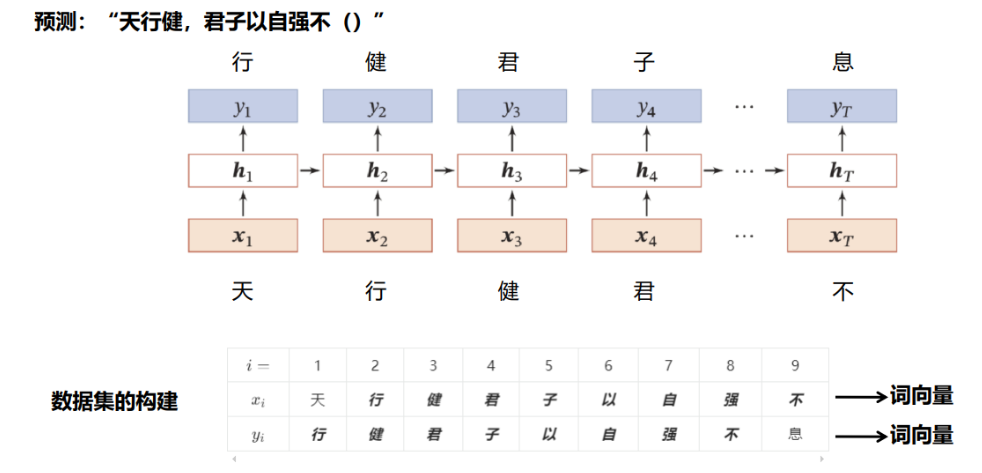
根据输入(Input)和输出(Output)序列的长度和对应关系,对循环神经网络(RNN) 的应用场景进行了分类,这是理解序列模型(如RNN/LSTM/GRU)如何解决不同任务的关键。
主要分为五种模式:
1. 一对一 (One to One)
-
结构特点: 1个输入对应1个输出。
-
主要应用: 传统的神经网络任务。
-
图像去噪
-
数据加密
-
2. 一对多 (One to Many)
-
结构特点: 1个输入对应多个输出(序列)。
-
主要应用: 序列生成任务。
-
关键词
-
写作
-
拼写纠正
-
3. 多对一 (Many to One)
-
结构特点: 多个输入(序列)对应1个输出。
-
主要应用: 序列分类/总结任务。
-
语境情感分析
-
垃圾邮件识别
-
股票涨跌判断
-
关键词提取
-
4. 同步多对多 (Many to Many - Synchronous)
-
结构特点: 输入和输出序列长度相同,且一一对应(常用于序列标注)。
-
配图下方示例:
-
命名实体识别: “我爱/北京/天安门” → “主语/谓语/定语/宾语”
-
词性标注: “我爱/北京/天安门” → “名词/动词/名词/名词”
-
-
主要应用:
-
命名实体识别
-
词性标注
-
5. 异步多对多 (Many to Many - Asynchronous)
-
结构特点: 多个输入(序列)对应多个输出(序列),但输入和输出序列的长度不一定相同(常用于编码器-解码器结构,Encoder-Decoder)。
-
主要应用: 序列转换任务。
-
语句预测
-
机器翻译 (Machine Translation)
-
文本摘要
-
聊天机器人
-
语音识别
-
股票走势预测
-
总结: 该图清晰地展示了RNN如何通过其灵活的结构来解决不同类型的序列任务,是理解序列模型应用领域的一个核心框架。
例题
了一个多对多同步 RNN(循环神经网络) 的基本逻辑结构图和一个具体的计算示例(例 10-1)。
一、基本逻辑结构(右侧图)
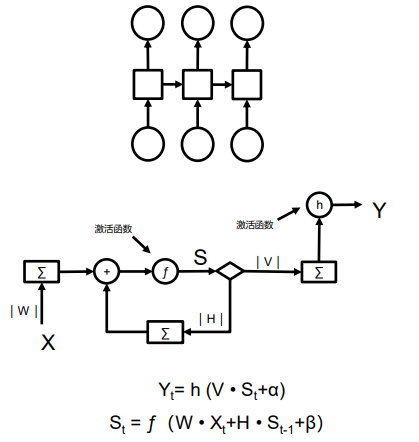
右侧的图示展示了两种形式的 RNN 结构:
-
顶部:序列结构图
-
这是一个多对多同步结构,输入序列的每个元素对应一个输出元素。
-
底部圆圈: 输入 XXX。
-
中间方框: RNN 的隐藏层/单元。
-
顶部圆圈: 输出 YYY。
-
箭头表示信息流在时间维度上的传递。
-
-
底部:计算流程图与公式
-
这是一个 RNN 单元在单个时间步 ttt 上的详细计算流程。
-
隐藏状态 StS_tSt 的计算: St=f(W⋅Xt+H⋅St−1+β)S_t = f(W \cdot X_t + H \cdot S_{t-1} + \beta)St=f(W⋅Xt+H⋅St−1+β)
- 它由当前输入 XtX_tXt 和上一个时间步的隐藏状态 St−1S_{t-1}St−1 共同决定,经过权重 WWW 和 HHH 加权求和,加上偏置 β\betaβ,最后通过激活函数 fff 得到。
-
输出 YtY_tYt 的计算: Yt=h(V⋅St+α)Y_t = h(V \cdot S_t + \alpha)Yt=h(V⋅St+α)
- 它由当前隐藏状态 StS_tSt 决定,经过权重 VVV 加权求和,加上偏置 α\alphaα,最后通过激活函数 hhh 得到。
-
二、计算示例(例 10-1)
该示例演示了如何利用给定的参数和公式,计算 RNN 的输出序列 YYY。
已知条件:
-
网络结构: 输入层、隐藏层(一层)、输出层的神经元均为一个。
-
激活函数: ReLU(x)=max(0,x)ReLU(x) = \max(0, x)ReLU(x)=max(0,x) (在 x≥0x \ge 0x≥0 时 ReLU(x)=xReL U(x)=xReLU(x)=x)。
-
权重参数:
-
W=[0.5,0.1,0.2]W = [0.5, 0.1, 0.2]W=[0.5,0.1,0.2] (输入 XXX 到隐藏层的权重)
-
H=[1]H = [1]H=[1] (隐藏层到隐藏层的循环权重)
-
V=[3]V = [3]V=[3] (隐藏层到输出层的权重)
-
-
初始状态/偏置:
-
S0=0S_0 = 0S0=0 (初始隐藏状态)
-
α=0\alpha = 0α=0 (输出层偏置)
-
β=0\beta = 0β=0 (隐藏层偏置)
-
-
输入序列 XXX:
-
X1=[1,1,1]X_1 = [1, 1, 1]X1=[1,1,1]
-
X2=[2,2,2]X_2 = [2, 2, 2]X2=[2,2,2]
-
X3=[3,3,3]X_3 = [3, 3, 3]X3=[3,3,3]
-
计算步骤: (由于 α=0,β=0\alpha=0, \beta=0α=0,β=0,且激活函数 ReLU(x)=xReLU(x)=xReLU(x)=x 当 x≥0x \ge 0x≥0 时,公式简化为 St=W⋅Xt+H⋅St−1S_t = W \cdot X_t + H \cdot S_{t-1}St=W⋅Xt+H⋅St−1 和 Yt=V⋅StY_t = V \cdot S_tYt=V⋅St)
1. t=1t=1t=1 时刻:
-
隐藏状态 S1S_1S1:
S1=W⋅X1T+H⋅S0S_1 = W \cdot X_1^T + H \cdot S_0S1=W⋅X1T+H⋅S0
S1=([0.5,0.1,0.2]⋅[1,1,1]T)+(1⋅0)S_1 = ([0.5, 0.1, 0.2] \cdot [1, 1, 1]^T) + (1 \cdot 0)S1=([0.5,0.1,0.2]⋅[1,1,1]T)+(1⋅0)
S1=(0.5×1+0.1×1+0.2×1)+0S_1 = (0.5 \times 1 + 0.1 \times 1 + 0.2 \times 1) + 0S1=(0.5×1+0.1×1+0.2×1)+0
S1=0.8S_1 = 0.8S1=0.8
(图示计算: f(0.8)=0.8f(0.8) = 0.8f(0.8)=0.8)
-
输出 Y1Y_1Y1:
Y1=V⋅S1Y_1 = V \cdot S_1Y1=V⋅S1
Y1=3⋅0.8Y_1 = 3 \cdot 0.8Y1=3⋅0.8
Y1=2.4Y_1 = 2.4Y1=2.4
2. t=2t=2t=2 时刻:
-
隐藏状态 S2S_2S2:
S2=W⋅X2T+H⋅S1S_2 = W \cdot X_2^T + H \cdot S_1S2=W⋅X2T+H⋅S1
S2=([0.5,0.1,0.2]⋅[2,2,2]T)+(1⋅0.8)S_2 = ([0.5, 0.1, 0.2] \cdot [2, 2, 2]^T) + (1 \cdot 0.8)S2=([0.5,0.1,0.2]⋅[2,2,2]T)+(1⋅0.8)
S2=(0.5×2+0.1×2+0.2×2)+0.8S_2 = (0.5 \times 2 + 0.1 \times 2 + 0.2 \times 2) + 0.8S2=(0.5×2+0.1×2+0.2×2)+0.8
S2=(1.0+0.2+0.4)+0.8S_2 = (1.0 + 0.2 + 0.4) + 0.8S2=(1.0+0.2+0.4)+0.8
S2=1.6+0.8=2.4S_2 = 1.6 + 0.8 = 2.4S2=1.6+0.8=2.4
(图示计算: f(1.6+0.8)=2.4f(1.6 + 0.8) = 2.4f(1.6+0.8)=2.4)
-
输出 Y2Y_2Y2:
Y2=V⋅S2Y_2 = V \cdot S_2Y2=V⋅S2
Y2=3⋅2.4Y_2 = 3 \cdot 2.4Y2=3⋅2.4
Y2=7.2Y_2 = 7.2Y2=7.2
3. t=3t=3t=3 时刻:
-
隐藏状态 S3S_3S3:
S3=W⋅X3T+H⋅S2S_3 = W \cdot X_3^T + H \cdot S_2S3=W⋅X3T+H⋅S2
S3=([0.5,0.1,0.2]⋅[3,3,3]T)+(1⋅2.4)S_3 = ([0.5, 0.1, 0.2] \cdot [3, 3, 3]^T) + (1 \cdot 2.4)S3=([0.5,0.1,0.2]⋅[3,3,3]T)+(1⋅2.4)
S3=(0.5×3+0.1×3+0.2×3)+2.4S_3 = (0.5 \times 3 + 0.1 \times 3 + 0.2 \times 3) + 2.4S3=(0.5×3+0.1×3+0.2×3)+2.4
S3=(1.5+0.3+0.6)+2.4S_3 = (1.5 + 0.3 + 0.6) + 2.4S3=(1.5+0.3+0.6)+2.4
S3=2.4+2.4=4.8S_3 = 2.4 + 2.4 = 4.8S3=2.4+2.4=4.8
(图示计算: f(2.4+2.4)=4.8f(2.4 + 2.4) = 4.8f(2.4+2.4)=4.8)
-
输出 Y3Y_3Y3:
Y3=V⋅S3Y_3 = V \cdot S_3Y3=V⋅S3
Y3=3⋅4.8Y_3 = 3 \cdot 4.8Y3=3⋅4.8
Y3=14.4Y_3 = 14.4Y3=14.4
结论:
- 输出序列 YYY 为 [2.4,7.2,14.4][2.4, 7.2, 14.4][2.4,7.2,14.4]。
9.2 长短期记忆网络(LSTM)
LSTM的结构
这幅图片主要介绍了循环神经网络(RNN) 的长期依赖问题以及为解决该问题而设计的长短期记忆网络(LSTM)。
1. RNN 的问题
-
问题: 无法学习太长的序列。
-
形象描述: “很快忘记前面说过的话”(即长期依赖问题或梯度消失问题)。
2. 长短期记忆网络 (LSTM)
-
全称: Long Short-Term Memory。
-
作用: 专门设计用于解决长期依赖的问题。
3. LSTM 的结构和核心机制
图片展示了 LSTM 按时间展开示意图,重点在于中间被称为“黑箱 A”的单元的内部结构,这个结构取代了标准 RNN 的单一激活函数层。
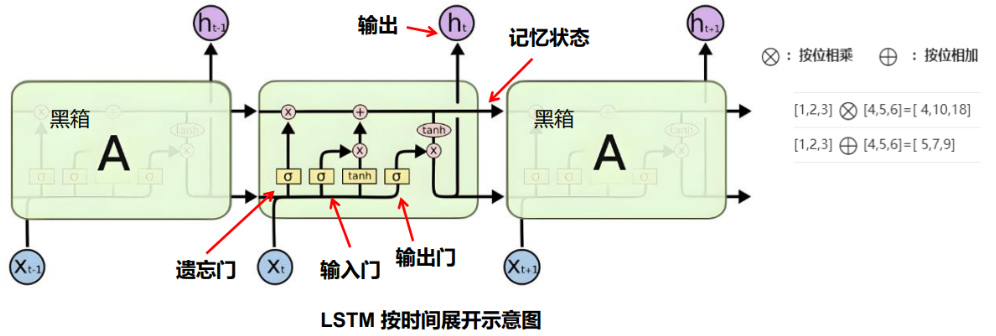
核心组成部分(门的结构):
-
遗忘门(Forget Gate, ftf_tft): 决定上一时刻的记忆状态(Cell State, Ct−1C_{t-1}Ct−1) 有多少应该被保留或“遗忘”。它接收当前输入 XtX_tXt 和上一时刻隐藏状态 ht−1h_{t-1}ht−1,并输出一个 0 到 1 之间的值(通过 σ\sigmaσ 激活函数)。
-
输入门(Input Gate, iti_tit)和新的候选记忆(C~t\tilde{C}_tC~t):
-
输入门: 决定当前时刻的输入 XtX_tXt 有多少应该被加入到新的记忆状态中。
-
tanh\tanhtanh 单元: 产生一个新的候选记忆 C~t\tilde{C}_tC~t,它包含了当前输入的信息。
-
-
记忆状态(Cell State, CtC_tCt): 是 LSTM 的核心,它是一条贯穿整个序列的**“高速公路”**。
- 它通过遗忘门和输入门来更新:上一时刻的记忆 Ct−1C_{t-1}Ct−1 被遗忘门部分遗忘,同时新的候选记忆 C~t\tilde{C}_tC~t 被输入门部分加入,从而形成新的记忆状态 CtC_tCt。
-
输出门(Output Gate, oto_tot): 决定当前的记忆状态 CtC_tCt 有多少应该被用于计算当前时刻的输出(隐藏状态 hth_tht)。
关键符号说明:
-
XtX_tXt:当前时间步的输入。
-
hth_tht:当前时间步的输出(同时也是下一时间步的隐藏状态)。
-
σ\sigmaσ:Sigmoid 激活函数,输出 0 到 1 之间的值,用于“门”的控制(忘记或通过多少信息)。
-
tanh\tanhtanh:双曲正切激活函数,用于生成候选记忆 C~t\tilde{C}_tC~t。
-
按位相乘(⊗\otimes⊗): 用于门控机制,将 0 到 1 之间的门值应用于数据,实现选择性地遗忘或保留。
-
按位相加(⊕\oplus⊕): 用于更新记忆状态,将信息进行叠加。
总结: LSTM 通过引入门结构(遗忘门、输入门、输出门) 和记忆状态(Cell State) 这条独立的通路,精确地控制信息的流入、流出和在时间上的保留,从而有效地解决了标准 RNN 中信息衰减过快的问题,实现了对长期依赖关系的建模。
LSTM的算法过程
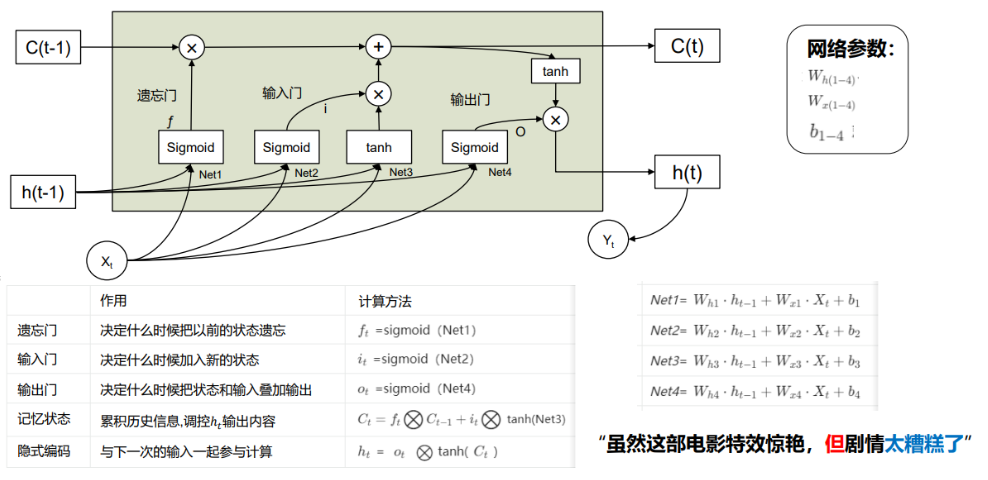
LSTM的局限及变种RNN
总结了LSTM(长短期记忆网络)的局限性,并介绍了两种为解决 RNN/LSTM 局限或增强其能力而提出的改进模型:GRU 和双向/深度 RNN。
1. LSTM 的局限
尽管 LSTM 解决了标准 RNN 的长期依赖问题,但它仍存在以下局限:
-
计算复杂: LSTM 单元内部有多个门控结构和计算步骤,导致其计算复杂度高。
-
顺序处理,无法进行并行化计算: RNN/LSTM 的本质是按时间步依次处理序列,后一个时间步的计算依赖于前一个时间步的结果,这限制了在现代硬件(如 GPU)上的并行计算能力。
-
计算慢,实时响应难: 由于计算复杂且难以并行化,导致整体计算速度较慢,难以满足对实时响应要求高的场景。
2. 改进模型/增强结构
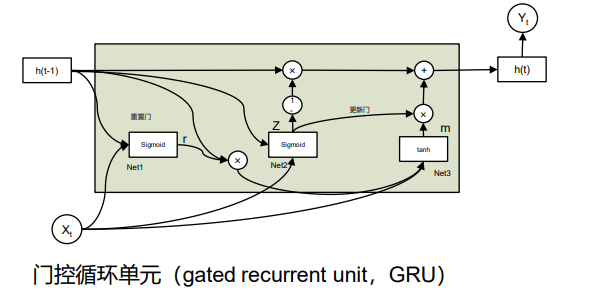
A. 门控循环单元 (Gated Recurrent Unit, GRU)
-
定义: 门控循环单元(gated recurrent unit, GRU)。
-
特点: GRU 是 LSTM 的一个简化版本。它将 LSTM 的遗忘门和输入门合并为一个更新门,同时将记忆状态(Cell State)和隐藏状态(Hidden State)合并。
-
结构图(左下): 相比于 LSTM 的三个门,GRU 只有两个门(更新门和重置门),结构更紧凑,参数更少,因此计算速度更快,同时在许多任务上能达到与 LSTM 相当的性能。
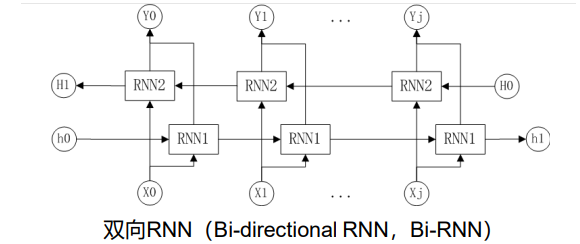
B. 双向 RNN (Bi-directional RNN, Bi-RNN)
-
结构图(右上): 序列数据 X0,X1,X2,…X_0, X_1, X_2, \dotsX0,X1,X2,… 不仅通过一个正向 RNN(RNN1) 从左向右处理,还通过一个**反向 RNN(RNN2)**从右向左处理。
-
特点: 允许网络在计算某一时刻的隐藏状态(或输出)时,同时利用到该时刻之前和之后的所有信息(即整个序列的上下文),从而提高对序列的理解能力。
C. 深度循环神经网络 (Deep Recurrent Neural Network)
-
结构图(右下): 沿着空间/垂直维度堆叠了多个 RNN 层(RNN1, RNN2, …\dots…)。
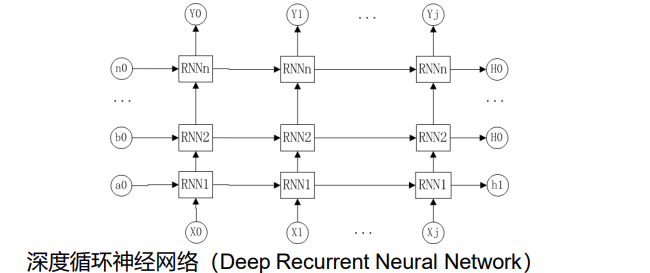
-
特点: 类似于深度前馈网络,通过增加网络层数来增强模型的抽象特征提取能力和非线性建模能力,以处理更复杂的序列任务。
总结: 该图展示了深度学习社区在 RNN 领域针对计算效率和模型性能所做出的努力:通过 GRU 简化结构提高效率;通过 Bi-RNN 捕捉双向上下文;通过深度 RNN 增强特征提取能力。
9.3 股票走势预测
程序流程图
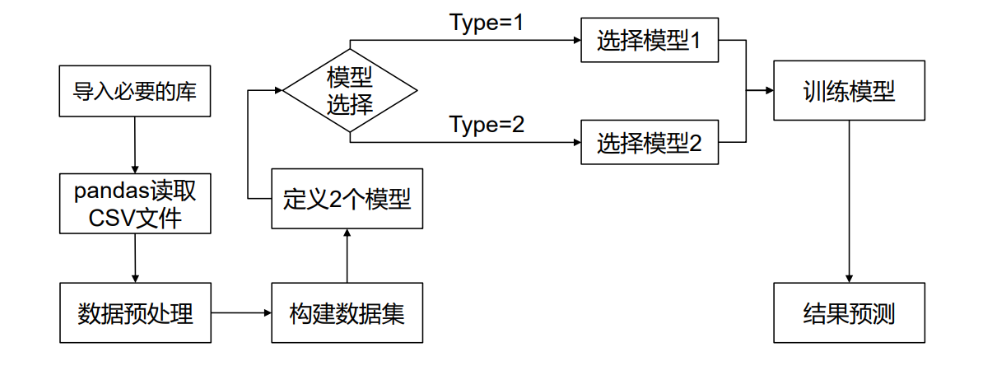
模型参数设计及训练
使用 LSTM 模型进行时间序列预测(例如股票或负荷预测)的典型步骤和流程。
整个流程从数据准备到模型预测,可以概括为以下七个主要阶段:
| 阶段 | 核心任务 | 关键技术/概念 |
|---|---|---|
| 1. 读取数据 | 读取原始数据并进行初步处理。 | 使用 pandas.read_csv() 读取 CSV 数据;进行数据清洗。 |
| 2. 构造数据集 | 确定模型的输入特征(X)和预测目标(Y)。 | 选取特征值,例如: - XXX(特征):PRE_CLOSE(前收盘价) - YYY(目标):CLOSE(收盘价) |
| 3. 数据预处理 | 对数据进行转换,使其适应神经网络训练。 | 数据标准化(归一化);生成时间序列数据(将序列数据转换为模型可接受的样本格式),例如使用 TimeseriesGenerator()。 |
| 4. 定义2个模型 | 构建并设计用于比较和选择的候选模型。 | 设计2个或多个不同拓扑结构的 LSTM 网络(以比较预测效果)。 可调整的超参数包括: 深度、神经元个数、激活函数、dropout、优化器、损失函数、评价指标等。 |
| 5. 模型选择 | 确定最终用于训练和预测的模型。 | 根据输入的参数类型(Type)选择不同的模型结构。 |
| 6. 训练模型 | 使用准备好的数据对模型进行拟合。 | 指定训练轮次(epochs)、批次大小(batch size)、**验证集(validation set)等参数。 |
| 7. 结果预测 | 使用训练好的模型对未来数据进行预测。 | 指定某一序列作为输入,输出预测结果**。 |
总结: 该流程图提供了一个结构化的框架,用于指导基于 LSTM 的时间序列预测项目的实施,涵盖了从数据输入到最终输出的全部关键环节。
展示了两个使用 Python 编写的函数 model1() 和 model2(),它们用于定义基于 LSTM (长短期记忆网络) 的深度学习模型。
以下是对这两段代码的详细注解:
1. model1() 函数注解
这个函数定义了一个三层深度的单向 LSTM 网络,用于进行回归预测。
def model1():
    # 使用 SequentialCell 定义一个按顺序堆叠层的模型容器
    model = nn.SequentialCell([

        # --- 第一层 LSTM ---
        # input_size=1: 输入特征维度为1(例如,时间序列中的单个值)
        # hidden_size=128: 隐藏状态/记忆单元维度为128
        # num_layers=1: LSTM层数为1
        # has_bias=True: 使用偏置项
        # dropout=0.5: 在训练中应用0.5的Dropout,防止过拟合
        # bidirectional=False: 单向LSTM
        nn.LSTM(input_size=1, hidden_size=128, num_layers=1,
                has_bias=True, dropout=0.5, bidirectional=False),

        # --- 第二层 LSTM ---
        # input_size=128: 上一层LSTM的输出维度(hidden_size)
        # hidden_size=64: 隐藏状态/记忆单元维度为64
        # num_layers=1, has_bias=True, bidirectional=False: 同上
        # dropout=0.5: 在训练中应用0.5的Dropout
        nn.LSTM(input_size=128, hidden_size=64, num_layers=1,
                has_bias=True, dropout=0.5, bidirectional=False),

        # --- 第三层 LSTM ---
        # input_size=64: 上一层LSTM的输出维度
        # hidden_size=1: 隐藏状态/记忆单元维度为1
        # num_layers=1, has_bias=True, bidirectional=False: 同上
        # dropout=0.5: 在训练中应用0.5的Dropout
        nn.LSTM(input_size=64, hidden_size=1, num_layers=1,
                has_bias=True, dropout=0.5, bidirectional=False),

        # --- 输出层 (全连接层) ---
        # nn.Dense(1, 1):
        #   第一个参数1是输入维度(来自最后一层LSTM的hidden_size=1)
        #   第二个参数1是输出维度(最终预测的单个值)
        nn.Dense(1, 1)
    ])

    # 定义损失函数:均方误差(Mean Squared Error),常用于回归任务
    loss_fn = nn.MSELoss()

    # 定义优化器:Adam 优化器,学习率为 0.001
    optimizer = nn.Adam(model.trainable_params(), learning_rate=0.001)

    # 返回模型、损失函数和优化器
    return model, loss_fn, optimizer
2. model2() 函数注解
这个函数定义了一个单层深度的单向 LSTM 网络,用于进行回归预测。
def model2():
    # 使用 SequentialCell 定义一个按顺序堆叠层的模型容器
    model = nn.SequentialCell([

        # --- 第一层 LSTM ---
        # input_size=1: 输入特征维度为1
        # hidden_size=50: 隐藏状态/记忆单元维度为50
        # num_layers=1: LSTM层数为1
        # has_bias=True: 使用偏置项
        # dropout=0.0: 不使用Dropout
        # bidirectional=False: 单向LSTM
        nn.LSTM(input_size=1, hidden_size=50, num_layers=1,
                has_bias=True, dropout=0.0, bidirectional=False),

        # --- 输出层 (全连接层) ---
        # nn.Dense(50, 1):
        #   第一个参数50是输入维度(来自LSTM的hidden_size=50)
        #   第二个参数1是输出维度(最终预测的单个值)
        nn.Dense(50, 1)
    ])

    # 定义损失函数:均方误差(Mean Squared Error)
    loss_fn = nn.MSELoss()

    # 定义优化器:Adam 优化器,学习率为 0.001
    optimizer = nn.Adam(model.trainable_params(), learning_rate=0.001)

    # 返回模型、损失函数和优化器
    return model, loss_fn, optimizer
3. 模型对比总结
-
model1是一个深层(3层) 的 LSTM 模型,使用了 Dropout (0.5) 来进行正则化,隐藏层尺寸依次为 128→64→1128 \to 64 \to 1128→64→1。 -
model2是一个浅层(1层) 的 LSTM 模型,未设置 Dropout,隐藏层尺寸为 505050。
这两个模型设计上的差异(深度、宽度、正则化)是为了在时间序列预测任务中比较不同网络拓扑结构的性能。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)