【篇三】Linux进程控制
文章目录
一、进程退出
之前我们学习了如何创建进程 —— 通过 fork 等机制为程序分配 CPU、内存等资源,让程序能以 “多任务协作” 的方式运行起来,去处理计算、IO 等各类任务。而进程运行时会持续占用系统资源,若没有 “退出”,完成任务的进程会一直 “霸占” 资源,导致系统资源逐渐枯竭,新任务无法获得资源支持;同时fork创建的子进程若出现本身错误, 如内存越界等原因也要告知我们父进程自己最终状态, 是任务成功了,还是哪里出了问题。这样系统才能及时回收资源、根据错误状态开展后序任务。
说白了,进程退出就像 “用完工具要归位、做完事要反馈结果”,是保障系统资源循环利用、程序间有序协作的关键环节。
1.1进程退出场景
- 代码运行完毕,结果正确: 程序按预期执行完所有逻辑(如计算任务完成、文件处理结束),是最理想的退出状态。
- 代码运行完毕,结果不正确: 程序执行流程完整,但因逻辑错误(如算法 Bug、输入处理不当)导致结果不符合预期。
- 代码异常终止: 程序执行中遭遇意外(如段错误、被信号强制终止),未完成正常流程就被迫停止。
1.2 退出码
从 main 函数返回:main 执行 return n; 时,进程会以状态码 n 退出,状态码0, 我们认为是正常退出
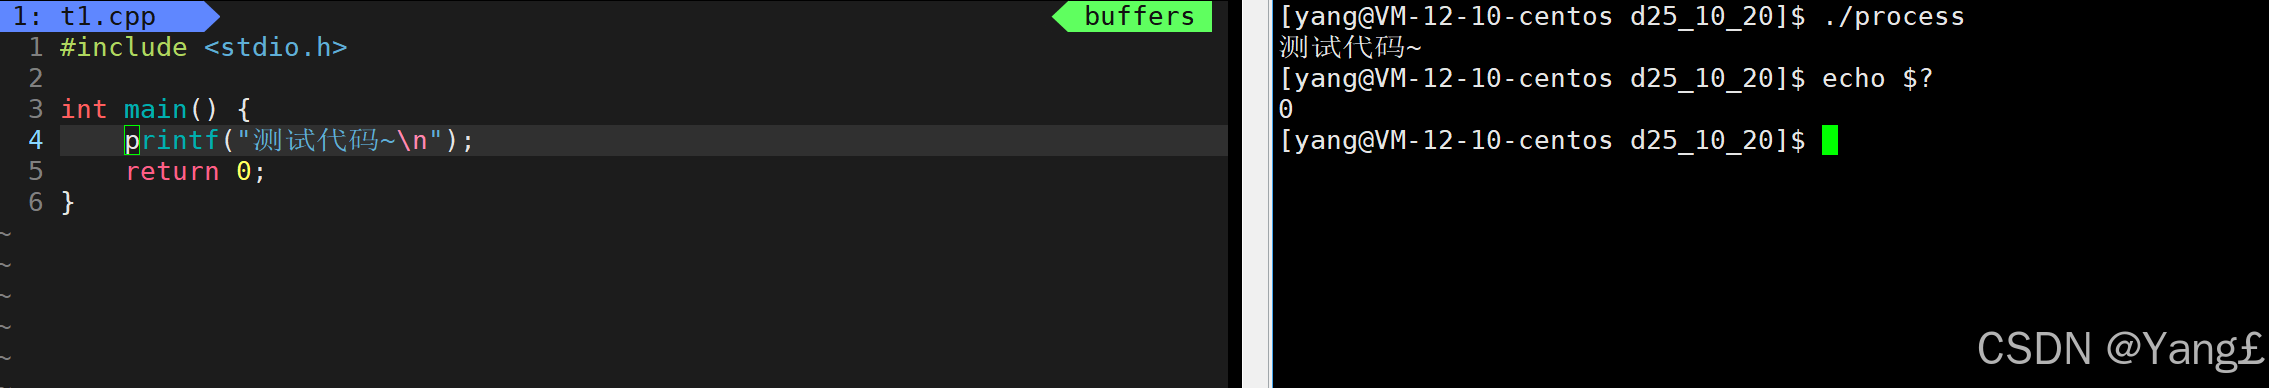
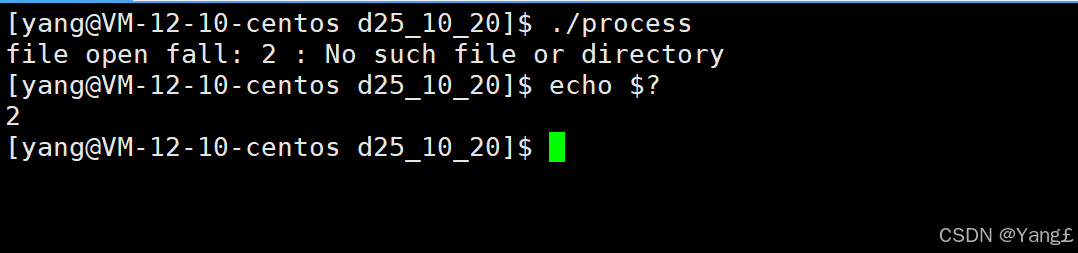
通过 echo $? 可以查看上一个进程的退出码
echo $?
其中,main 函数的返回值, 本质表示,进程运行完成时是否是正确的结果, 可以用不同的数字表示不同的出错原因(0代表正常退出, 非0代表程序运行错误) —— 退出码, 让我们的父进程接收到错误原因
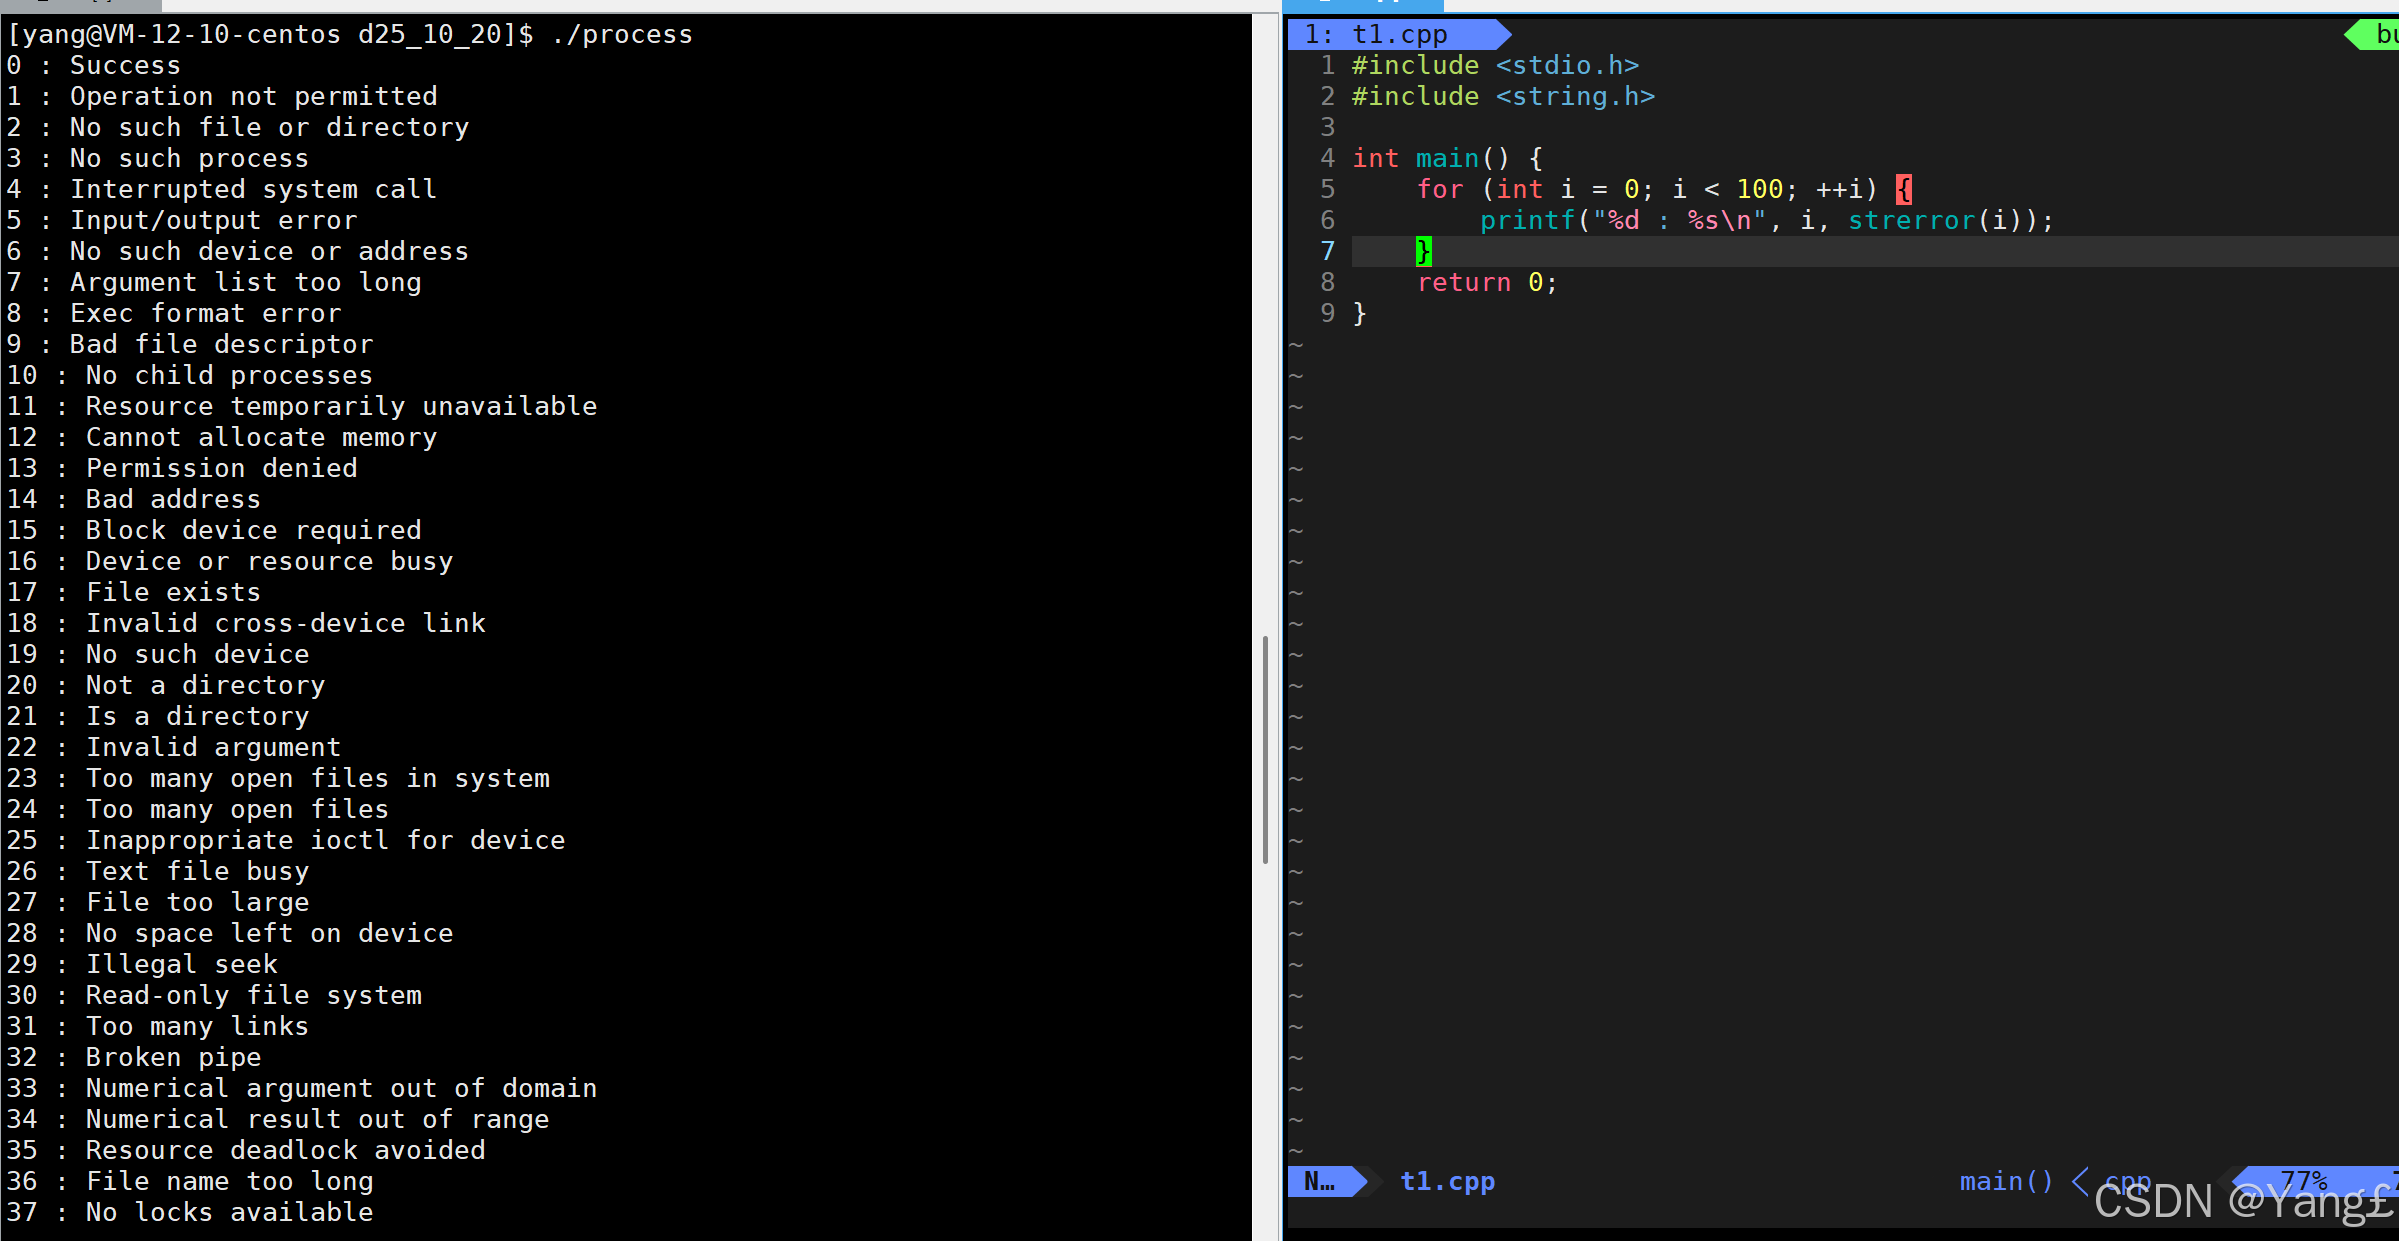
知道了错误码, 我们还可以通过strerror了解对应的错误码对应的描述, 如下
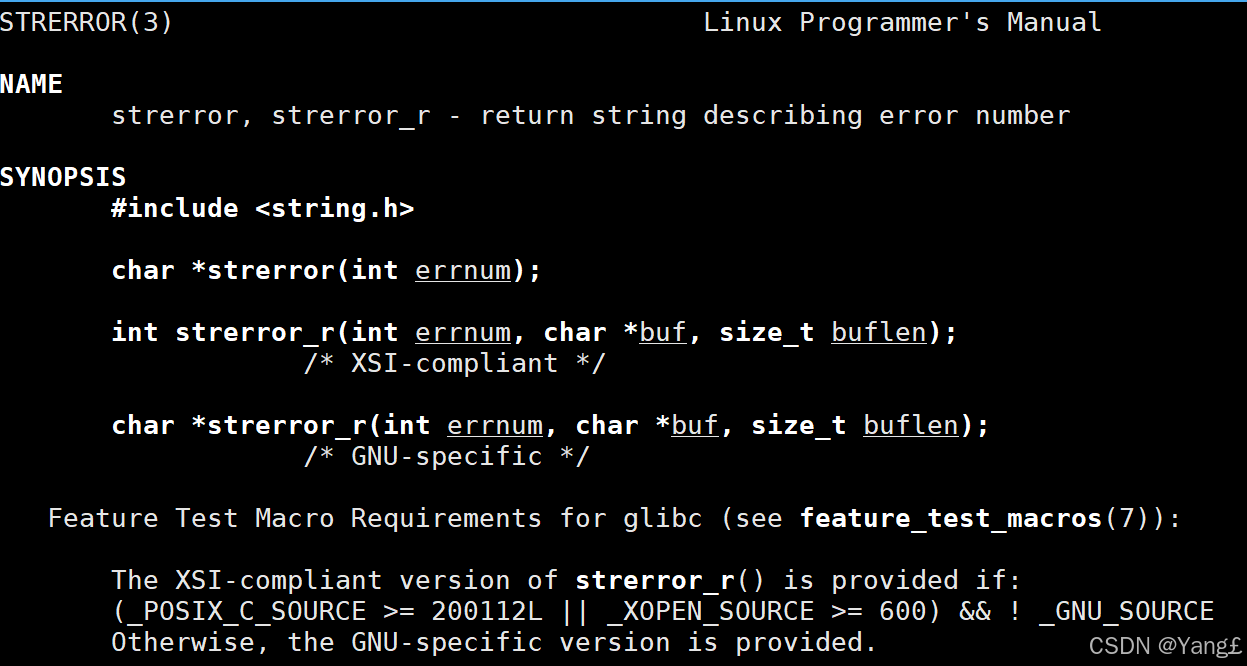
通过调用strerror接口显示错误码描述
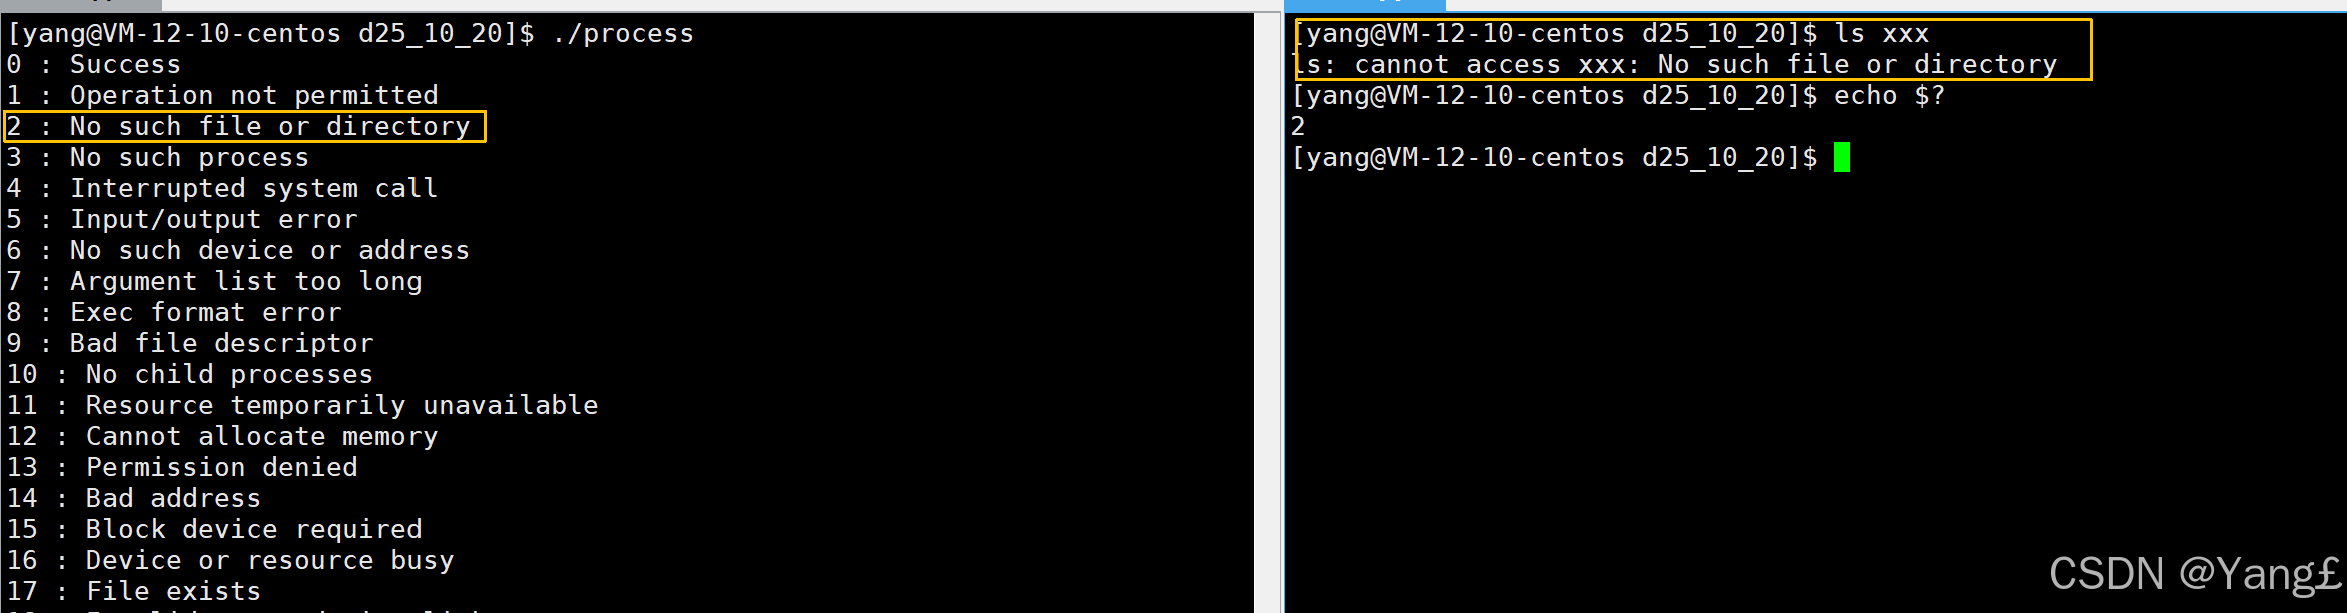
例如, 当我们通过ls 指令进入一个不存在的文件时, 系统会显示文件不存在, 即对应我们的错误码 2, 同样我们可以查看上一个进程(ls)的退出码来查看验证
通常在程序内部我们可以通过errno查看(显示上一条错误信息,当存在多个错误, 会将上一条错误码进行覆盖), 当函数执行失败时(如文件打开失败、网络连接超时),不会直接返回详细错误描述,而是通过 errno 存储一个整数型错误码,我们则通过该错误码进一步判断失败原因。在早期 C 标准中,errno 是一个全局变量 (定义于 <errno.h> 头文件)
错误演示
#include <stdio.h>
#include <string.h>
#include <errno.h>
#include <stdlib.h>

int main() {
    int res = 0;

    // 尝试打开一个不存在的文件(故意失败)
    FILE* file = fopen("xxx.txt", "r");
    if (file == NULL) {
        printf("file fopen fall: %d : %s\n", errno, strerror(errno));
        res = errno;
    } else {
		printf("fopen success!\n");
    }

    return res;
}
运行结果
1.3 异常退出
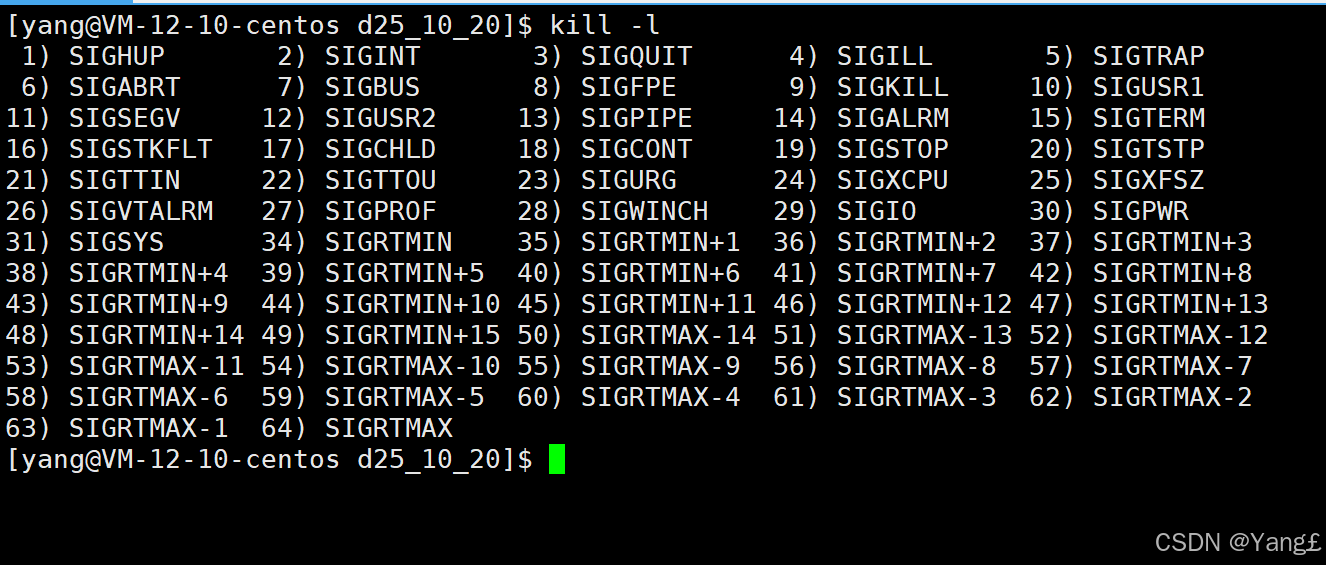
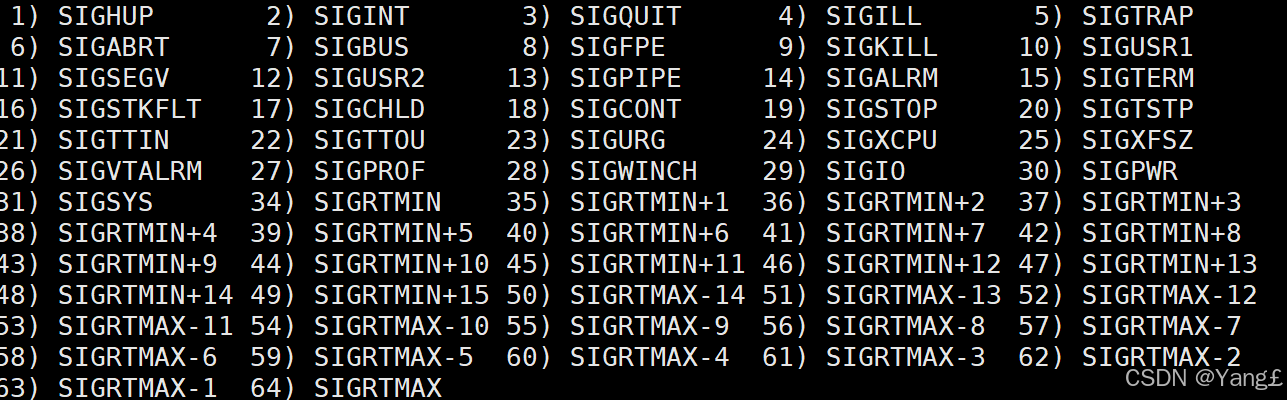
在之前通过ajx命令查看进程属性时, 我们通过kill - 9命令可以杀死一个进程, 实际上是向该进程发送所谓的"终止信息", 来结束当前进程.我们通过kill -l 查看信号
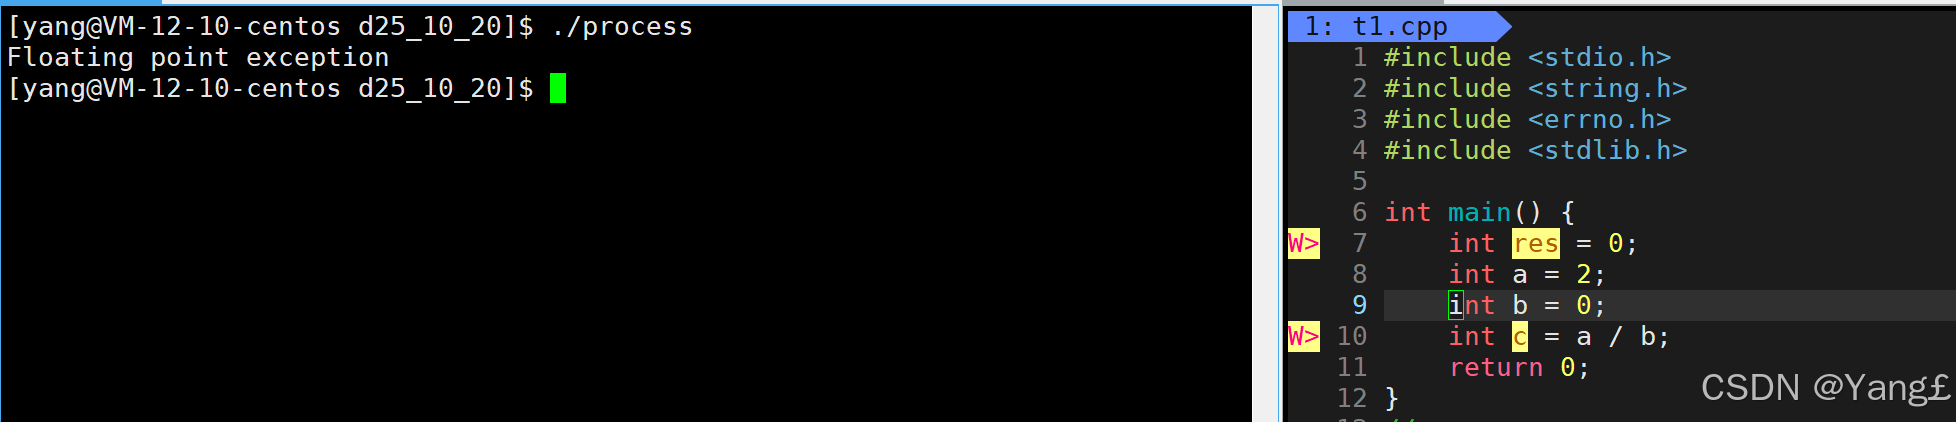
程序内部发生错误时终端则显示对应信号信息, 例如: 除0错误,运行程序后,终端会输出 Floating point exception (core dumped)(浮点异常),进程因非法运算被操作系统终止,属于异常退出。
程序演示
常见触发异常退出的场景:
外部信号强制终止:操作系统或其他进程向当前进程发送 “终止信号”,且进程未捕获或无法处理该信号。
- 用户按下Ctrl+C,系统发送SIGINT信号(中断信号);
- 进程占用资源过久,被管理员用kill命令发送SIGKILL信号(强制终止,无法捕获);
程序内部致命错误:进程执行时出现无法恢复的错误,被操作系统直接终止。
- 访问非法内存(如空指针解引用、数组越界);
- 执行非法指令(如 CPU 不支持的操作码);
浮点运算异常(如除以 0)。
1.4 exit 和 _exit
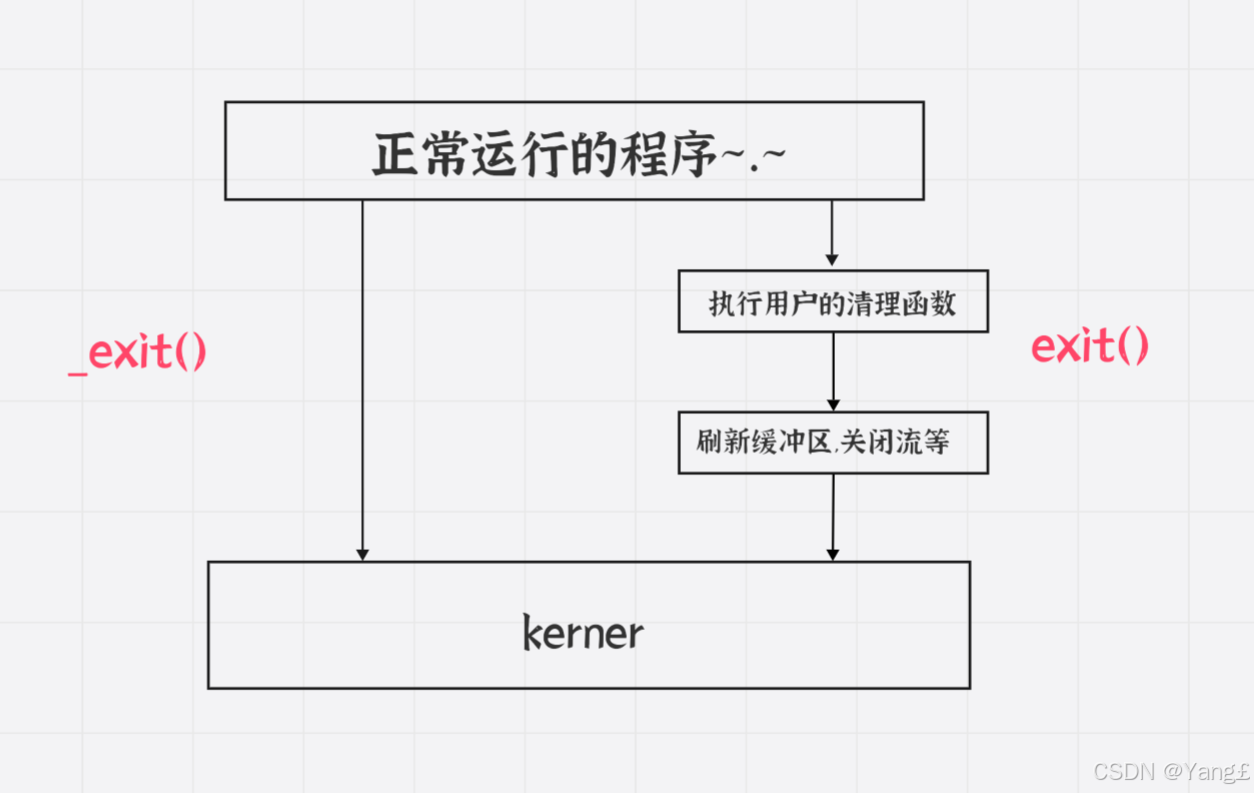
在 C 语言中,exit 和 _exit 都是用于终止进程的函数,但它们的核心区别在于 退出前是否执行 “清理操作”,这直接影响程序的资源释放、数据完整性等行为(稍后测试)
// 通过man 3号手册查看参数信息
//标准库函数
#include <stdlib.h>
void exit(int status);

//系统调用封装
#include <unistd.h>
void _exit(int status);
我们通过一个简单的例子观察两者最直接区别
// exit部分
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main() {
    while (1) {
        printf("测试exit和_exit区别");
        exit(0);
    }
    return 0;
}
// _exit部分
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main() {
    while (1) {
        printf("测试exit和_exit区别");
        _exit(0);
    }
    return 0;
}
分别运行两者代码, 发现exit()退出程序成功打印测试代码, 而_exit()调用部分什么也没打印
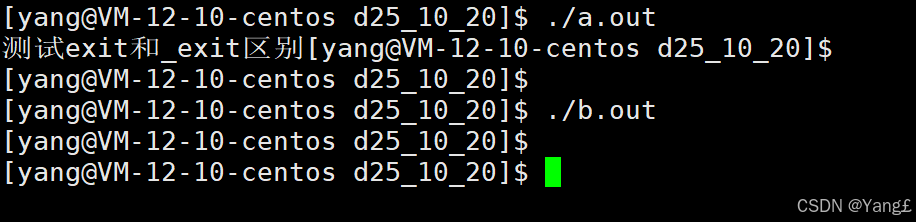
在之前所学习中C 语言的标准输出(如 printf)默认使用 “缓冲机制”:输出内容会先存到缓冲区,只有当缓冲区满、遇到换行符(\n)或程序正常退出时,才会真正打印到终端。
所以我们得出结论:
exit 会强制刷新所有缓冲区,确保数据不丢失;先清理,再终止
适合 “正常退出” 场景当进程需要完整释放资源、确保数据写入(如文件、终端)、执行收尾逻辑时使用。
程序正常完成任务后退出;
处理完输入输出后主动终止。
_exit 不刷新缓冲区,未输出的内容会直接丢弃。 直接终止,不清理
适合 “无需清理” 或 “子进程退出” 场景当进程不需要(或不应该)执行清理操作时使用,典型场景是 子进程退出: 子进程若用 exit,可能会清理父进程共享的资源(如文件流缓冲区),导致父进程数据异常; 用 _exit 可避免干扰父进程,仅终止自身。
简单说:exit 是 “体面退出”(做好收尾再走),_exit 是 “紧急撤离”(立刻终止,不带走一片云彩)。
二、进程等待
- 进程等待必要性
子进程退出后,若父进程未处理,子进程会进入僵尸状态 Z (详细请看) ,保留 PCB 等内核资源,导致内存泄漏。
父进程通过等待可以获取子进程的退出状态(如正常退出的返回值、异常终止的信号等),从而判断子进程的执行结果。
2.1 wait 和 waitpid
- wait() 是最简单的进程等待函数,功能是阻塞 等待任意一个子进程退出,并回收其资源。
//函数原型
#include <sys/wait.h>
pid_t wait(int *status);
其中status:输出型参数,用于存储子进程的退出状态(若为NULL,表示不关心退出状态)。
返回值
成功:返回等待的子进程的 PID
失败:返回 -1(如无子进程时)
我们将之前演示僵尸进程代码改造一下,观察wait()回收子进程场景
#include <iostream>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>
using namespace std;
int main () {
    pid_t id = fork();
    pid_t res;
    if (id == 0) {
        // 子进程
        cout << "子进程pid " << getpid() << " ppid "$
        // 子进程先退出
        sleep(2);
        exit(0);
    } else {
	cout << "父进程pid " << getpid() << " ppid "$
       sleep(5); // 回收前睡眠5秒钟, 此时为Z状态
        res = wait(NULL);
        sleep(30);
    }
    return res;
}
循环调用监控进程状态
while :; do ps ajx | head -1 ; ps ajx | grep waitpro | grep -v grep; sleep 1; echo " "; done
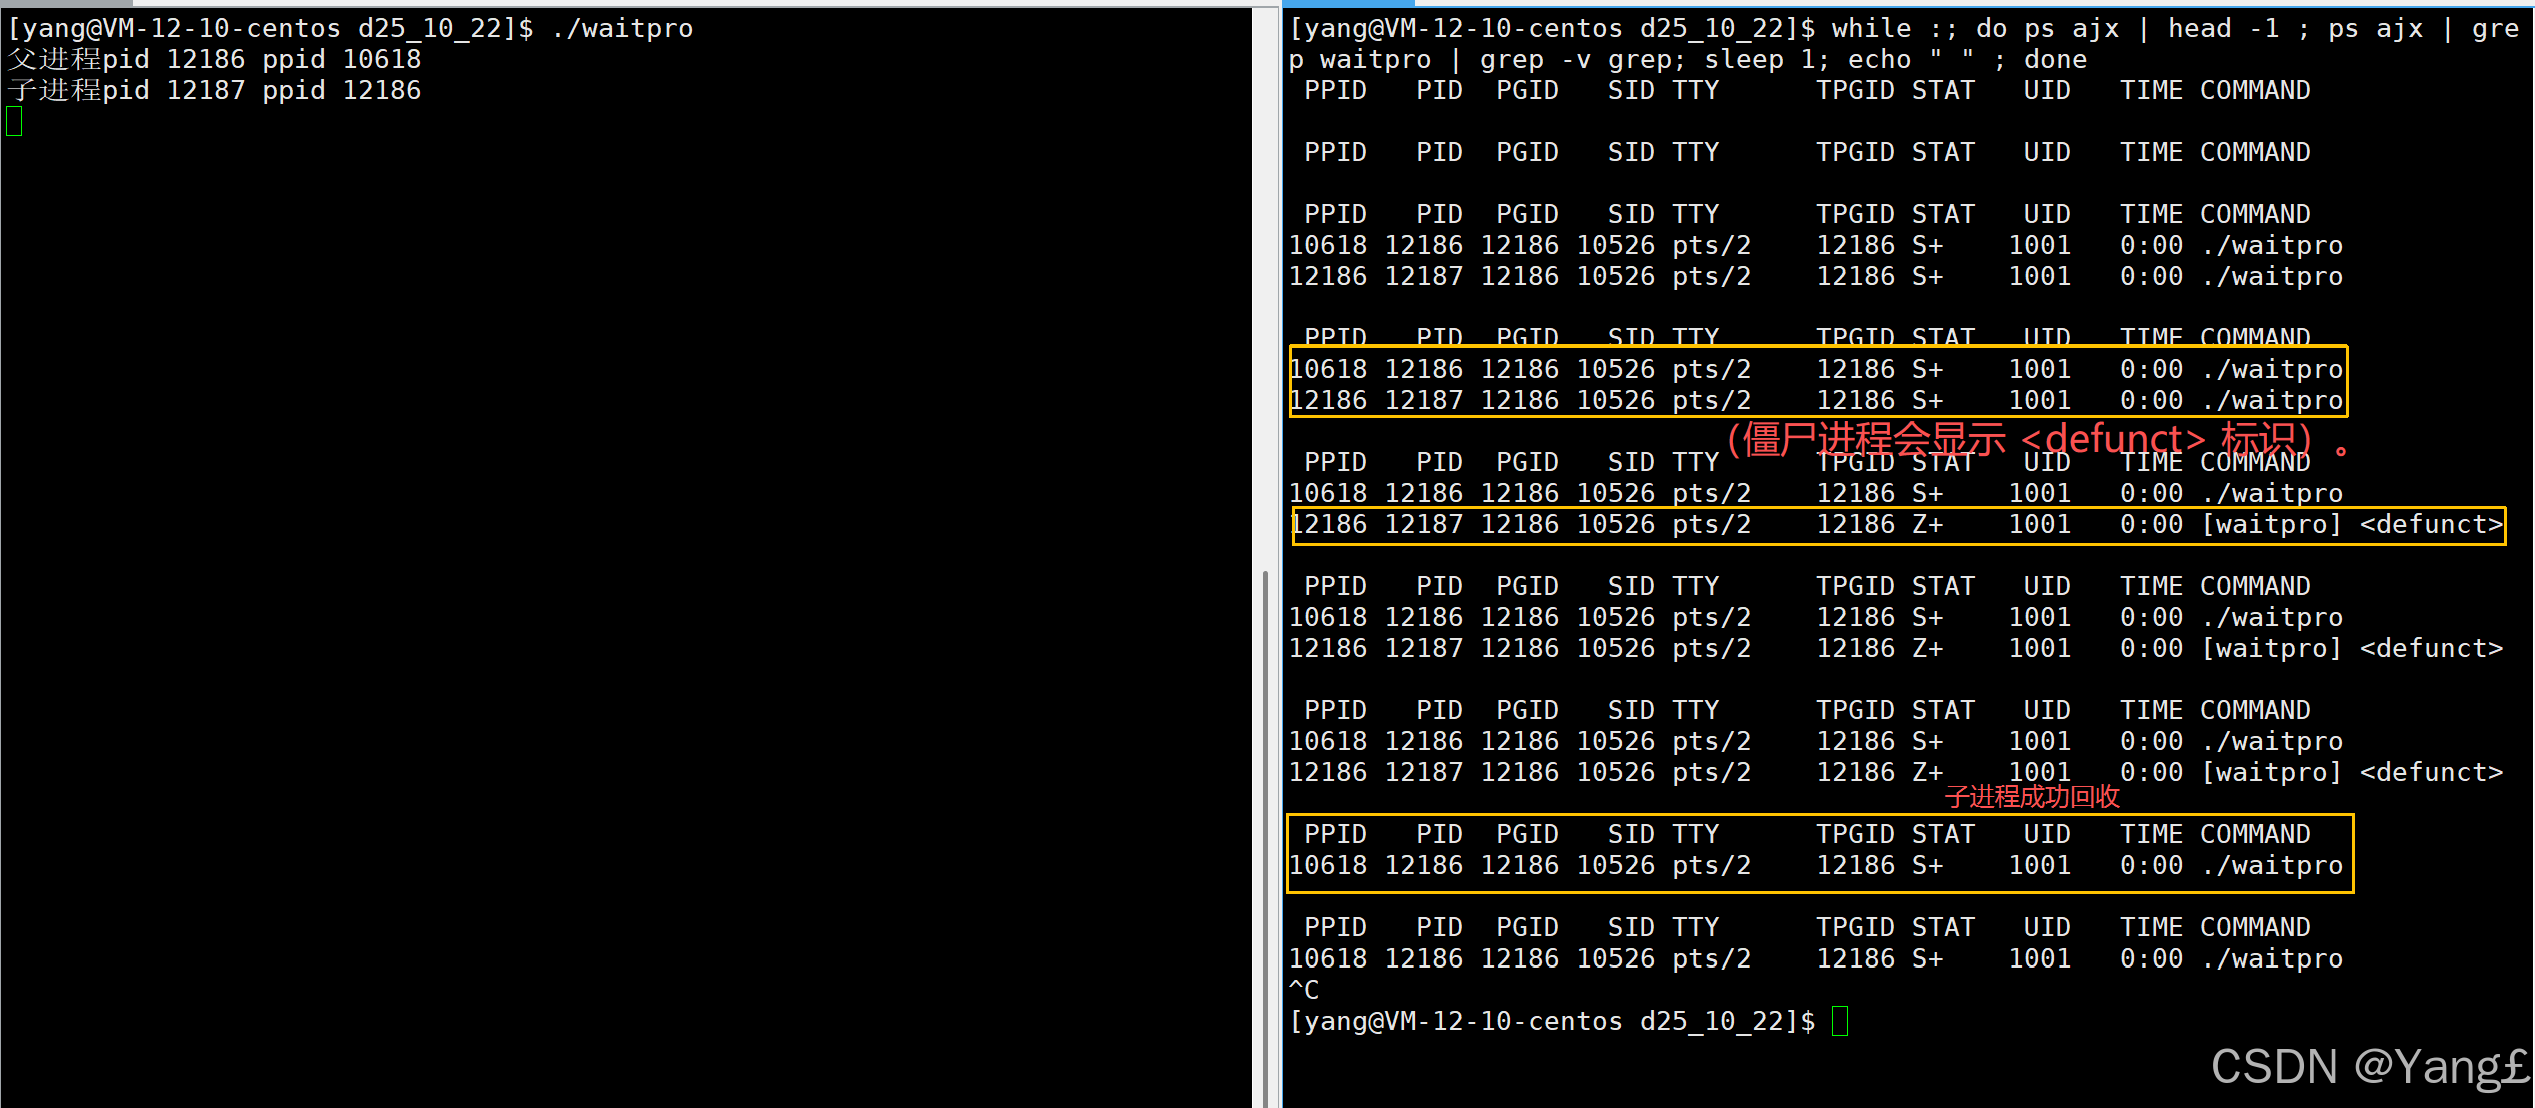
特殊的若子进程一直不退出, 父进程在wait等待时, 会一直处于阻塞状态.
- waitpid()
pid_t waitpid(pid_t pid, int *status, int options);
返回值:
- 若子进程已退出,返回该子进程的 PID
若options选项为WNOHANG且子进程未退出,返回0
失败则返回 -1(如无符合条件的子进程)
参数:
- pid:指定等待的子进程 PID,当前只考虑pid取 > 0 和 pid = -1
pid > 0:等待 PID 为pid的子进程。
pid = -1:等待任意子进程(与wait()功能相同) - status:同wait(),用于存储子进程退出状态
status是一个输出型参数,用于存储子进程的退出状态信息。它本身是一个 int 类型的整数,但并非直接表示子进程的退出码(如 exit(n) 中的 n),而是通过不同的位存储了子进程的退出细节(比如 “是否正常退出”“退出码是多少”“是否被信号终止”“终止信号是什么” 等)。
为什么 status 不能直接使用?
status 的内部结构是 “位级别的分段存储”
低 7 位:通常存储 “终止信号” 相关信息(若子进程被信号杀死)。
第 8 位: core dump信号(信号部分后文在补充, 在此不讨论)
高 8 位:通常存储 “正常退出的退出码”(若子进程通过 exit() 或 return 正常退出)。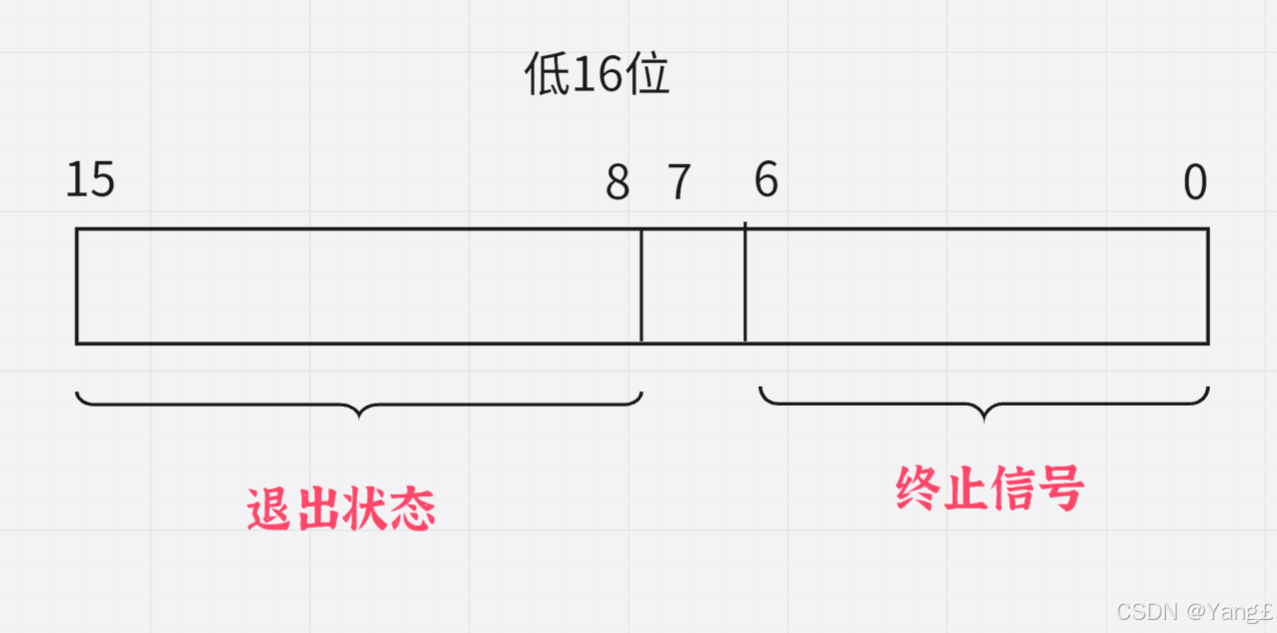
其中终止信号在之前我们从kill -l 得出 信号码 1 ~ 64, 所以若低七位为0, 则代表进程没有异常, 我们只需知道该进程的退出码为多少
可以通过打印函数, 以及位运算观察status结果
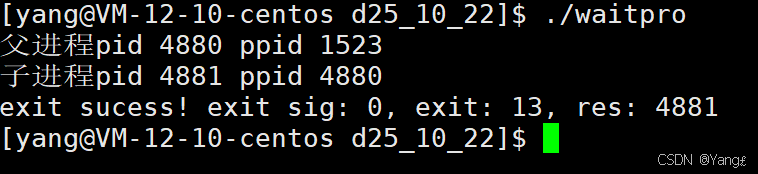
// 在末尾添加该语句, 开头代码子进程exit(0) 改为 exit(13), 退出码为13
printf("exit sucess! exit sig: %d, exit: %d, res: %d\n", status&0x7f, (status >> 8) & 0xff, res);
示例: 符合预期
在实际应用场景中, 我们一般不会使用位运算方式获取以上信息, 而是通过宏解析
| 宏 | 功能 |
|---|---|
| WIFEXITED(status) | 进程正常退出返回非0 |
| WIFSIGNALED(status) | 进程被信号终止返回非0 |
| WEXITSTATUS(status) | 进程正常退出情况下, 返回退出码 |
| WTERMSIG(status) | 存在异常情况下, 返回异常信号值 |
- options选项
0: 默认阻塞等待, 子进程未退出时,父进程挂起(一直等待)
WNOHANG:非阻塞轮询等待(若子进程未退出,立即返回0)
非阻塞轮询必要性
默认情况下,waitpid(pid, &status, 0) 是阻塞等待:父进程会暂停执行(进入阻塞状态),直到子进程退出后才继续运行。但在实际开发中,父进程可能需要同时处理其他任务(如监听网络请求、处理用户输入等),不能长时间阻塞。此时 WNOHANG 就非常有用 —— 它让父进程可以 “轮询” 检查子进程是否退出,同时不耽误自身工作。且在进程退出时始终保持父进程最后一个退出
简单来说在检查子进程退出之前, 父进程等待时还干其他的事
下面代码可以简单演示父进程在轮询时干其他的事情
#include <iostream>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>
#include <stdio.h>

using namespace std;
int main () {
    pid_t pid = fork();
    pid_t res;
    int status;

    if (pid == 0) {
        printf("子进PID %d 10秒后退出...\n", getpid());
        sleep(10);
        exit(0);
    } else { // 父进程:非阻塞等待,同时做自己的事

        while (1) {
            res = waitpid(pid, &status, WNOHANG);
            //sleep(1);
            if (res == 0) {
                printf("父进程:子进程还在运行,继续工作...\n");
                sleep(1); // 模拟其他工作
            } else if (res == pid) {
                printf("父进程:子进程PID: %d已退出,回收完成\n", res);
                break; // 退出循环
            } else {
                perror("waitpid failed");
                exit(1);
            }
	}
    }
    return res;
}
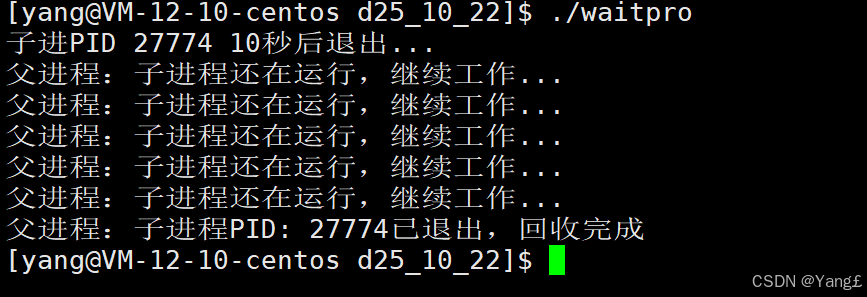
三、进程替换
在操作系统中,进程替换是指用一个全新的程序替换当前进程的代码、数据、堆、栈等内存区域(原程序的执行逻辑彻底消失),同时保持进程的 pid 、父进程 id、用户 id、文件描述符等核心属性不变的操作。
为什么需要进程替换?
当一个进程(通常是子进程)完成了初始化工作后,可能不需要继续执行原程序的逻辑,而是需要执行另一个全新的程序。此时无需创建新进程(避免 pid 变化),而是采取用新进程替换原来的子进程
3.1 替换函数
下面介绍exec系列5种进程替换函数
1. execl
#include <unistd.h>
int execl(const char *path, const char *arg, ... /* (char  *) NULL */);
- path:新程序的绝对路径或相对路径 必须准确指定 (execl 不会从环境变量 PATH 中搜索程序)
- arg: 传递给新程序的命令行参数,是一个可变参数列表。
第一个参数 arg 通常是新程序的名称,对应新程序 main 函数的 argv[0]。后续参数是具体的命令选项参数 - 最后一个参数必须以 (char*)NULL 结尾,标记参数结束。
- 返回值:
若成功,execl 不会返回(因为当前进程已被新程序替换)失败,返回 -1(此时原进程的执行逻辑可继续,可通过 perror() 查看错误原因)。
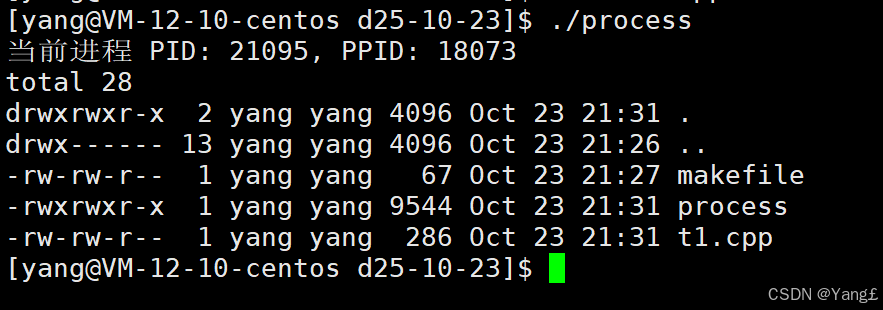
单进程代码示例
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>

int main() {
    printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());

    execl("/usr/bin/ls", "ls", "-a", "-l", NULL);
    // 程序替换后, 下面行不会执行
    printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());
    return 0;
}
现象:
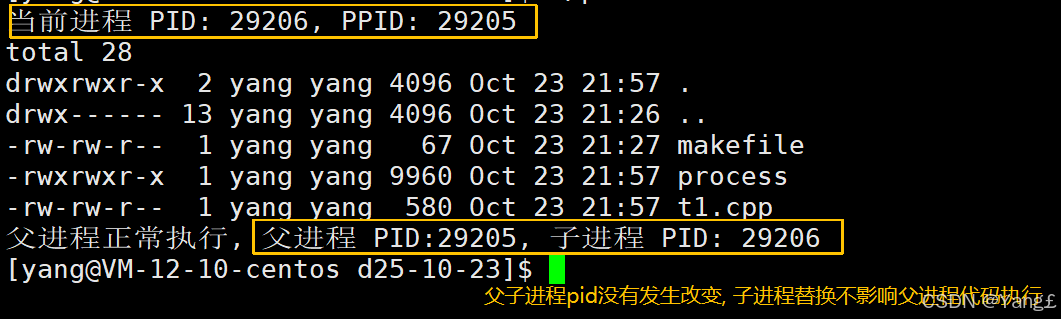
多进程时替换
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <stdlib.h>
int main() {
    pid_t id = fork();

    if (id == 0) {
        printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());

        execl("/usr/bin/ls", "ls", "-a", "-l", NULL);

        printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());
        exit(0);
    } else {
	pid_t res = waitpid(id, NULL , 0);
        sleep(5);
        printf("父进程正常执行, 父进程 PID:%d, 子进程 PID: %d\n", getpid(), res);
    }
    return 0;
}
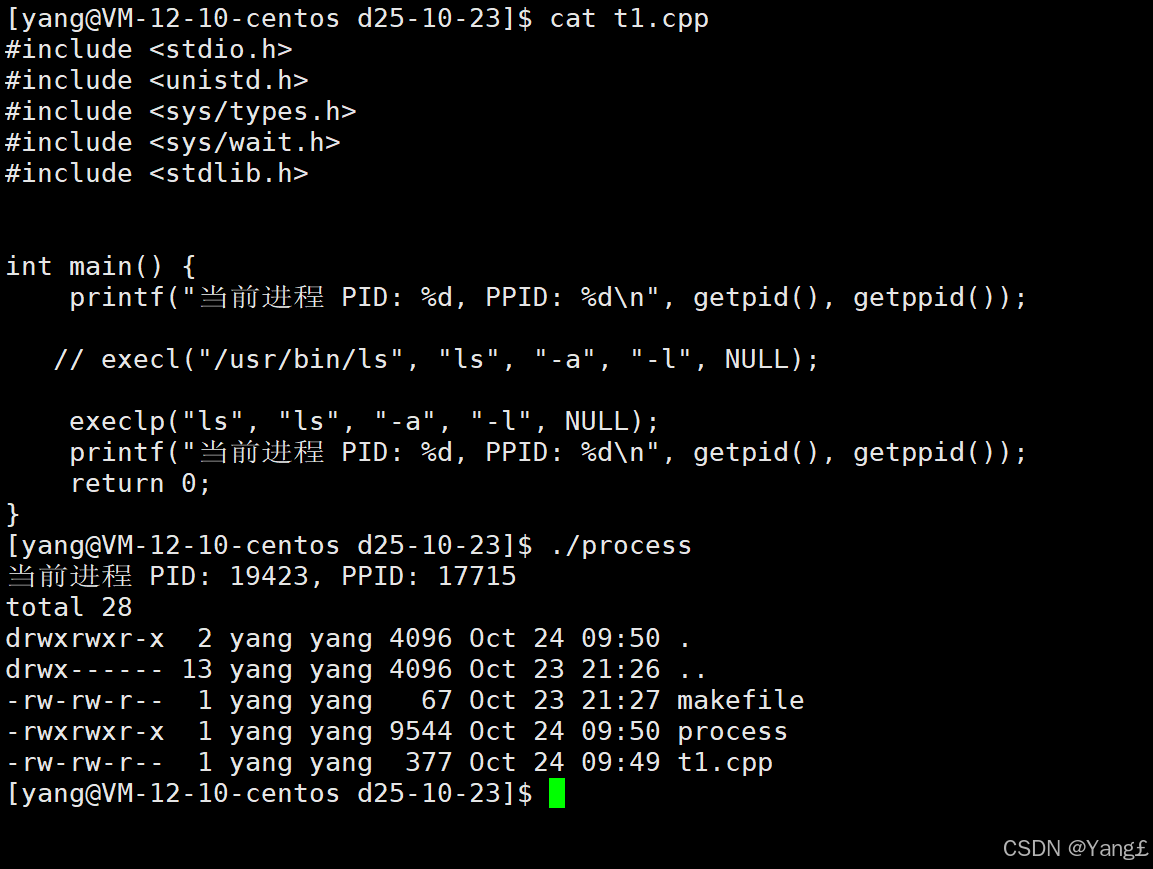
2.execlp
#include <unistd.h>
int execlp(const char *file, const char *arg, ... /* (char  *) NULL */);
第一个参数 file 会自动从环境变量 PATH 中搜索新程序的路径, 若使用绝对或相对路径, 则直接使用该路径,其他参数与execl保持一致
3.execv
#include <unistd.h>
int execv(const char *path, char *const argv[]);
- 参数
path: 新程序的绝对路径或相对路径(必须显式指定完整路径,execv 不会从环境变量 PATH 中搜索程序)
argv: 指向命令行参数数组的指针,数组格式要求:
argv[0] 通常是新程序的名称, argv[1], argv[2], … 是具体的命令选项或参数并且数组必须以 NULL 结尾标记参数列表结束。
函数返回值与execl保持一致
用法
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <stdlib.h>


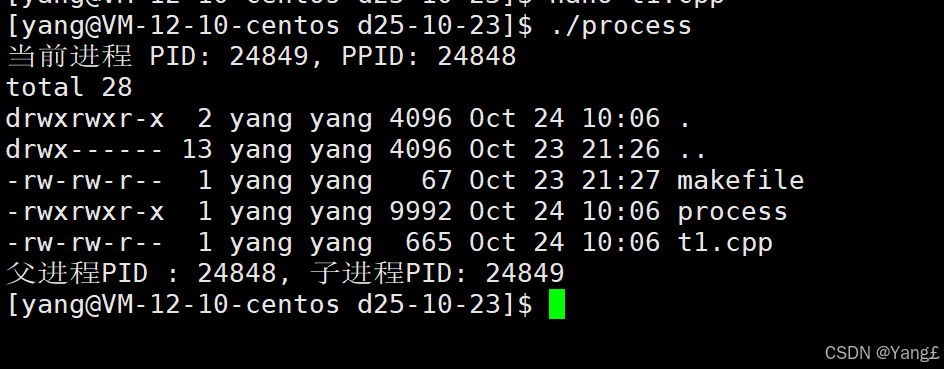
int main() {
    pid_t id = fork();

    if (id == 0) {
        printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());

        //execl("/usr/bin/ls", "ls", "-a", "-l", NULL);
        //execlp("ls", "ls", "-a", "-l", NULL);
        char* const argv[] = {"ls", "-a", "-l", NULL};

        execv("/usr/bin/ls", argv);
        printf("当前进程 PID: %d, PPID: %d\n", getpid(), getppid());
    } else {
	pid_t res = waitpid(id, NULL, 0);
        printf("父进程PID : %d, 子进程PID: %d\n", getpid(), res);
    }
    return 0;
}
4.execvp
#include <unistd.h>
int execvp(const char *file, char *const argv[]);
同样的第一个参数 file会自动从环境变量 PATH 中搜索新程序的路径, 若使用绝对或相对路径, 则直接使用该路径 返回值保持一致
示例
	char* const argv[] = {"ls", "-a", "-l", NULL};
    //execv("/usr/bin/ls", argv);
    execvp("ls", argv);
5.execle
#include <unistd.h>
int execle(const char *path, const char *arg, ... , char *const envp[]);
在execl函数基础上, 新增允许自定义环境变量数组(而非继承其父进程的环境变量)
envp:自定义的环境变量数组
数组元素是字符串,格式为 NAME=VALUE
数组必须以 NULL 结尾(即 envp[n] = NULL)。
新程序的环境变量将完全由 envp 指定,不再继承原进程的环境变量。
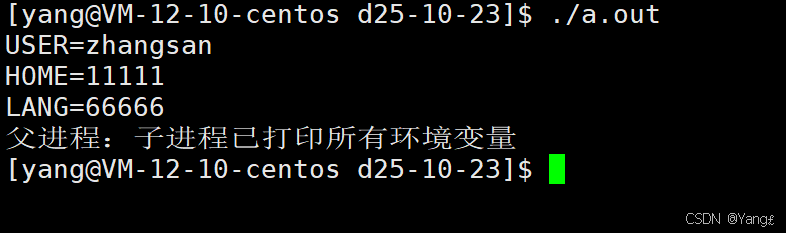
我们通过将替换程序改为改为 printenv, 来实现打印全部自定义环境变量信息
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>
#include <stdlib.h>

int main() {
    pid_t pid = fork();
    if (pid == 0) {
        char* envp[] = {
            "USER=zhangsan",
            "HOME=11111",
            "LANG=66666",
             NULL
        };

	execle(
            "/usr/bin/printenv",
            "printenv",
            NULL,
            envp
        );
    } else {
	wait(NULL);
        printf("父进程:子进程已打印所有环境变量\n");
    }
    return 0;
}
记忆口诀:
带 l (list) 使用参数列表
带 v(vector) 参数用数组
带 p(path) 自动搜索当前环境变量
带 e(env) 使用自己维护的环境变量
	char *const argv[] = {"ps", "-ef", NULL};
    char *const envp[] = {"PATH=/bin:/usr/bin", "TERM=console", NULL};
    execl("/bin/ps", "ps", "-ef", NULL);
    // 带p的,可以使用环境变量PATH,无需写全路径
    execlp("ps", "ps", "-ef", NULL);
    // 带e的,需要自己组装环境变量
    execle("/bin/ps", "ps", "-ef", NULL, envp);
    // 带v的,使用指针数组
    execv("/bin/ps", argv);
    // 带p的,可以使用环境变量PATH,无需写全路径
    execvp("ps", argv);
    // 带e的,需要自己组装环境变量
    execve("/bin/ps", argv, envp);

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)