【必收藏】从Prompt到Context Engineering:Dify构建企业级AI Agent实战指南
引言
2024年夏季,人工智能领域权威学者Andrej Karpathy对Context Engineering(CE)实践报告的转发,标志着智能体技术从传统Prompt Engineering(PE)向系统化上下文管理的范式转变。CE通过整合指令/系统提示词、用户输入、短期记忆、长期记忆、检索信息、可用工具、结构化输出七大核心要素,构建动态上下文系统,解决了PE在复杂任务处理中的局限性。与PE的"便利贴式"静态提示不同,CE更接近"完整剧本"的系统工程,使Agent具备环境感知、工具协同和自主决策能力。
Dify作为开源LLM应用开发平台,凭借可视化Prompt IDE、企业级RAG引擎、灵活工作流编排三大核心优势,成为CE技术落地的理想载体。其独创的蜂巢架构支持模型、插件、数据源的动态编排,内置RAG引擎可处理20+文档格式的语义化解析,可视化工作流设计器降低了复杂逻辑的构建门槛[2]。实践数据显示,基于Dify的CE方案可降低推理成本10倍,提升复杂任务成功率40%,显著优于传统开发模式。
本文以"问题-解决方案-效果"为实战导向,采用5W1H框架从零构建Dify Agent,重点解决动态上下文适配、多模态知识融合、缓存效率优化三大核心问题。通过技术解析与案例实践,帮助读者掌握CE技术在Dify中的应用方法,实现从理论认知到工程落地的能力闭环。
Dify Agent应用场景
企业知识库智能问答系统
场景描述:某制造企业需构建内部知识库,整合产品手册(PDF)、技术文档(Markdown)、员工FAQ(Excel)等多源信息,实现精准问答与知识检索。
传统痛点:
- • 文档分散存储于不同系统,员工需切换5+平台查询
- • 非结构化内容检索精度低(关键词匹配准确率<60%)
- • 新员工培训依赖人工讲解,知识传递效率低下
Dify CE解决方案:
-
- 多模态知识融合:通过Dify RAG引擎统一处理PDF/Markdown/Excel文档,采用"父子分段"策略(父块保留上下文,子块用于检索)提升匹配精度
-
- 混合检索优化:结合向量搜索(语义匹配)+关键词搜索(精确匹配),TopK设置为5时准确率达92%
-
- 动态上下文生成:根据用户问题自动拼接相关知识片段(如产品型号+维修步骤),避免上下文超限
实施效果:
- • 知识检索响应时间从15分钟缩短至20秒
- • 问答准确率提升至91%,减少80%重复咨询
- • 新员工培训周期缩短40%
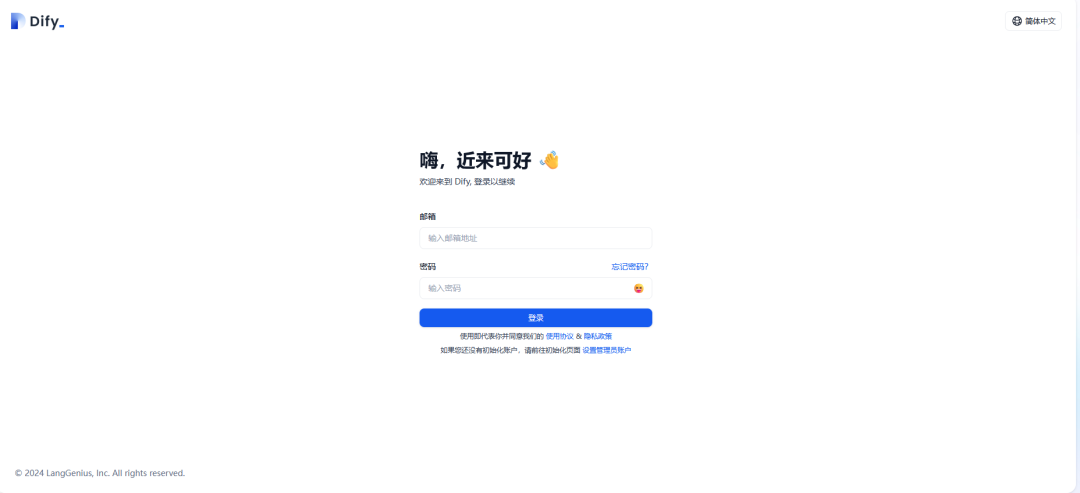
Dify应用创建界面
图:Dify知识库创建流程,支持多格式文档批量导入与自动向量化处理
智能客服工单自动处理
场景描述:电商平台需处理日均5000+客服工单,涵盖订单查询、售后退换、物流跟踪等场景,传统人工处理成本高且响应延迟。
Dify CE技术路径:
- • 意图识别:通过Dify Prompt工程定义12类工单意图(如"订单修改"、“退款申请”),准确率达95%
- • 工具链集成:调用订单API(查询状态)、物流系统(获取轨迹)、CRM(记录客户偏好)
- • 结构化输出:统一生成JSON格式工单摘要,自动分派至对应处理组
量化收益:
- • 首次响应时间从4小时降至15分钟
- • 人工处理量减少60%,年节省人力成本80万元
- • 客户满意度提升28%
CE技术在Dify中的实施步骤
步骤1:环境准备与基础配置
硬件与软件要求
- • 最低配置:4核CPU、8GB内存、50GB存储(Docker部署)
- • 依赖环境:Docker 19.03+、Docker Compose 1.25.1+、Python 3.12
Docker快速部署
# 克隆代码仓库git clone https://github.com/langgenius/dify.gitcd dify/docker# 启动中间件(PostgreSQL/Redis/Weaviate)docker compose -f docker-compose.middleware.yaml up -d# 启动Dify服务docker compose up -d
初始配置
-
- 访问
http://localhost:3000完成管理员账号设置
- 访问
-
- 在模型供应商页面配置LLM(支持OpenAI/Claude/本地模型如Llama3)
-
- 创建API密钥(Settings > API Keys)用于工作流调用
注意:国内用户建议配置代理加速模型访问,或使用阿里云香港节点部署以降低延迟[3]。
步骤2:系统提示词的CE要素设计
Dify Prompt IDE核心功能
Dify提供可视化Prompt编排界面,支持变量注入、多模型对比、版本控制三大核心功能,其CE要素设计遵循"角色定义-指令约束-输出格式"黄金三角结构:
# Dify系统提示词模板(YAML格式)context_prompt: | 使用以下知识库内容回答问题: {{knowledge}} system_prompt_orders: - context_prompt - pre_prompt - histories_prompt query_prompt: "{{#query#}}"stops: ["\nHuman:", "</histories>"]
动态变量应用示例
| 变量类型 | 语法 | 应用场景 |
|---|---|---|
| 用户输入 | {{#query#}} | 捕获用户提问内容 |
| 知识库 | {{knowledge}} | 注入检索到的文档片段 |
| 系统变量 | {{sys.user_id}} | 获取当前用户ID |
| 会话变量 | {{session.language}} | 存储用户语言偏好 |
最佳实践:在客服场景中,通过
{{session.customer_level}}动态调整回复语气(VIP客户增加专属权益说明)[4]。
步骤3:工作流节点串联与知识融合
核心节点配置
Dify工作流采用"节点-连线"可视化编排,关键节点包括:
-
- 知识检索节点
- • 配置:选择目标知识库,设置TopK=3、相似度阈值=0.85
- • 高级:启用混合检索(向量+关键词)与重排序(BGE-Reranker)
-
- LLM节点
- • 模型:GPT-4o(推理速度快)/ Claude-3(长文本处理优)
- • 参数:Temperature=0.3(降低随机性)、Max Tokens=2048
- • Prompt模板: ```plaintext
基于以下知识回答用户问题:{{knowledge}}用户问题:{{#query#}}回答要求:分点说明,引用文档章节号
-
- 工具调用节点
- • 类型:HTTP请求(调用订单API)、数据库查询(PostgreSQL)
- • 认证:API Key/用户名密码/OAuth2.0
图:Dify工具调用节点配置界面,支持参数映射与错误处理
上下文管理策略
- • 短期记忆:通过
{{histories}}变量自动拼接对话历史(默认保留5轮) - • 长期记忆:集成向量数据库(如Weaviate)存储用户偏好,检索时通过
{{#retrieve}}函数调用 - • 动态压缩:超过4k Token时自动触发摘要算法,保留关键信息
关键功能模块配置
企业级RAG知识库构建
文档处理流程
-
- 上传与解析:支持PDF/DOCX/TXT等20+格式,自动提取文本与元数据
-
- 分段策略:
- • 语义分段(按主题切分,300-500字/段)
- • 父子分段(父块保留章节标题,子块存储具体内容)
-
- 向量化索引:默认使用
text-embedding-3-small模型,支持切换至bge-large提升精度
- 向量化索引:默认使用
高级检索优化
// 知识库检索配置(JSON格式){ "retrieval_setting": { "top_k": 5, "rerank": true, "rerank_model": "bge-reranker-large", "similarity_threshold": 0.8 }}// 知识库检索配置(JSON格式){ "retrieval_setting": { "top_k": 5, "rerank": true, "rerank_model": "bge-reranker-large", "similarity_threshold": 0.8 }}
性能优化:多层缓存架构
Dify采用三级缓存策略优化响应速度:
-
- L1内存缓存:存储高频查询结果(TTL=5分钟)
-
- L2 Redis缓存:跨进程共享向量检索结果(TTL=1小时)
-
- L3磁盘缓存:持久化存储大模型生成结果(TTL=24小时)
配置示例:
# 缓存优化代码片段def cached_knowledge_retrieval(query): cache_key = f"query:{hash(query)}:topk:5" if redis_client.exists(cache_key): return json.loads(redis_client.get(cache_key)) # 未命中缓存时执行检索 results = vector_db.search(query, top_k=5) redis_client.setex(cache_key, 3600, json.dumps(results)) # 缓存1小时 return results
效果:某客服系统实施后,缓存命中率达82%,平均响应时间从1.8s降至0.4s[5]。
最佳实践案例:财务分析Agent
场景需求
构建自动化财务分析Agent,实现:
-
- 从ERP系统提取月度销售数据(CSV格式)
-
- 生成包含同比/环比分析的Excel报表
-
- 输出自然语言分析报告(中英双语)
实施步骤
步骤1:创建知识库
- • 上传财务指标定义(Excel)、历史报表(PDF)
- • 配置分段策略:按"指标-公式-说明"三级结构拆分
步骤2:设计工作流
Start
ERP数据导入
数据清洗
知识检索
LLM分析
Excel生成
报告输出
步骤3:关键节点配置
- • ERP数据导入:使用"HTTP请求"节点调用ERP API,参数
{{sys.month}}动态获取上月数据 - • 知识检索:关联"财务指标库",检索相关计算公式
- • LLM分析:Prompt模板注入
{{data}}与{{knowledge}}变量
步骤4:效果验证
- • 报表生成时间从8小时缩短至15分钟
- • 数据分析准确率达98%(人工校验结果)
- • 支持多语言切换(通过
{{session.language}}变量控制)
技术重难点与解决方案
核心挑战与应对策略
| 技术难点 | 解决方案 | 实施细节 |
|---|---|---|
| 知识库检索不准 | 混合检索+重排序 | 启用"向量搜索+BM25关键词搜索",使用bge-reranker重排结果 |
| 长上下文处理 | 动态窗口压缩 | 保留最近3轮对话+检索到的知识片段,总长度控制在8k Token内 |
| 模型成本高 | 模型路由策略 | 简单问题使用Llama3-8B,复杂分析调用GPT-4o |
错误处理最佳实践
// Dify工作流错误处理配置{ "error_handling": { "retry": { "max_attempts": 3, "delay": 2000 }, "fallback": { "node": "human_escalation", // 失败时转人工处理 "message": "系统暂时无法处理,请联系客服" } }}
总结与展望
Context Engineering通过系统化上下文管理,使Dify Agent突破传统PE的局限,在企业级场景中实现"降本增效"的双重价值。其核心方法论可概括为:
-
- 动态要素注入:通过变量系统实现上下文实时校准
-
- 结构化输出设计:预定义字段约束确保系统兼容性
-
- 缓存策略优化:多层缓存架构降低推理成本
Dify作为CE技术的理想载体,正在重塑LLM应用开发范式。通过持续优化上下文工程实践,开发者可构建更智能、更可靠的AI Agent,推动人工智能从工具向协作伙伴的深层进化。
最后
为什么要学AI大模型
当下,⼈⼯智能市场迎来了爆发期,并逐渐进⼊以⼈⼯通⽤智能(AGI)为主导的新时代。企业纷纷官宣“ AI+ ”战略,为新兴技术⼈才创造丰富的就业机会,⼈才缺⼝将达 400 万!
DeepSeek问世以来,生成式AI和大模型技术爆发式增长,让很多岗位重新成了炙手可热的新星,岗位薪资远超很多后端岗位,在程序员中稳居前列。
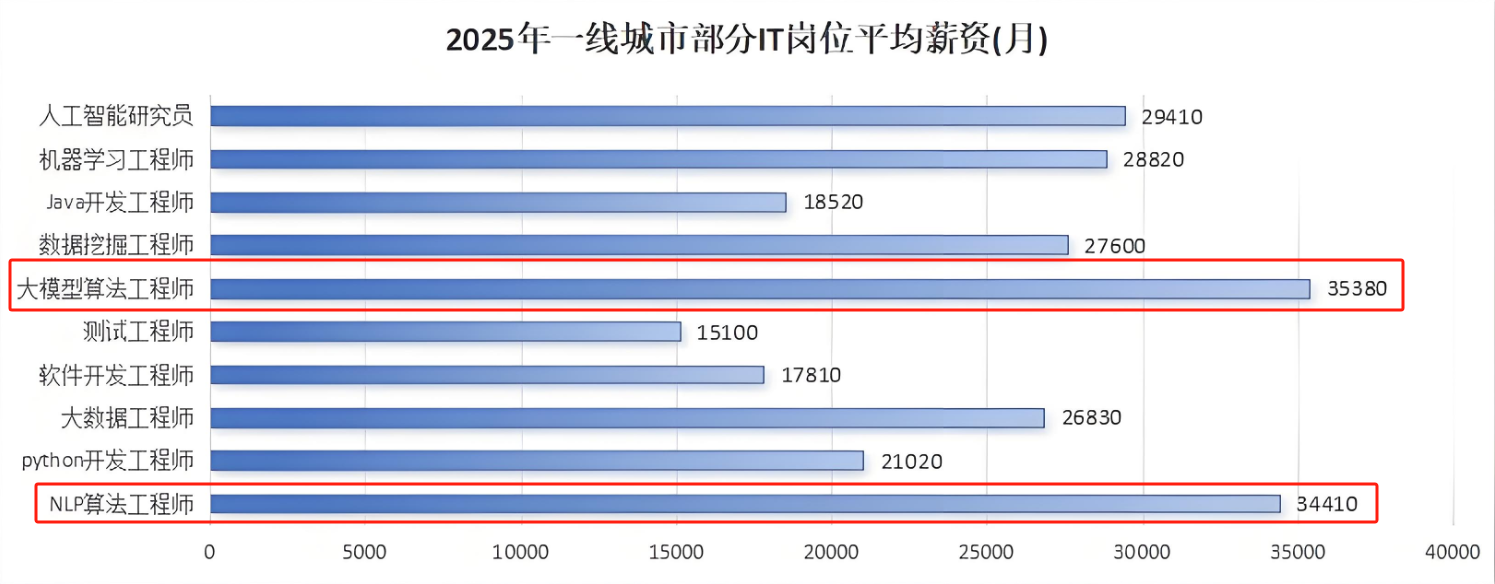
与此同时AI与各行各业深度融合,飞速发展,成为炙手可热的新风口,企业非常需要了解AI、懂AI、会用AI的员工,纷纷开出高薪招聘AI大模型相关岗位。
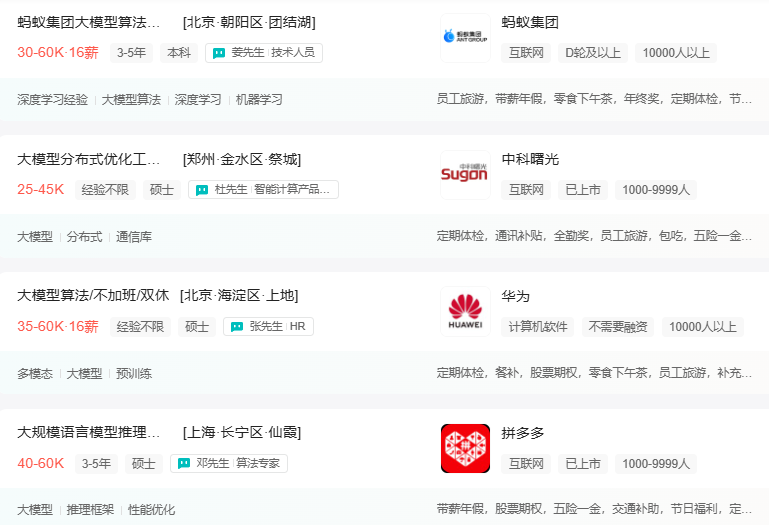
最近很多程序员朋友都已经学习或者准备学习 AI 大模型,后台也经常会有小伙伴咨询学习路线和学习资料,我特别拜托北京清华大学学士和美国加州理工学院博士学位的鲁为民老师给大家这里给大家准备了一份涵盖了AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频 全系列的学习资料,这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
AI大模型系统学习路线
在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。
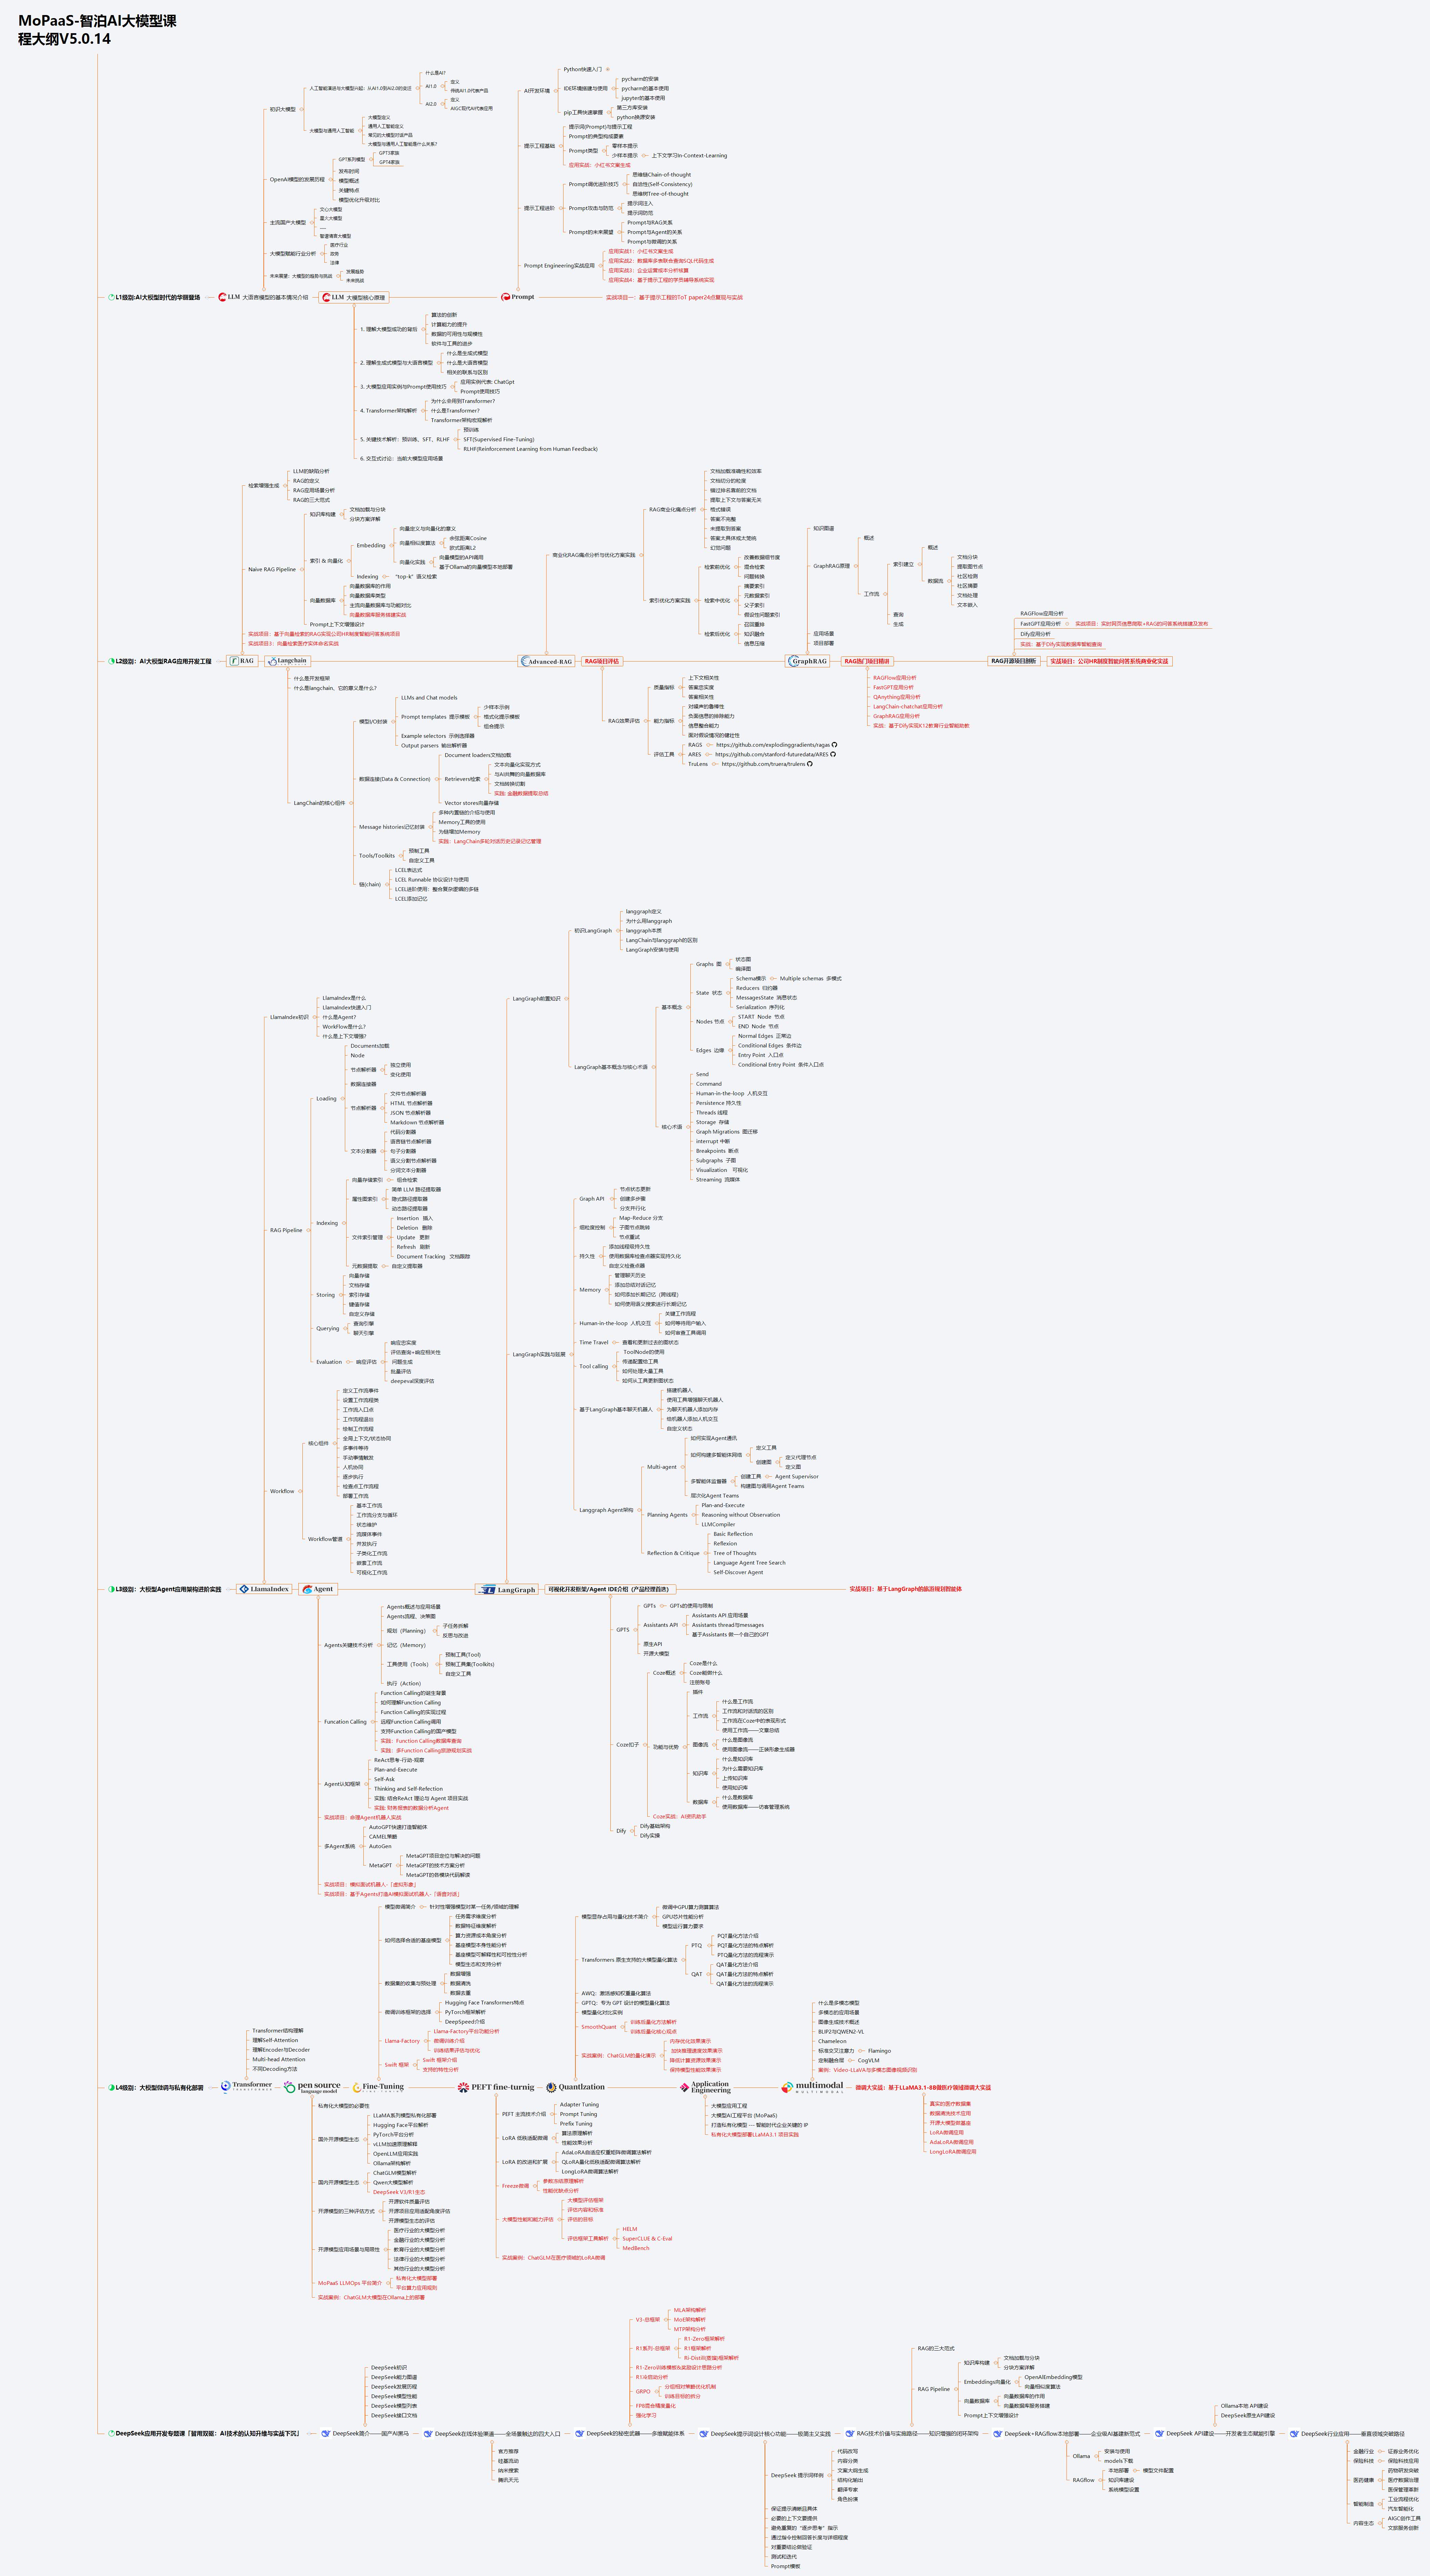
但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。
AI大模型入门到实战的视频教程+项目包
看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
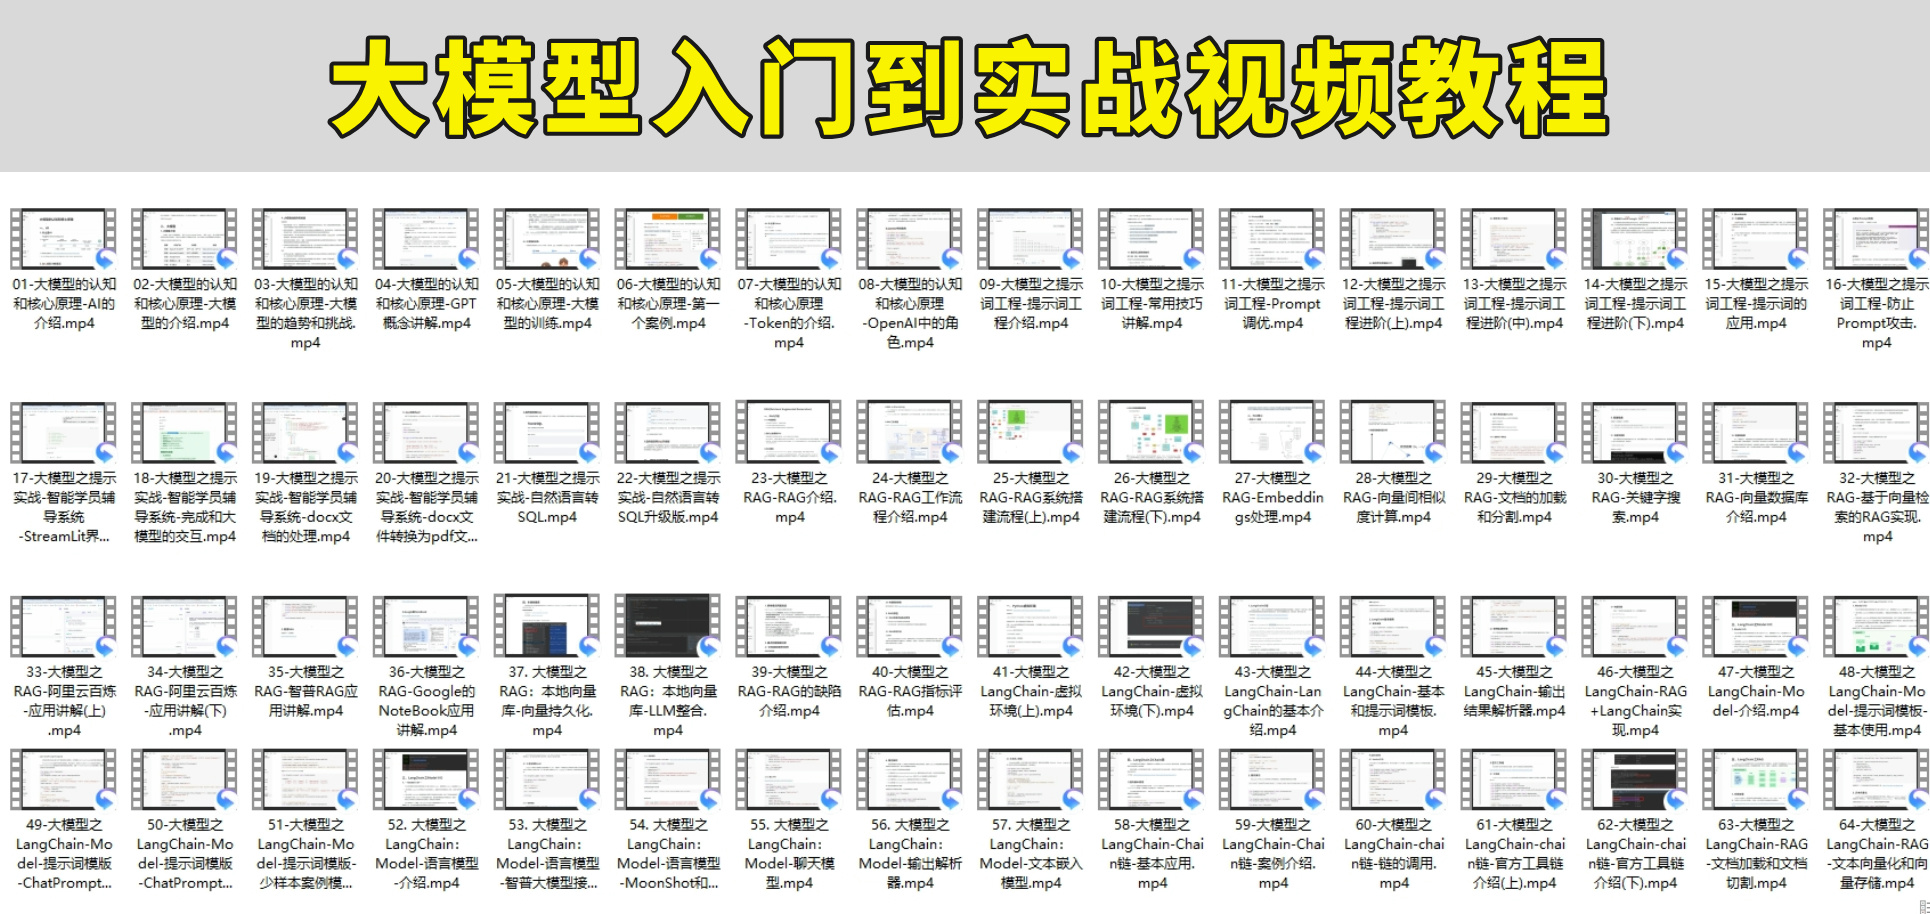
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
海量AI大模型必读的经典书籍(PDF)
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
600+AI大模型报告(实时更新)
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
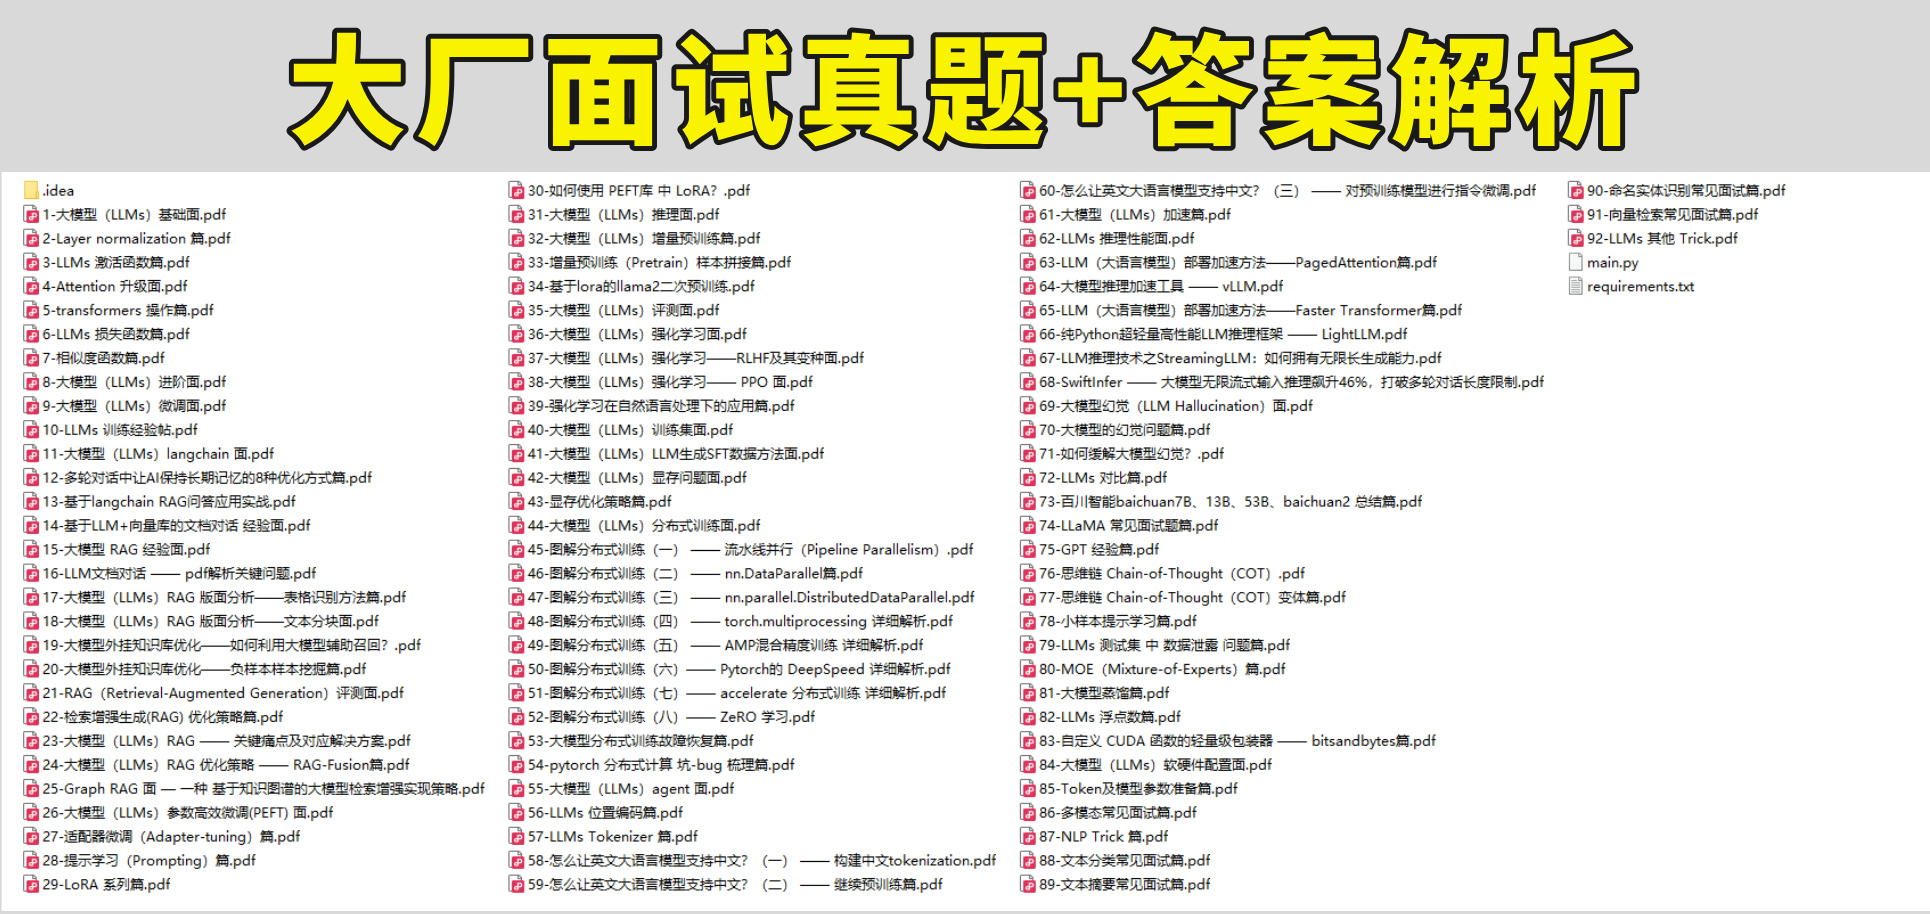
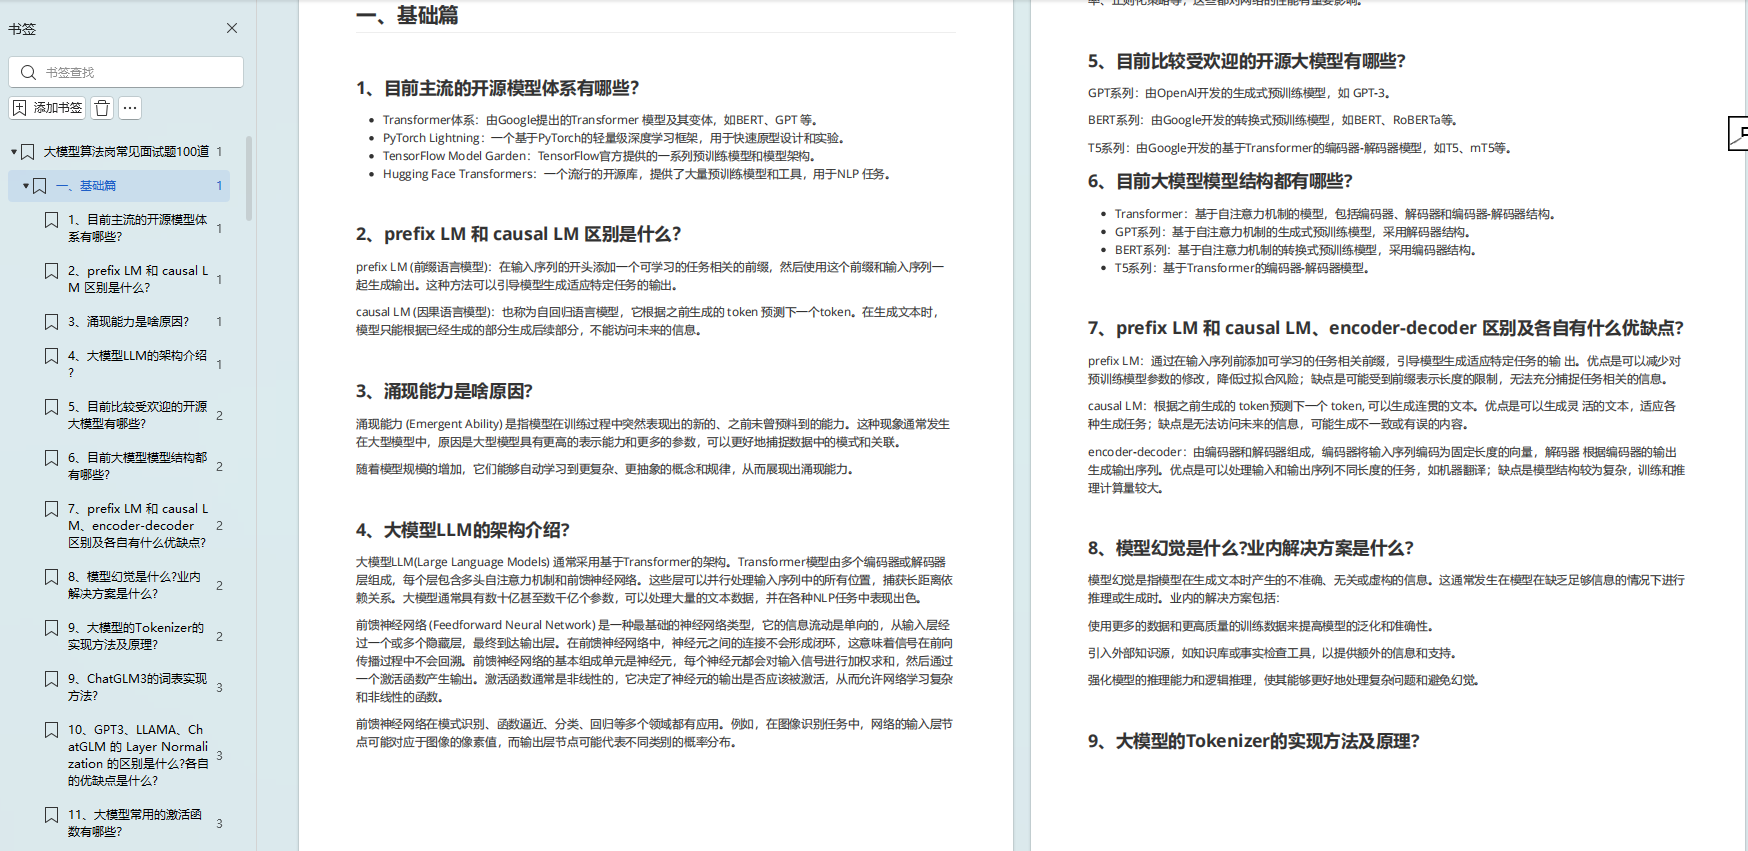
AI大模型面试真题+答案解析
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 10
 0
- 0


 已为社区贡献454条内容

所有评论(0)