MySQL
幻读(Phantom Read)是数据库并发控制中的一个现象,指在同一个事务中多次执行相同的查询操作,但在查询之间有其他事务插入了新的数据行,导致查询结果集发生变化,产生了额外的数据行。
具体来说,幻读发生在以下情况下:
- 事务T1在某个时间点执行了一个范围查询,返回了一组数据行。
- 在T1执行范围查询之后,事务T2在同一范围内插入了新的数据行。
- 事务T1再次执行相同的范围查询,发现结果集中出现了额外的数据行,这些数据行之前在第一次查询时是不存在的。
幻读与不可重复读(Non-repeatable Read)有些相似,但两者的重点不同。不可重复读主要关注的是在同一个事务中多次读取同一数据项时,其他事务对该数据项进行了修改,导致读取结果不一致。而幻读关注的是在同一个事务中多次执行相同的查询操作时,其他事务对查询结果集进行了修改,导致结果集发生了变化,出现了额外的数据行。
幻读可能会导致数据的不一致性和意外的结果。例如,一个事务在某个时间点查询了某个范围内的订单数量,并基于结果做出了决策。但在稍后的时间点,由于其他事务插入了新的订单,同样的查询会返回更多的订单数量,导致事务的决策产生了不一致性。
为了避免幻读,通常可以采用更严格的隔离级别,如Serializable(串行化)级别。在Serializable级别下,数据库会使用锁或其他机制保证范围查询期间的数据不会被其他事务修改,从而避免了幻读的出现。
1、聚合函数的用法:
count()
avg()
2、神奇的null,再参与运算的时候是怎样的
3、集合连接
左连接、右连接、自然连接(内连接)
4、窗口函数
5、
"You can't specify target table 'Person' for update in FROM clause":
https://chat.openai.com/share/a9253d37-74e8-41d9-8789-645da8665a41
这个错误提示 "You can't specify target table 'Person' for update in FROM clause" 是MySQL数据库中的一个常见错误。
它的含义是,在一个SQL查询中,你不能在FROM子句中直接引用目标表,并在同一个查询中对其进行更新操作。
这个错误通常发生在使用子查询或连接查询时,其中子查询或连接的结果涉及到要更新的目标表。MySQL的执行顺序限制了在同一个查询中直接对目标表进行更新操作。
为了解决这个问题,常见的方法是使用别名(Alias)来引用目标表,并将其作为子查询或连接操作的一部分。这样可以绕过MySQL的执行限制。
例如,假设你希望在表格'Person'中将所有名字为'John'的记录的年龄更新为30,你可以使用以下查询:
UPDATE Person
SET age = 30
WHERE id IN (
  SELECT id
  FROM (
    SELECT id
    FROM Person
    WHERE name = 'John'
  ) AS subquery
);
在上面的示例中,我们使用一个子查询来获取名字为'John'的记录的ID,然后将其作为更新操作的一部分。为了绕过错误,我们将子查询结果命名为'subquery'并使用别名进行引用。
通过使用别名,我们可以在同一个查询中引用目标表,并对其进行更新操作,从而解决了 "You can't specify target table 'Person' for update in FROM clause" 这个错误。
窗口函数:
建库建表准备数据:
CREATE DATABASE sales;
USE sales;
CREATE TABLE orders (
  order_id INT,
  customer_id INT,
  order_date DATE,
  total_amount DECIMAL(10, 2)
);

INSERT INTO orders (order_id, customer_id, order_date, total_amount)
VALUES
  (1, 1001, '2024-01-01', 100.00),
  (2, 1002, '2024-01-02', 200.00),
  (3, 1003, '2024-01-03', 150.00),
  (4, 1004, '2024-01-04', 300.00),
  (5, 1005, '2024-01-05', 250.00);
INSERT INTO orders (order_id, customer_id, order_date, total_amount)
VALUES
  (5, 1001, '2024-01-05', 100.00),
  (6, 1002, '2024-01-05', 200.00),
  (7, 1003, '2024-01-05', 150.00),
  (8, 1004, '2024-01-05', 300.00),
(9, 1005, '2024-01-06', 250.00); 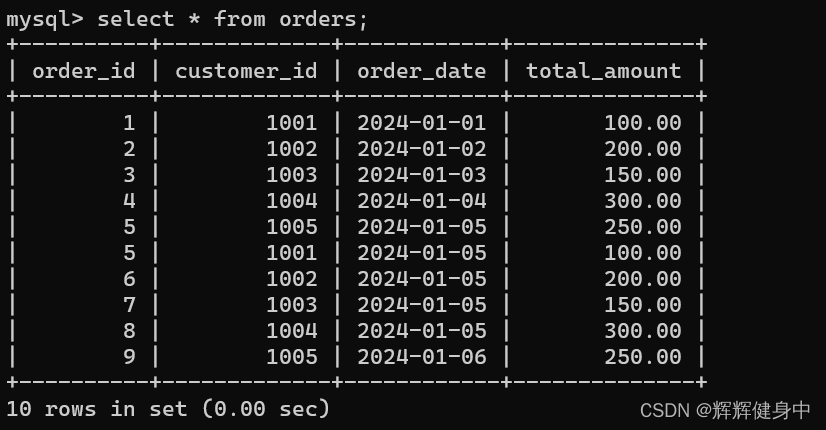
row_number():
·ROW_NUMBER(): 为每一行分配一个唯一的整数值,通常用于为结果集中的行进行编号。
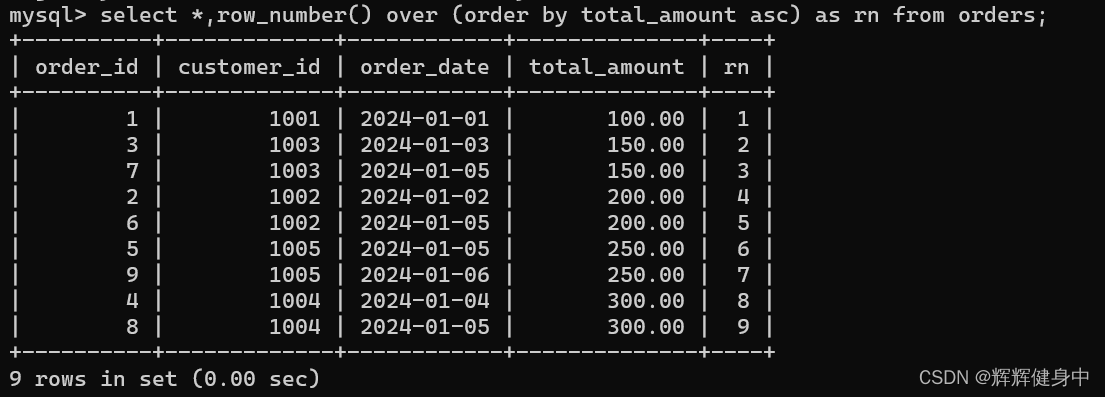
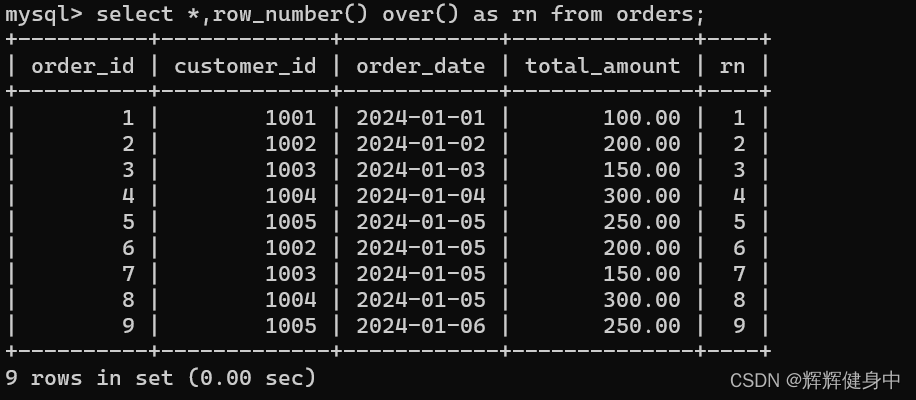
over() 即使没有内容也要些。
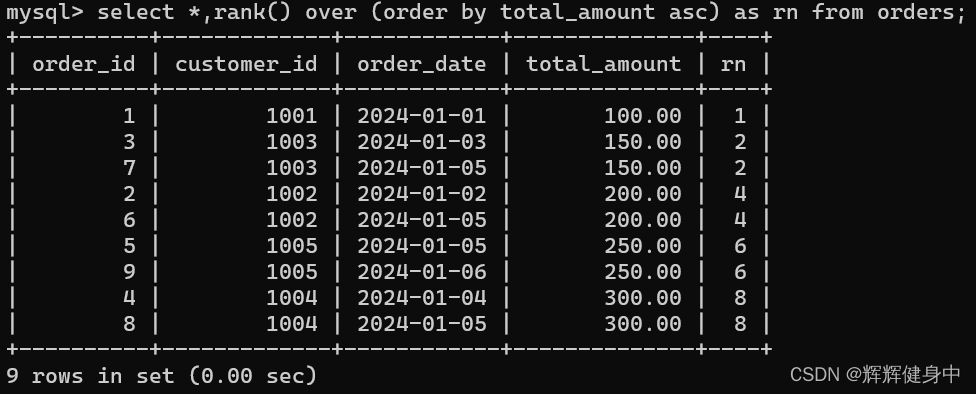
rank() :
·RANK(): 对结果集中的行进行排名,如果有相等的值,则相同值的行将获得相同的排名,并跳过下一个排名。
dense_rank():
·DENSE_RANK(): 类似于RANK()函数,但是在有相等的值时,相同值的行将获得相同的排名,并不会跳过下一个排名。
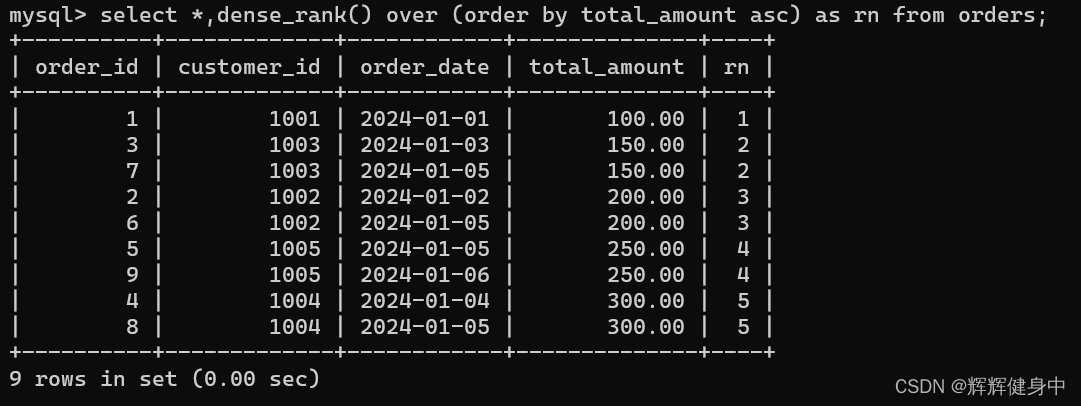
ntile():
·NTILE(n): 将结果集划分为n个相等大小的桶,并为每个行分配一个桶号。
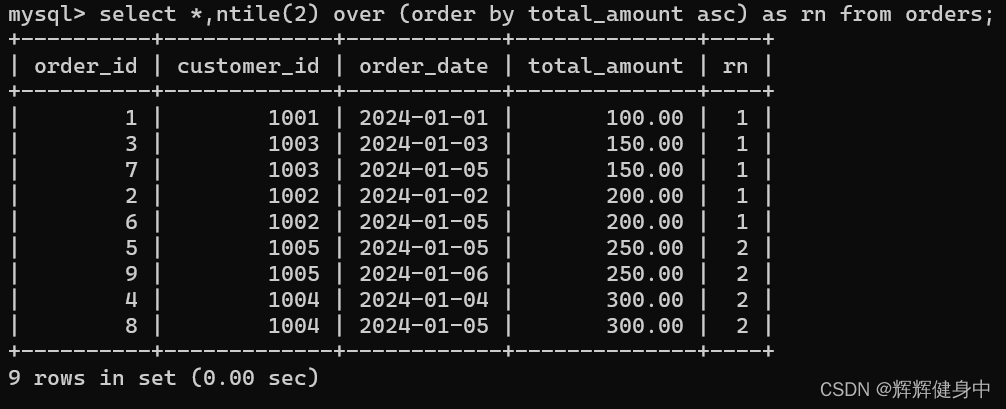
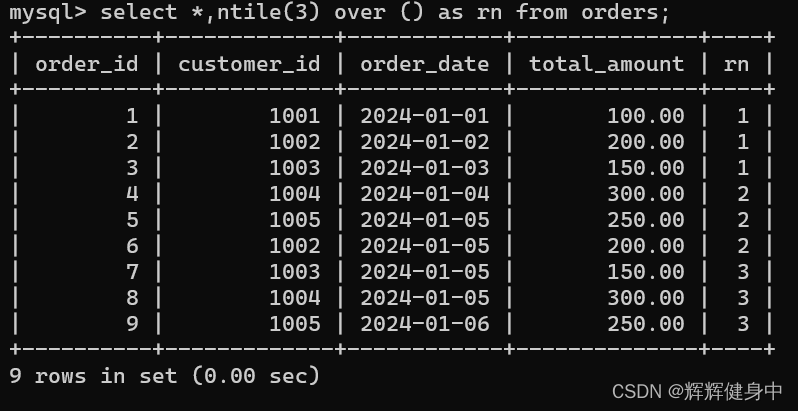
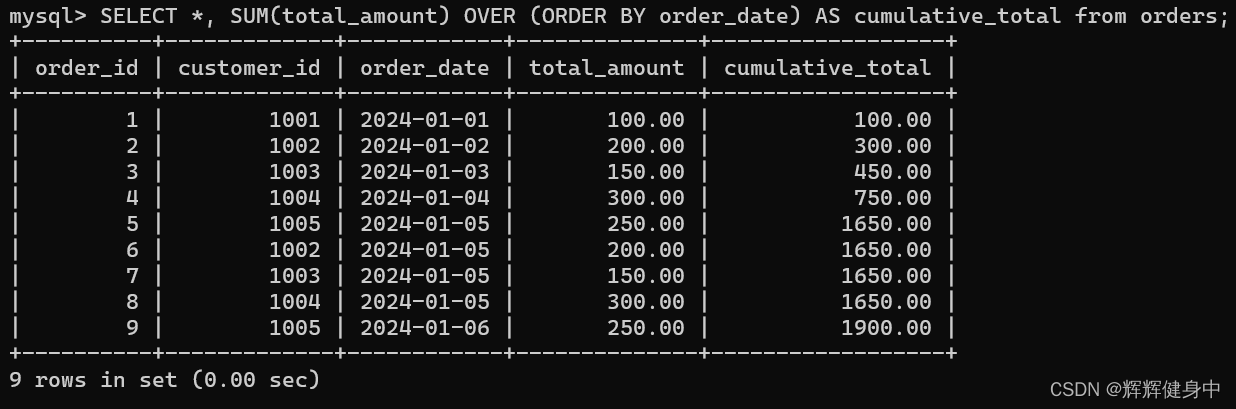
sum():
·SUM(column) OVER (partition_by_clause order_by_clause): 计算指定列的累积总和。
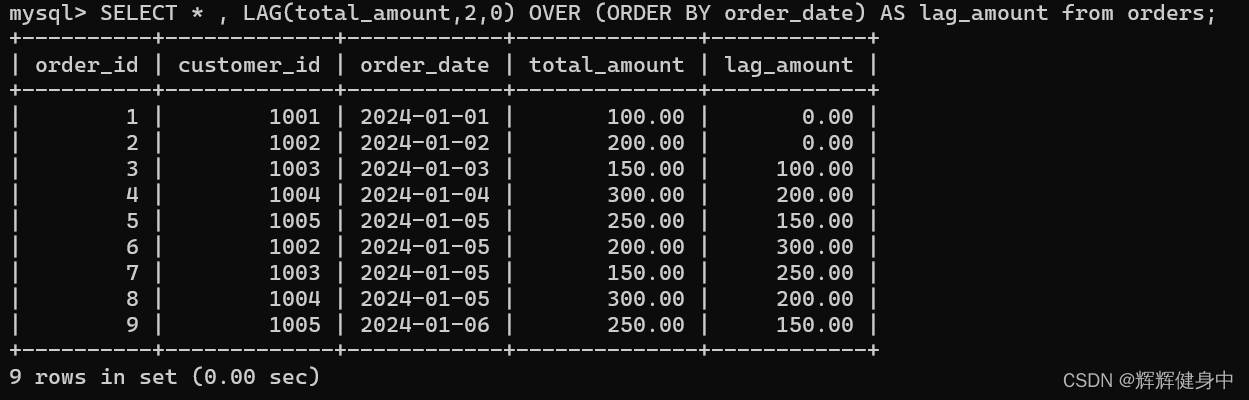
LAG():
·LAG(column, offset, default_value): 返回在当前行之前指定偏移量的行的值。偏移量可以是正数(表示向前偏移),不能为负数。(offset, default_value)默认为(1,null)。
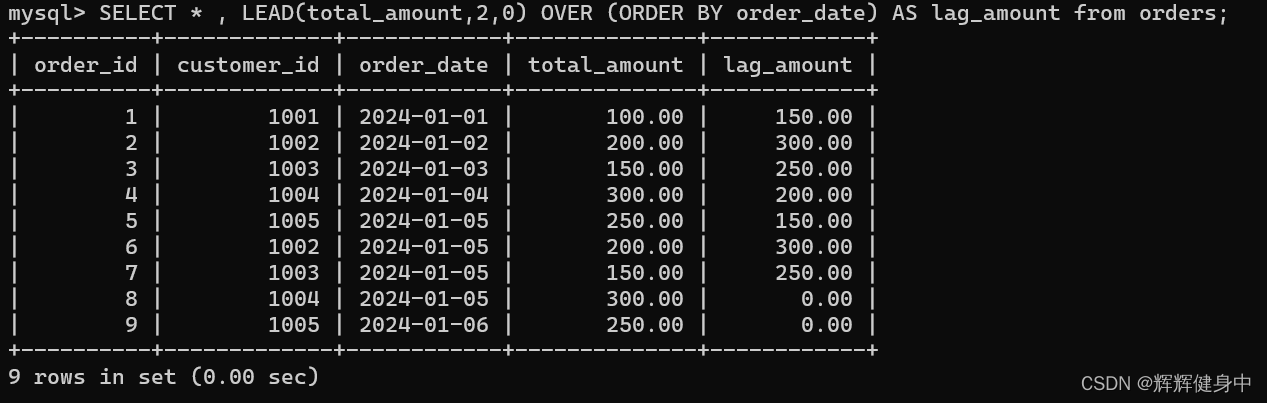
LEAD():
·LEAD(column, offset, default_value): 返回在当前行之后指定偏移量的行的值。偏移量可以是正数(表示向后偏移),不能为负数。(offset, default_value)默认为(1,null)
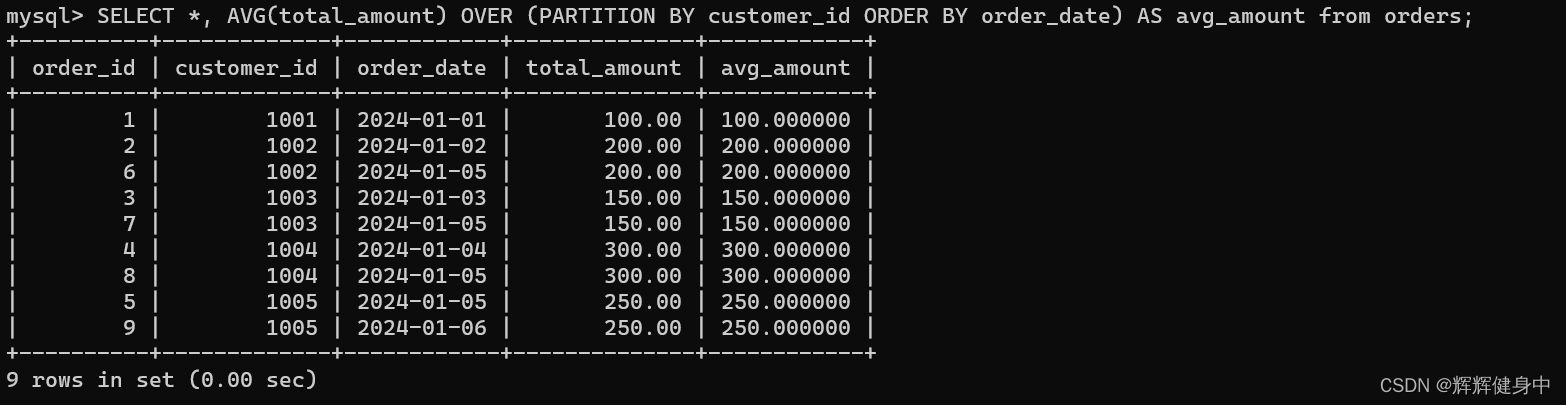
AVG():
·AVG(column) OVER (partition_by_clause order_by_clause): 计算指定列的累积平均值。
在MySQL中,如果您使用了
GROUP BY子句,SELECT列表中的列必须满足两个条件:
- 要么列是聚合函数(例如SUM、AVG、COUNT等)的参数。
- 要么列在GROUP BY子句中明确列出。
select order_id , customer_id from orders group by customer_id;只在
GROUP BY子句中使用了customer_id列,但在SELECT列表中使用了order_id列,而它既不是聚合函数的参数,也没有在GROUP BY子句中列出,因此会导致错误。
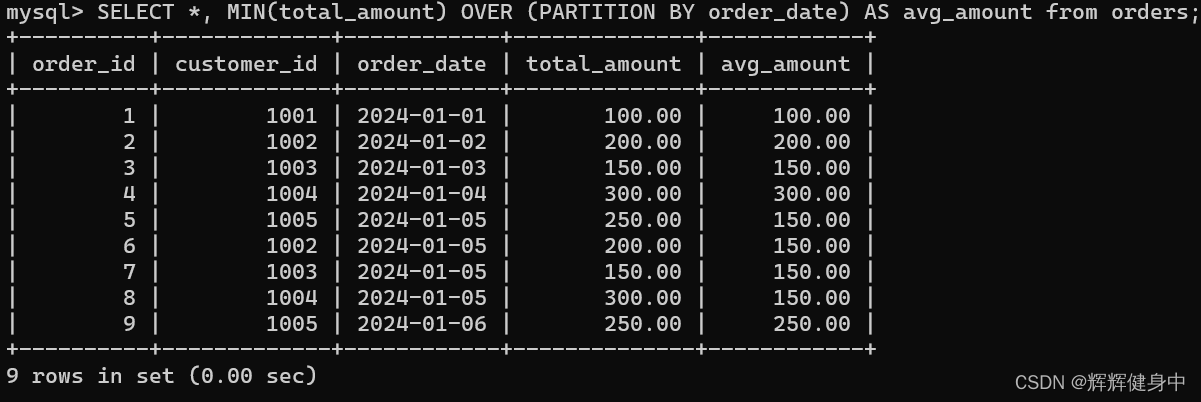
使用窗口函数AVG()不用担心整个问题,他会给每一行row都添加平均值,而不是删除行row。
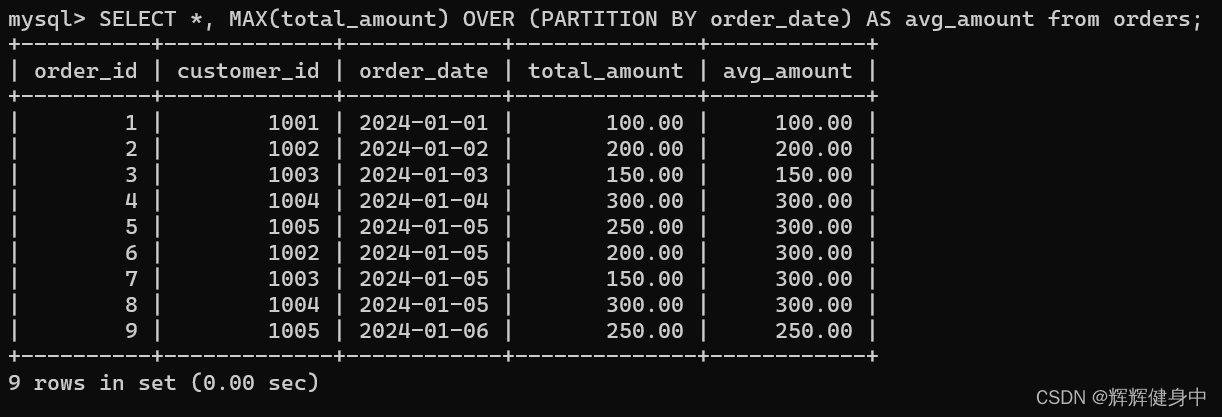
MAX():
·MAX(column) OVER (partition_by_clause order_by_clause): 计算指定列的累积最大值。
MIN():
·MIN(column) OVER (partition_by_clause order_by_clause): 计算指定列的累积最小值。
数据库相关术语:
当涉及到数据库时,以下是一些常见的数据库相关术语:
1. 数据库(Database):一个有组织的数据集合,用于存储和管理相关数据的集合。
2. 表(Table):在关系型数据库中,表是由行和列组成的数据结构,用于存储特定类型的数据。
3. 列(Column):表中的一个数据字段,表示表中的一种数据类型。
4. 行(Row):表中的一个记录,包含一组与列对应的数据。
5. 主键(Primary Key):在表中唯一标识每一行的列或列组合。它确保表中的每个行都具有唯一的标识。
6. 外键(Foreign Key):一个字段或一组字段,用于建立表与其他表之间的关系,它引用另一个表中的主键。
7. 索引(Index):用于提高数据库查询性能的数据结构。它可以加速数据的查找和排序。
8. 查询(Query):用于从数据库中检索和操作数据的命令。
9. 视图(View):虚拟表,是基于表或其他视图的查询结果定义的。它是一个可被查询的对象,但不实际存储数据。
10. 触发器(Trigger):与表关联的一段代码,定义在特定事件(如插入、更新和删除)发生时自动执行的操作。
11. 规范化(Normalization):数据库设计过程中的一种技术,旨在减少冗余数据并提高数据的一致性和完整性。
12. 关系型数据库(Relational Database):使用表、行和列来组织和存储数据的数据库类型。关系型数据库基于关系代数和SQL进行查询和操作。
13. 非关系型数据库(Non-relational Database):也称为NoSQL数据库,不使用传统的表格结构,而是使用键值对、文档、图形或列族等不同的数据模型。
这些是数据库领域中的一些常见术语,用于描述和操作数据存储和管理的相关概念。
常见的优化手段:
SQL优化是提高查询性能的重要任务之一。以下是一些常见的SQL优化手段和示例:
1. 选择恰当的列:
- 仅选择需要的列,避免不必要的数据传输和处理。
- 避免使用"SELECT *",而是明确列出所需的列。 示例:
-- 不推荐的写法
SELECT * FROM customers;

-- 推荐的写法
SELECT customer_id, customer_name FROM customers;
2. 使用合适的索引:
- 根据查询条件和频繁使用的列创建合适的索引。
- 避免在列上使用函数或表达式,以保持索引的有效性。 示例:-- 创建索引 CREATE INDEX idx_customer_name ON customers (customer_name); -- 使用索引进行查询 SELECT * FROM customers WHERE customer_name = 'John';3. 避免不必要的连接:
- 优化查询,避免使用过多的连接操作。
- 使用内连接(INNER JOIN)而不是外连接(LEFT JOIN、RIGHT JOIN)时,确保连接条件准确。 示例:-- 不必要的连接 SELECT * FROM orders JOIN customers ON orders.customer_id = customers.customer_id WHERE customers.customer_name = 'John'; -- 避免不必要的连接 SELECT * FROM orders WHERE customer_id = (SELECT customer_id FROM customers WHERE customer_name = 'John');4. 编写高效的子查询:
- 优化子查询,确保它们能够高效地执行。
- 尽可能使用连接操作或其他更有效的方法替代子查询。 示例:
-- 低效的子查询
SELECT * FROM orders
WHERE customer_id IN (SELECT customer_id FROM customers WHERE customer_name = 'John');

-- 更高效的连接操作
SELECT * FROM orders
JOIN customers ON orders.customer_id = customers.customer_id
WHERE customers.customer_name = 'John';
5. 使用合适的聚合函数:
- 在使用聚合函数时,选择合适的函数来满足需求。
- 避免在大数据集上使用耗时的聚合函数,考虑使用汇总表或缓存来提高性能。 示例:-- 低效的聚合函数 SELECT AVG(total_amount) FROM orders; -- 高效的聚合函数 SELECT SUM(total_amount) / COUNT(*) FROM orders;这些是SQL优化的一些常见手段和示例,但实际优化需根据具体情况进行评估和调整。优化查询性能是一个综合性的任务,需要考虑多个因素,如数据量、索引设计、查询结构和数据库配置等。
join:
集合运算中的 JOIN 是一种常见的操作,用于将两个或多个表中的数据按照指定的连接条件进行匹配和组合。JOIN 操作基于列之间的关系,可以在查询结果中获取来自不同表的相关数据。
常见的 JOIN 类型包括:
1. 内连接(INNER JOIN):返回两个表中匹配的行。只有在连接条件满足时,才返回结果。
示例:
SELECT *
FROM table1
INNER JOIN table2
ON table1.column = table2.column;
2. 左连接(LEFT JOIN):返回左表中的所有行,以及右表中满足连接条件的匹配行。如果右表中没有匹配的行,则返回 NULL 值。
示例:
SELECT *
FROM table1
LEFT JOIN table2
ON table1.column = table2.column;
3. 右连接(RIGHT JOIN):返回右表中的所有行,以及左表中满足连接条件的匹配行。如果左表中没有匹配的行,则返回 NULL 值。
示例:
SELECT *
FROM table1
RIGHT JOIN table2
ON table1.column = table2.column;
4. 全连接(FULL JOIN):返回左表和右表中的所有行,不管是否满足连接条件。如果某个表中没有匹配的行,则返回 NULL 值。
示例:
SELECT *
FROM table1
FULL JOIN table2
ON table1.column = table2.column;
5. 自连接(Self Join):将表与自身进行连接,常用于需要比较同一表中的不同行的情况。
示例:
SELECT *
FROM table1 t1
INNER JOIN table1 t2
ON t1.column = t2.column;
在使用 JOIN 操作时,需要明确连接条件,并确保连接条件正确地匹配了关联的列。此外,对于大型表和复杂的连接操作,优化查询性能可能需要考虑适当的索引设计和查询重写等技术。
inner join:2表值都存在
outer join:附表中值可能存在null的情况。
总结:
①A inner join B:取交集
②A left join B:取A全部,B没有对应的值,则为null
③A right join B:取B全部,A没有对应的值,则为null
④A full outer join B:取并集,彼此没有对应的值为null
上述4种的对应条件,在on后填写。
子表命名:
在SQL中,对子查询(子表)是否需要命名取决于它出现的上下文。
必须命名的情况
-
作为FROM子句的一部分: 当子查询作为一个表出现在FROM子句中时,必须给它命名(即提供一个别名),因为在查询的其他部分可能需要引用这个子查询产生的结果集。
SELECT T.col1 FROM (SELECT col1 FROM Table1) AS T;在这个例子中,子查询选择
Table1的col1列,并被命名为T,以便在外部查询中引用。 -
在JOIN操作中: 当子查询用于JOIN操作中,需要给出别名,以便能够指定JOIN条件。
SELECT *
FROM Table1 AS T1 JOIN
    (SELECT col1 FROM Table2) AS T2
    ON T1.col1 = T2.col1;
这里,子查询从
Table2中选择col1列,并作为T2参与JOIN操作。
不需要命名的情况
-
作为条件子句的一部分: 如果子查询用在WHERE或者HAVING子句中,通常不需要别名。
SELECT col1 FROM Table1 WHERE col2 IN (SELECT col2 FROM Table2);在这个例子中,子查询用于检查
col2的值是否包含在Table2的col2列中。 -
作为列的计算部分: 当子查询作为SELECT列表中的一个列计算时,不需要别名
SELECT (SELECT MAX(col1) FROM Table2) AS MaxValue FROM Table1;这里,子查询用来计算
Table2中col1的最大值,并作为外查询的一个结果列。
总结,是否需要为子查询命名取决于它在SQL语句中的作用和位置。在必须区分或引用子查询结果集时,通常需要提供别名。
MySQL有哪些关键字?
MySQL中的关键字可以按照它们在SQL语句中的作用和功能进行分类。这些关键字定义了SQL语句的结构和行为,帮助操作和管理数据库中的数据。以下是一些主要分类及其对应的关键字示例:
### 数据定义语言(DDL)
DDL关键字用于定义和修改数据库结构,包括创建、修改、删除数据库对象(如表、索引、触发器等)。
- `CREATE`: 创建数据库对象,如表、索引、视图等。
- `ALTER`: 修改数据库对象的结构。
- `DROP`: 删除数据库对象。
- `TRUNCATE`: 删除表中的数据,但不删除表本身。
- `RENAME`: 重命名数据库对象。### 数据操作语言(DML)
DML关键字用于处理数据库中的数据,如插入、修改、删除数据。
- `INSERT`: 向表中插入新的数据行。
- `UPDATE`: 更新表中的数据。
- `DELETE`: 删除表中的数据。
- `SELECT`: 查询表中的数据。### 数据控制语言(DCL)
DCL关键字用于控制对数据库的访问和权限。
- `GRANT`: 授予用户权限。
- `REVOKE`: 撤销用户权限。### 事务控制语言(TCL)
TCL关键字用于管理数据库中的事务,保证数据的一致性和完整性。
- `BEGIN` or `START TRANSACTION`: 开始一个事务。
- `COMMIT`: 提交当前事务,使所有更改成为永久性的。
- `ROLLBACK`: 回滚当前事务,撤销所有更改。
- `SAVEPOINT`: 创建事务中的保存点。### 其他关键字
还有一些其他关键字用于特定功能,如查询优化、连接、条件判断等。
- `JOIN`: 用于表的连接操作。
- `WHERE`: 用于过滤查询结果。
- `GROUP BY`: 用于按特定列分组查询结果。
- `ORDER BY`: 用于排序查询结果。
- `LIMIT`: 用于限制查询结果的数量。
- `UNION`: 用于合并两个或多个`SELECT`语句的结果集。这些关键字是SQL语言的组成部分,通过组合这些关键字,可以构建用于各种数据操作和管理任务的SQL语句。
解释MySQL中每一个关键字的具体含义和用法会非常详细,因此我将给出一些关键字的简要说明:
- `SELECT`: 用于从一个或多个表中查询数据。
- `INSERT`: 用于向表中插入新的行。
- `UPDATE`: 用于更新表中的数据。
- `DELETE`: 用于从表中删除数据。
- `FROM`: 在`SELECT`语句中指定要查询的表。
- `WHERE`: 用于过滤查询结果,指定查询条件。
- `GROUP BY`: 用于根据一个或多个列将结果集分组。
- `ORDER BY`: 用于对结果集进行排序。
- `LIMIT`: 用于限制查询结果的数量。
- `JOIN`: 用于通过在两个或多个表中的列之间的关系来组合行。
- `LEFT JOIN`: 产生包括左表(FROM之前的表)的所有行的结果集,即使右表(JOIN之后的表)中没有匹配。
- `RIGHT JOIN`: 产生包括右表的所有行的结果集,即使左表中没有匹配。
- `INNER JOIN`: 只产生两个表中都有匹配的行的结果集。
- `OUTER JOIN`: 包括左表或右表中的行,即使另一表中没有匹配。
- `ON`: 用于`JOIN`中指定连接条件。
- `UNION`: 用于合并两个或多个`SELECT`语句的结果集。
- `CREATE`: 用于创建新的数据库、表、索引等对象。
- `ALTER`: 用于修改现有的数据库对象,如表。
- `DROP`: 用于删除数据库对象。
- `TRUNCATE`: 用于删除表中的所有行,但不删除表本身。
- `INDEX`: 用于创建或删除索引。
- `TABLE`: 通常用于`CREATE TABLE`、`ALTER TABLE`、`DROP TABLE`等语句中指定表对象。
- `VIEW`: 用于创建或删除视图。
- `TRIGGER`: 用于创建或删除触发器。
- `GRANT`: 用于授权用户访问权限。
- `REVOKE`: 用于撤销用户的访问权限。
- `COMMIT`: 用于提交当前事务,使所有更改成为永久性的。
- `ROLLBACK`: 用于回滚当前事务,撤销所有更改。
- `SAVEPOINT`: 用于在事务内创建一个可以回滚的点。
- `LOCK`: 用于锁定表或数据库,以控制并发访问。
- `UNLOCK`: 用于解锁之前锁定的表或数据库。
- `BEGIN`: 标志事务的开始。
- `DECLARE`: 在程序代码(如存储过程或函数)中用于声明变量。
- `CASE`: 用于条件选择,类似于其他编程语言中的`switch-case`结构。
- `WHEN`: 与`CASE`一起使用,定义条件。
- `THEN`: 与`CASE`和`WHEN`一起使用,指定满足条件时的结果。
- `ELSE`: 与`CASE`一起使用,定义当没有条件匹配时的结果。
- `END`: 结束`CASE`语句或存储过程、函数的体。
- `IF`: 用于在存储过程或函数中进行条件判断。
- `ELSEIF`: 在`IF`语句中使用,定义另一个条件分支。
- `LOOP`: 用于在存储过程或函数中定义循环。
- `WHILE`: 用于定义条件循环。
- `REPEAT`: 用于定义直到满足条件才结束的循环。
- `FUNCTION`: 用于创建函数。
- `PROCEDURE`: 用于创建存储过程。这些关键字构成了MySQL语言的核心部分,通过它们可以实现对数据库的结构和数据的各种操作。
这里是对刚才列举的一些常用MySQL函数的解释:
- `CONCAT()`: 用于连接两个或多个字符串。例如,`CONCAT('Hello', ' ', 'World')` 返回 `'Hello World'`。
- `SUBSTRING()`: 从字符串中提取子字符串。例如,`SUBSTRING('Hello World', 1, 5)` 返回 `'Hello'`。
- `LENGTH()`: 返回字符串的长度。例如,`LENGTH('Hello')` 返回 `5`。
- `REPLACE()`: 在字符串中替换子字符串。例如,`REPLACE('Hello World', 'World', 'MySQL')` 返回 `'Hello MySQL'`。
- `UPPER()`: 将字符串转换为大写。例如,`UPPER('Hello')` 返回 `'HELLO'`。
- `LOWER()`: 将字符串转换为小写。例如,`LOWER('HELLO')` 返回 `'hello'`。
- `TRIM()`: 去除字符串两端的空格或其他指定的字符。例如,`TRIM(' Hello ')` 返回 `'Hello'`。
- `CAST()`: 将一种类型的数据转换为另一种类型。例如,`CAST('123' AS UNSIGNED)` 将字符串 `'123'` 转换为数字 `123`。
- `CONVERT()`: 与 `CAST()` 类似,用于数据类型转换。例如,`CONVERT('123', UNSIGNED)` 也是将字符串 `'123'` 转换为数字 `123`。
- `NOW()`: 返回当前的日期和时间。例如,`NOW()` 可能返回 `2023-04-07 12:34:56`。
- `CURDATE()`: 返回当前的日期。例如,`CURDATE()` 可能返回 `2023-04-07`。
- `CURTIME()`: 返回当前的时间。例如,`CURTIME()` 可能返回 `12:34:56`。
- `DATE_FORMAT()`: 按指定格式显示日期或时间。例如,`DATE_FORMAT(NOW(), '%Y-%m-%d')` 返回 `2023-04-07`。
- `DAY()`: 返回日期的天部分。例如,`DAY('2023-04-07')` 返回 `7`。
- `MONTH()`: 返回日期的月部分。例如,`MONTH('2023-04-07')` 返回 `4`。
- `YEAR()`: 返回日期的年部分。例如,`YEAR('2023-04-07')` 返回 `2023`。
- `ROUND()`: 将数字四舍五入到指定的小数位数。例如,`ROUND(123.4567, 2)` 返回 `123.46`。
- `CEILING()`: 返回大于或等于给定数字的最小整数。例如,`CEILING(123.456)` 返回 `124`。
- `FLOOR()`: 返回小于或等于给定数字的最大整数。例如,`FLOOR(123.456)` 返回 `123`。
- `RAND()`: 返回0到1之间的随机数。例如,`RAND()` 可能返回 `0.123456`。
- `COUNT()`: 返回查询结果的行数。例如,`COUNT(*)` 用于计算表中的总行数。
- `SUM()`: 返回数值列的总和。例如,`SUM(price)` 计算 `price` 列的总和。
- `AVG()`: 返回数值列的平均值。例如,`AVG(price)` 计算 `price` 列的平均值。
- `MIN()`: 返回列中的最小值。例如,`MIN(price)` 返回 `price` 列的最小值。
- `MAX()`: 返回列中的最大值。例如,`MAX(price)` 返回 `price` 列的最大值。
- `GROUP_CONCAT()`: 将多行值连接为一个字符串。例如,`GROUP_CONCAT(name)` 会将多个 `name` 值连接成一个字符串。
- `COALESCE()`: 返回参数列表中第一个非`NULL`值。例如,`COALESCE(NULL, 'Hello', 'World')` 返回 `'Hello'`。
- `IFNULL()`: 如果第一个参数不是`NULL`,返回第一个参数,否则返回第二个参数。例如,`IFNULL(NULL, 'Hello')` 返回 `'Hello'`。
- `NULLIF()`: 如果两个参数相等,返回`NULL`;否则,返回第一个参数。例如,`NULLIF('Hello', 'Hello')` 返回 `NULL`。
- `MD5()`: 返回字符串的MD5哈希值。例如,`MD5('password')` 返回 `'5f4dcc3b5aa765d61d8327deb882cf99'`。
- `SHA1()`: 返回字符串的SHA-1哈希值。例如,`SHA1('password')` 返回 `'5baa61e4c9b93f3f0682250b6cf8331b7ee68fd8'`。这些函数在MySQL中非常常用,它们涵盖了字符串处理、日期和时间处理、数值计算、聚合计算等多种功能。
别人的MySQL代码?
好代码集锦
# Write your MySQL query statement below
-- SELECT
--     C.to_id AS person1,
--     C.from_id AS person2,
--     COUNT(*)/2 AS call_count,
--     SUM(C.duration)/2 AS total_duration
-- FROM
--     (
--         (SELECT to_id AS from_id, from_id AS to_id, duration FROM Calls)
--         UNION ALL
--         (SELECT * FROM Calls)
--     ) AS C
-- GROUP BY LEAST(C.from_id, C.to_id), GREATEST(C.from_id, C.to_id);

-- LEAST (将列表的值进行比较得到最小值)
-- GREATEST(将列表的值进行比较得到最大值)
-- 这样要来(2,1)(1,2)就是同一组了


select
   (case when from_id<to_id then from_id else to_id end) as person1,
   (case when to_id>from_id then to_id else from_id end) as person2,
   count(*) as call_count,
   sum(duration) as total_duration
from Calls
group by person1,person2
-- 优秀,确实优秀
-- 还引出一个问题:sql命令的执行原理,过程
-- 分组还能这么分啊 还带是大哥你啊
SQL命令的执行过程及原理?
了解您想要了解SQL语句的逻辑执行顺序,即在处理查询时各个部分是如何按顺序执行的。以下是SQL命令在逻辑上的执行顺序,这对于理解如何编写有效的SQL语句非常重要:
1. **`FROM`子句**
- 首先执行,确定查询的主表或视图,以及需要连接的任何其他表。
- 这一步涉及数据的读取,可能包括物理表、视图或子查询。2. **`JOIN`**
- 如果有多个表,将按照`FROM`子句中指定的顺序进行连接。
- 在这一步中执行任何`ON`条件来确定如何连接表。3. **`WHERE`子句**
- 然后过滤从`FROM`子句和`JOIN`操作中获取的结果集。
- 只有符合`WHERE`子句条件的行才会包含在后续的处理步骤中。4. **`GROUP BY`子句**
- 对过滤后的结果集进行分组。
- 用于后续的聚合计算,如计算每个组的总和、平均值等。5. **聚合函数**
- 如`SUM()`, `AVG()`, `COUNT()`等,在`GROUP BY`后执行。
- 对每个分组执行聚合操作。6. **`HAVING`子句**
- 在`GROUP BY`和聚合函数之后执行,用于过滤聚合后的结果集。
- 只有符合`HAVING`条件的分组才会包含在最终的结果集中。7. **`SELECT`子句**
- 确定并计算要返回的列。
- 在此步骤中,可以使用函数、表达式、别名等对数据进行处理和转换。8. **`DISTINCT`子句**
- 如果使用`SELECT DISTINCT`,则在`SELECT`后去除重复的行。9. **`ORDER BY`子句**
- 对结果集进行排序。
- 这一步骤通常是查询处理的最后阶段,确保输出的顺序符合用户要求。10. **`LIMIT`子句**
- 最后执行,限制要返回的记录数,常用于分页处理。理解这个顺序对于编写有效的SQL语句非常重要,因为它影响数据如何被过滤、排序和显示。例如,`WHERE`子句中的过滤先于`SELECT`的字段选择,这意味着过滤工作发生在数据列被选取和处理之前。
要深入理解SQL查询的执行过程,我们可以进一步探讨各个阶段的内部工作原理及其对查询性能的影响。这将帮助我们更好地理解如何优化SQL查询以提高效率。
### 1. `FROM`子句和`JOIN`
- **数据源选择**:`FROM`子句定义了查询的主要数据源,可以是表、视图或子查询。
- **表扫描与索引**:在从指定的数据源读取数据时,数据库决定使用全表扫描还是索引扫描。如果存在适用的索引,数据库可能会使用索引来加速数据检索过程。
- **连接操作**:当涉及到多个表时,`JOIN`操作决定了这些表是如何关联的。数据库会根据`JOIN`条件,使用嵌套循环连接、散列连接或合并连接等策略来执行。### 2. `WHERE`子句
- **行过滤**:`WHERE`子句对读取的数据行进行过滤,只保留满足条件的行。这个阶段很关键,因为它直接减少了后续操作需要处理的数据量。### 3. `GROUP BY`子句和聚合函数
- **数据分组**:`GROUP BY`子句将数据分成多个组,以便对每个组独立进行聚合计算。
- **聚合操作**:聚合函数(如`SUM`、`COUNT`、`AVG`等)在每个组上执行,计算出每组的聚合值。### 4. `HAVING`子句
- **组过滤**:与`WHERE`子句类似,`HAVING`子句对聚合后的组进行过滤,但是它是在聚合计算之后进行。### 5. `SELECT`子句
- **字段处理**:在`SELECT`子句中指定的字段和表达式现在被计算和构造。如果查询包含对数据的转换或计算,这些操作也在这一步骤完成。### 6. `DISTINCT`子句
- **去重**:`DISTINCT`子句用于移除结果集中的重复行,确保每行都是唯一的。### 7. `ORDER BY`子句
- **结果排序**:`ORDER BY`子句对最终的结果集进行排序,确保输出的顺序符合指定的条件。### 8. `LIMIT`子句
- **限制输出**:`LIMIT`子句在最后执行,用于限制查询结果的数量,这常用于实现分页功能。### 性能优化
- **索引使用**:通过适当的索引,可以加快`WHERE`和`JOIN`条件的处理速度,以及`ORDER BY`和`GROUP BY`的排序和分组操作。
- **执行计划分析**:利用数据库提供的执行计划工具可以分析查询的执行过程和资源消耗,从而发现性能瓶颈和优化点。理解这些执行步骤和它们之间的关系,可以帮助开发者和数据库管理员编写更高效的SQL查询,以及进行必要的性能调优。通过优化查询的结构和逻辑,可以显著提高数据检索的速度和减少数据库的负载。
with公共表表达式:
在SQL中,WITH子句是一种常用的语法,也被称为"公共表表达式"(Common Table Expression,CTE)。它允许您创建一个临时的命名结果集,以供后续查询使用。
语法结构如下:
WITH <cte_name> AS (
    <cte_query>
)
SELECT <columns>
FROM <cte_name>
<additional_clauses>;
其中:
<cte_name>是临时表的名称,您可以为其指定任何合法的标识符。<cte_query>是定义临时表的查询语句。<columns>是您要从临时表中选择的列。<additional_clauses>是可选的,用于进一步筛选或排序查询结果的其他语句(如WHERE、GROUP BY等)。在您提供的查询中,使用了两个WITH子句。第一个WITH子句创建了一个名为
temp的临时表,其中包含cinema表中free为1的座位,并计算了每个座位ID与其行号之差,赋值给名为k的列。第二个WITH子句在temp表上执行了另一个查询,从中选择了k值在temp表中出现至少两次的座位ID。请注意,WITH子句不是SQL的必需部分,您可以直接编写单个查询,而不使用WITH子句。但使用WITH子句可以提高查询的可读性和可维护性,尤其是在需要多次引用相同的临时结果集时。
用户定义变量:
SELECT period_state, MIN(date) as start_date, MAX(date) as end_date
FROM (
    SELECT
        success_date AS date,
        "succeeded" AS period_state,
        IF(DATEDIFF(@pre_date, @pre_date := success_date) = -1, @id, @id := @id+1) AS id
    FROM Succeeded, (SELECT @id := 0, @pre_date := NULL) AS temp --此处隐式的声明变量
    UNION
    SELECT
        fail_date AS date,
        "failed" AS period_state,
        IF(DATEDIFF(@pre_date, @pre_date := fail_date) = -1, @id, @id := @id+1) AS id
    FROM Failed, (SELECT @id := 0, @pre_date := NULL) AS temp --此处隐式的声明了变量
) T  WHERE date BETWEEN "2019-01-01" AND "2019-12-31"
GROUP BY T.id
ORDER BY start_date ASC
在 MySQL 中,变量主要分为两类:用户定义的变量和系统变量。这两类变量支持不同的操作和用途:
### 用户定义的变量
1. **定义和初始化:**
- 使用 `SET @variable_name = value;` 或 `SELECT @variable_name := value;` 来定义并初始化变量。
2. **读取:**
- 直接使用 `@variable_name` 在查询中引用变量的值。
3. **赋值:**
- 可以在任何 SQL 语句中使用 `:=` 对变量进行重新赋值。
4. **计算:**
- 可以在表达式中使用变量,进行数学运算、字符串操作、日期计算等。### 系统变量
1. **全局变量 vs 会话变量:**
- 全局变量影响服务器的整体操作。通过 `SHOW GLOBAL VARIABLES;` 查看。
- 会话(或局部)变量仅影响当前连接。通过 `SHOW SESSION VARIABLES;` 查看。
2. **设置变量值:**
- 使用 `SET GLOBAL variable_name = value;` 修改全局变量。
- 使用 `SET SESSION variable_name = value;` 或 `SET @@session.variable_name = value;` 修改会话变量。
3. **读取变量值:**
- 使用 `SELECT @@global.variable_name;` 或 `SELECT @@session.variable_name;` 读取变量值。### 特殊用法
- 用户定义的变量通常用于存储查询结果,作为临时变量,在存储过程、函数或批量操作中特别有用。
- 系统变量用于配置和管理 MySQL 服务器的行为,如调整缓冲区大小、设置连接超时等。用户定义的变量在一次查询或会话中持续存在,而不是跨会话。它们在使用前不需要声明数据类型,因为类型会根据赋值时的上下文自动确定。
### 注意事项
- 用户定义的变量在同一会话中是共享的,但在不同会话间是隔离的。
- 系统变量的更改(特别是全局变量)可以影响所有用户的数据库操作,因此需要谨慎操作。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 30
 0
- 0


 已为社区贡献1条内容

所有评论(0)