如何理解 Transformer 中的 Query、Key 与 Value
参考链接:
https://blog.csdn.net/weixin_36896856/article/details/103471086
我相信有一堆人和我一样刚开始看Transformer 中的 Query、Key 与 Value都是一脸懵逼,参考链接里算是比较容易看懂的,但我觉得仅仅讲清楚了怎么计算Query、Key 与 Value与Transformer计算过程,却没讲为什么这样算,自己很幸运看了同样是2017凯明大神的一篇文章:《Non-local Neural Networks》,同年google的《Attention is all you need》引入transform模块,我还特意去查了下凯明大神那段时间是不是在google工作过,但貌似2016年就进了facebook,回到正题,《Non-local Neural Networks》还没有把名称定义为注意力,而是非局部,主要是为了捕捉长时依赖(相关性),灵感来源于2005年的顶尖图像去噪算法BM3D、NL-means,这个去噪算法就是非局部的去噪算法:

传统的去噪算法,例如均值滤波,高斯滤波,中值滤波都是基于某点的领域加权计算来实现去噪,都是局部的,而非局部的方法,不仅仅取该点领域x,而且会去计算其他区域y与x相似度(相关度)综合加权来去噪,效果达到了传统图像最好的去噪效果,假如相x,y关度计算函数为f,y区域滤波函数为g,则最终的结果可以表示为:
相关度计算可以是点积:
也可以是高斯:
还可以是嵌入高斯:
经过实验,相关度的计算方式对性能几乎没影响。
还可以用softmax表示:
 ,
,
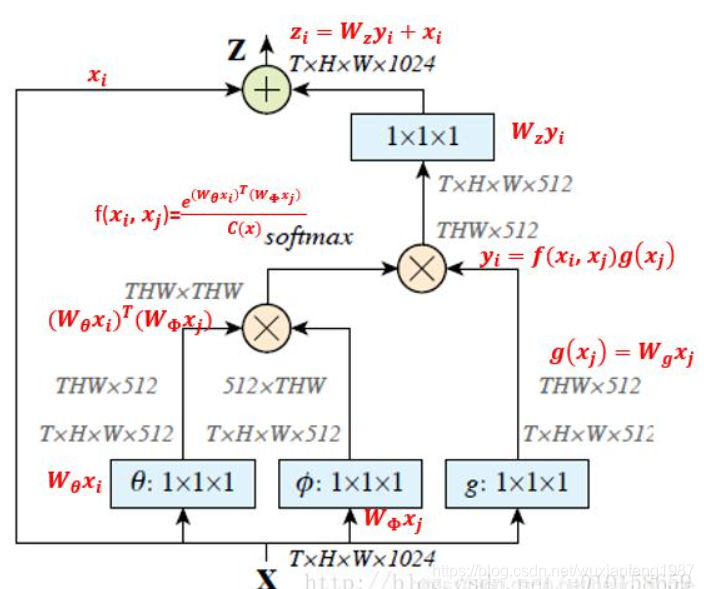
到这,再对应到《Attention is all you need》中的Query、Key 与 Value就比较容易理解了,对应了嵌入高斯的表达式:
Query*Key其实就是计算相关度或叫依赖度,然后经过softmax转为权重,针对可能的y计算加权和就得到最终的结果了。
实践证明这样处理确实有效,但为什么有效,不知还有什么更深层次的解释没.. 暂时是想不到了

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)