embARC 机器学习库的使用
目录
一、前言
本文档面向2022/2023新思科技企业命题XDU培训。
embARC MLI(机器学习库)用于ARC 物联网开发套件 (IoTDK)机器学习部分的开发 。
目前,embARC 机器学习库已经发布到了2.0版本,但是官方说2.0建议只为 VPX 和 x86 仿真使用,可以将 MLI 1.1 用于 EM/HS 目标。但是MLI1.1需要使用MetaWare 开发工具进行构建,MetaWare 需要申请License才能使用,笔者没有这个环境。所以还是使用ARC GNU 工具链构建的版本embarc_osp的embarc_mli分支,不过这个库自2019以后已经没有更新了,里头只有三个例程,更多更新的例程还是得参考独立的embarc_mli库,具体可以参考MLI 1.1的文档,也就是下载MLI 1.1的release,根据embarc_mli/doc/README.md来生成它的文档进行学习。
二、前置知识
- 神经网络基础
- Python
- C
- 嵌入式
三、环境安装
安装参考官方手册

win下需要:
1、ARC GNU 工具链,安装 2019.09 版本的 release,因为 embarc_mli 的代码很久没有更新了,配不上新的工具链了,安装时会自动配置系统环境变量,最好使用默认路径安装,否则还要改一些路径。
2、Digilent Adept Software JTAG 调试器驱动,无脑安装,装完把开发板连电脑在设备管理器出现一个串行端口和两个串行总线端口。
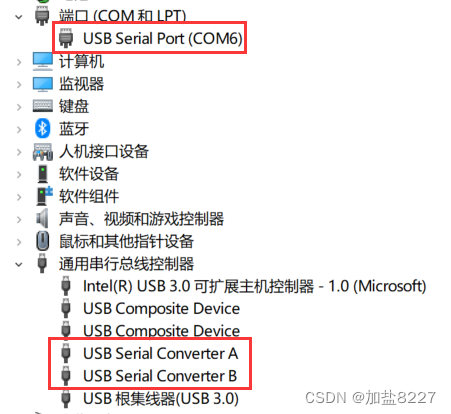
3、Zadig 用于驱动转换,选择 Options/List all devices 可以看到 interface 0 和 interface 1,根据不同开发板选不同接口,EMSK 转 interface 0,iotdk 转 interface 1,此处转 interface 1,点击 Replace Driver 开始转。

转完端口如下:

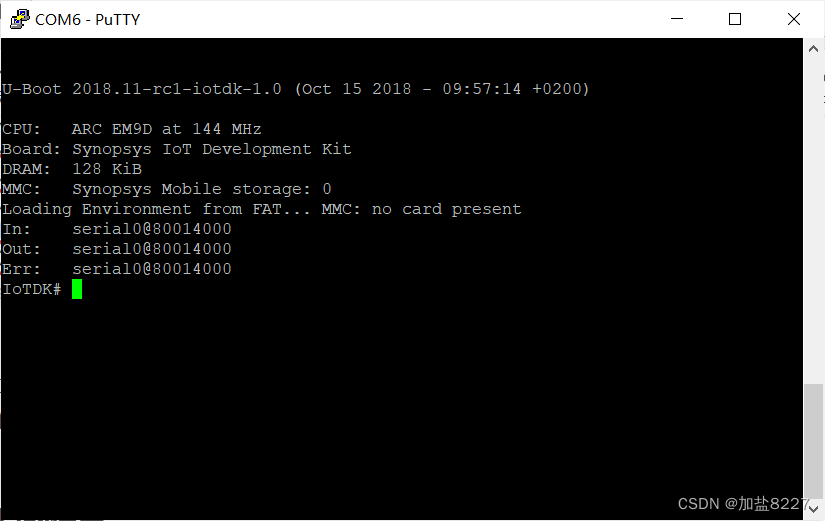
4、任意串口工具,例如PuTTY,波特率115200,有的板子接入串口后按板上的 reset 串口工具会打印一串板子信息出来,有的不会打印,但不代表板子坏了。
四、MLI的使用
1、下载代码仓库

或者使用命令行
git clone -b embarc_mli https://github.com/foss-for-synopsys-dwc-arc-processors/embarc_osp.git
2、跑例程
此处跑cifar10_caffe这个例程,主要是通过神经网络分类cifar10数据集,数据集共有10个类别如下,图片的尺寸为 32×32。

打开example\baremetal\embarc_mli\cifar10_caffe\makefile,添加工具链 TOOLCHAIN ?= gnu

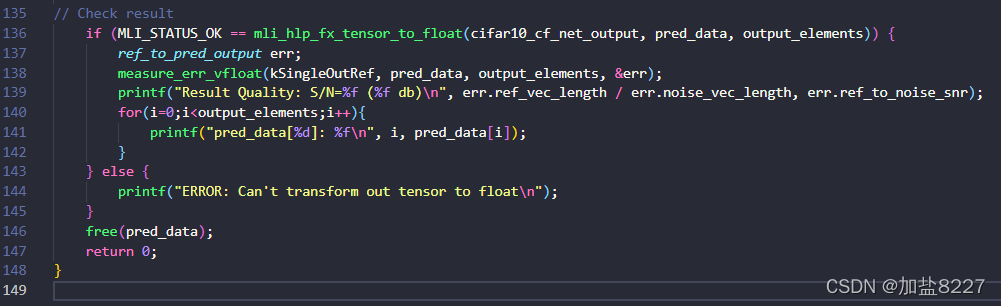
为了更直观地显示分类结果,对代码作如下修改,对example\baremetal\embarc_mli\cifar10_caffe\ml_api_cifar10_caffe_main.c第140行,加入:
for(int i=0; i<output_elements; i++){
		printf("pred_data[%d]: %f\n", i, pred_data[i]);
	}
在embarc_osp-embarc_mli\example\baremetal\embarc_mli\cifar10_caffe路径下打开终端,输入make进行编译


编译完成没有报错后,把IoT开发板接入电脑,使用串口工具如Putty连接开发板,在终端输入make run运行代码

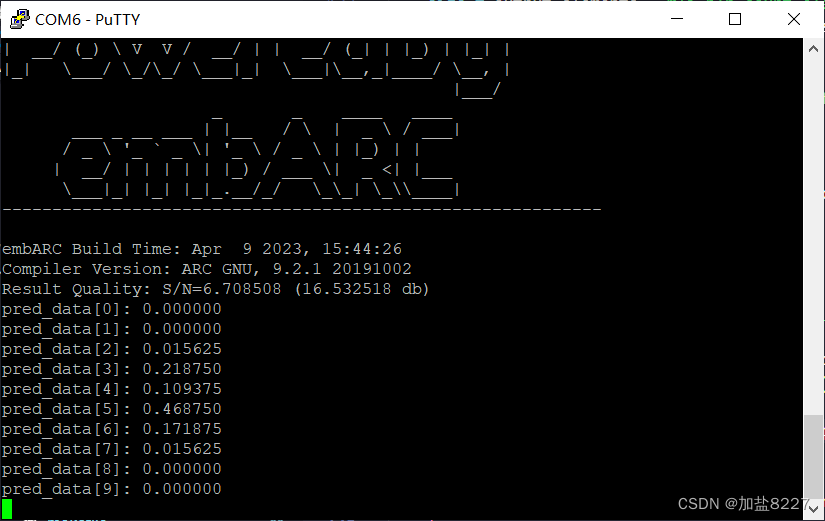
在串口工具上能看到输出如下,每一行末尾的数字代表这个类别的分类置信度,可以看到第 5 类的置信度最高,表示所输入图片的最终分类结果为第五类,也就是Dog。
3、改变输入
在ml_api_cifar10_caffe_main.c的第34行可以修改输入
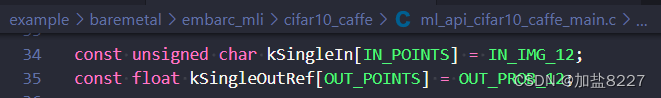
可以发现IN_IMG_12在example\baremetal\embarc_mli\cifar10_caffe\cifar10_ref_inout.h里进行定义,所以通过修改此处定义,重新编译运行就能看到输出类别改变了。
那么如何使用 cifar10 的其他图片呢?
先来看cifar10_ref_inout.h里的数据,神经网络的输入就是这个格式的数组,IN_IMG_12_SHAPE为输入图片的大小,为 HWC 格式,即 {height,width,channels}。IN_IMG_12_RANK是输入的维度,此处为3维,IN_IMG_12存储的是量化后的图片数据,INQ则是量化操作,后面的91、64这些是图片原始像素点数据,这样写法可以让图片在编译的时候就自动完成量化操作,但由于此处图片像素范围本身就是0~255,可以看作Q7.0格式,所以会发现此处INQ只是作了个类型转换#define INQ(val) ((unsigned char)val)。如果要换其他图片,只需要将这里INQ括号里的值替换就好。

当然不是自己手动一个个替换了,可以用python自动把图片转为这个格式的数组再复制进去。
from PIL import Image
import numpy as np
import os

#图片转数组并保存
path= "a.png"
img = Image.open(path)
img = img.resize((32, 32),Image.ANTIALIAS)
img = img.convert("RGB")
arr = np.asarray(img)
print(arr.shape)
a_file = open("a.txt", "w")
i =0
for row in arr.flat:
    a_file.write("INQ("+"%.9f" %row+"),")
    i+=1
    if(i==10):
        i=0
        a_file.write("\\")
        a_file.write("\n")
a_file.close()
将 python 生成的图片数据复制出来放入cifar10_ref_inout.h

重新编译运行发现现在的分类结果为第0类 飞机

4、定点数
关于定点数量化可以参考MLI2.0数据格式,具体来说就是把32位的浮点数量化成8位的定点数在硬件上能跑的更快,占用存储空间更小,从神经网络的输入到神经网络每一层的权重和中间特征层的输出到神经网络的输出,都需要量化成8位定点数来跑,当然也支持16位的定点数,量化会带来精度损失,8位精度不够的话就可以考虑16位。
使用Q表示法来表示量化后的数:

具体公式这里就不赘述了,看几个例子就懂了:
前两个是浮点数->定点数,后两个是定点数->浮点数

定点数之间的转换:

需要注意的是,有符号整数类型的不对称性会影响 FX 表示。fx8 容器 (int8_t) 保存 [-128, 127] 范围内的值,这意味着该数字的 FX 表示也是不对称的。所以对于 Q.7 格式,这个范围是 [-1, 1),或者更准确地说是 [-1.0, 0.9921875](不包括 1.0)。类似地,fx16 容器 (int16_t) 保存 [-32768, 32767] 范围内的值。对于 Q.15 格式,范围是 [-1, 0.999969482421875]。
定点数换算体现在代码里就是:
typedef int8_t w_type;
#define IN_INT   (0)//整数部分位数

#define QMN(type, fraq, val)   (type)(val * (1u << (fraq)) + ((val >= 0)? 0.5f: -0.5f))
#define FRQ_BITS(int_part, el_type) ((sizeof(el_type)*8)-int_part-1)

#define IN_FRAQ   (FRQ_BITS(IN_INT, w_type))
#define INQ(val)   QMN(w_type, IN_FRAQ, val)
IN_INT定义了整数部分位数,FRQ_BITS根据整数部分位数算出小数部分位数,QMN进行定点数换算,其中1u << (fraq)移位操作表示2的fraq次方。
5、权重量化配置
cifar10_coefficients_chw_small.c文件包含了神经网络的权重数据,cifar10_constants.h则是神经网络的参数配置,以第一个卷积层为例:
(略)
#else //(MODEL_BIT_DEPTH == MODEL_FX_8 or MODEL_FX_8W16D)

#define CONV1_W_INT   (-1)
#define CONV1_B_INT   (0)
#define CONV1_OUT_INT (3)
(略)
// CONV1
//================================================
#define CONV1_W_SHAPE {32,3,5,5}
#define CONV1_W_ELEMENTS (32*3*5*5)
#define CONV1_W_RANK (4)

#define CONV1_W_FRAQ   (FRQ_BITS(CONV1_W_INT, w_type))
#define L1_WQ(val)   QMN(w_type, CONV1_W_FRAQ, val)

#define CONV1_B_ELEMENTS (32)
#define CONV1_B_SHAPE {32}
#define CONV1_B_RANK (1)

#define CONV1_B_FRAQ   (FRQ_BITS(CONV1_B_INT, w_type))
#define L1_BQ(val)   QMN(w_type, CONV1_B_FRAQ, val)

#define CONV1_OUT_FRAQ (FRQ_BITS(CONV1_OUT_INT, d_type))
CONV1_W_SHAPE的四个参数分别为输出通道数、输入通道数、卷积核的宽、卷积核的高,CONV1_W_ELEMENTS表示卷积核总的数据量,CONV1_W_RANK表示卷积核维度,CONV1_W_FRAQ和L1_WQ用于权重量化,下面几个参数同理,用于设置偏置信息,CONV1_OUT_FRAQ设置卷积输出的中间特征层的量化。
所有这些配置最终在cifar10_model_chw.c的结构体里生效,需要注意的是这里的el_params.fx.frac_bits是小数部分位数,上文的CONV1_W_INT配置的是整数部分位数。
// Conv 1 Layer related tensors
//===================================
static const mli_tensor L1_conv_wt = {
	.data = (void *)L1_conv_wt_buf,
	.capacity = CONV1_W_ELEMENTS * sizeof(w_type),
	.shape = CONV1_W_SHAPE,
	.rank = CONV1_W_RANK,
	.el_type = W_EL_TYPE,
	.el_params.fx.frac_bits = CONV1_W_FRAQ,
};
6、累加器位深的影响
乘积累加运算(Multiply Accumulate, MAC)是将乘法的乘积结果和累加器 A 的值相加,再存入累加器:
a←a+b×c,许多运算(如卷积运算、点积运算、矩阵运算、数字滤波器运算、乃至多项式的求值运算)都可以分解为数个MAC指令。
既然是累加就要考虑会不会溢出。
- FX8 操作数:32 位深度累加器由 1 个符号位和 31 个有效位组合使用。FX8 操作数有 1 个符号位和 7 个有效位。此类操作数的单次乘法导致 7 + 7 = 14 个有效位用于输出。因此,对于基于 MAC 的内核,有 17 个累加位(31–(7+7)=17)可用,可用于执行多达 217 = 131072 次操作而不会溢出。对于简单的累加,31 – 7 = 24 位可用,可保证执行多达 224 = 16777216 次操作而不会溢出。
- FX16 操作数:40 位深度累加器由 1 个符号位和 39 个有效位一起使用。FX16 操作数有 1 个符号位和 15 个有效位。此类操作数的乘法导致 15 + 15 = 30 个有效位用于输出。对于基于 MAC 的内核,有 39 – (15+15) = 9 个累加位可用,可用于执行多达 29 = 512 次操作而不会溢出。对于简单的累加,有 39 – 15 = 24 位可用,它们最多可以执行 224 = 16777216 次操作而不会溢出。
- FX16 x FX8 操作数:使用 32 位深度累加器。对于基于 MAC 的内核,有 31 – (15 + 7) = 31 - 22 = 9 个累积位可用,可用于执行多达 29 = 512 次操作而不会溢出。

若是累加器有可能溢出,就要考虑减少量化的小数位数,这样量化后的数值也会减少,就能避免累加器溢出。
转模型流程
1、寻找最大最小值
假使我们已经训练好了一个神经网络,以例程里的cifar10为例

需要将网络的输入、输出、每层的权重和中间特征层的值都保存下来,统计每一层的最大最小值
2、设置最小整数位数
然后为每一层的权重和数据定义 Q 数据格式

表的左侧是我们统计的每一层的绝对最大值范围:
max_abs_val = max ( abs ( val_max ), abs ( val_min ))
右边是计算出的最小整数位数:
int_bits = int ( np.ceil ( np.log2 ( max_abs_val ) ) )
np.ceil(ndarray) 计算大于等于该值的最小整数,小数位计算为容器大小减去整数位。
3、考虑溢出问题

4、写入权重和网络配置
然后就能把权重写入cifar10_coefficients_chw_small.c文件,把相关配置写入cifar10_constants.h,再在cifar10_model_chw里头配置网络结构,输入输出的配置也在这里,x_mem_buf和y_mem_buf同时作为中间特征层的存放处。
对于输入为hwc排布的可以用mli_krn_permute_fx转换为chw格式,IoTDK网络为chw格式。
// Module Input/Output tensors and their's external interface
//============================================================
static mli_tensor input = {
	.data = (void *)x_mem_buf,
	.capacity = sizeof(d_type) * IN_POINTS,
	.shape = {32, 32, 3},
	.rank = 3,
	.el_type = D_EL_TYPE,
	.el_params.fx.frac_bits = 7,
};

static mli_tensor output = {
	.data = (void *)y_mem_buf,
	.capacity = sizeof(d_type) * OUT_POINTS,
	.shape = {10},
	.rank = 1,
	.el_type = D_EL_TYPE,
	.el_params.fx.frac_bits = 0,
};
//  CIFAR10 graph based on Caffe example.
//  Layer-by-Layer execution for CHW layput
//
//==============================================================
void cifar10_cf_net(void) {
	// Version A: Pure implementation: without return status checking and profiling wrappers
	//========================================================================================
	// LAYER 0: Change RGB Image layout
	//=======================================
	mli_krn_permute_fx(&input, &permute_hwc2chw_cfg, &ir_tensor_Y);

	// LAYER 1
	//=======================================
	ir_tensor_X.el_params.fx.frac_bits = CONV1_OUT_FRAQ;
	conv2d_chw(&ir_tensor_Y, &L1_conv_wt, &L1_conv_bias, &shared_conv_cfg, &ir_tensor_X);
	maxpool_chw(&ir_tensor_X, &shared_pool_cfg, &ir_tensor_Y);

	// LAYER 2
	//=======================================
	ir_tensor_X.el_params.fx.frac_bits = CONV2_OUT_FRAQ;
	conv2d_chw(&ir_tensor_Y, &L2_conv_wt, &L2_conv_bias, &shared_conv_cfg, &ir_tensor_X);
	avepool_chw(&ir_tensor_X, &shared_pool_cfg, &ir_tensor_Y);

	// LAYER 3
	//=======================================
	ir_tensor_X.el_params.fx.frac_bits = CONV3_OUT_FRAQ;
	conv2d_chw(&ir_tensor_Y, &L3_conv_wt, &L3_conv_bias, &shared_conv_cfg, &ir_tensor_X);
	avepool_chw(&ir_tensor_X, &shared_pool_cfg, &ir_tensor_Y);

	// LAYER 4
	//=======================================
	ir_tensor_X.el_params.fx.frac_bits = FC4_OUT_FRAQ;
	fully_connected(&ir_tensor_Y, &L4_fc_wt, &L4_fc_bias, &ir_tensor_X);

#if defined(MODEL_BIG)
	// LAYER 5
	//=======================================
	ir_tensor_Y.el_params.fx.frac_bits = FC5_OUT_FRAQ;
	fully_connected(&ir_tensor_X, &L5_fc_wt, &L5_fc_bias, &ir_tensor_Y);
	softmax(&ir_tensor_Y, &output);
#else
	softmax(&ir_tensor_X, &output);
#endif

}
注意这里的每层的函数更底层是具体的带参数的函数,要改网络函数名(专用或通用,16或8),不知道改啥就用通用函数,但是专用函数有对特定卷积核做特定加速处理。
//========================================================================================
//  MLI Functions wrappers: Kernels with weights
//========================================================================================
#if (MODEL_BIT_DEPTH == MODEL_FX_8)
static inline mli_status conv2d_chw(
	const mli_tensor *in,
	const mli_tensor *weights,
	const mli_tensor *bias,
	const mli_conv2d_cfg *cfg,
	mli_tensor *out) {
	return mli_krn_conv2d_chw_fx8_k5x5_str1_krnpad(in, weights, bias, cfg, out);
}

static inline mli_status fully_connected(
	const mli_tensor *in,
	const mli_tensor *weights,
	const mli_tensor *bias,
	mli_tensor *out) {
	return mli_krn_fully_connected_fx8(in, weights, bias, out);
}

#elif (MODEL_BIT_DEPTH == MODEL_FX_16)
static inline mli_status conv2d_chw(
	const mli_tensor *in,
	const mli_tensor *weights,
	const mli_tensor *bias,
	const mli_conv2d_cfg *cfg,
	mli_tensor *out) {
	return mli_krn_conv2d_chw_fx16_k5x5_str1_krnpad(in, weights, bias, cfg, out);
}

static inline mli_status fully_connected(
	const mli_tensor *in,
	const mli_tensor *weights,
	const mli_tensor *bias,
	mli_tensor *out) {
	return mli_krn_fully_connected_fx16(in, weights, bias, out);
}
5、内存分配
IoTDK内存如下:
- 256 kByte ICCM
- 128 kByte DCCM
- 32 kByte X memory
- 32 kByte Y memory
由于内存有限,一块内存不一定放的下整个模型权重,需要把权重放在不同的内存区域里。
在appl_mem_config.h里可以分配模型权重的存储位置,需要注意在makefile里设置如下,USE_APPL_MEM_CONFIG是使用appl_mem_config.h里的设置,V2DSP_XY是使用xy内存空间,MODEL_BIT_DEPTH是数据采用8位定点数。
APPL_DEFINES = -DUSE_APPL_MEM_CONFIG -DV2DSP_XY -DMODEL_BIT_DEPTH=8
appl_mem_config.h里不同开发板有不同的设置,此处是IOTDK的设置:

在inc\library\embarc_mli\include\embarc_mli_sections.h里定义了_W、_W2、_X、_Y、_Z和上面设置的内存区之间的关系:

在cifar10_constants.h定义了每块buffer对应的内存分配,同时在cifar10_coefficients_chw_small.c也需要设置

cifar10内存分配如下:

再附上一个笔者去年部署模型的内存分配,真的最大的问题是模型可能放不下去…要反复权衡哪个权重放哪块内存区域更合适。

其他
前文讲的网络输入都是预写入cifar10_ref_inout.h再读取的,也可以设置从传感器读取数据,反正最后传入网络的就是一个数组。输入尺寸不合适可以用双线性插值resize一下,如果要做归一化,得考虑边界情况量化后会不会溢出,因为量化范围不是对称的。
可以参考笔者21年的项目:XDU_In-air_handwritten_characters_recognition

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)