学习笔记(GMM,HMM)
潜变量模型
观测变量:可以直接观测到的变量
潜变量:无法直接观测到,需要通过模型和观测变量进行推断,利用潜变量来解释观测变量的数学模型叫做潜变量模型,如GMM、HMM都是潜变量模型。
潜变量模型将不完全数据(只有观测数据)的边缘分布转换成容易处理的完全数据的联合分布
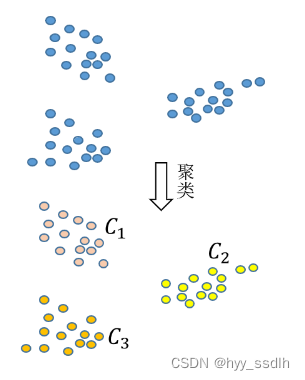
如下图中,潜变量就是各点的类别,观测变量就是数据点。
K-means聚类
k-means聚类的目标是将N个数据点聚类在K个类别中,其中K值以及给定
K-means的思路如下
(1)首先引入K个D维均值向量,k=1,2,…,K,
即为第k个类别的聚类中心
(2)接着计算数据点和所有类中心
的距离 (如欧式距离),类中心距离此数据点最近的类别,即为当前数据点的类别
(3)根据新的聚类结果,使用当前聚集到各个类别的数据的均值来更新当前类别的聚类中心,
(4)返回第2步,直到满足一定的停止准则。停止准则可能是:聚类中心变化不大,各个数据点不再变化类别等情况
对K-means进行优化
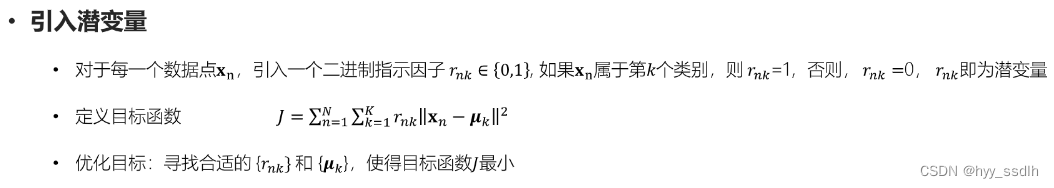
引入潜变量
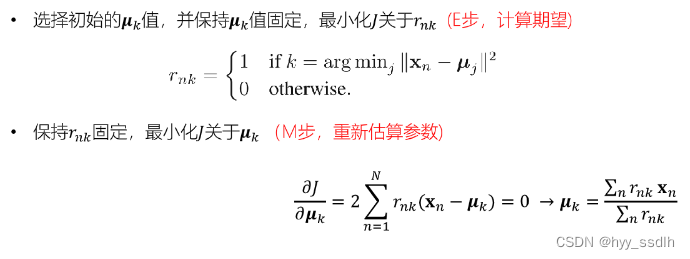
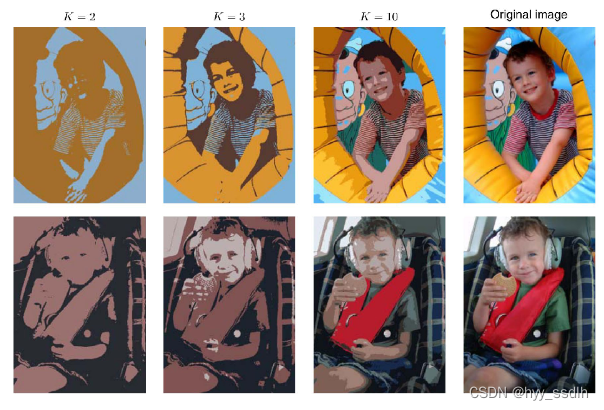
k-means可以用作图像的分割和压缩,如下图将一个图片分为两个颜色存储,大大降低数据的存储量
GMM模型(高斯混合模型)
GMM模型用于解决同一集合下数据包含不同分布的情况
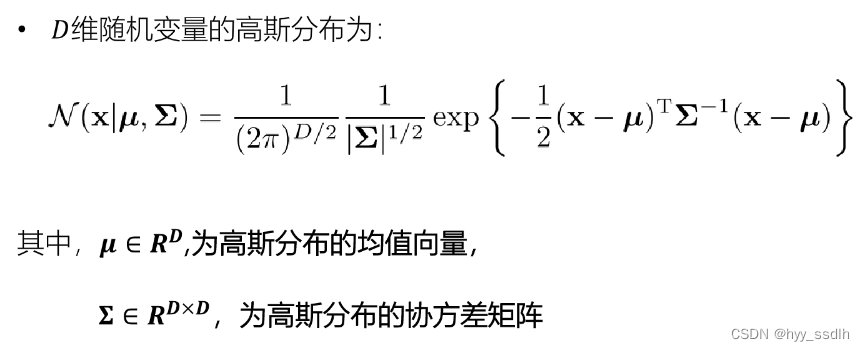
多维高斯分布
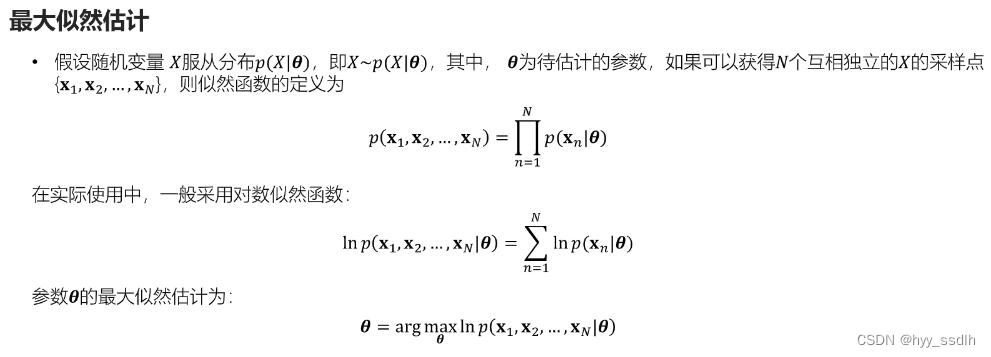
最大似然估计
寻找一组参数,使这批样本生成固定数据的概率最大。
高斯模型的最大似然估计
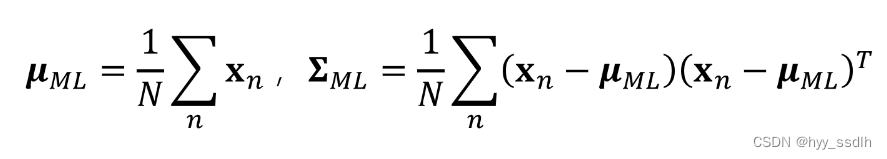
高斯混合分布
从几何角度来看:高斯混合分布可以看做加权平均由多个高斯分布叠加实现的,由此高斯混合分布公式如下
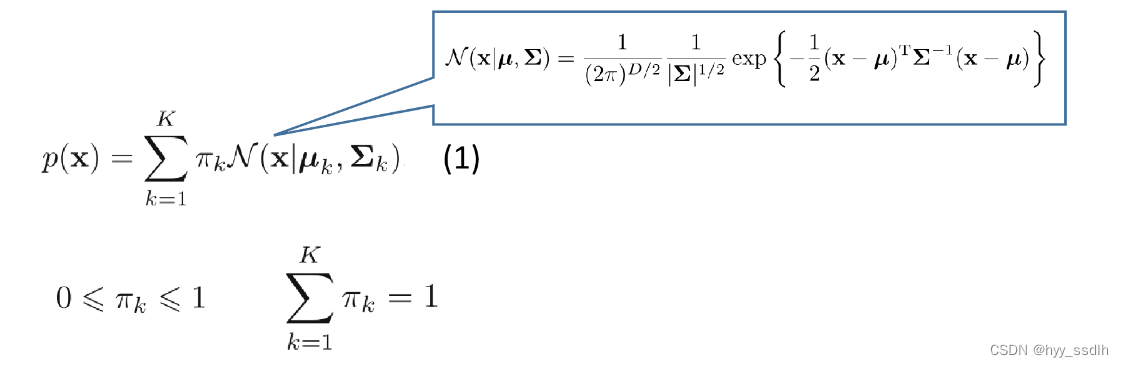
其中{},{
},{
}为待估计参数。对于
可以理解为:第k个高斯所占的比重。
从混合模型角度来看:引入变量z,x为观测变量,z为隐变量,表示对应的样本x是属于哪一个高斯分布。可以看做是一个离散型的随机变量,其中,如下图,其中C为类型
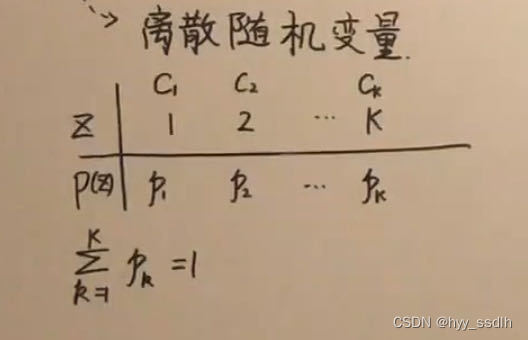
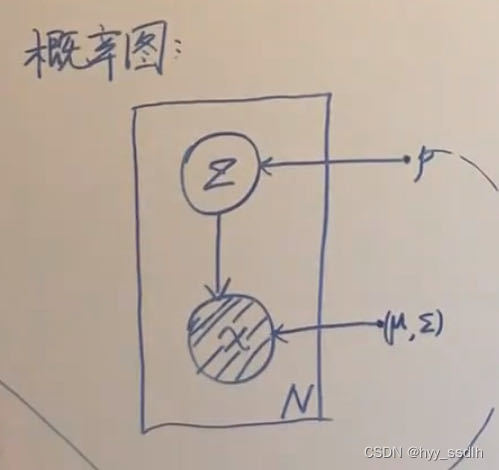
其中Z和X的概率图如下。
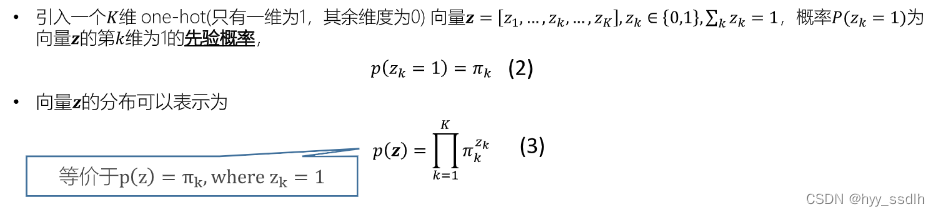
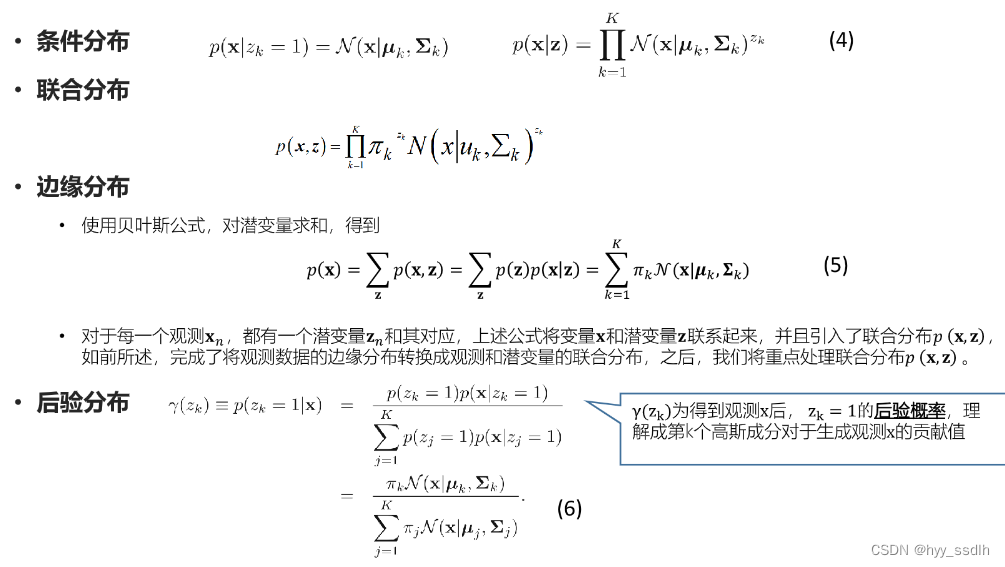
先验概率:在没有任何观测数据条件下给出的概率
后验概率:得到观测数据,依据观测数据对某一变量的概率
GMM的对数似然式子如下

GMM模型参数估计的EM算法
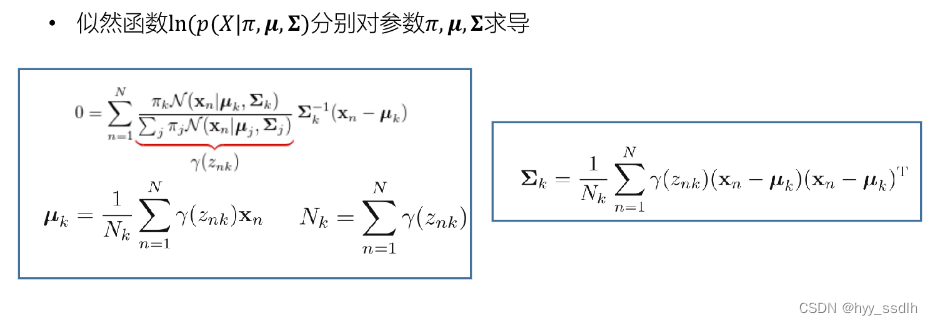
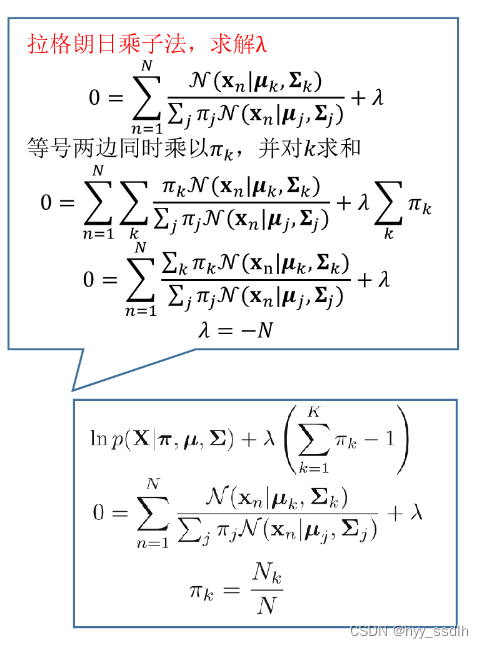
GMM模型参数估计的EM总结

EM算法
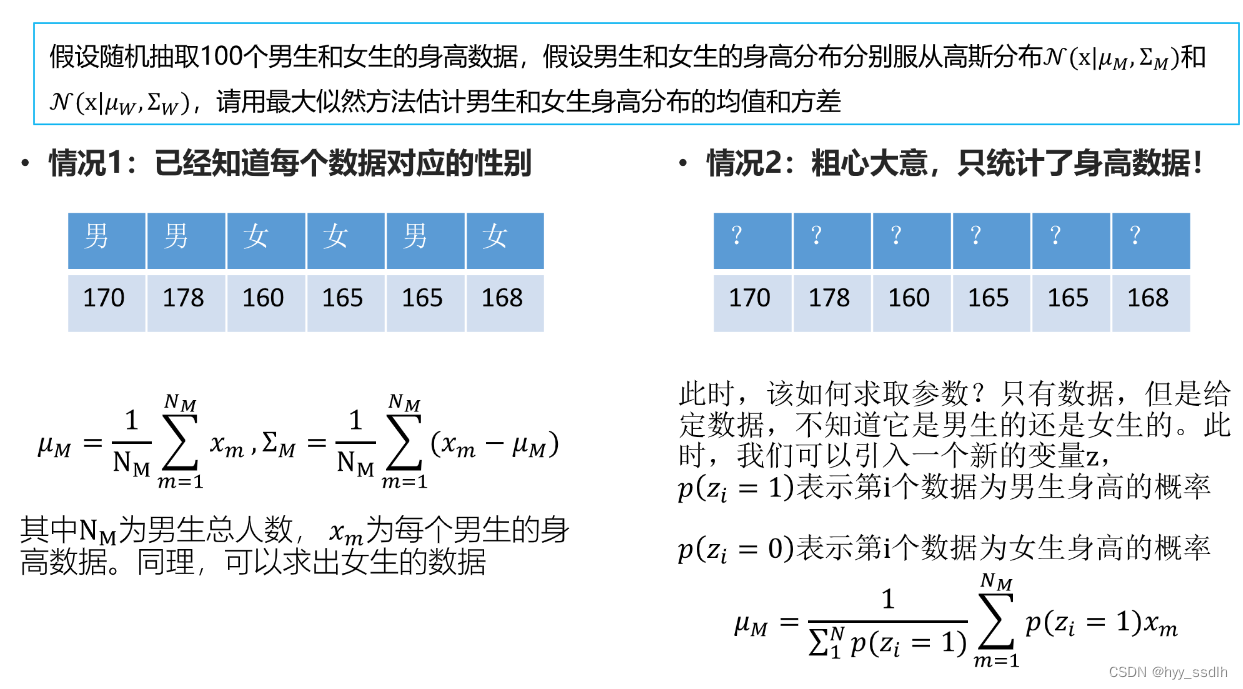
上述中的P()一般使用迭代的方法进行计算,具体步骤如下
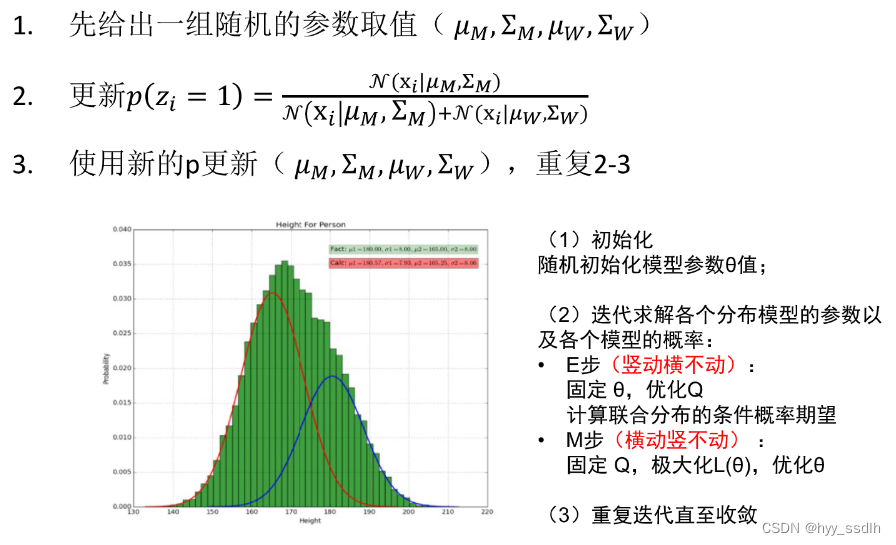
EM算法分为E步和M步两部
E步:直观的可以看做是数数,M步就是在最大化似然的过程,所以这就是两部迭代更新E/M
EM算法的步骤如下
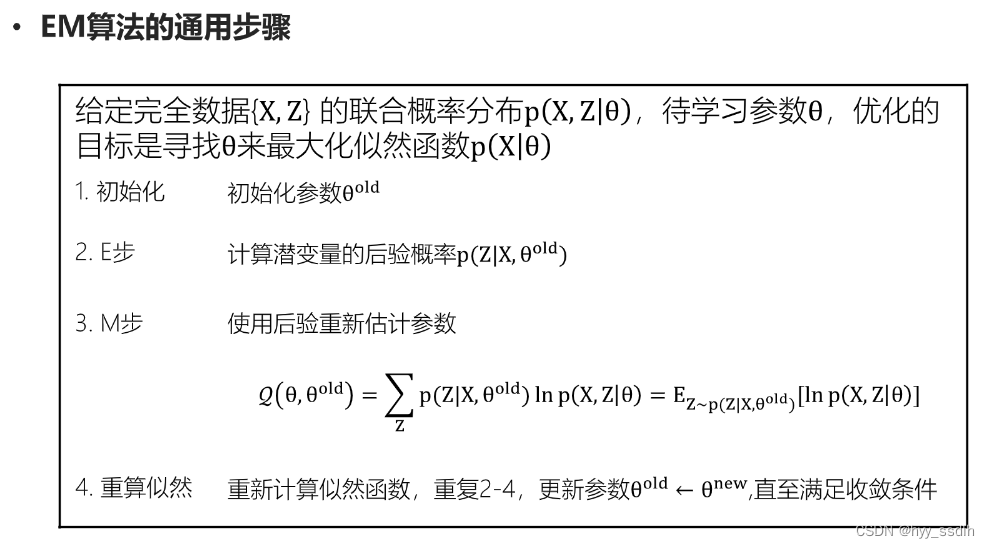
EM算法的核心问题就是将不完全数据(只有观测数据)的边缘分布转换成容易处理的完全数据(观测变量+潜变量)的联合分布。
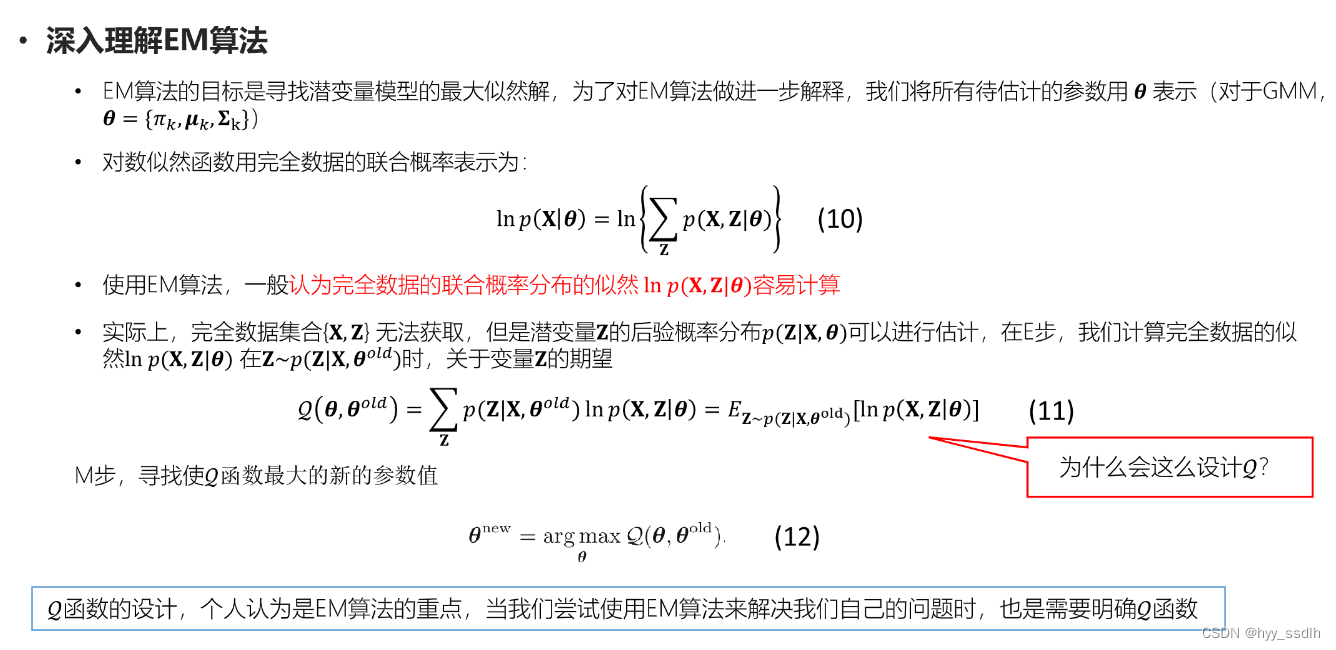

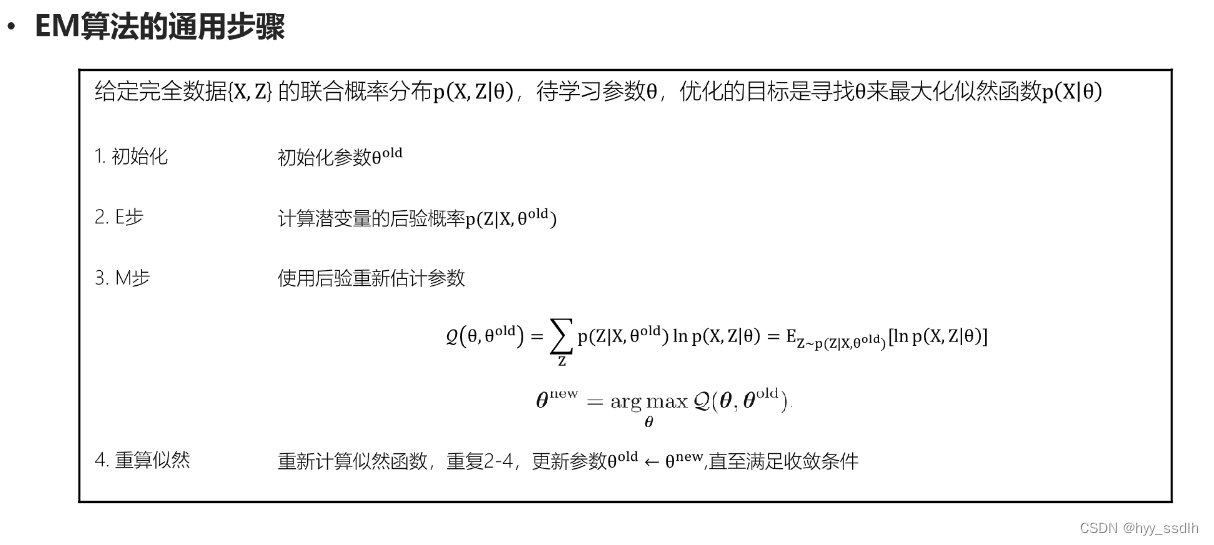
EM算法的通用步骤如下
HMM(隐马尔可夫模型)
定义
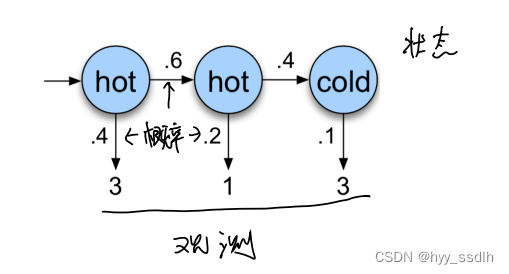
隐马尔可夫模型是关于时间序列的概率模型,描述由一个隐藏的马尔可夫链随机生成不可观测的状态序列,再由各个状态生成一个观测而产生观测序列的过程。举个例子,加入科学家们需要根据小明每天吃冰激凌的数量1,2,3来判断那天的天气,那么观测序列O可以是O=(3,1,3)对应的天气的状态序列Q则为Q=(hot,cold,hot),观测序列就是可以直观感受到的,状态序列则需要通过观测序列推理得到。
下图是一个隐马尔可夫模型,中间是一条隐藏的马尔可夫链,当我们处于不同状态时会以不同概率跳转到不同状态,也会以不同概率跳转到不同观测。
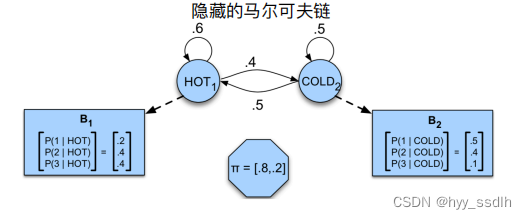
下图是一个实例
组成
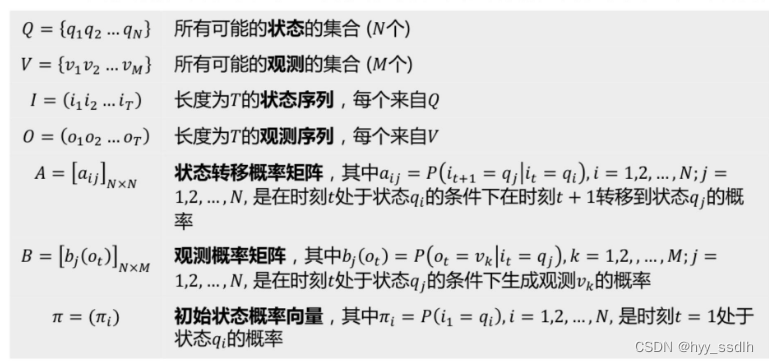
HMM的表达公式为 =(A,B,π),其中A,B,π成为HMM的三要素
HMM两个基本假设
齐次马尔可夫性假设:隐藏的马尔可夫链在时刻t的状态只和t-1的状态有关,即
观测独立性假设:观测只和当前时刻的状态有关,即
HMM的例题
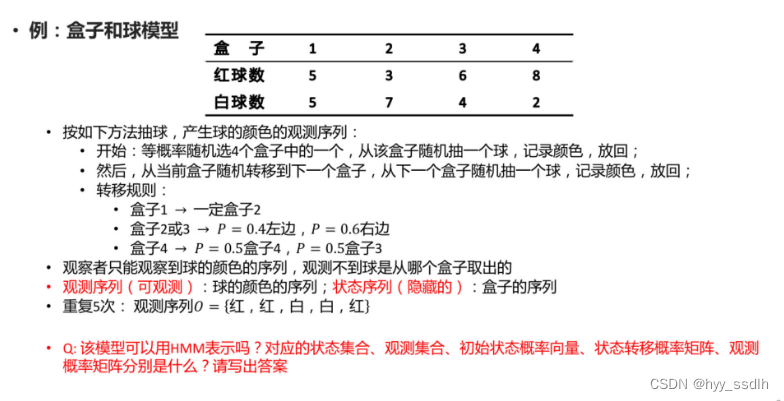
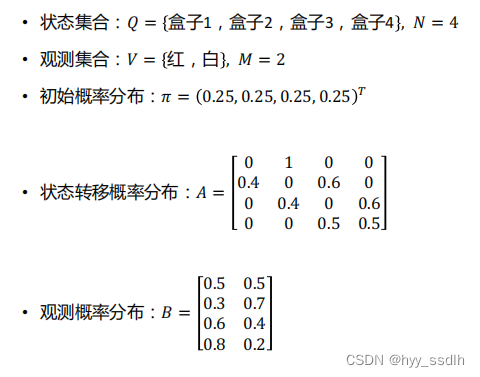
答案
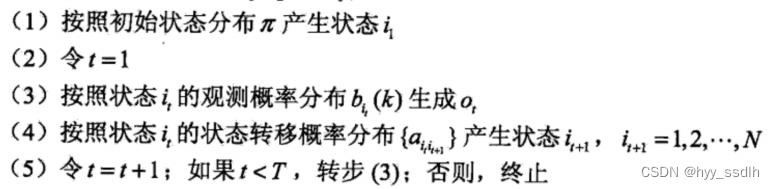
观测序列的生成过程
输入:隐马尔可夫模型 =(A,B,π),观测序列长度T;
输出:观测序列O=()
步骤如下:
隐马尔可夫模型的三个基本问题
1、概率计算问题
概率计算问题即已知模型=(A,B,π)和观测模型O=(
),计算概率P(O|
)
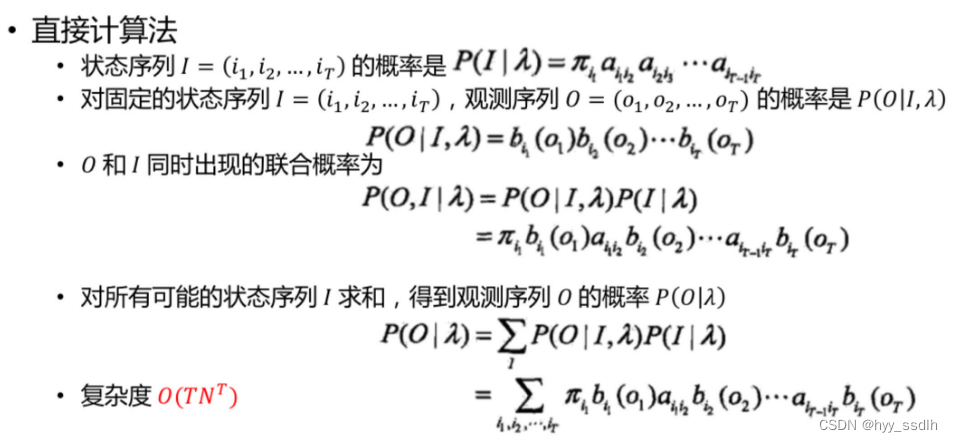
直接计算法
该方法是最直接的方法,列举了所有可能的长度为T状态序列,之后求各个状态序列与观测序列的联合概率P(O,I|),然后对所有可能的状态序列求和,得到P(O|
)
具体的计算步骤如下
前向算法
前向概率:给定隐马尔可夫模型,定义到时刻t部分观测序列为
且状态为
的概率为前向概率,记作
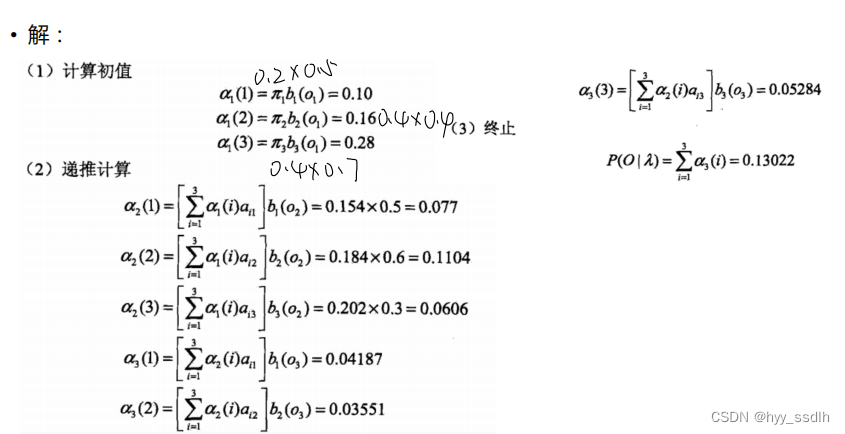
观测序列概率的前向算法过程如下
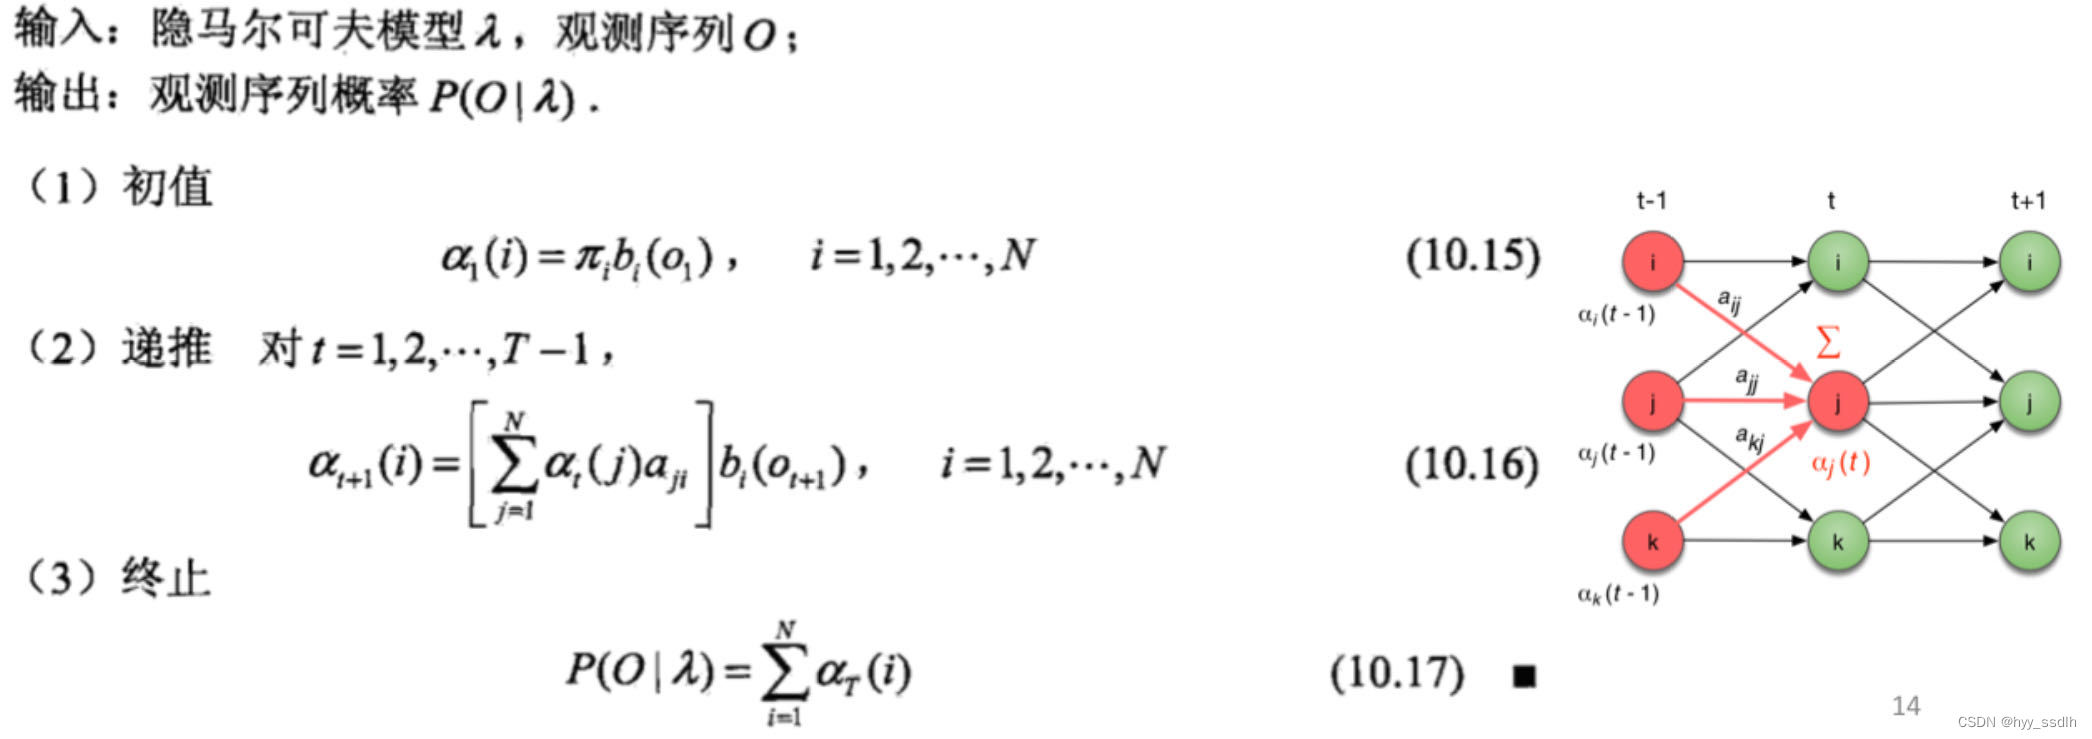
前向算法的关键在与每一次计算,直接引用前一个时刻的计算结果,减少了计算量,避免了重复计算。复杂度降为了
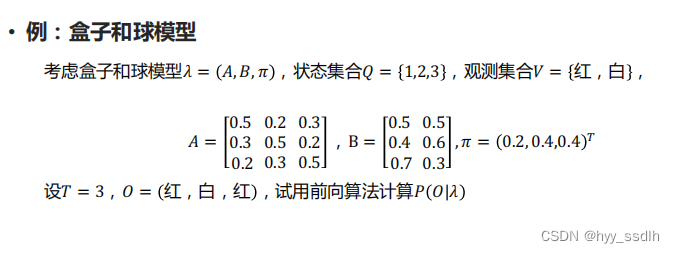
例题
后向算法
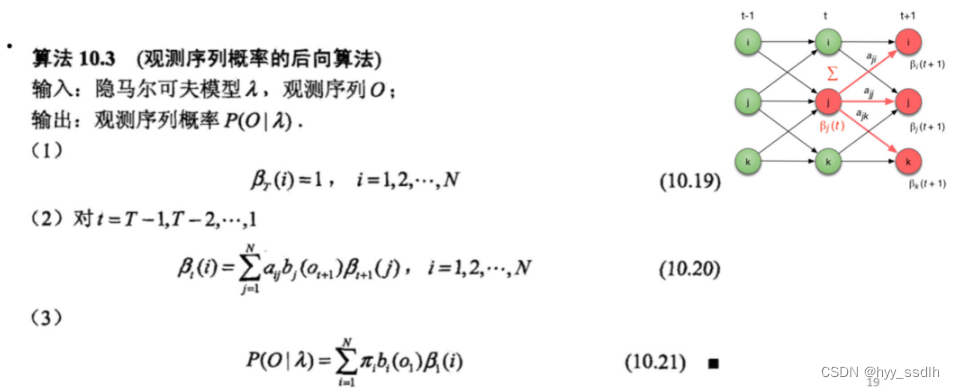
后向概率:给定隐马尔可夫模型,定义在时刻t状态为
的条件下,从t+1到T的部分观测序列为
的概率为后向概率,记作
观测序列概率的后向算法过程如下
2、预测问题
预测问题即已知模型=(A,B,π)和观测模型O=(
), 计算概率P(O|
)最大的状态序列I=(
)
Viterbi算法
viterbi算法是要动态规划求概率最大路径(最优路径),一个路径对应一个状态序列
最优路径的特性:如果最优路径在时刻t通过结点,那么这一路径从结点
到终点
的部分路径,对于从
到
的所有可能的部分路径来说,必须是最优的。
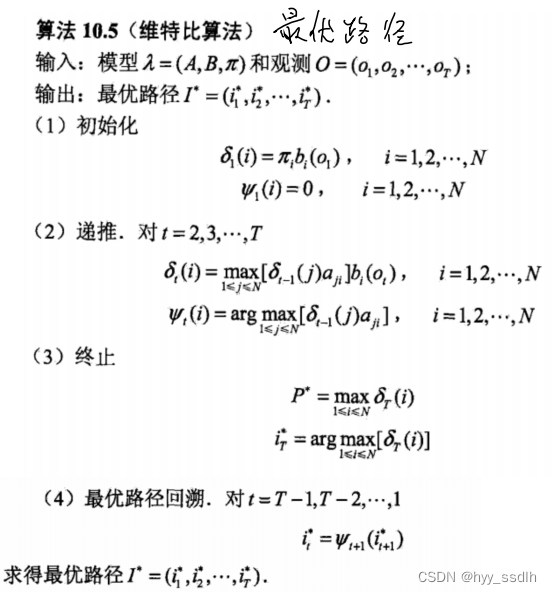
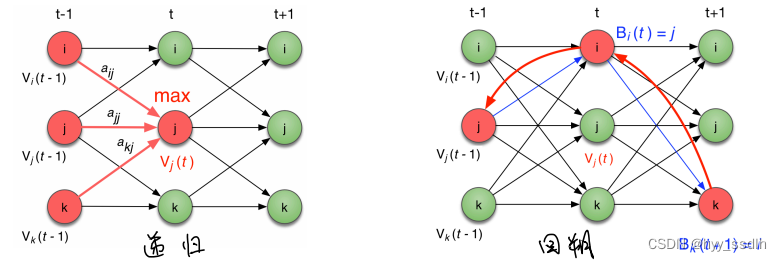
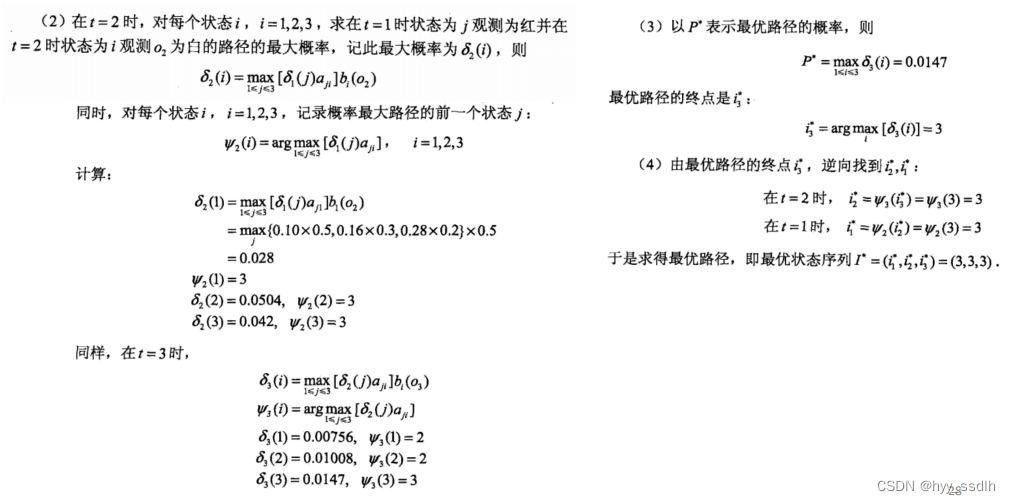
递推:只需从时刻t=1开始 ,递推地计算在时刻t状态为i的各条部分路径的最大概率,直至得到时刻t=T状态为i的各条路径的最大概率,时刻t=T的最大概率即为最优路径的概率 p*,最优路径的终结点也同时得到
回溯:之后,为了找出最优路径的各个结点 ,从终结点开始,由后向前逐步求得结点
,...,
,得到最优路径
viterbi算法的过程如下
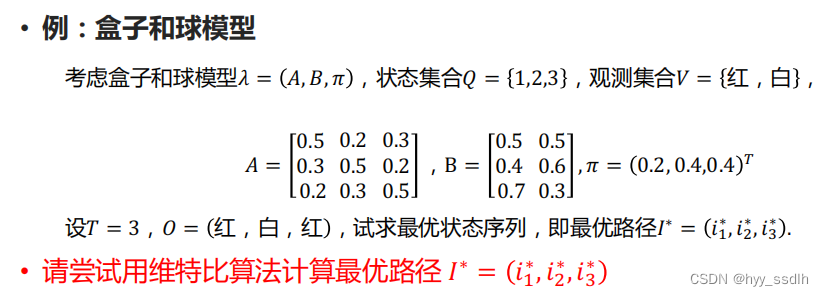
例题:
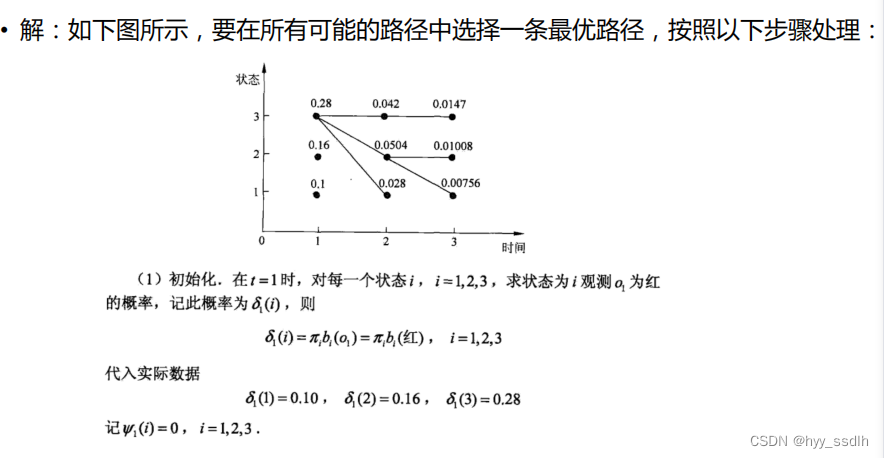
解答:
3、学习问题
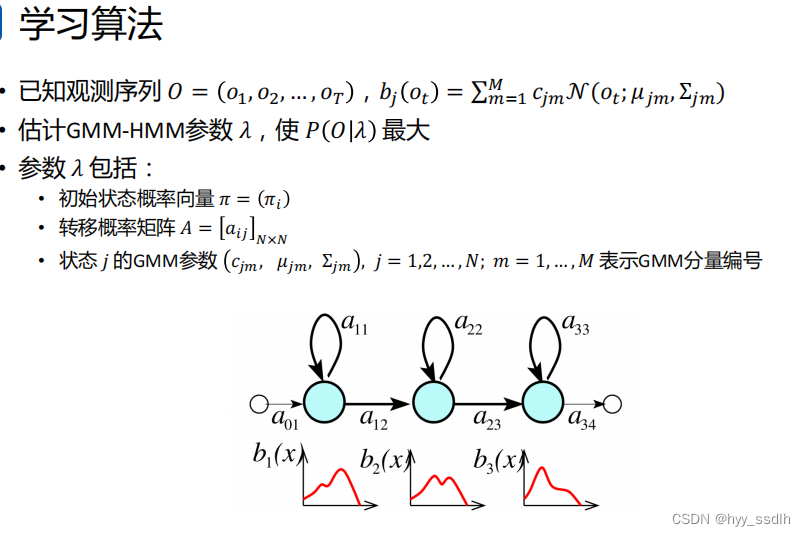
学习问题即已知观测模型O=(),估计模型
,使概率P(O|
)最大
Viterbi算法
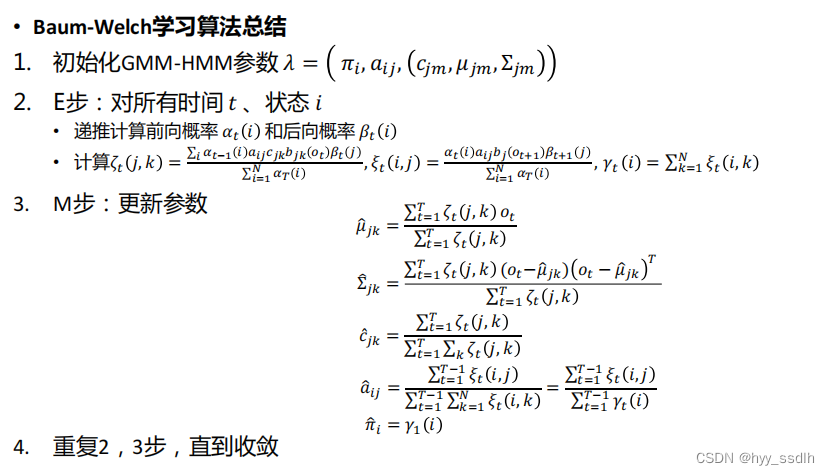
Baum-Welch学习算法
GMM-HMM语音识别框架
一些概念
对齐:“音频wav”和“文本txt”的对应关系
训练:已知对齐(wav及其txt),迭代计算模型参数
解码:根据训练得到的模型参数,从wav推出txt

基于孤立词的GMM-HMM语言识别系统
孤立词:考虑一个最简单的0~9十个数字,每个数据语音只包含一个数字,那么就叫做孤立词
下图是系统主要做的事情
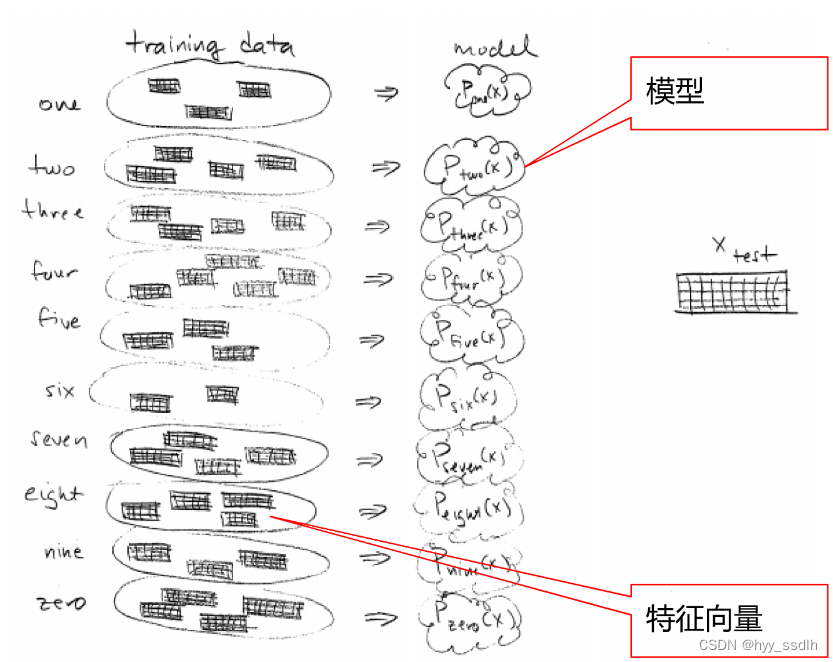
将上图形式化为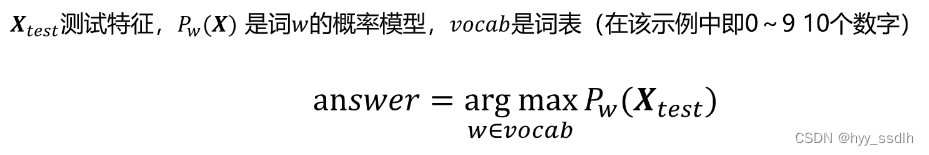
假设我们为每个词建立了一个模型P,计算在每个词上的概率,并选择所有词中概率最大的词作为识别结构。这里的模型P可以用DNN,GMM等方法实现。

语音识别中的GMM(对角GMM,协方差为对角阵,MFCC特征)
语音识别中的HMM如下图所示,它是由三状态组成的左右模型的拓扑结构

GMM与HMM的结合如下图


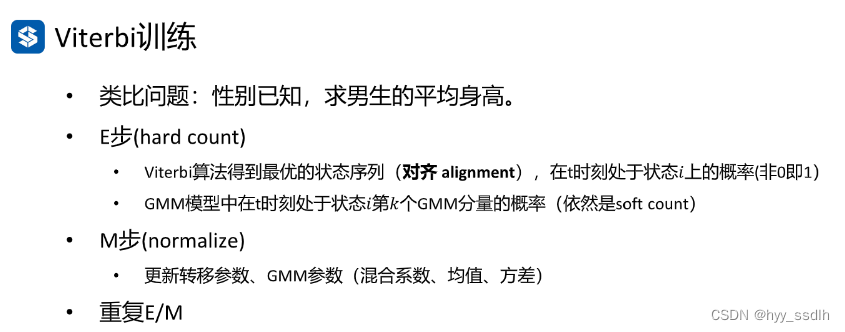


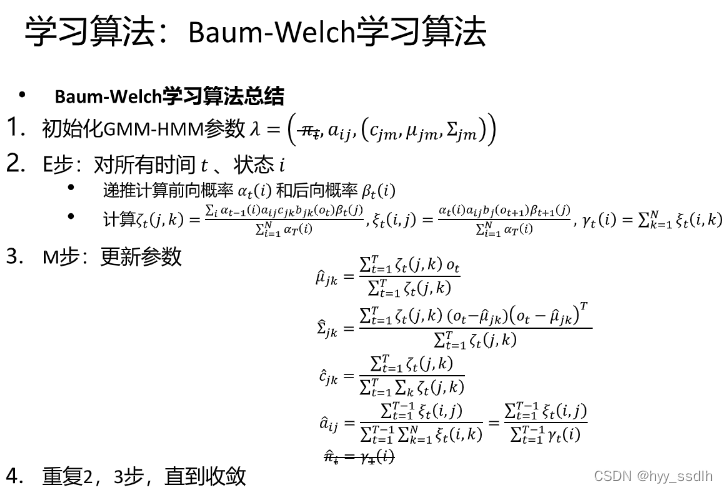
解码需要输入各个词的HMM-GMM模型即未知的测试语言X,输出X是哪个词。
解码的关键在于对于所有的w,如何计算P(X)。
基于单音素的GMM-HMM语言识别系统

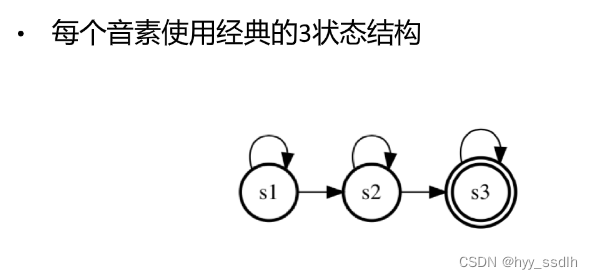
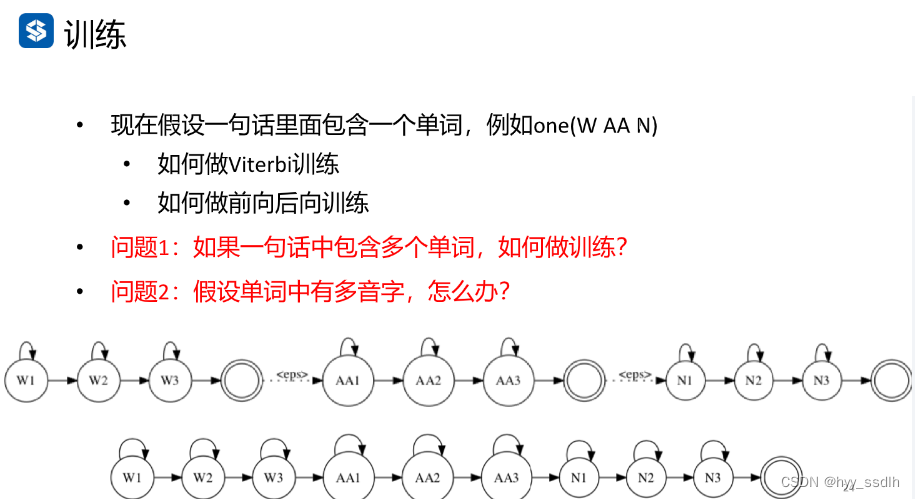

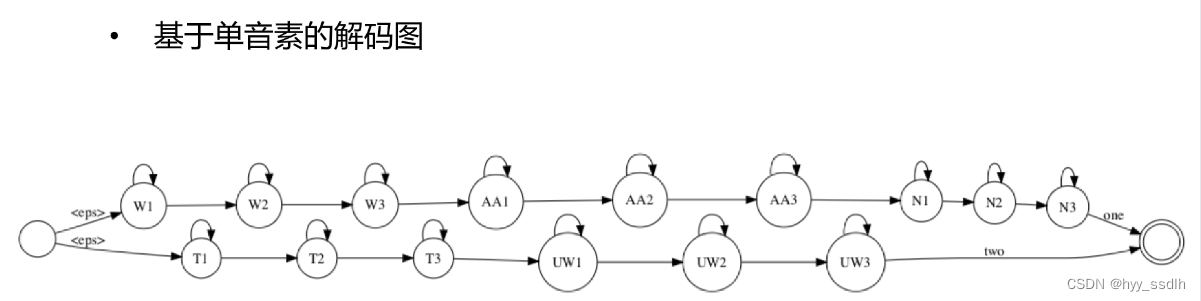

基于三音素的GMM-HMM语言识别系统

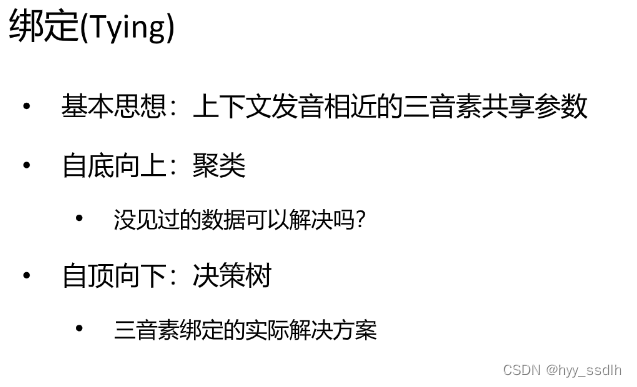
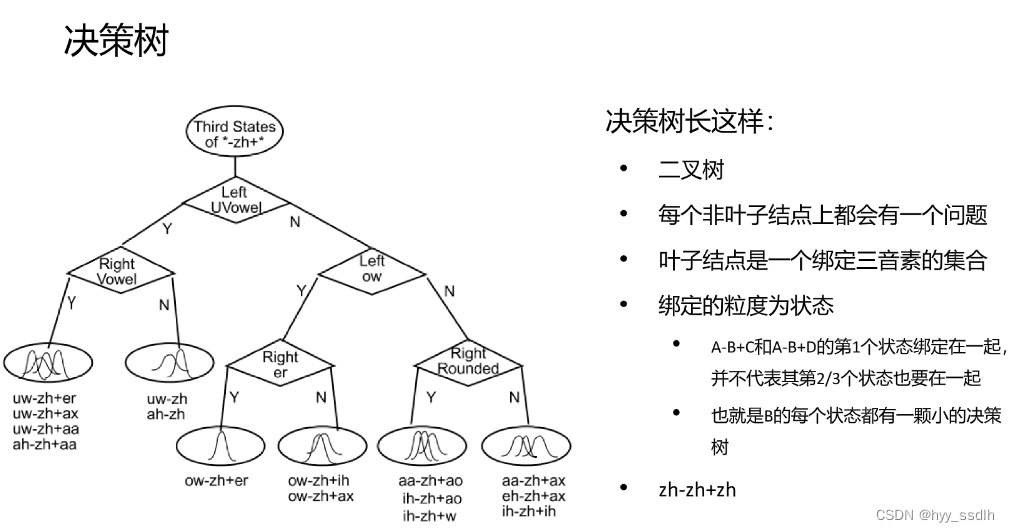
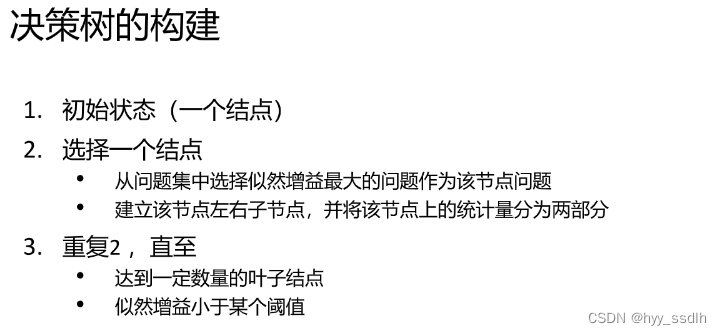
基于GMM-HMM语言识别系统


有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 20
 0
- 0


 已为社区贡献1条内容

所有评论(0)