base加密
一、base64
1原理
base64是一种二进制到文本的编码系统,它使用一组 64 个不同的 ASCII 字符将二进制数据传输为基于文本的格式,6bit为一组。它通常用于对二进制数据进行编码,例如图像或音频文件。
2.字符表
| Character | Binary | Decimal |
|---|---|---|
| A | 000000 | 0 |
| B | 000001 | 1 |
| C | 000010 | 2 |
| D | 000011 | 3 |
| E | 000100 | 4 |
| F | 000101 | 5 |
| G | 000110 | 6 |
| H | 000111 | 7 |
| I | 001000 | 8 |
| J | 001001 | 9 |
| K | 001010 | 10 |
| L | 001011 | 11 |
| M | 001100 | 12 |
| N | 001101 | 13 |
| O | 001110 | 14 |
| P | 001111 | 15 |
| Q | 010000 | 16 |
| R | 010001 | 17 |
| S | 010010 | 18 |
| T | 010011 | 19 |
| U | 010100 | 20 |
| V | 010101 | 21 |
| W | 010110 | 22 |
| X | 010111 | 23 |
| Y | 011000 | 24 |
| Z | 011001 | 25 |
| a | 011010 | 26 |
| b | 011011 | 27 |
| c | 011100 | 28 |
| d | 011101 | 29 |
| e | 011110 | 30 |
| f | 011111 | 31 |
| g | 100000 | 32 |
| h | 100001 | 33 |
| i | 100010 | 34 |
| j | 100011 | 35 |
| k | 100100 | 36 |
| l | 100101 | 37 |
| m | 100110 | 38 |
| n | 100111 | 39 |
| o | 101000 | 40 |
| p | 101001 | 41 |
| q | 101010 | 42 |
| r | 101011 | 43 |
| s | 101100 | 44 |
| t | 101101 | 45 |
| u | 101110 | 46 |
| v | 101111 | 47 |
| w | 110000 | 48 |
| x | 110001 | 49 |
| y | 110010 | 50 |
| z | 110011 | 51 |
| 0 | 110100 | 52 |
| 1 | 110101 | 53 |
| 2 | 110110 | 54 |
| 3 | 110111 | 55 |
| 4 | 111000 | 56 |
| 5 | 111001 | 57 |
| 6 | 111010 | 58 |
| 7 | 111011 | 59 |
| 8 | 111100 | 60 |
| 9 | 111101 | 61 |
| + | 111110 | 62 |
| / | 111111 | 63 |
3.编码过程
了解完上述的知识,我们以编码 Man 字符串为例,来直观的感受一下编码过程。Man 由 M、a 和 n 3 个字符组成,它们对应的 ASCII 码为 77、97 和 110。

接着我们以每 6 个比特为一个单元,进行 base64 编码操作,具体如下图所示:

由图可知,Man (3字节)编码的结果为 TWFu(4字节),很明显经过 base64 编码后体积会增加 1/3。Man 这个字符串的长度刚好是 3,我们可以用 4 个 base64 单元来表示。但如果待编码的字符串长度不是 3 的整数倍时,先使用 0 字节值在末尾补足,使其能够被 3 整除,然后再进行 base64 的编码。
4.变种
1)一种用于URL的改进Base64编码,它不在末尾填充=号,并将标准Base64中的+和/分别改成了-和_,这样就免去了在URL编解码和数据库存储时所要做的转换,避免了编码信息长度在此过程中的增加,并统一了数据库、表单等处对象标识符的格式。
2)另有一种用于正则表达式的改进Base64变种,它将+和/改成了!和-,因为+,*以及前面在IRCu中用到的[和]在正则表达式中都可能具有特殊含义。
3)此外还有一些变种,它们将+/改为_-或._(用作编程语言中的标识符名称)或.-(用于XML中的Nmtoken)甚至_:(用于XML中的Name)。
5.使用python加密文本
import base64
print('进行base64编码')
bs64 = str(input('请输入需要加密的文本\n>>>'))
bs64_e = base64.b64encode(bs64.encode('utf-8'))
print('结果如下:')
print(bs64_e)
6.使用python解密
import base64
bs64 = input('请输入需要解密的文本\n>>>')
bs64_d = str(base64.b64decode(bs64),'utf-8')
print('结果如下')
print(bs64_d)
7.base64编码特征:
1. 字符集:Base64编码使用了64个字符来表示二进制数据,包括A-Z(26个大写字母)、a-z(26个小写字母)、0-9(10个数字),以及两个额外的字符+和/。有时候也会使用=字符作为填充。
2. 编码方式:Base64将每3个字节(24位)的数据编码为4个ASCII字符。如果数据不足3个字节,会进行填充。
3. 可打印性:Base64编码后的数据只包含可打印的ASCII字符,因此可以在文本协议中安全地传输和存储。
4. 字符长度:Base64编码后的字符串长度通常会比原始数据稍长,因为每3个字节的数据会被编码为4个字符。填充字符=的出现取决于数据长度是否能被3整除。
5. 逆向转换:Base64编码是可逆的,可以将编码后的数据解码回原始的二进制数据。
6. 应用场景:Base64常用于将二进制数据转换为文本格式,例如在电子邮件中传输二进制附件、在URL中传递二进制数据、或将二进制数据存储在文本文件中。
需要注意的是,Base64编码并不是一种加密算法,它只是一种将二进制数据转换为文本数据的编码方式。编码后的数据仍然可以被解码回原始的二进制形式。
二、base32
1.定义及区别
Base32 是 Base64 的变种,与 Base64 不同的地方在于 Base64 以 6 bit 为一组作为索引,而 Base32 以 5 bit 为一组作为索引,每一组用一个 ASCII 字符表示。Base 64 总共需要 64 个字符表示,而 Base32 则只需要 32 个字符表示。
2.Base32 的编码流程如下:
对二进制数据进行预处理:如果二进制数据的 bit 数目不是 5 的倍数的话,在末尾补 0 直至为 5 的倍数。
以 5 bit 为一组进行分组。
将每一组的 5 bit 二进制转换为索引(0 - 31)。
在索引 - 字符转换表中查询索引对应的字符。
根据原始二进制数据的 bit 数目除以 40 后的余数,确定末尾需要补 + 的数目。
如果原始二进制数据 bit 数目除以 40 后的余数是 0 的话,不需要补 +。
如果余数是 8,补 6 个 +。
如果余数是 16,补 4 个 +。
如果余数是 24,补 3 个 +。
如果余数是 32,补 1 个 +。
3.Base32 的索引 - 字符转换表如下:
索引:0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
字符:9 8 7 6 5 4 3 2 1 0 m n b v c x z a s d f g h j k l p o i u y t
4.python加密
import base64
str = input()
res = base64.b32encode(str.encode('utf-8')).decode('utf-8')
print(res)
python解密
import base64
a=input()
res = base64.b32decode(a.encode('utf-8')).decode('utf-8')
print(res)
三、base58
1.定义及区别:
base58是比特币的一种特殊编码方式,主要用于产生比特币钱包地址。相比Base64,Base58不使用数字"0",字母大写"O",字母大写"I",和字母小写"l",以及"+"和"/"符号。
2.编码表

3.python加解密
#加密
def b58encode(tmp: str) -> str:
    tmp = list(map(ord, tmp))
    temp = tmp[0]
    base58 = "123456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnopqrstuvwxyz"
    for i in range(len(tmp) - 1):
        temp = temp * 256 + tmp[i + 1]
    tmp = []
    while True:
        tmp.insert(0, temp % 58)
        temp = temp // 58
        if temp == 0:
            break
    temp = ""
    for i in tmp:
        temp += base58[i]
    return temp
#解密
def b58decode(tmp: str) -> str:
    import binascii
    base58 = "123456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnopqrstuvwxyz"
    temp = []
    for i in tmp:
        temp.append(base58.index(i))
    tmp = temp[0]
    for i in range(len(temp) - 1):
        tmp = tmp * 58 + temp[i + 1]
    return binascii.unhexlify(hex(tmp)[2:].encode("utf-8")).decode("UTF-8")
#输出加密内容
print(b58encode("HELLO"))
#输出解密内容
print(b58decode("99v1Y8E"))
四、base16
1.定义
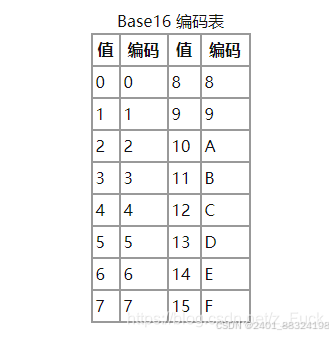
Base16编码使用16个ASCII字符对任何数据进行编码,Base16与Base64的实现原理类似,同样是将原数据二进制形式取指定位数转换为ASCII码。首先获取数据的二进制形式,将其串联起来,每4个比特为一组进行切分,每一组内的4个比特可转换到指定的16个ASCII字符中的一个,将转换后的ASCII字符连接起来,就是编码后的数据。
2.python
#python加密
import base64
str = input()
res = base64.b16encode(str.encode('utf-8')).decode('utf-8')
print(res)
#python解密
import base64
a=input()
res = base64.b16decode(a.encode('utf-8')).decode('utf-8')
print(res)
五、base91
1.顾名思义,base91需要91个字符来表示用ASCII编码的二进制数据。在94个可打印的ASCII字符(0x21-0x7e)中,以下三个字符被省略以构建base91字母表:
-(破折号,0x2d)
\(反斜杠,0x5C)
'(撇号,0x27)

六、base100
是emoji表情

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 43
 0
- 0


 已为社区贡献2条内容

所有评论(0)