数学建模模型算法-Python实现
一、评价决策类
1、层次分析法(AHP)
层次分析法用来评价或选择一个更好更优的决策或方案
通过找到可以衡量其好坏的指标,进而衡量指标,再形成评价体系

归一化处理
让指标在同一数量级,且保证在同一指标下其差距保持不变
操作:指标的数组[a b c]归一化处理得到[ a/(a+b+c) , b/(a+b+c) , c/(a+b+c) ]

但实际上每个指标的重要性是不同的,可以给每个指标上加上一个权重

而如何科学的设定权重,则体现出层次分析法的主要作用
层次分析法是对一些较复杂模糊的问题作出决策的简易方法,其适用于难以完全定量分析的问题
模型原理
首先要把问题条理化、层次化,构造出一个有层次的结构模型。复杂问题被分解为元素的组成部分,上一层次的元素作为准则对下一层次有关元素起支配作用

层次可以分为三类:最高层、中间层、最底层

基本步骤

其中第二步构造判断矩阵,要对指标的重要性进行两两比较
矩阵中的元素aij的意义为:第i个指标相对于第j个指标的重要程度


依次对变量进行两两比较,得到完整的判断矩阵

而因为两两比较的过程中忽略了其他因素,导致最后的结果可能出现矛盾
所以需要一致性检验
一致性检验


求权重
Ⅰ.算数平均法

①用每一个元素除以所在列的和
② 每一行相加
③得出的一列数据除以n
Ⅱ.几何平均法

①根据n来开根号
②用每一个开根号后的元素除以所在列的和
Ⅲ.特征值法
求评分

Python代码
在数学建模中最常用的三个库:Numpy、Pandas、Matplotlib
Numpy
Numpy是Python中用于科学计算和数值操作的基础库,其提供了很多高性能的多维数组对象和用于处理数组的各种函数
Pandas
用来提供高性能,易于使用的数据结构和数据分析工具所用的库
Matplotlib
创建可视化的库,也就是用来绘图的
#1、一致性检验
import numpy as np#as np是将numpy库名命名为np,这样在使用的时候更加方便
#定义矩阵A
#np.array是NumPy库中的一个函数,用于创建数组,它可以将输入的对象(列表元组其他数组等)转换为NumPy数组
A=np.array([[1,2,3,5],[1/2,1,1/2,2],[1/3,2,1,2],[1/5,1/2,1/2,1]])#二维数组作矩阵
n=A.shape[0]#shape获取形状信息,获取A的行,1为获取A的列
#求最大特征值以及对应的特征向量
#np.linalg.eig是NumPy库中的一个函数,用于计算方阵的特征值和特征向量
#eig_val特征值,eig_vec特征向量
eig_val,eig_vec=np.linalg.eig(A)
Max_eig=max(eig_val)#求特征值最大值
CI=(Max_eig-n)/(n-1)
#这里n=2时,一定为一致矩阵,所以CI=0,为了避免分母为0,将这里的第二个元素改为了很接近0的正整数
RI=[0,0.0001,0.52,0.89,1.12,1.26,1.36,1.41,1.46,1.49,1.52,1.54,1.56,1.58,1.59]#这里RI最多支持n=15
CR=CI/RI[n-1]
print('一致性指标CI=',CI)
print('一致性比例CR=',CR)
if CR<0.10:
    print('因为CR<0.10,所以该判断矩阵A的一致性可以接受')
else:
    print('注意:CR>=0.10,因此该判断矩阵A需要进行修改')

#2、算数平均法求权重
import numpy as np
A=np.array([[1,2,3,5],[1/2,1,1/2,2],[1/3,2,1,2],[1/5,1/2,1/2,1]])
#计算每一列的和
#no.sum函数可以计算一维数组中所有元素的总和
#可以通过指定axis参数来计算多维数组在某个维度上的元素总和
#例如在二维数组中,axis=0表示按列计算总和,axis=1表示按行计算
ASum=np.sum(A,axis=0)
n=A.shape[0]#shape获取形状信息,获取A的行,1为获取A的列
#归一化,二维数组除以一维数组,会自动将一维数组扩展为与二维数组相同的形状,然后进行逐元素的除法运算
Stand_A=A/ASum
#各列相加到同一行
ASumr=np.sum(Stand_A,axis=1)
#计算权重向量
weights=ASumr/n
print(weights)

#3、几何平均法求权重
import numpy as np
A=np.array([[1,2,3,5],[1/2,1,1/2,2],[1/3,2,1,2],[1/5,1/2,1/2,1]])
#将A中的每一行元素相乘得到一列向量
#np.prod函数可以计算一维数组中所有元素的乘积
prod_A=np.prod(A,axis=1)
n=A.shape[0]
#将新的向量的每个分量开n次方
#np.power函数可以对数组中的元素进行幂运算
prod_n_A=np.power(prod_A,1/n)
#归一化
re_prod_A=prod_n_A/np.sum(prod_n_A)
print(re_prod_A)

#4、特征值法求权重
2、优劣解距离法(Topsis)
Topsis法是常用的综合评价法,其结果能精确的反应各评价方案之间的差距
其引入两个基本概念:
理想解:最优的解(方案),各个属性都达到了备选方案中的最好值
负理想解:最劣的解(方案),各个属性都达到了备选方案中的最坏值
Topsis法通过最接近理想解且最远离负理想解来确定最优选择
原始矩阵正向化
将所有指标类型转换为极大型指标


正向化矩阵后,要将矩阵标准化
正向化矩阵标准化
标准化的目的在于消除不同指标量纲的影响

 计算得分并归一化

模型原理
Topsis在多目标决策分析中是一种非常有效的方法。通过归一化后的矩阵,找出理想解和负理想解,分别计算各个目标与理想解和负理想解的距离,获得各个目标和理想解的贴进度,按照贴进度的大小排序,以此作为评价目标优劣的依据。
贴进度取值在0~1之间,值越接近1,则目标越接近最有水平
基本步骤

Python代码


3、熵权法
在最后评分时根据各指标的重要性不同,需要确定权重。而在前两个模型中,权重都是通过主观得到的,那是否有更为客观得到权重的方法呢?
熵权法是一种客观的赋权方法,它可以靠数据本身得出权重
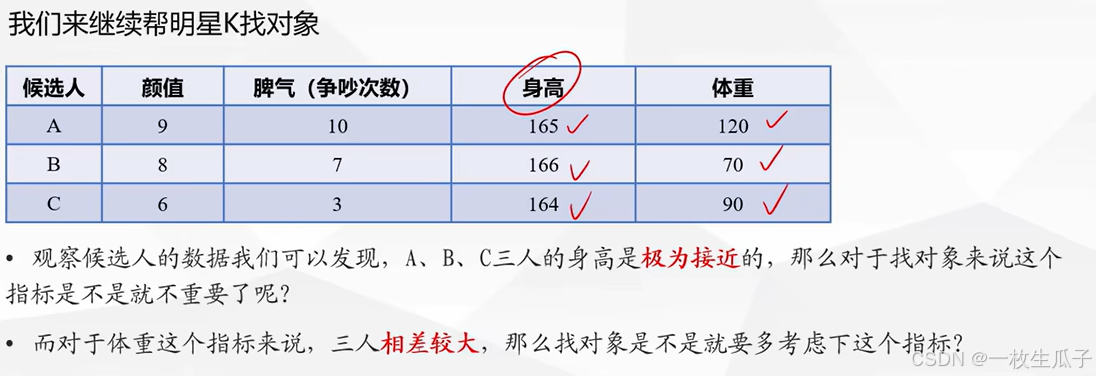
信息是系统有序程度的一个度量,熵则是系统无序程度的一个度量
模型原理
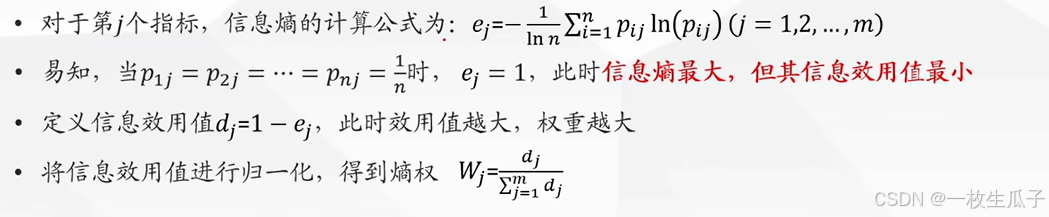
根据信息熵的定义,对于某项指标,可以用熵值来判断其离散程度,其信息熵值越小,指标离散程度越大,权重也就越大;指标的变异程度越小,所反映的信息量也越少,其对应的权值也越低
基本步骤
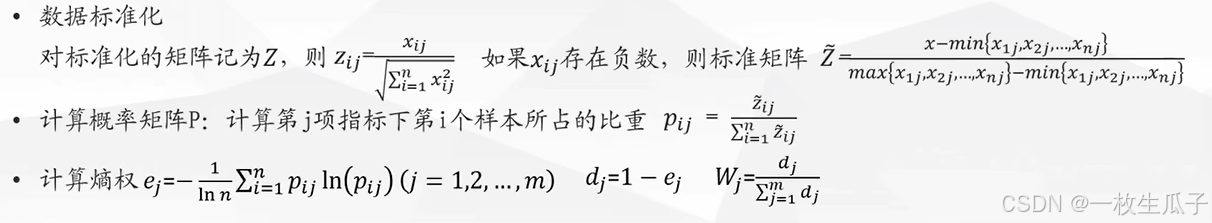 首先正向化
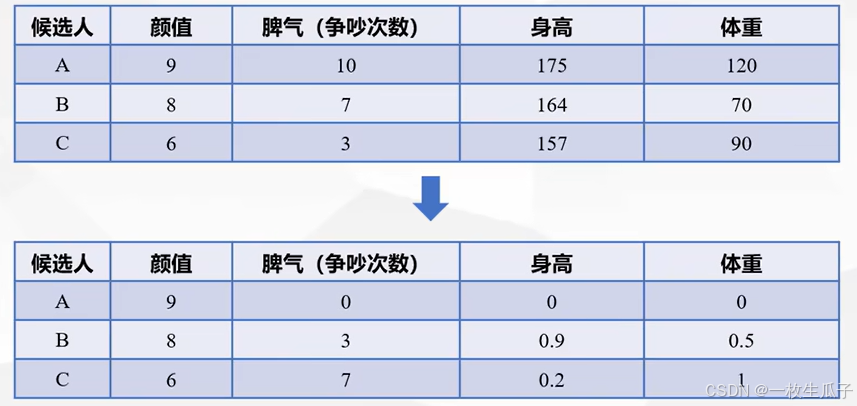
再标准化
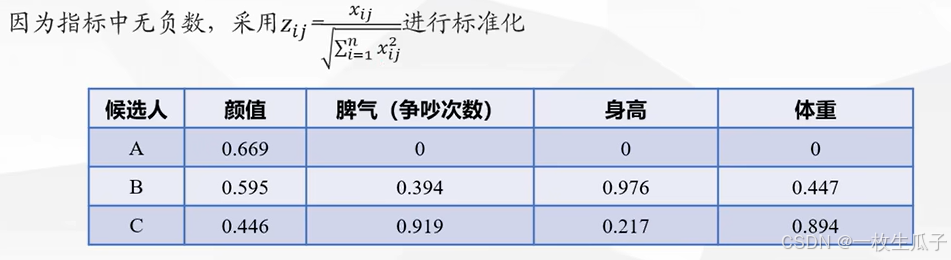
再归一化

最后计算熵权
Python代码
import numpy as np
#定义一个自定义函数mylog,用于处理输入数组中的零元素
def mylog(p):
    n=len(p)#获取输入向量p的长度
    lnp=np.zeros(n)#创建一个长度为n,元素都为0的新数组lnp
    for i in range(n):#对向量p的每一个元素进行循环
        if p[i]==0:
            lnp[i]=0
        else:
            lnp[i]=np.log(p[i])
    return lnp

#输入正向化后的指标矩阵
X=np.array([[9,0,0,0],[8,3,0.9,0.5],[6,7,0.2,1]])
#标准化处理
Z=X/np.sqrt(np.sum(X*X,axis=0))
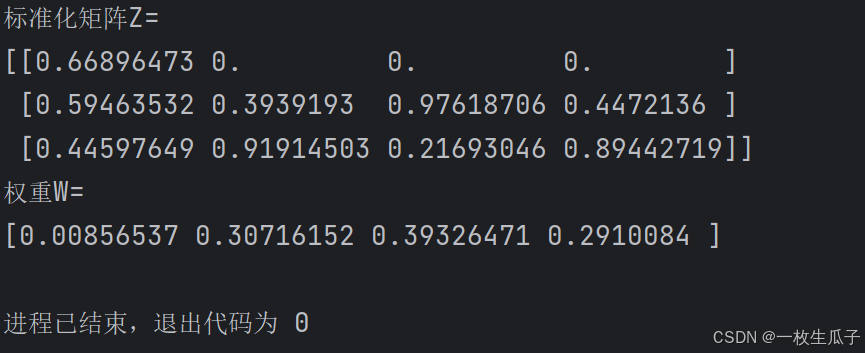
print('标准化矩阵Z=')
print(Z)
#定义计算熵权所需的变量以及矩阵初始化
n,m=Z.shape#获取Z矩阵的行数和列数
D=np.zeros(m)#初始化一个长度为m的数组D,用于保存每个指标的信息效用值
#计算每个指标的信息效用值d
for  i in range(m):#遍历Z的每一列
    x=Z[:,i]#获取Z的第i列,即第i个指标的所有数据
    #对第i个指标进行归一化处理
    p=x/np.sum(x)
    #使用自定义的mylog函数计算p的对数
    #需要注意的是,如果p中含有0,直接使用np.log会得到-inf,这里使用自定义函数解决了这个问题
    e=-np.sum(p*mylog(p))/np.log(n)#根据熵的定义计算第i个指标的信息熵e
    D[i]=1-e
#根据信息效用值计算各指标的权重
W=D/np.sum(D)
print('权重W=')
print(W)
4、模糊综合评价模型
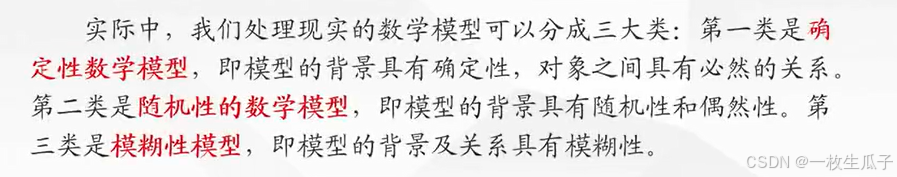
像美丑这样的概念称为模糊性概念
模糊是指客观事物差异的中间过渡中的“不分明性”或“亦此亦彼性”
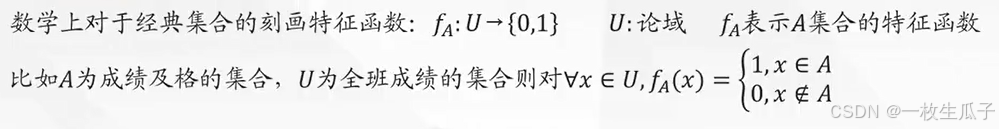
集合:具有相同属性事物的集体。
其基本属性包括①互斥性(集合中的元素都不相同)②确定性(元素是否属于集合是确定的)
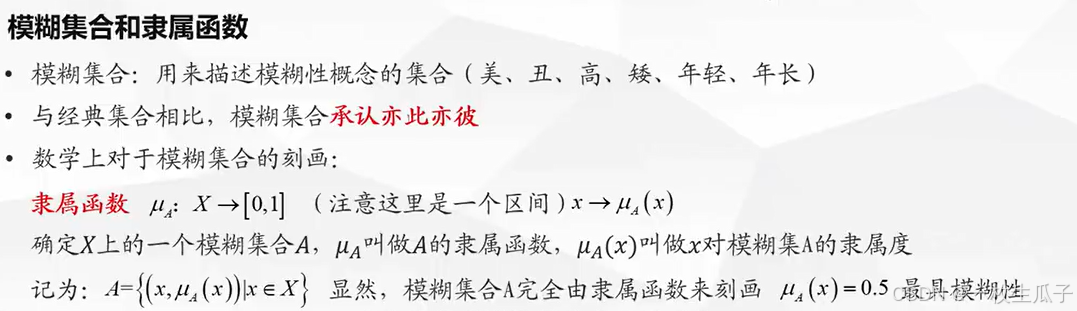
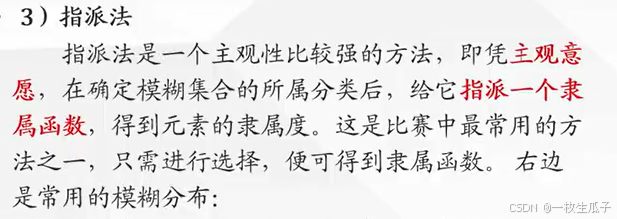
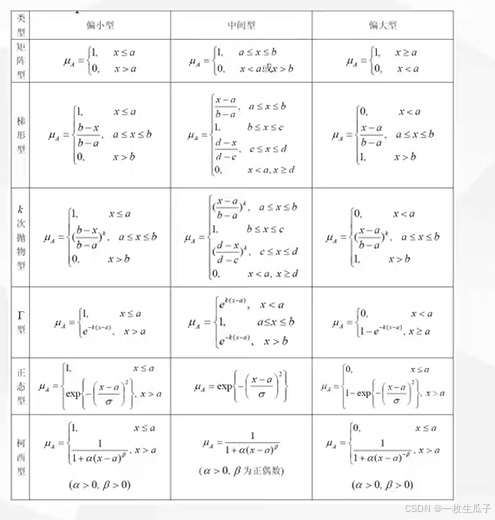
简单来说,隶属度就是元素属于某个模糊集合的程度,而隶属函数就是来确定隶属度的函数
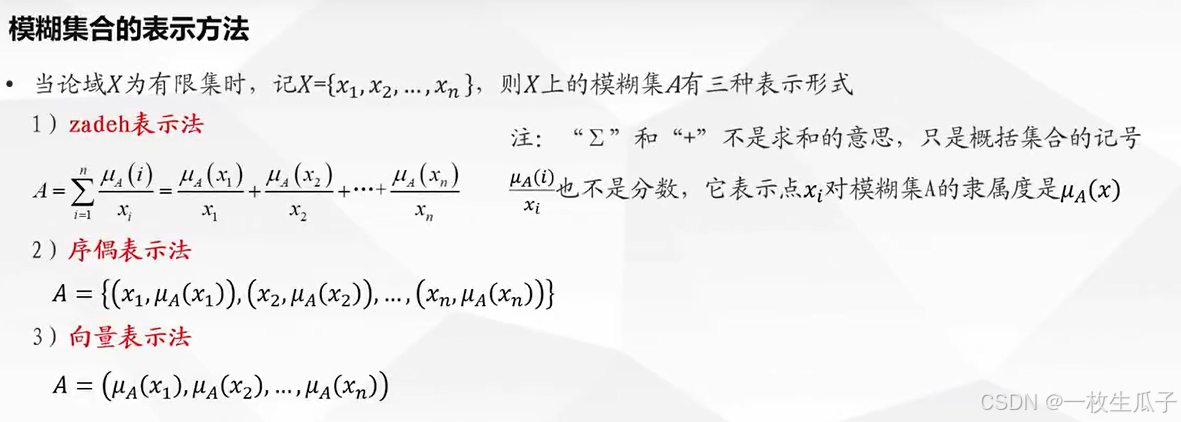
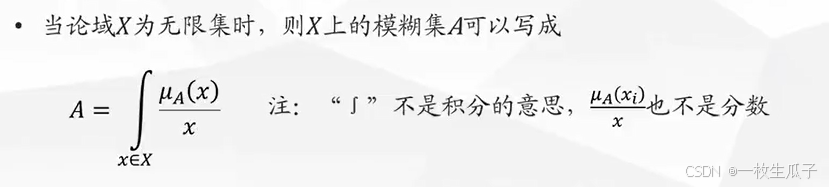
模糊集合的表示
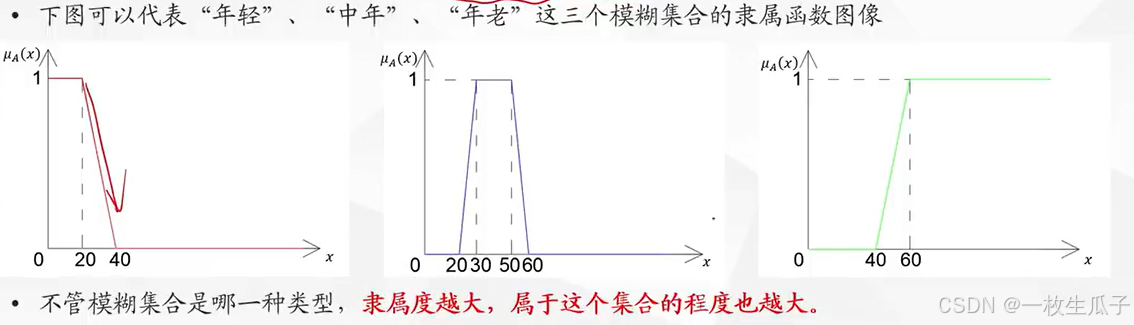
模糊集合的分类

隶属函数的确定




评价问题概述
一级模糊综合评价模型
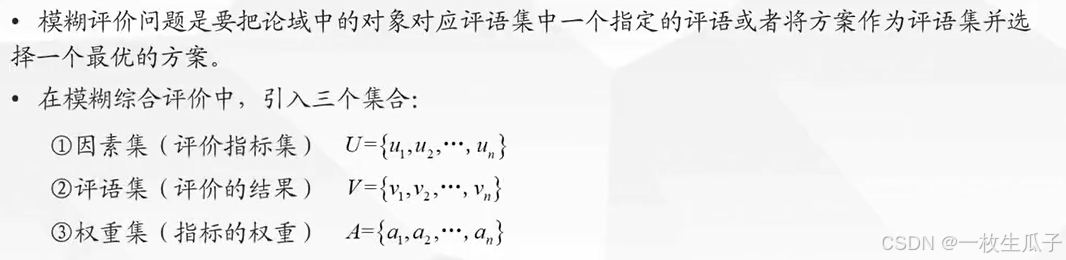
在指标个数较少的考核中,可以运用一级模糊综合评判
基本步骤
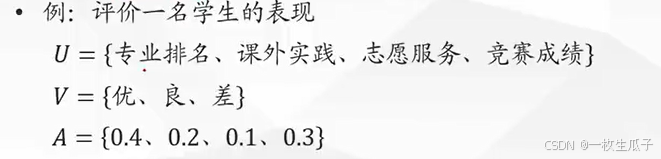
(1)确定因素集、评语集、权重集合(Delphi、层次分析、熵权法等)
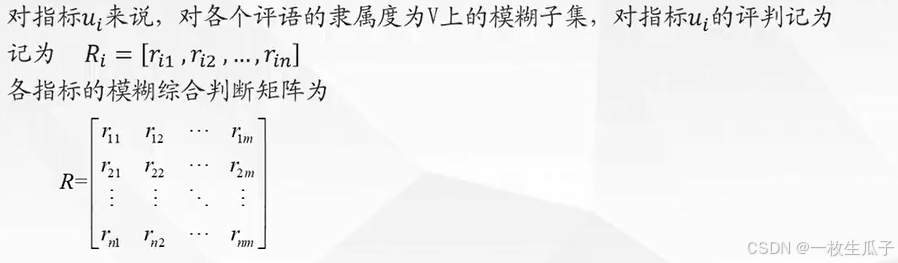
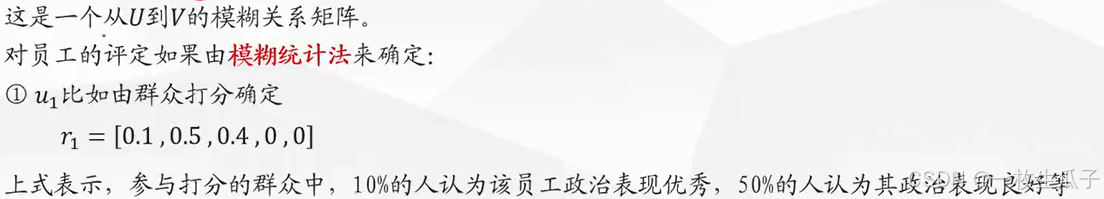
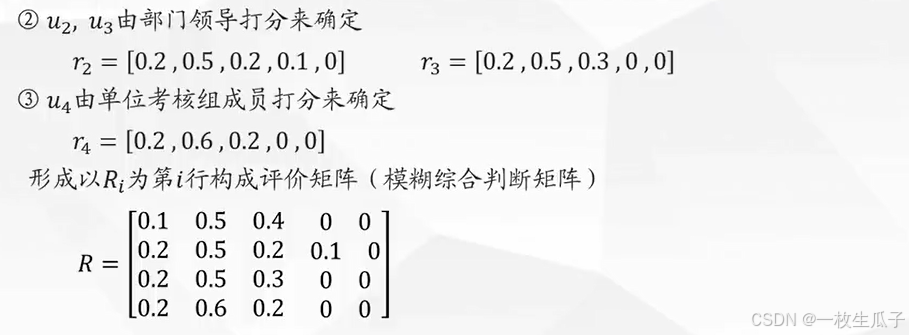
(2)确定模糊综合判断矩阵
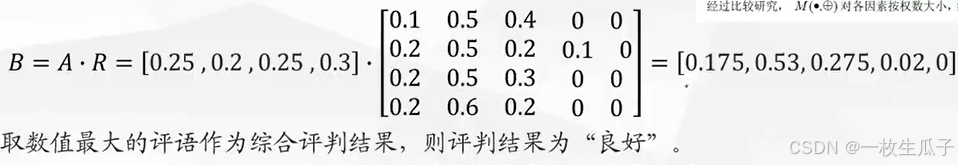
(3)模糊综合判断,进行矩阵合成运算
多层次模糊综合评价模型


概念比较抽象,以例题为例
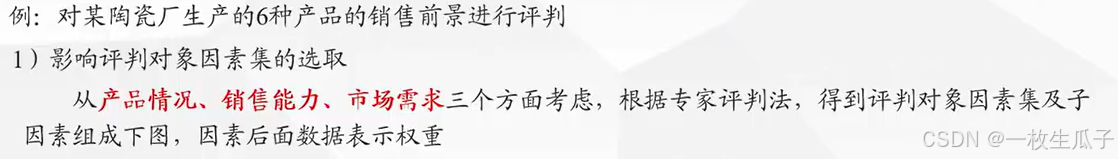
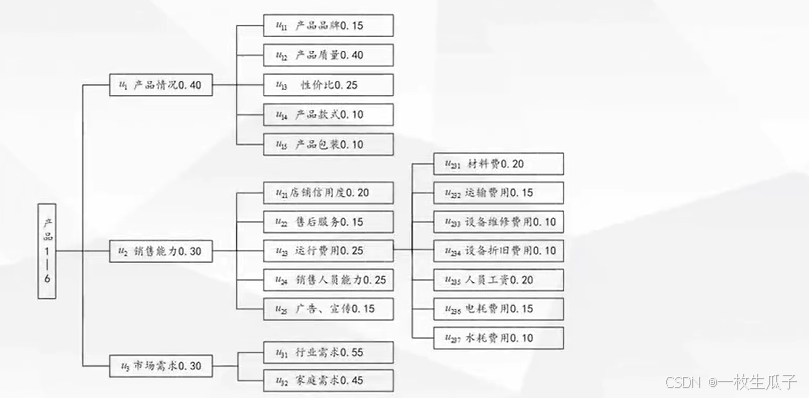

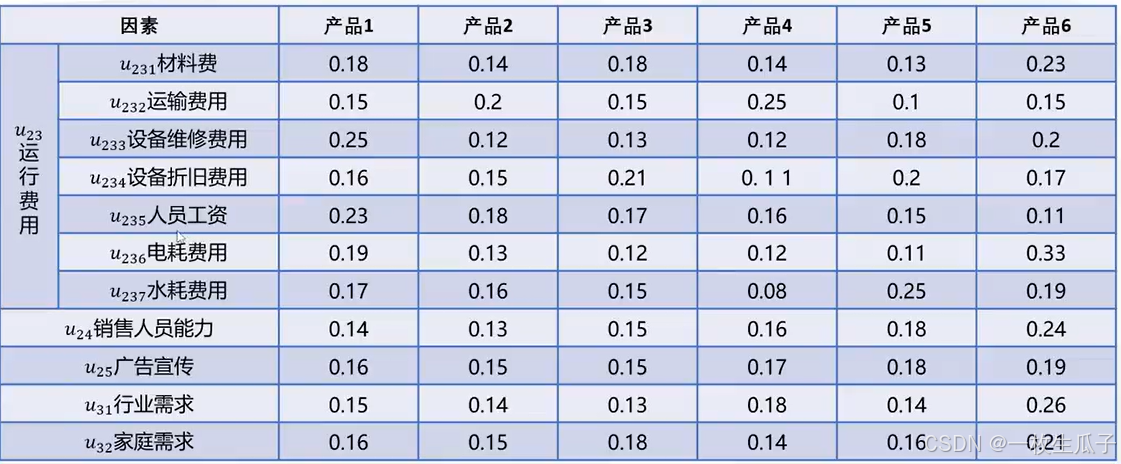


Python代码
import numpy as np
#1、一级模糊综合评判
#影响运行费用的各因素的单因素评价矩阵为:
R23=np.array([
    [0.18,0.14,0.18,0.14,0.13,0.23],
    [0.15,0.20,0.15,0.25,0.10,0.15],
    [0.25,1.12,0.13,0.12,0.18,0.20],
    [0.16,0.15,0.21,0.11,0.20,0.17],
    [0.23,0.18,0.17,0.16,0.15,0.11],
    [0.19,0.13,0.12,0.12,0.11,0.33],
    [0.17,0.16,0.25,0.08,0.25,0.19]])
#权重分配为
A23=np.array([0.20,0.15,0.10,0.10,0.20,0.15,0.10])
#评价结果
#np.dot是Numpy库中的一个函数,用于计算两个数组的点积。对于一维数组,它计算的是这两个数组的内积
#对于二维数组(矩阵来说),它计算的是矩阵乘法
B23=np.dot(A23,R23)
#2、二级模糊综合判定
R1=np.array([
    [0.12,0.18,0.17,0.23,0.13,0.17],
    [0.15,0.13,0.18,0.25,0.12,0.17],
    [0.14,0.13,0.16,0.18,0.20,0.19],
    [0.12,0.14,0.15,0.17,0.19,0.23],
    [0.16,0.12,0.13,0.25,0.18,0.16]])
A1=np.array([0.15,0.20,0.25,0.10,0.10])
B1=np.dot(A1,R1)
#以下数据复制的R1,没改哈
R2=np.array([
    [0.12,0.18,0.17,0.23,0.13,0.17],
    [0.15,0.13,0.18,0.25,0.12,0.17],
    [0.14,0.13,0.16,0.18,0.20,0.19],
    [0.12,0.14,0.15,0.17,0.19,0.23],
    [0.16,0.12,0.13,0.25,0.18,0.16]])
A2=np.array([0.15,0.20,0.25,0.10,0.10])
B2=np.dot(A2,R2)

R3=np.array([
    [0.12,0.18,0.17,0.23,0.13,0.17],
    [0.15,0.13,0.18,0.25,0.12,0.17],
    [0.14,0.13,0.16,0.18,0.20,0.19],
    [0.12,0.14,0.15,0.17,0.19,0.23],
    [0.16,0.12,0.13,0.25,0.18,0.16]])
A3=np.array([0.15,0.20,0.25,0.10,0.10])
B3=np.dot(A3,R3)
#3、三级模糊综合判定
R=np.array([B1,B2,B3])
A=np.array([0.4,0.3,0.3])
B=np.dot(A,R)

print(B)
5、灰色关联分析模型
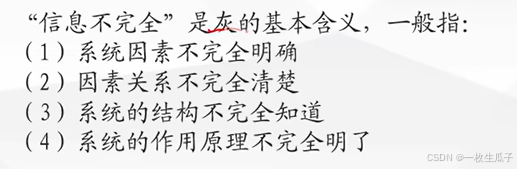
一个系统是黑色说明信息量太少,白色说明信息量充足。处在黑白之间,信息不完全的系统,称为灰色系统
灰色系统用颜色深浅反应信息量的多少
关联分析

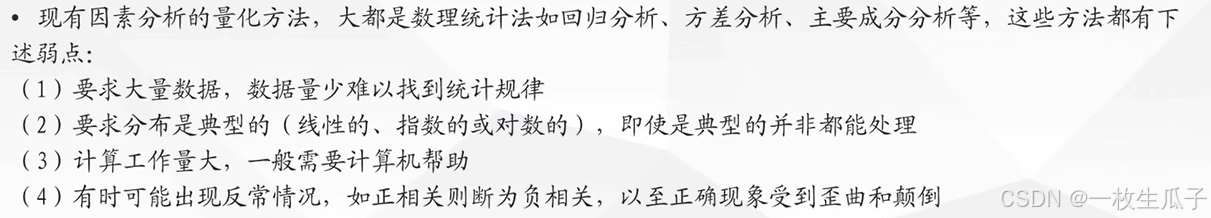

灰色关联分析是一种多因素统计分析的方法
其弥补了采用数理统计方法作为系统分析所导致的缺憾,对样本量的多少和样本有无规律都适用,而且计算量小,十分方便,不会出现量化结果与定性分析结果不符的情况
基本思想
根据序列曲线几何形状的相似程度来判断其联系是否紧密。曲线越接近,相应序列之间的关联度就越大,反之则越小
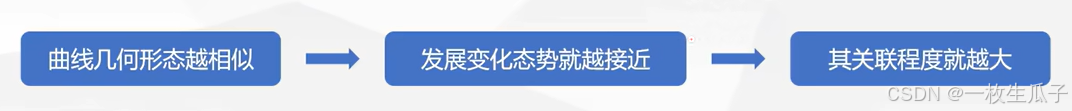
分析时首先要选准反映系统行为特征的数据序列,即找系统行为的映射量,用映射量来间接的表征系统行为
例:用国民平均接受教育的年数来反应教育发达程度
有了系统行为特征数据和相关因素的数据,即可作出各个序列的图形,从直观上进行分析
基本步骤
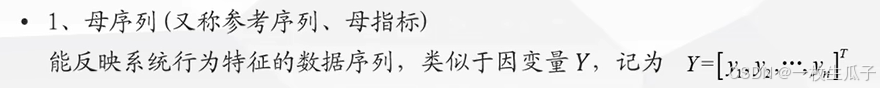
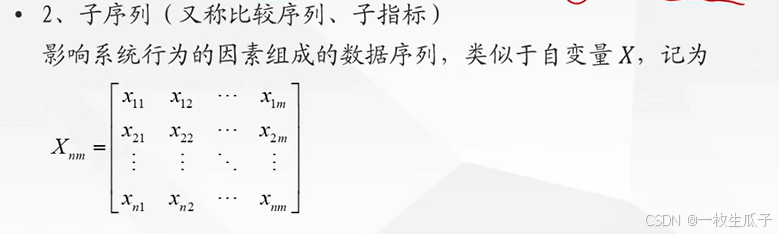
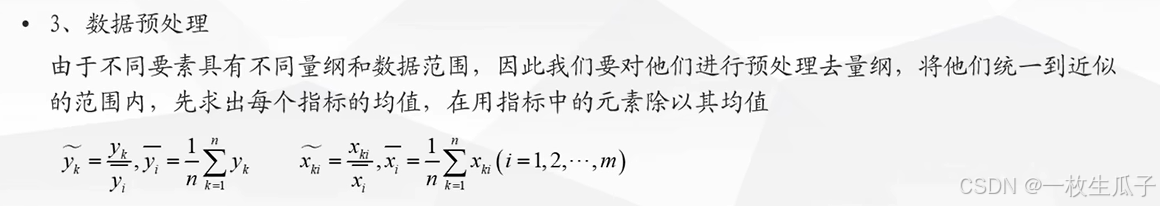
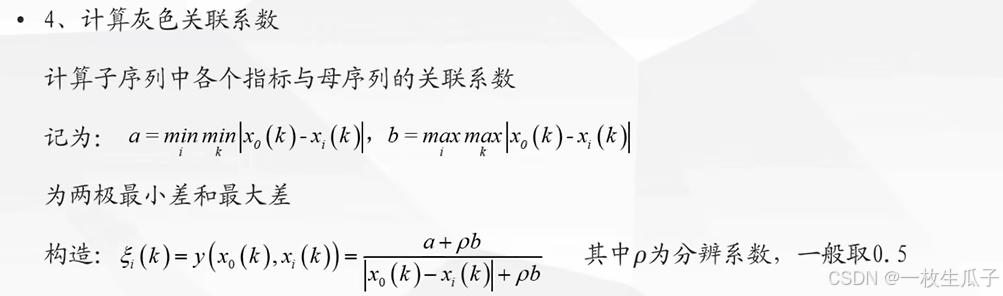
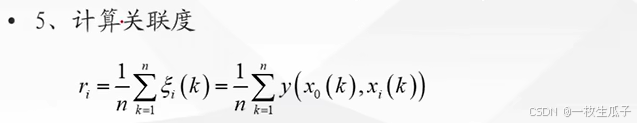
概念比较抽象,以例题为例
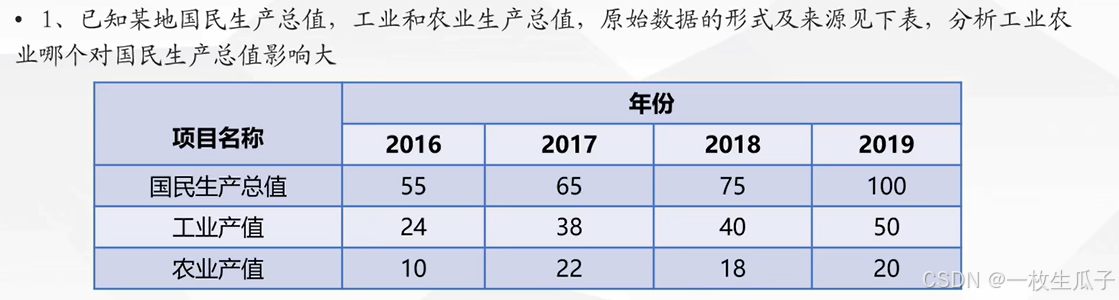
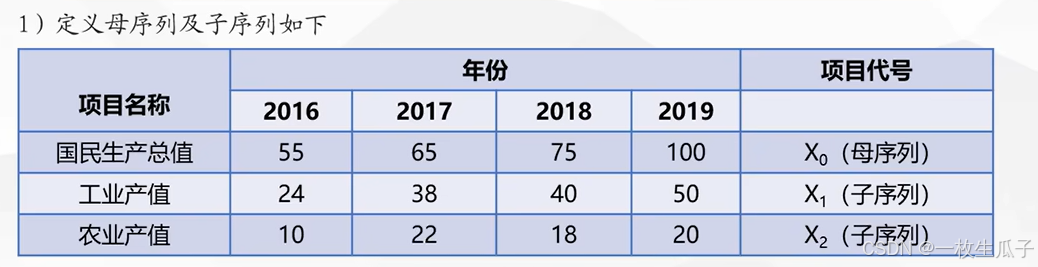
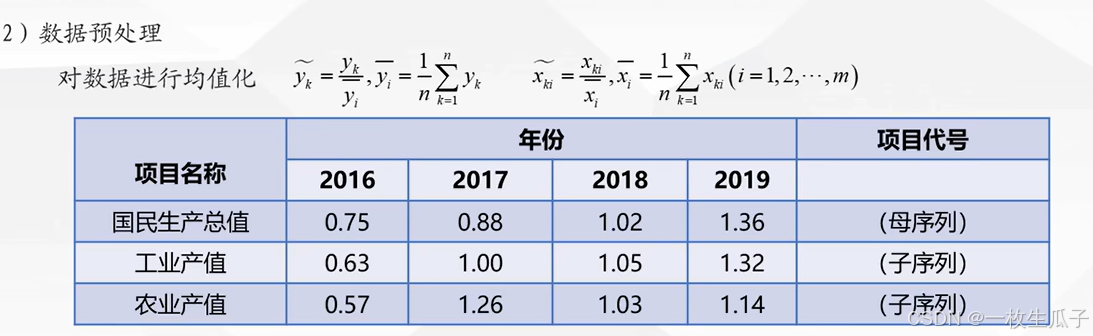
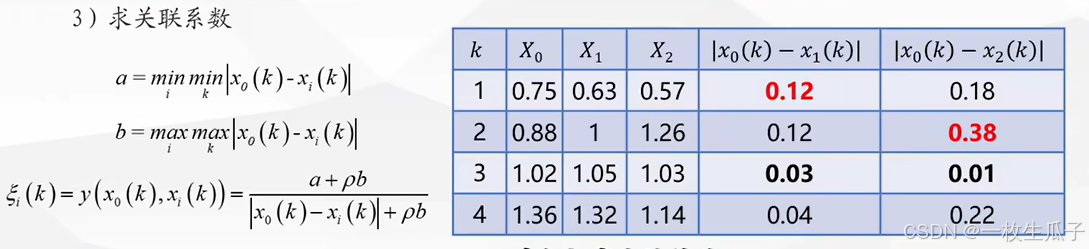
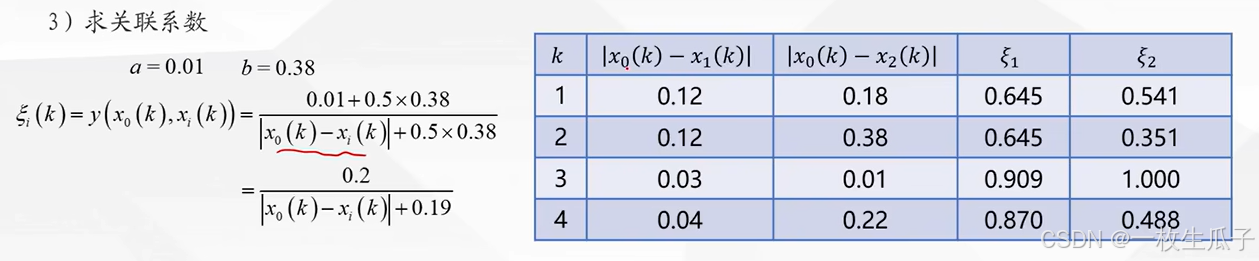
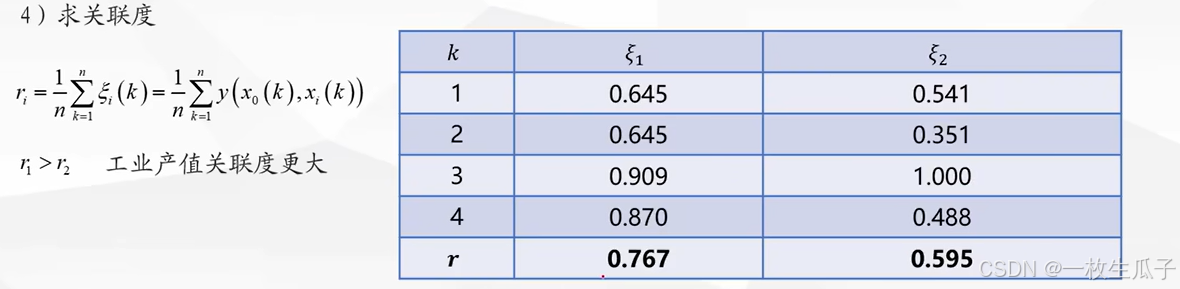
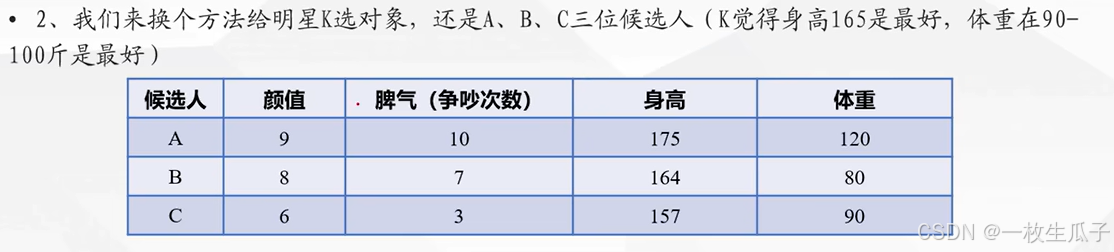
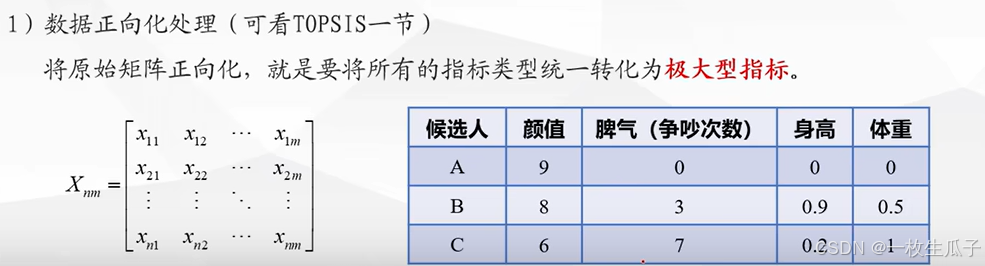
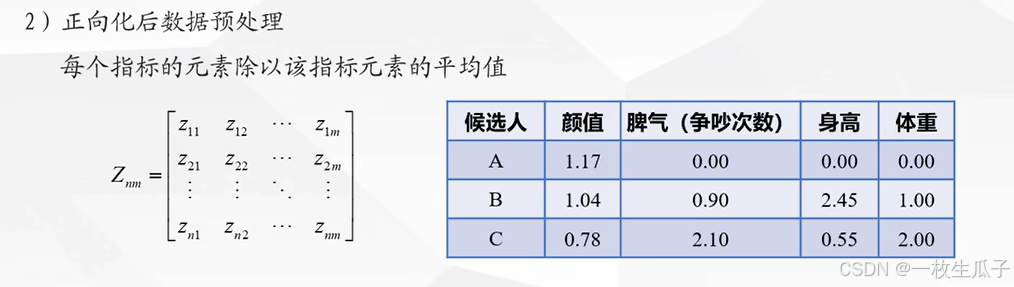
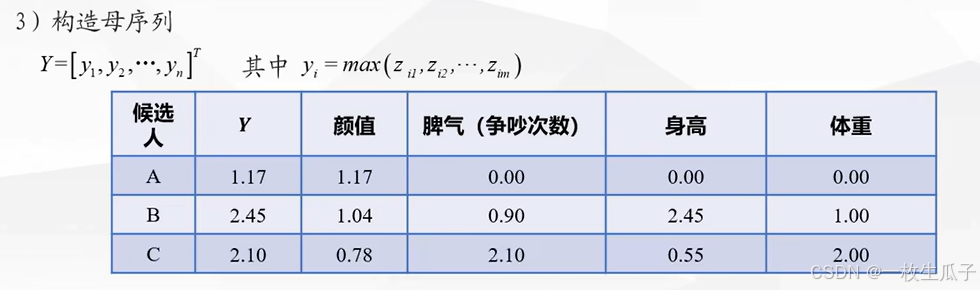
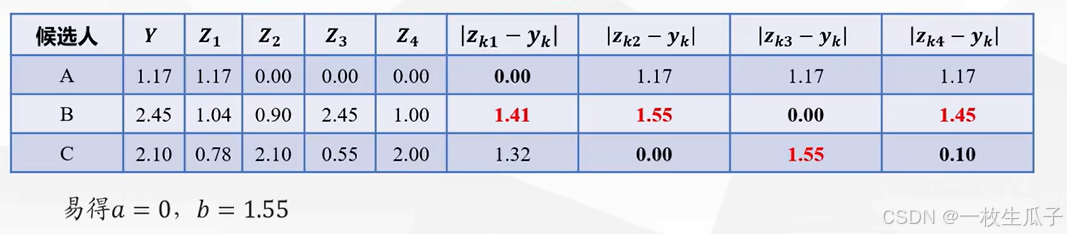
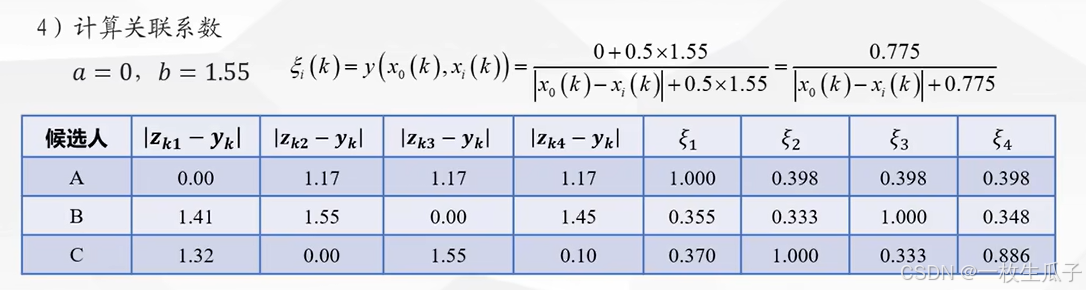
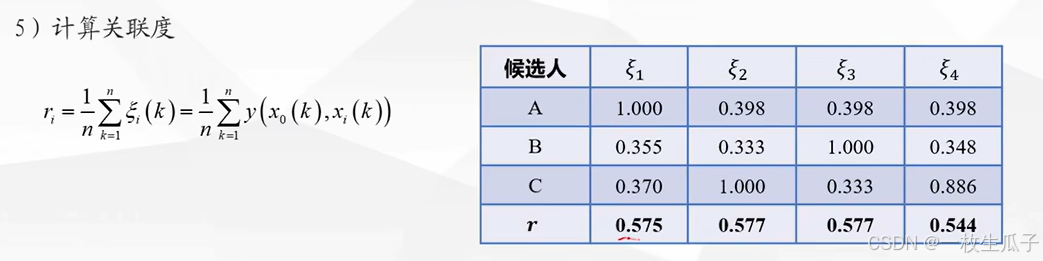
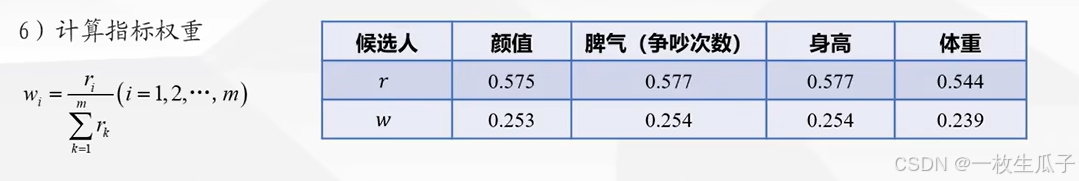
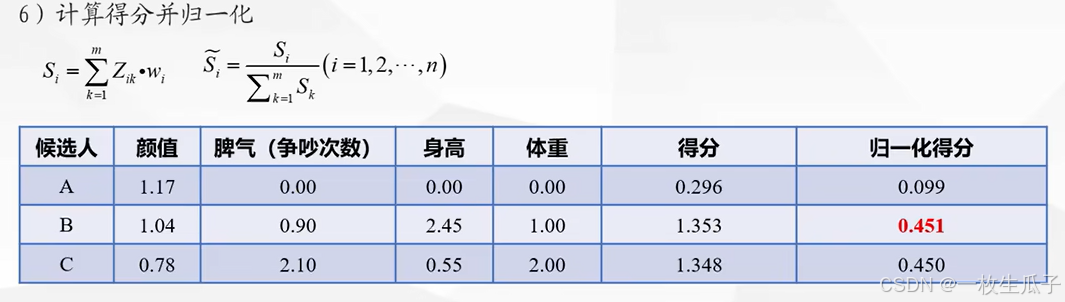
母序列取每行的最大值
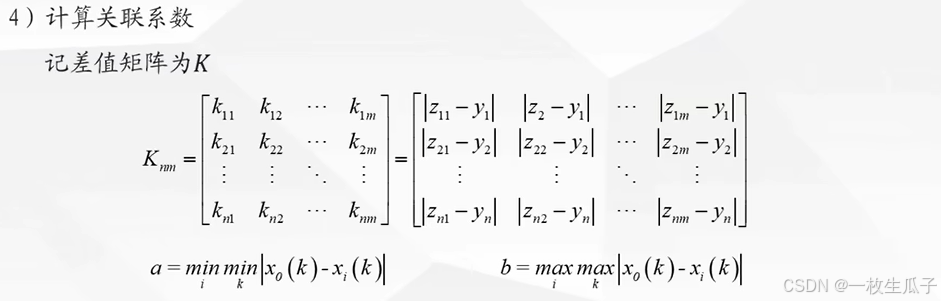

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 20
 0
- 0


 已为社区贡献1条内容

所有评论(0)