Neyman-Pearson 奈曼-皮尔逊决策分析
Neyman-Pearson 奈曼-皮尔逊决策分析
1. 决策问题的引入——二分类问题
二分类问题中犯错的可能性有两种情况:
①采取决策w1w_1w1时的实际自然状态为w2w_2w2,此情况错误率可定义为P(w2)P2(error)P(w_2)P_2(error)P(w2)P2(error),其中P2(error)=∫R1p(x∣w2)dx(1)P_2(error)=\int_{R_1}p(x|w_2)dx \tag{1}P2(error)=∫R1p(x∣w2)dx(1)
②采取决策w2w_2w2时的实际自然状态为w1w_1w1,此情况错误率可定义为P(w1)P1(error)P(w_1)P_1(error)P(w1)P1(error),其中P1(error)=∫R2p(x∣w1)dx(2)P_1(error)=\int_{R_2}p(x|w_1)dx \tag{2}P1(error)=∫R2p(x∣w1)dx(2)
由于先验概率在某些具体问题中一般是确定的,因此称P1(e),P2(e)P_1(e),P_2(e)P1(e),P2(e)为两类错误率,R1,R2R_1,R_2R1,R2分别是第1,2类错误的决策区域。其图形表示如图所示:
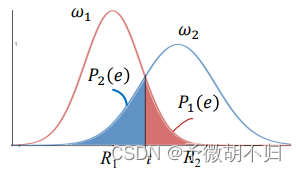
第一类错误:假阳率(FP);
第二类错误:假阴率(FN);
2. Neyman-Pearson决策
2.1 问题转化
在某些实际应用过程中,有时希望保证某一类错误率维持在一个固定水平,以此为前提,考虑另一类错误率尽可能地低。比如在医疗检测时,检测出某种疾病非常重要,可能会要求漏报率即第二类错误达到某一个水平ε\varepsilonε(比如0.1%,即灵敏度99.9%),在这个基础上,希望误报率尽可能低。
如果将w1w_1w1看作是阴性而把w2w_2w2看作是阳性,那么第一类错误率定义为:
P1(error)=∫R2p(x∣w1)dx(3)P_1(error)=\int_{R_2}p(x|w_1)dx \tag{3}P1(error)=∫R2p(x∣w1)dx(3)
第二类错误率定义为:
P2(error)=∫R1p(x∣w2)dx(4)P_2(error)=\int_{R_1}p(x|w_2)dx \tag{4}P2(error)=∫R1p(x∣w2)dx(4)
因此可将该问题转化为最优化问题(固定一类错误率,使得另一类错误率尽可能小):
minP1(e)s.t.P2(e)=ε(5)min{P_1(e)}\\s.t.P_2(e)=\varepsilon \tag{5}minP1(e)s.t.P2(e)=ε(5)
2.2 拉格朗日(language)乘数法
通过引入拉格朗日乘子λ\lambdaλ从而将该有约束条件极值问题写作:
minL=P1(e)+λ(P2(e)−ε)(6)min{L}=P_1(e)+\lambda(P_2(e)-\varepsilon) \tag{6}minL=P1(e)+λ(P2(e)−ε)(6)
需要注意的是,LLL函数的最小值是关于两类的分界面求解的。假设R1,R2R_1,R_2R1,R2分别为第一类错误和第二类错误的决策区域,RRR是整个特征空间,且有R1+R2=RR_1+R_2=RR1+R2=R,两个决策区域之间的边界称为决策边界或分界面(一维情况下为一个点-决策点),考虑到类条件概率密度的性质,有
∫R2p(x∣w1)dx=1−∫R1p(x∣w1)dx(7)\int_{R_2}p(x|w_1)dx=1-\int_{R_1}p(x|w_1)dx\tag{7}∫R2p(x∣w1)dx=1−∫R1p(x∣w1)dx(7)
将式(3),(4)代入(7)中得:
L=∫R2p(x∣w1)dx+λ[∫R1p(x∣w2)dx−ε]=(1−λε)+∫R1[λp(x∣w2)−p(x∣w1)]dx(8)\begin{aligned}
L&=\int_{R_2}p(x|w_1)dx+\lambda[\int_{R_1}p(x|w_2)dx-\varepsilon]\\&=(1-\lambda\varepsilon)+\int_{R_1}[\lambda p(x|w_2)-p(x|w_1)]dx
\end{aligned}\tag{8}L=∫R2p(x∣w1)dx+λ[∫R1p(x∣w2)dx−ε]=(1−λε)+∫R1[λp(x∣w2)−p(x∣w1)]dx(8)
优化的最终目标是求解使式(8)最小的决策边界(点)x=tx=tx=t。
根据拉格朗日求解多元函数条件极值的方法,将(8)分别对λ\lambdaλ和分界面(点)ttt求偏导:
∂L∂t=λp(x∣w2)−p(x∣w1)∂L∂λ=∫R1p(x∣w2)dx−ε(9)\begin{aligned}
\frac{\partial L}{\partial t} &= \lambda p(x|w_2)-p(x|w_1)\\
\frac{\partial L}{\partial \lambda} &= \int_{R_1}p(x|w_2)dx-\varepsilon
\end{aligned}\tag{9}∂t∂L∂λ∂L=λp(x∣w2)−p(x∣w1)=∫R1p(x∣w2)dx−ε(9)
由于极值点处的导数都应为0,即在决策边界上应满足:
λ=p(x∣w1)p(x∣w2)ε=∫R1p(x∣w2)dx(10)\begin{aligned}
\lambda&=\frac{p(x|w_1)}{p(x|w_2)}\\
\varepsilon&=\int_{R_1}p(x|w_2)dx
\end{aligned}\tag{10}λε=p(x∣w2)p(x∣w1)=∫R1p(x∣w2)dx(10)
在式(7)中,若要使得LLL最小,由于第一项(1−λε)(1-\lambda\varepsilon)(1−λε)当ε,λ\varepsilon,\lambdaε,λ确定后,该项为定值。若希望函数整体趋向最小,则应选择决策区域R1R_1R1使积分项内全为负值(如图,函数在R_1区域恒大于0,积分结果=面积)。
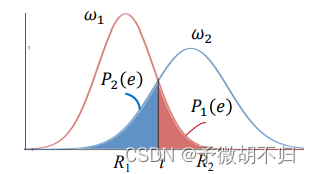
综上,所确定的R1R_1R1应是所有使得λp(x∣w2)−p(x∣w1)<0\lambda p(x|w_2)-p(x|w_1)<0λp(x∣w2)−p(x∣w1)<0成立的xxx所组成的区域。
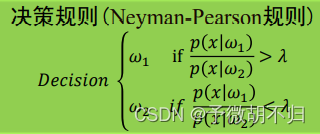
当处于决策区域R1R_1R1时,由图知应判定为属于w1w_1w1,由于R1+R2=RR_1+R_2=RR1+R2=R,所以其余情况均应判定为属于w2w_2w2。
因而决策规则为:
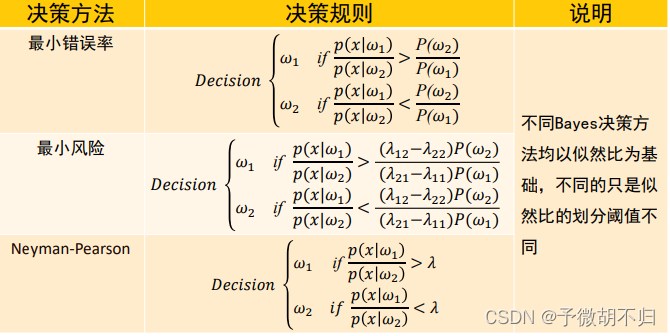
2.3 决策规则扩展

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)