Windows 训练YOLOV8 (超级简单的运行方案)
为什么选择YOLOV8进行训练?
以下是选择YOLOv8训练模式的一些有力理由:
- 效率: 充分利用您的硬件资源,无论您是使用单GPU设置还是跨多个GPU扩展。
- 多功能: 除了可随时获取的数据集(如COCO、VOC和ImageNet)之外,还可以对自定义数据集进行训练。
- 用户友好: 简单而强大的CLI和Python接口,为您提供直接的训练体验。
- 超参数灵活性: 可定制的广泛超参数范围,以微调模型性能。
训练模式的关键特性
以下是YOLOv8训练模式的一些显著特点:
- 自动数据集下载: 标准数据集如COCO、VOC和ImageNet将在首次使用时自动下载。
- 多GPU支持: 无缝地跨多个GPU扩展您的训练工作,以加快过程。
- 超参数配置: 通过YAML配置文件或CLI参数修改超参数的选项。
- 可视化和监控: 实时跟踪训练指标并可视化学习过程,以获得更好的洞察力。
环境安装
1.安装python
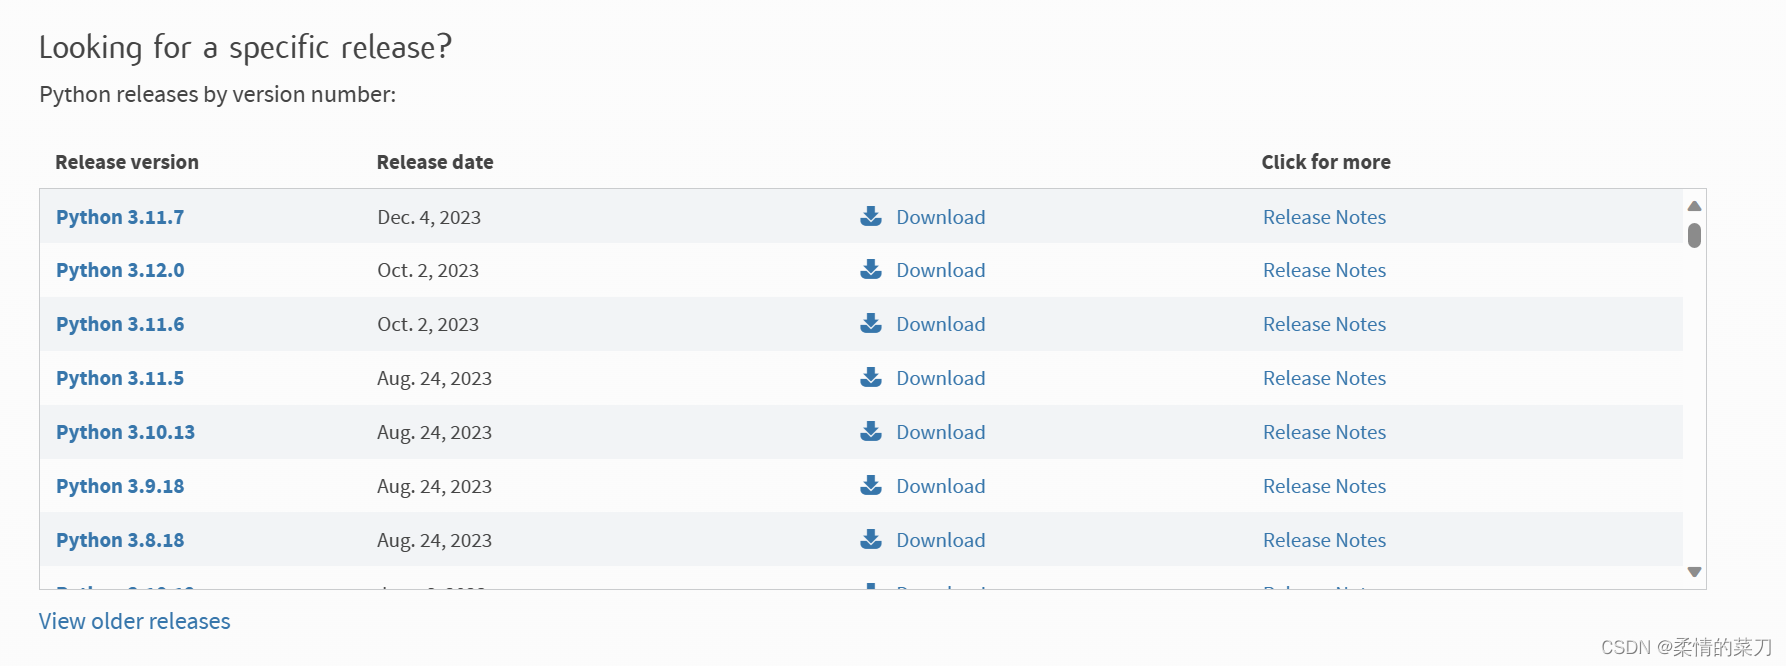
打开 Download Python | Python.org 网页,选择最新的版本下载,点击下一步安装即可
 2.安装ultralytics
打开cmd输入pip install ultralytics,等待结束即可
3.安装touch torchvision等依赖项
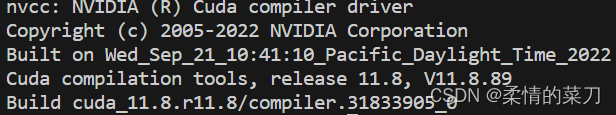
1)输入 nvcc.exe --version 查看自己电脑的CUDA的版本信息
以下是我的版本信息:
2)安装touch torchaudio
由于我的版本是11.8,所以我得指令使用cu118: pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
3)安装torchvision
pip install .\torchvision-0.16.1+cu118-cp311-cp311-win_amd64.whl
如果以上的安装都没有报错,那恭喜你依赖环境已经搭好,剩下就可直接运行YOLOV8了
4.运行YOLOV8
1)创建运行目录
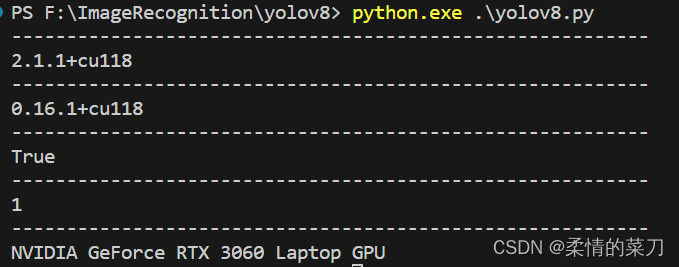
创建YOLOV8文件夹,在文件夹中创建yolov8.py,加入以下代码并在cmd中执行以下指令验证运行环境
python.exe .\yolov8.py
######################## 运行版本验证 ########################
import torch
import torchvision
print('----------------------------------------------------------')
print(torch.__version__)  # 查看torch版本
print('----------------------------------------------------------')
print(torchvision.__version__)  # 查看torchvision版本
print('----------------------------------------------------------')
print(torch.cuda.is_available())  # 查看torch下cuda是否可用
print('----------------------------------------------------------')
print(torch.cuda.device_count())  # 查看#GPU驱动数量
print('----------------------------------------------------------')
print(torch.cuda.get_device_name())  # 查看#GPU驱动动名称
我的环境运行结果如下:##说明环境没有问题##
2)准备数据集
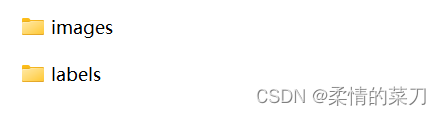
创建vocdata文件夹,在文件夹下分别创建images和labels文件夹,其中images存放图片信息,labels存放标注信息(哈哈,你没看错,就这么简单)
2)开始训练
在YOLOV8文件夹下,创建yolov8.data.yaml文件,内容如下:
# Train/val/test sets as
# 1) dir: path/to/imgs
# 2) file: path/to/imgs.txt
# 3) list: [path/to/imgs1, path/to/imgs2, ..]

path: F:/ImageRecognition/vocdata  # dataset root dir
train: images  # train images (relative to 'path')
val: images  # val images (relative to 'path')
test:  # test images (optional)

# Classes
names:
  0: cow_down
  1: cow_stand
创建yyolov8.train.py,代码如下:
####################### 新的训练 ########################
from ultralytics import YOLO
# 加载一个模型
model = YOLO('yolov8.yaml')  # 从YAML建立一个新模型
model = YOLO('yolov8n.pt')  # 加载预训练模型(推荐用于训练)
model = YOLO('yolov8n.yaml').load('yolov8n.pt')  # 从YAML建立并转移权重

# # 训练模型
results = model.train(data='yolov8.data.yaml',
                      epochs=100, imgsz=640,device=0,workers=0,batch =128)
YOLO模型的训练设置是指用于对数据集进行模型训练的各种超参数和配置。这些设置会影响模型的性能、速度和准确性。一些常见的YOLO训练设置包括批大小、学习率、动量和权重衰减。其他可能影响训练过程的因素包括优化器的选择、损失函数的选择以及训练数据集的大小和组成。仔细调整和实验这些设置以实现给定任务的最佳性能是非常重要的。
关键参数如下:
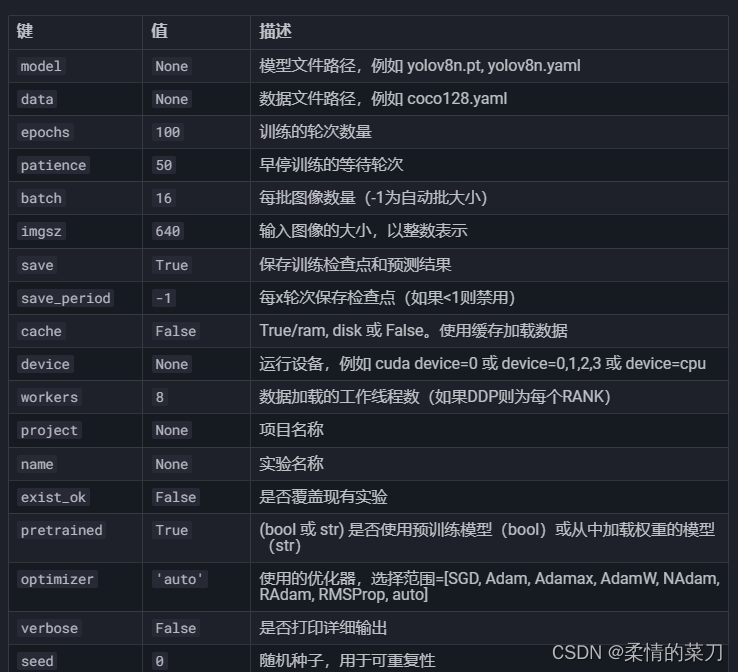
运行 python.exe yolov8.train.py 即可开始训练,如下图所示:
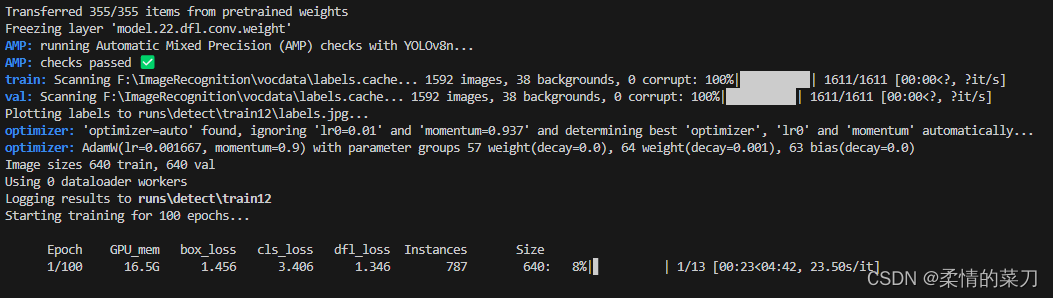
等待100次训练结束,就可以测试模型了
4.测试模型
在YOLOV8文件夹下,创建yolov8.predict.py文件,内容如下:
######################## 推理 ########################

from ultralytics import YOLO
# 加载预训练的 YOLOv8n 模型
model = YOLO('F:/ImageRecognition/yolov8/runs/detect/train/weights/last.pt')
# 定义图像文件的路径
source = 'F:/ImageRecognition/vocdata/predict/'
# 对来源进行推理
# results = model(source)  # Results 对象列表
# 运行推理,并附加参数
model.predict(source, save=True, imgsz=640, conf=0.2,device=0)
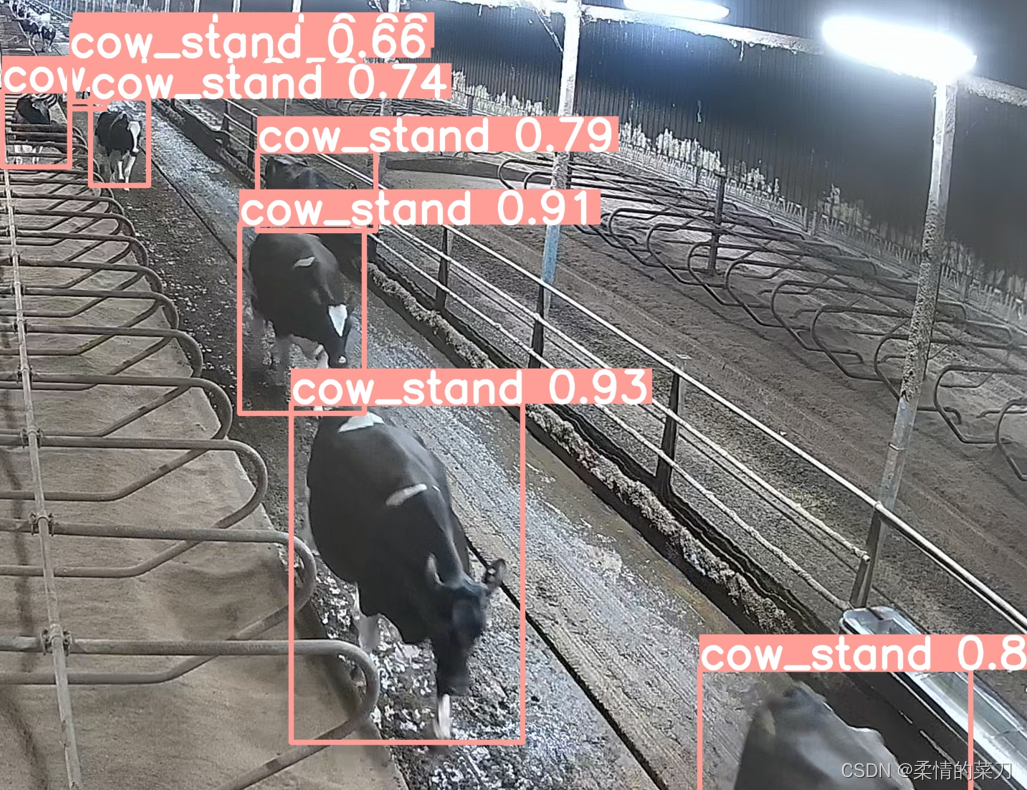
结果还可以,毕竟自己比较菜,更加魔幻的操作还在学习中:
以下是本次测试的结果:判断牛是否摔倒
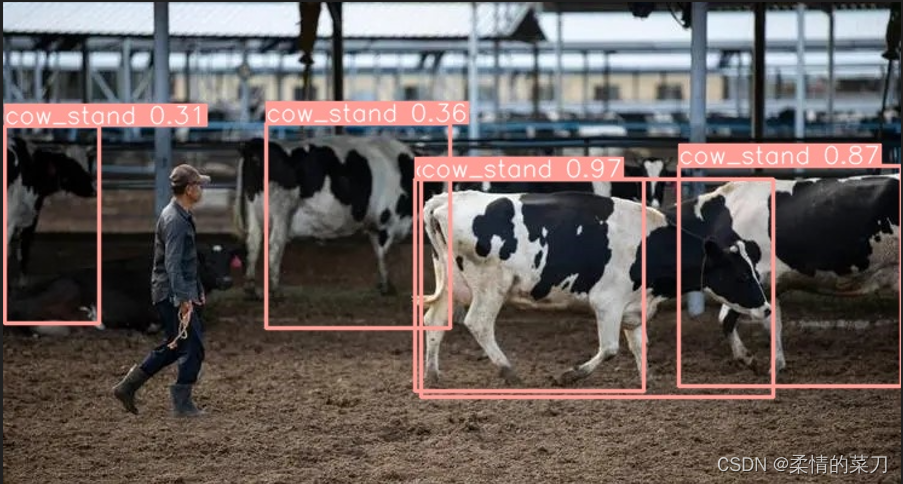
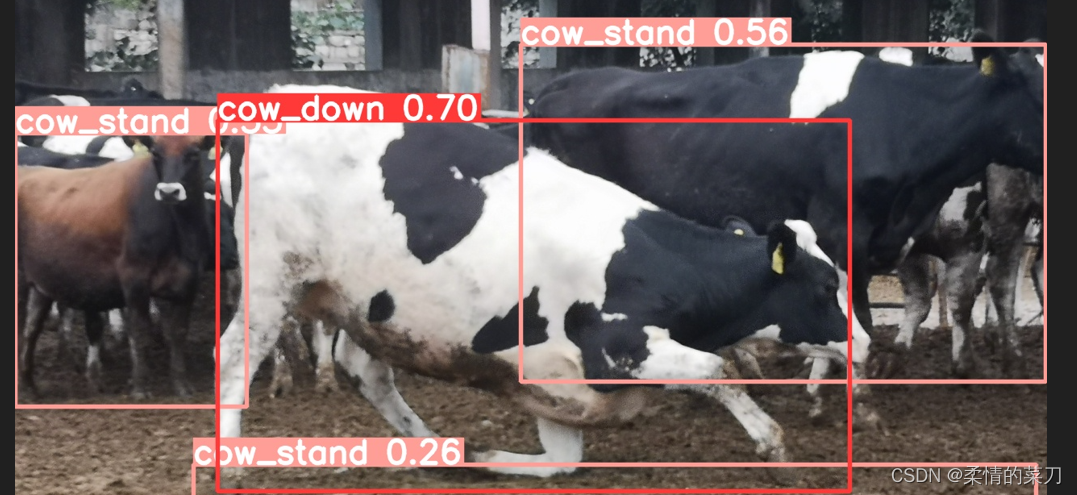

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 33
 0
- 0


 已为社区贡献2条内容

所有评论(0)