字体加密另类反爬对策(2023可用)
字体加密另类反爬对策(2023可用)
前言:
本篇内容仅供学习参考交流,转载请注明出处,如若侵权,请联系删除
某眼票房页面的字体加密是动态的,每次或者每天加载页面的字体文件都会有所变化,本篇内容针对这种加密方式进行分析
字体加密原理:简单来说就是程序员在设计网站的时候使用了自己设计的字体代码对关键字进行编码,在浏览器加载的时会根据这个字体文件对这些字体进行编码,从而显示出正确的字体。已知的使用了字体加密的一些网站:
58同城,起点,猫眼,大众点评,启信宝,天眼查,实习僧,汽车之家
本篇内容不过多解释字体文件的映射关系,不了解的请自行查找其他资料。
High-Logic FontCreator Pro 12.0.0.2546 提取码tt9x
安装:
pip install difflib
pip install fonttools
# 目标网址 某眼
url = 'aHR0cHM6Ly9waWFvZmFuZy5tYW95YW4uY29tL2Rhc2hib2FyZC1hamF4'
字体加密特征
特征1:通过审查元素或者是查看源文件,某些关键字显示乱码。
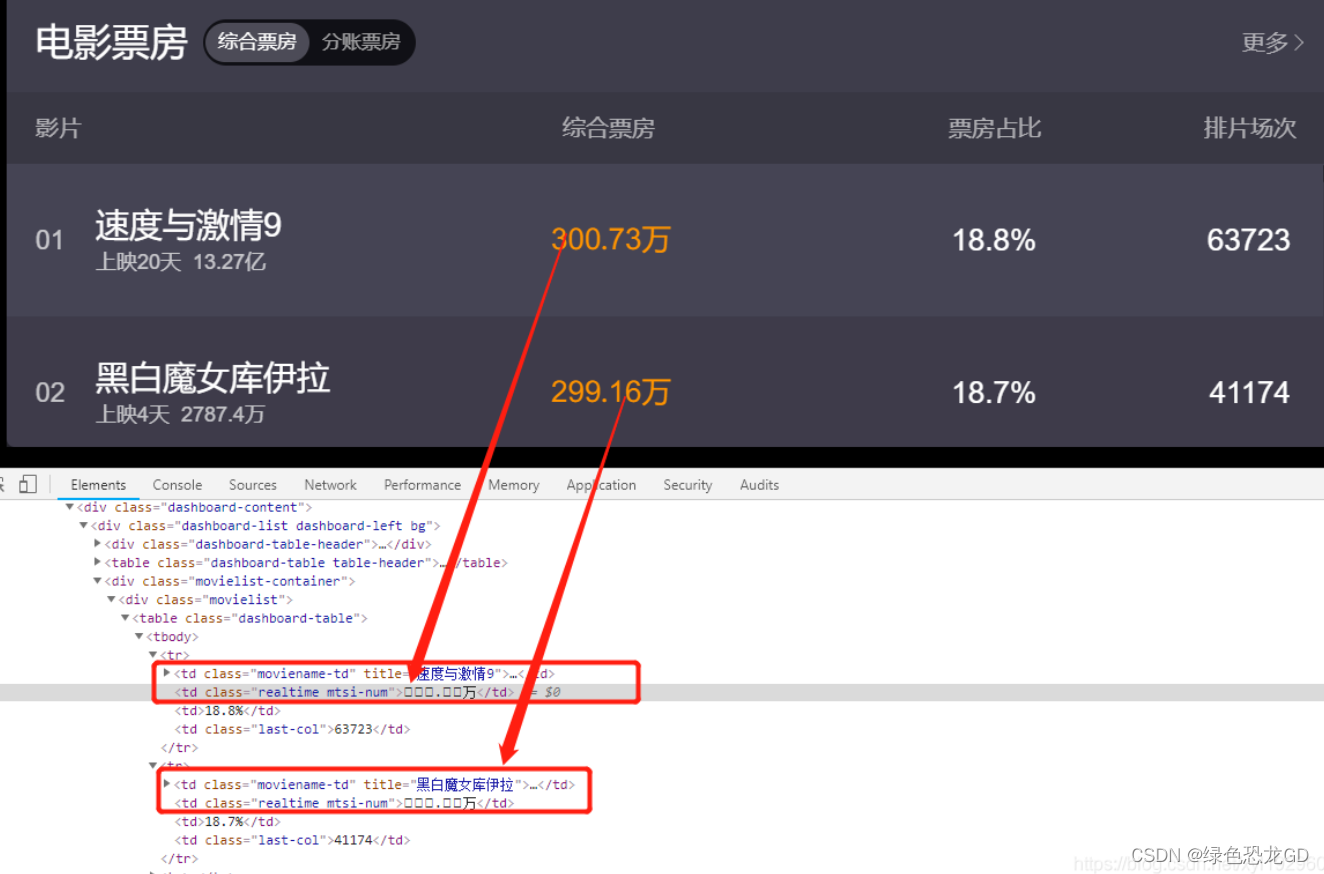
特征2:每次刷新页面都会加载一个xxxx.woff或者其他格式的字体文件。

分析字体文件
下载相关字体文件,并用High-Logic FontCreator 打开,鼠标移动到数字上停留可以看见数字的一些信息

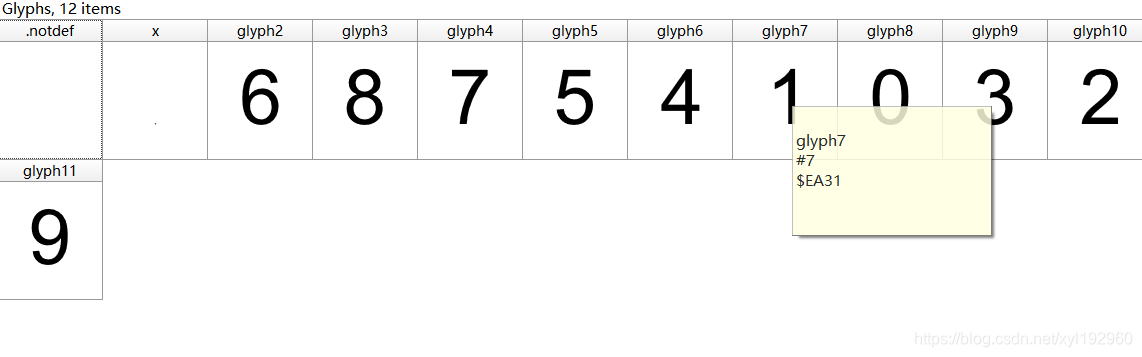
在用python把该字体文件保存为XML格式查看,我们在文本中查找发现比如数字 “1”所对应的“$EA31 ” 在XML格式里面的GlyphOrder组中正好对应的是GlyphID=7,对比其他数字图像与GlyphID是一一对应的
from fontTools.ttLib import TTFont
font=TTFont('4fd0b539.woff')
font.saveXML('maoyan.xml')
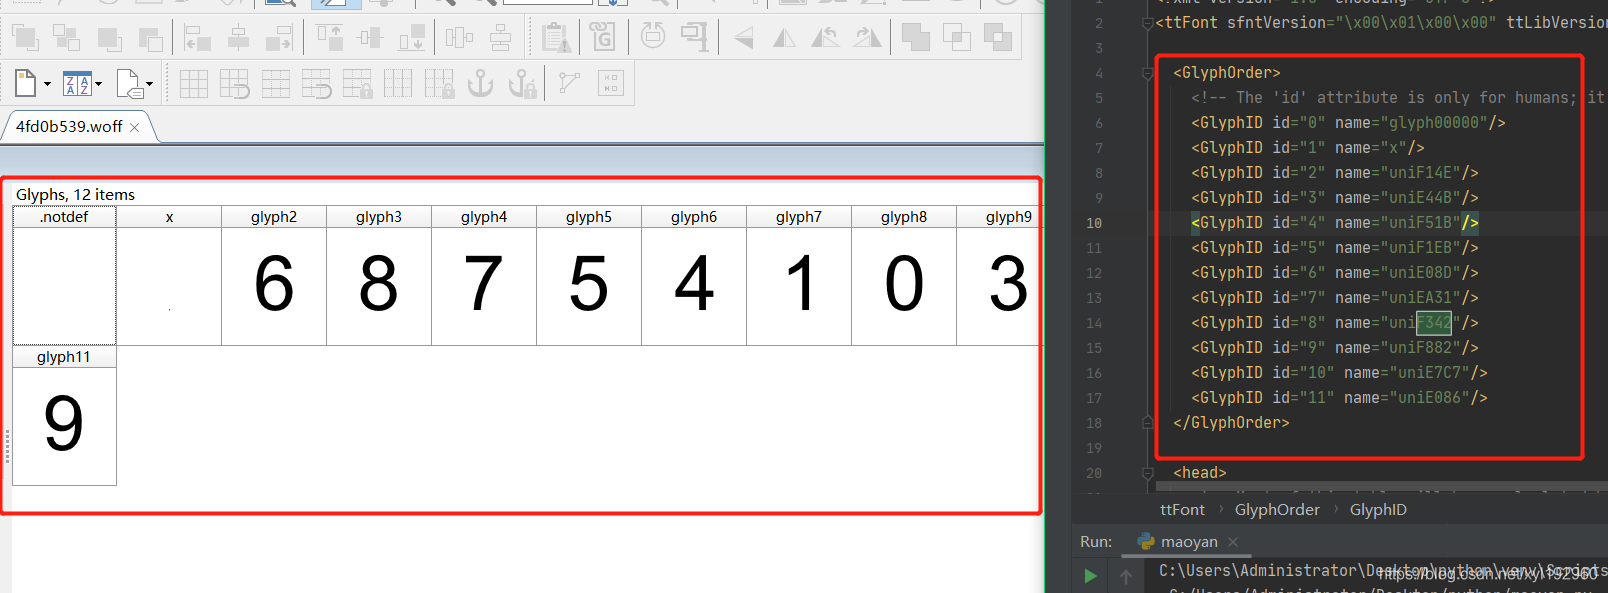
我们在搜索每个数字对应的“TTGlyph”,可以找到每个数字每一笔每一画的坐标,并且可以看到‘on’属性
on属性的解释:on属性是在OpenType字体中定义的一个元素,它表示字符轮廓的起始坐标点。在XML表示的WOFF字体中,TTGlyph元素包含了一条或多条完整的字形轮廓路径(也称为“轮廓曲线”或“Bezier曲线”),on属性用于指定这些曲线的起始坐标点。
其中每一个pt元素表示轮廓路径中的一个点,x和y属性分别表示该点的水平和垂直坐标,而on属性表示该点是否为曲线的起始坐标点。如果on属性值为1,则表示该点是曲线的起始坐标点;如果on属性值为0,则表示该点不是曲线的起始坐标点。
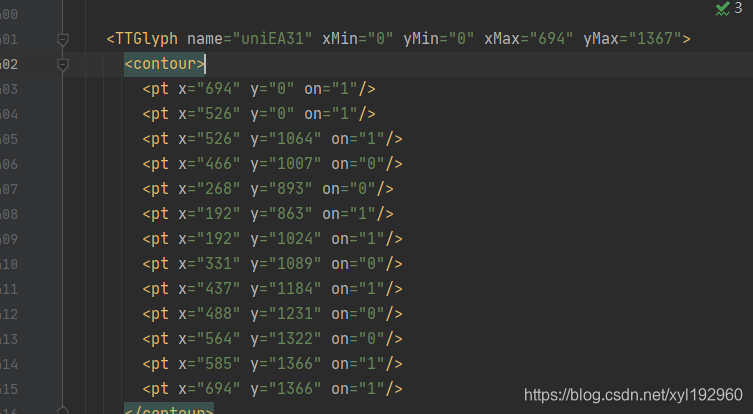
通过对字体Xml文件的分析和坐标的对比,在不依赖机器学习下有两种根据字体文件去匹配数字的方法。
方法一:“on属性”列表匹配法
每个数字坐标下都有一个on属性,可以简单理解为线段起点重点的属性,那么在字体风格相似的前提下,不同大小的字体线段的位置比例,应该是相似的。比如数字1的on属性列表on_list=[‘1’, ‘1’, ‘1’, ‘0’, ‘0’, ‘1’, ‘1’, ‘0’, ‘1’, ‘0’, ‘0’, ‘1’, ‘1’],通过对比on列表的相似度,可以准确的匹配出数字1
方法二:斜率对比。
因为每个字体文件的字体形状都是一样的,所以每条线段的斜率也应该是一样的,通过坐标相减得到每条线段的斜率,在对斜率进行匹配,应该可以匹配出字形。
(猫眼票房每次更新的字体文件的坐标数量都会发生变化,而且不同文件下数字坐标线段所得出的斜率也会发生变化,如果想要准确匹配出数字,可能需要很多的for去遍历,所以不考虑这种方法)
使用“on属性”列表匹配处理加密字体
首先我们需要获得on属性的值就要对字体xml文件进行解析,读取其子节点
from fontTools.ttLib import TTFont
from xml.etree.ElementTree import parse

font = TTFont('4fd0b539.woff')

# 将字体保存为xml格式
font.saveXml('maoyan.xml')
xml = parse('maoyan.xml')

# 获取xml树的根元素
root = xml.getroot()
for i in root:
    if i.tag == 'glyf':  # 找到glyf元素
        dict_0 = {}
        for j in i:  # 遍历在glyf元素下找到每个坐标对应的元素
            if j.get('name') == 'glyph00000' or j.get('name') == 'x':  # 跳过非数字元素
                continue
            list_1 = []
            for k in j:  # 遍历TTGlyph元素下的多个contour元素
                for l in k:
                    list_1.append(l.get('on'))
            dict_0[j.get('name')] = list_1
print(dict_0)
在通过High-Logic FontCreator软件上找到每个字形的代码可以得出on列表所对应的数字:
    0: ['1', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0'],
    1: ['1', '1', '1', '0', '0', '1', '1', '0', '1', '0', '0', '1', '1'],
    2: ['1', '1', '1', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '1', '0', '0', '0', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '0', '1'],
    3: ['1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '1', '0', '0', '1', '0', '1', '0', '1', '0','1', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1', '0','1', '0', '1', '0', '0', '1'],
    4: ['1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1'],
    5: ['1', '0', '0', '1', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '1', '1', '1', '1', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1'],
    6: ['1', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '0', '0', '1','0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1','0', '1', '0', '1', '0'],
    7: ['1', '1', '1', '1', '0', '0', '0', '0', '1', '0', '1', '1', '0', '0', '1', '0', '1', '0', '0', '1'],
    8: ['1', '0', '1', '0', '0', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1', '0','0', '0', '1', '0', '1', '0'],
    9: ['1', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '1', '0', '1', '0', '1', '1', '0', '0', '1', '0', '1','0', '1', '0', '1', '0', '0', '1', '0']
如图
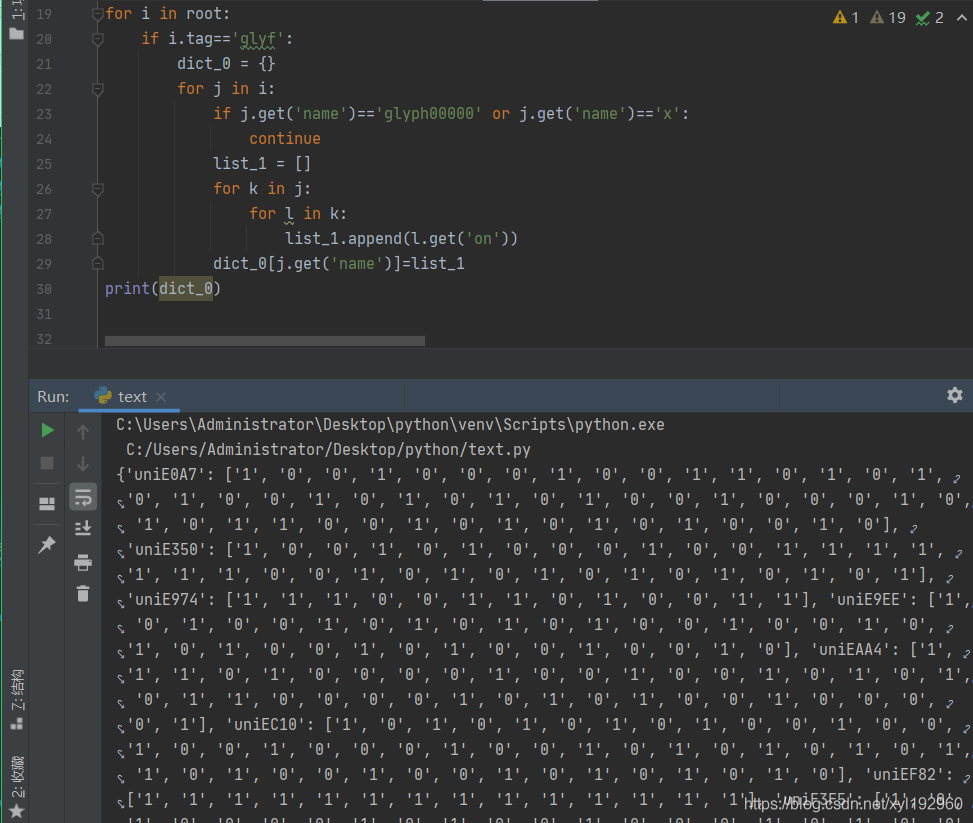
通过多次匹配测试,发现 数字 0,3,6,8,9,在不同的字体文件下可能会发生变化,所以我采样了多组字体文件下0,3,6,8,9的on列表加入到字典进行匹配测试,经过不同时间段获取到的字体文件进行的测试,匹配成功率匹配成功率还是非常高的。
注意:在多次爬取的时候会进入猫眼的滑动验证码反爬导致爬取失败。
最终结果
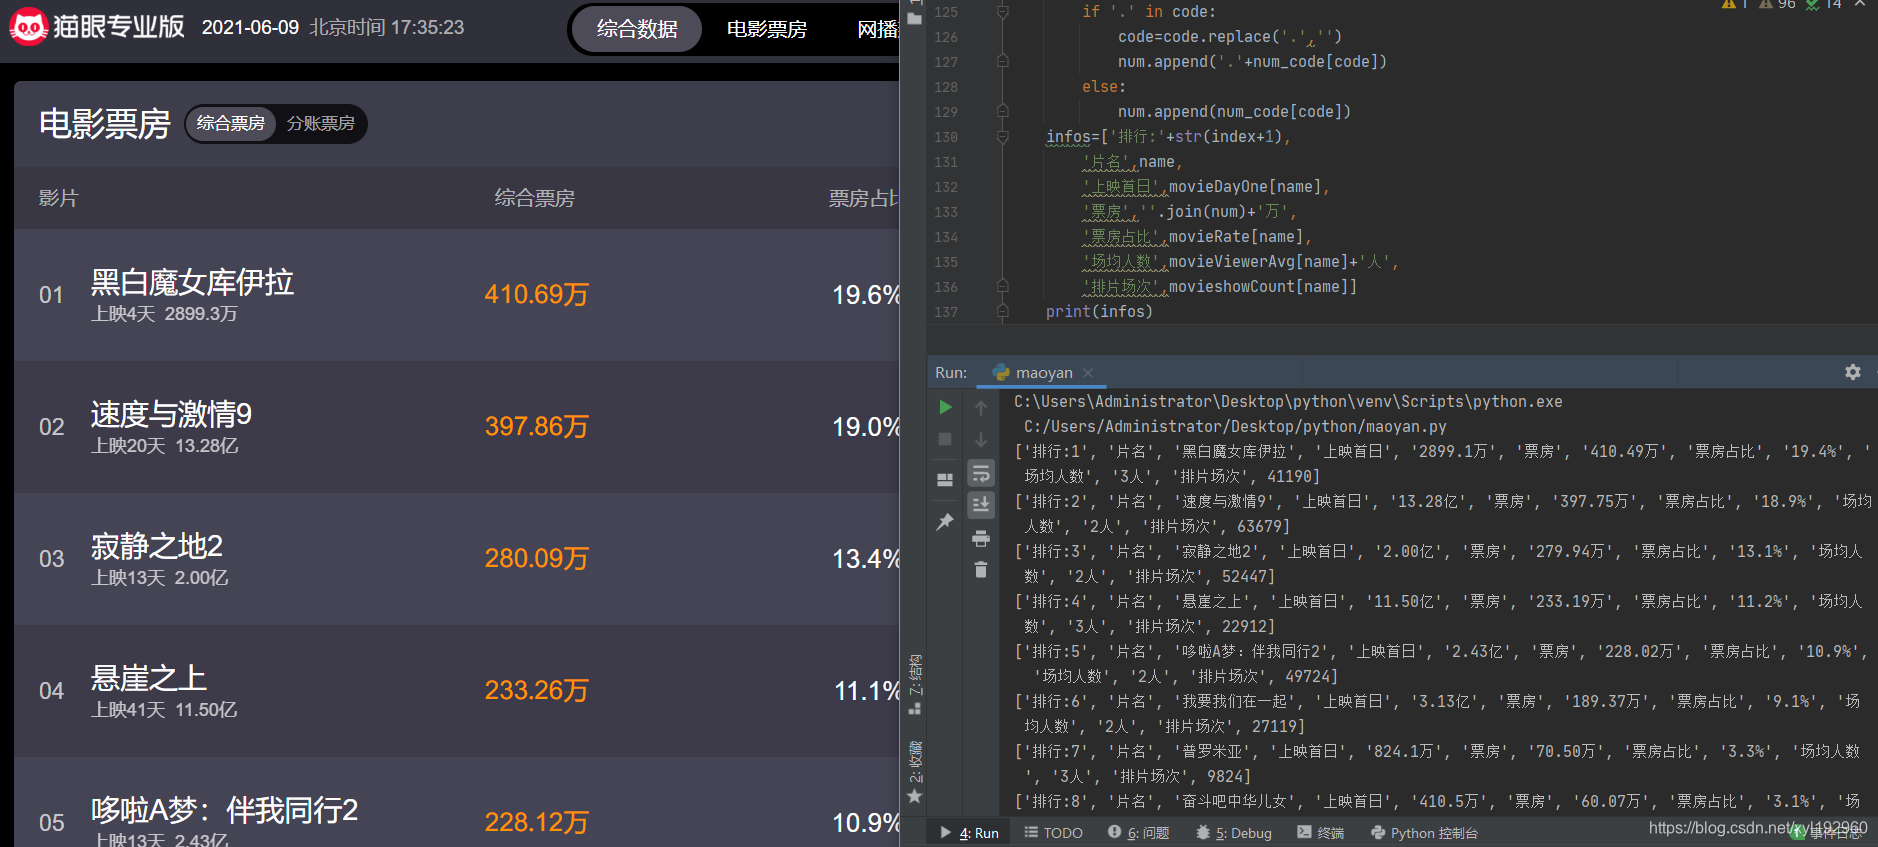
代码实现
import re
import base64
import requests
import urllib.request as down

from fontTools.ttLib import TTFont  # 字体解析库
from xml.etree.ElementTree import parse
from difflib import SequenceMatcher  # 序列匹配器


def similarity(a, b):
    """
    对比a,b序列,返回相似度(0~1.0)
    eg:
    list1=[1,2,3,4,5]
    list2=[1,2,3]
    similarity(list1,list2)
    return 0.75
    :param a: 序列a
    :param b: 序列b
    :return:  相似度(0~1.0)
    """
    return SequenceMatcher(None, a, b).ratio()  # 引用ratio方法,返回序列相似性的度量


def get_movie_infos() -> list:
    """
    请求电影数据,并且保存字体文件
    :return:
    """

    cookies = {
        '_lxsdk_cuid': '18787e3c85cc8-047db80ef7d2d98-412f2c3d-1aeaa0-18787e3c85cc8',
        '_lxsdk_s': '18787e3c85d-efe-fce-1c8%7C%7C4',
        '_lxsdk': '18787e3c85cc8-047db80ef7d2d98-412f2c3d-1aeaa0-18787e3c85cc8',
        '_lx_utm': 'utm_source%3DBaidu%26utm_medium%3Dorganic',
    }
	# 自行去网页上拿
    headers = {
        'User-Agent': '用自己的T T',
        'Accept': 'application/json, text/plain, */*',
        'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
        'Accept-Encoding': 'gzip, deflate, br',
        'X-FOR-WITH': '这里应该是出发验证码的参数,同一个请求太多可能会验证码',
        'Connection': 'keep-alive',
        'Referer': 'https://piaofang.maoyan.com/dashboard',
        'Sec-Fetch-Dest': 'empty',
        'Sec-Fetch-Mode': 'cors',
        'Sec-Fetch-Site': 'same-origin',
    }
	# 自行去网页上拿
    params = (
        ('orderType', '0'),
        ('uuid', '18787e3c85cc8-047db80ef7d2d98-412f2c3d-1aeaa0-18787e3c85cc8'),
        ('timeStamp', '1681613813837'),
        ('User-Agent', '12345上山打老虎'),
        ('index', '838'),
        ('channelId', '40009'),
        ('sVersion', '2'),
        ('signKey', '12345上山打老虎'),
    )

    response = requests.get(url, headers=headers, params=params,
                            cookies=cookies)

    res = response.json()
    font_style = re.findall('\"([\s\S]*?)\"', res['fontStyle'][::-1])
    font_url = 'http:' + font_style[0][::-1]  # 字体url链接
    print(f'字体文件链接:{font_url}')
    down.urlretrieve(font_url, file_name + '.woff')
    data = res['movieList']['data']['list']
    return data


def get_font_map() -> dict:
    """
    获得字体对象,将获得到的字体关系映射存为字典保存

    :return:
    """
    with TTFont(file_name + '.woff') as font:
        font.saveXML(file_name + '.xml')  # 保存为XML格式
        f = font.getBestCmap()  # 获取字体关系映射 code="0xe359"——name="uniE359"

    font_map = {}
    for num, code in f.items():
        if code == 'x': continue
        font_map[code] = hex(num)  # 存入字典
    return font_map


def read_pt_from_xml() -> list:
    """
    获取加载字体的on属性列表字典

    :return: on列表字典
    """
    xml = parse(file_name + '.xml')
    root = xml.getroot()
    for i in root:
        if i.tag == 'glyf':
            nums_on_dict = {}
            for j in i:
                if j.get('name') == 'glyph00000' or j.get('name') == 'x':
                    continue
                on_list = []
                for k in j:
                    for l in k:
                        on_list.append(l.get('on'))
                nums_on_dict[j.get('name')] = on_list
            break
    print(f'on列表:{nums_on_dict}')
    return nums_on_dict


def matching() -> dict:
    """
    匹配on列表

    对数字进行匹配,当匹配相似度>=0.9时,则匹配成功
    :return: 返回加密代码 和数字的字典
    """
    num_code = {}
    for number, on_list in nums_matching.items():
        for _number, _on_list in new_font_maps.items():
            for i in on_list:
                if similarity(i, _on_list) >= 0.9:  # >=0.9 则成功匹配
                    num_code[my_font_maps[_number].replace('0x', '&#x')] = str(number)
                    break
    print(f'解析完成的数字对应关系:{num_code}')
    return num_code


def handle_font():
    """
    处理字体,返回真实数据

    :return:
    """
    movie_num = {}  # 综合票房数字典
    movie_day_one = {}  # 上映首日数量
    movie_rate = {}  # 票房占比
    movie_show_count = {}  # 排片场次
    movie_viewer_avg = {}  # 场均人数
    movie_infos = {}
    # 页面内容
    for data in datas:
        movie_name = data['movieInfo']['movieName']
        movie_num[movie_name] = data['boxSplitUnit']['num']
        movie_day_one[movie_name] = data['sumBoxDesc']
        movie_rate[movie_name] = data['splitBoxRate']
        movie_show_count[movie_name] = data['showCount']
        movie_viewer_avg[movie_name] = data['avgShowView']

    # 替换加密字体,获得正确数字,并输出结果
    # 对加密的字体遍历分组,并去除无用字符
    for name, number_code in movie_num.items():
        movie_num[name] = re.findall('([\S]*?);', number_code)

    # 根据得到的num_code_map对加密字体进行替换,得到正确数值
    for index, (name, number_code_list) in enumerate(movie_num.items()):
        num = []
        # 替换操作
        for code in number_code_list:
            if '.' in code:
                code = code.replace('.', '')
                num.append('.' + num_code_map[code])
            else:
                num.append(num_code_map[code])
        infos = ['排行:' + str(index + 1),
                 '片名', name,
                 '上映首日', movie_day_one[name],
                 '票房', ''.join(num) + '万',
                 '票房占比', movie_rate[name],
                 '场均人数', movie_viewer_avg[name] + '人',
                 '排片场次', movie_show_count[name]]
        print(infos)


if __name__ == '__main__':
    nums_matching = {
        0: [['1', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0',
             '1',
             '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0'],
            ['1', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0',
             '1',
             '0', '0', '0', '0', '0', '0', '0', '1', '0']],
        1: [['1', '1', '1', '0', '0', '1', '1', '0', '1', '0', '0', '1', '1']],
        2: [['1', '1', '1', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0',
             '1',
             '1', '0', '0', '0', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '0', '1'],
            ['1', '1', '1', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1', '0', '0', '0', '0', '0', '1', '1', '0',
             '0',
             '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '1', '1', '0', '1']],
        3: [['1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '1', '0', '1', '1', '0', '0', '1', '0', '1', '0', '1',
             '0',
             '1', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1',
             '0',
             '1', '0', '1', '0', '0', '1'],
            ['1', '0', '0', '1', '0', '0', '0', '0', '1', '0', '1', '1', '1', '0', '0', '1', '0', '0', '0', '0', '1',
             '1',
             '0', '0', '1', '0', '0', '0', '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '0', '1']],
        4: [['1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1', '1']],
        5: [['1', '0', '0', '1', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '1', '1', '1', '1', '1', '0', '0',
             '1',
             '0', '1', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1']],
        6: [['1', '0', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '0', '1', '0', '0', '0',
             '1',
             '0', '0', '1', '0', '1', '0', '1', '0', '1', '0', '1', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0',
             '1',
             '0', '1', '0', '1', '0']],
        7: [['1', '1', '1', '1', '0', '0', '0', '0', '1', '0', '1', '1', '0', '0', '1', '0', '1', '0', '0', '1']],
        8: [['1', '0', '1', '0', '0', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '1', '0', '1', '0', '0',
             '1',
             '0', '0', '1', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '1', '0', '1', '0', '0', '1',
             '0',
             '0', '0', '1', '0', '1', '0'],
            ['1', '0', '1', '0', '0', '0', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '0', '1', '0', '0', '1',
             '0',
             '0', '0', '0', '0', '0', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '0', '0', '0', '0', '0']],
        9: [['1', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1',
             '0',
             '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '1', '0', '1', '0', '1', '1', '0', '0', '1', '0',
             '1',
             '0', '1', '0', '1', '0', '0', '1', '0'],
            ['1', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1',
             '0',
             '1', '0', '1', '0', '1', '0', '0', '1', '0', '0', '0', '1', '0', '1', '0', '1', '1', '0', '0', '1', '0',
             '1',
             '0', '1', '0', '1', '0', '0', '1', '0'],
            ['1', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '1', '0', '1', '0', '1', '0', '0', '1',
             '0',
             '0', '1', '0', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '0', '1', '0', '0', '1', '0',
             '0',
             '0', '0'],
            ['1', '0', '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '0', '1', '0', '0', '0', '0', '1', '0',
             '0',
             '0', '1', '0', '0', '0', '1', '0', '0', '1', '1', '0', '0', '0', '0', '1', '0', '0', '0', '0']]
    }

    url = 'aHR0cHM6Ly9waWFvZmFuZy5tYW95YW4uY29tL2Rhc2hib2FyZC1hamF4'
    url = base64.b64decode(url).decode('utf-8')
    # 爬取内容
    file_name = 'maoyan'
    # 请求电影数据,并且保存字体文件
    datas = get_movie_infos()
    # 存储到的字体关系
    my_font_maps = get_font_map()

    # 当前页面字体文件的map on列表
    new_font_maps = read_pt_from_xml()
    # 加密代码 和数字的字典
    num_code_map = matching()
    # 处理字体,解析成正确数据
    handle_font()
注意:在频繁请求页面时候会出现滑动验证哦。
测试日记
| 日期 | 是否正常 |
|---|---|
| 2021年6月9日 | 添加新的的on列表 |
| 2021年7月6日 | 测试正常 |
| 2021年9月16日 | 测试正常 |
| 2023年4月16日 | 优化代码,测试正常 |

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 17
 0
- 0


 已为社区贡献2条内容

所有评论(0)