rime的数据结构笔记(c语言)--malloc函数【堆区,栈和内存】
malloc函数的作用
malloc的全称是memory allocation,中文叫动态内存分配。
用于申请一块连续的指定大小的内存块区域以void*类型返回分配的内存区域地址,当无法知道内存具体位置的时候,想要绑定真正的内存空间,就需要用到动态的分配内存,且分配的大小就是程序要求的大小。
malloc() 在堆区分配一块指定大小的内存空间,用来存放数据。这块内存空间在函数执行完成后不会被初始化,它们的值是未知的。如果希望在分配内存的同时进行初始化,请使用 calloc() 函数。
malloc下级分类
stdlib.h
例子
char *ptr = (char *)malloc(10); // 分配10个字节的内存空间,用来存放字符
原型
void* malloc (size_t size);
堆区
栈区变量分析
所有程序/软件的运行,都是由操作系统统一调配的,操作系统是程序的运行环境
运行中的多个程序之间,内存是不交叉的
程序结束后,操作系统还要释放其使用的资源,来给其他程序使用
申请的空间种分为五个区域栈区(堆栈区),堆区,全局区,字符常量区,代码区,我们之前讲的这些定义变量、数组都是在内存的栈区存储。
为什么分这么多区域?在实际生活中,这和公司差不多,部门分的细致,工作分发的就有针对性,效率就会高。
由谁申请?
栈区的特点:内存由系统申请,在变量生命周期结束时由系统释放,也就是说,在程序运行的时候,系统要多个任务,就是检测变量是否该释放了,简单来说,就是cpu要抽时间去执行这部分功能。所以,如果这种变量比较多,不加节制的定义的话,那CPU的额外的工作量就会加大,综合下来,程序的运行效率就会低下。
堆区的特点:由我们程序员随时申请,由我们自己随时释放。
实际应用中,系统会限制我们可使用的栈区空间大小(默认1M)stack overflow即为爆栈。
这个大小可以从编译器的属性中修改,但尽量不修改,不够用了又不得不用再去修改。
如果我们申请的空间,不由操作系统管理,而是我们自己申请与释放,那么就不会占用系统的额外资源了,这样我们就可以申请任意大小的空间了。
引用:Lanciberrr的文章
详细文章,内有malloc函数详细用法和注意
关于内存
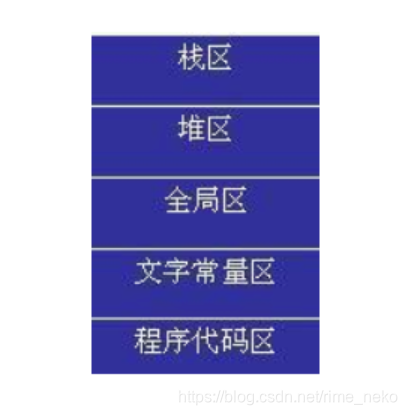
1、栈区(stack)
由编译器自动分配释放 ,存放函数的参数值,局部变量的值等,内存的分配是连续的,类似于平时我们所说的栈,如果还不清楚,那么就把它想成数组,它的内存分配是连续分配的,即,所分配的内存是在一块连续的内存区域内.当我们声明变量时,那么编译器会自动接着当前栈区的结尾来分配内存.
2、堆区(heap)
一般由程序员分配释放, 若程序员不释放,程序结束时可能由操作系统回收.类似于链表,在内存中的分布不是连续的,它们是不同区域的内存块通过指针链接起来的.一旦某一节点从链中断开,我们要人为的把所断开的节点从内存中释放.
3、全局区(静态区)(static)
全局变量和静态变量的存储是放在一块的,初始化的全局变量和静态变量在一块区域, 未初始化的全局变量和未初始化的静态变量在相邻的另一块区域。 程序结束后由系统释放
4、文字常量区
常量字符串就是放在这里的。 程序结束后由系统释放
5、程序代码区
存放函数体的二进制代码。
二.堆和栈的区别
1.申请方式不同栈:有系统自动分配。例如:在函数中定义一个局部变量 int a = 0; 系统会在栈上自动开辟相应大小
注意:系统首先会去查看栈上是否有足够的区域去开辟该空间,如果有就直接开辟,如果没有则栈溢出
堆:由程序员自己去申请开辟,并且指明大小。(利用new/malloc)
2.申请大小的限制
栈:在Windows下,栈是向低地址扩展的数据结构,是一块连续的内存的区域。这句话的意思是栈顶的地址和栈的最大容量是系统预先规定好的,在WINDOWS下,栈的大小是2M(也有的说是1M,总之是一个编译时就确定的常数),如果申请的空间超过栈的剩余空间时,将提示overflow。因此,能从栈获得的空间较小。
堆:堆是向高地址扩展的数据结构,是不连续的内存区域。这是由于系统是用链表来存储的空闲内存地址的,自然是不连续的,而链表的遍历方向是由低地址向高地址。堆的大小受限于计算机系统中有效的虚拟内存。由此可见,堆获得的空间比较灵活,也比较大。
3.申请效率的比较:
栈:由系统自动分配,速度较快。但程序员是无法控制的。
堆:是由new/malloc分配的内存,一般速度比较慢,而且容易产生内存碎片,不过用起来最方便.(new/malloc后一定要显示的调用free/delete去释放内存)
另外,在WINDOWS下,最好的方式是用VirtualAlloc分配内存,他不是在堆,也不是在栈是直接在进程的地址空间中保留一快内存,虽然用起来最不方便。但是速度快,也最灵活。
4.堆和栈中的存储内容
栈: 在函数调用时,第一个进栈的是主函数中后的下一条指令(函数调用语句的下一条可执行语句)的地址,然后是函数的各个参数,在大多数的C编译器中,参数是由右往左入栈的,然后是函数中的局部变量。注意静态变量是不入栈的。
当本次函数调用结束后,局部变量先出栈,然后是参数,最后栈顶指针指向最开始存的地址,也就是主函数中的下一条指令,程序由该点继续运行。
堆:一般是在堆的头部用一个字节存放堆的大小。堆中的具体内容有程序员安排。
5.底层不同
栈:是连续的空间
堆:不是连续的空间
请注意:在栈上所申请的内存空间,当我们出了变量所在的作用域后,系统会自动我们回收这些空间,而在堆上申请的空间,当出了相应的作用域以后,我们需要显式 的调用delete来释放所申请的内存空间,如果我们不及时得对这些空间进行释放,那么内存中的内存碎片就越来越多,从而我们的实际内存空间也就会变的越 来越少,即,孤立的内存块越来越多.在这里,我们知道,堆中的内存区域不是连续的,还是将有效的内存区域经过链表指针连接起来的,如果我们申请到了某一块 内存,那么这一块内存区将会从连续的(通过链表连接起来的)内存块上断开,如果我们在使用完后,不及时的对它进行释放,那么它就会孤立的开来,由于没有任 何指针指向它,所以这个区域将成为内存碎片,所以在使用完动态分配的内存(通过NEW申请)后,一定要显式的对它进行DELETE删除.
引用:忽晴忽雨的博文
栈
栈(stack)又名堆栈,它是一种运算受限的线性表。限定仅在表尾进行插入和删除操作的线性表。这一端被称为栈顶,相对地,把另一端称为栈底。向一个栈插入新元素又称作进栈、入栈或压栈,它是把新元素放到栈顶元素的上面,使之成为新的栈顶元素;从一个栈删除元素又称作出栈或退栈,它是把栈顶元素删除掉,使其相邻的元素成为新的栈顶元素。
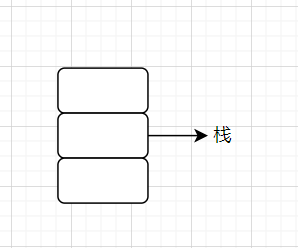
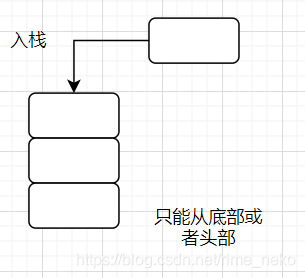
栈是一种 “特殊” 的线性存储结构,因此栈的具体实现有以下两种方式:
1.顺序栈:采用顺序存储结构可以模拟栈存储数据的特点,从而实现栈存储结构;
2.链栈:采用链式存储结构实现栈结构;
进栈和出栈
1.基于栈结构的特点,在实际应用中,通常只会对栈执行以下两种操作:
2.向栈中添加元素,此过程被称为"进栈"(入栈或压栈);
3.从栈中提取出指定元素,此过程被称为"出栈"(或弹栈);
慢慢收集补充吧。。。。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 31
 0
- 0


 已为社区贡献1条内容

所有评论(0)