快到没朋友的YOLO——原理篇
一、目标检测
常见的cv任务:
| 分类(Clarification) | 定位(Detection) | 分割(Segmentation) | 超分任务(Super Resolution, SR) | 关键点识别(Key Point) | 图像生成 | 度量学习 |
|---|---|---|---|---|---|---|
| 解决“what” ,很好理解,就是对输入图片进行分类(具体可选类别需要事先确定)。 | 解决“where” ,检测出图片中的物体位置,一般需要进行画框。 | 解决"where&what”,在检测任务的基础上把框精细化,具体到每个像素的分类。在上图的检测任务中,矩形框还是比较粗糙的,并不知道每个像素具体属于哪个物体。 | 简单地说就是增加图片的分辨率。 | 找出图片中的关键点,最常见的就是人体关键点检测. | 根据输入(可以是图片或者其他数据),生成目标图像。 | 断输入之间的距离到底多少,例如两个图片之间的距离,这时候欧氏距离肯定是不合适的,需要神经网络去学习如何度量。 |
目标检测必备术语
GT(Ground Truth) :人为的标注的物体位置
BB(Bounding Box):给出物体在图片中的定位区域,5个组成(x,y,w,h,confidence scores)
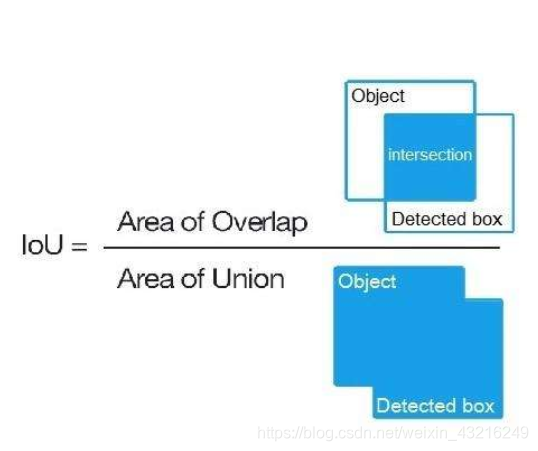
IOU(交并比):两个box的重叠程度,交并比越大,重叠程度越高
AP(average precision):当交并比大于某一阈值(通常是0.5),则认为正确。对每个类别,画出它的查准率-查全率曲线,平均准确率是曲线下的面积
mAP:对所有类别的AP求平均值,即为平均准确率
RP(Regional Proposal):候选区域,指提取出所有可能包含识别目标的那些候选区域,相比于传统的滑动窗口而言,RP数量会更少,质量更高
NMS(非极大值抑制):图像处理中用来消除多余(交叉或重复)找到最佳的物体检测位置的一个算法
Anchor Box(候选框):从原始或卷积后的图片中提取出来,然后用来判断是否存在要识别的目标的小的图片块
Selective Search(选择性搜索):利用颜色,纹理,尺寸,空间交叠来生成候选区域的算法,更优于传统的滑动窗口算法
图形化说明一下IOU(交并比):
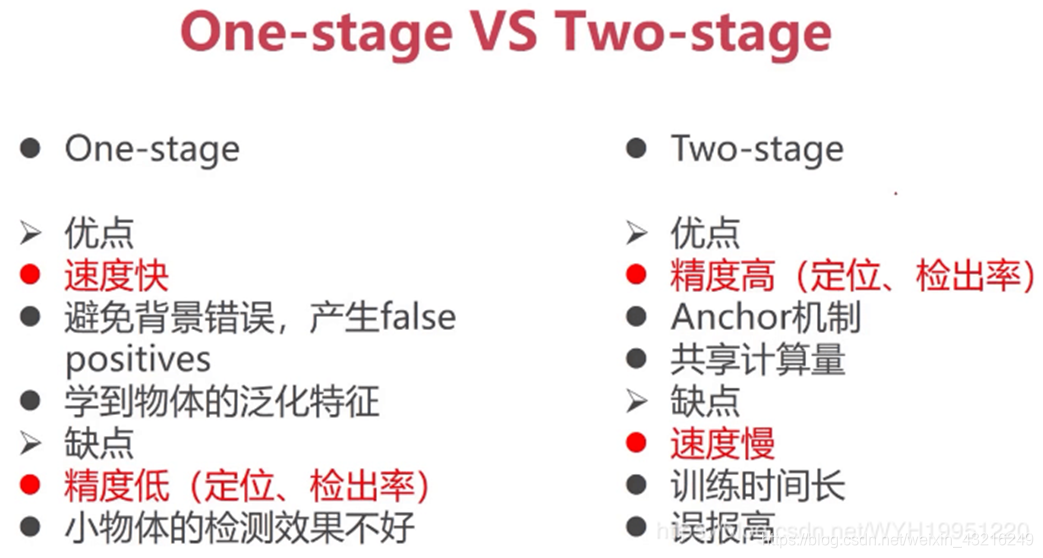
目标检测的两大分支
| two-stage | one-stage | |
|---|---|---|
| 代表 | faster-RCNN | yolo系列 |
| 特点 | 速度慢,准确高 | 速度快,准确低,直接回归,无RPN过程 |
| 简介 | 先进行RP的生成,再通过卷积神经网络进行分类 | 直接提取特征,预测物体类别和位置 |
| 代表 | faster-RCNN | yolo系列 |
| 步骤 | 特征提取->生成RP->分类/回归 | 特征提取->分类/回归 |
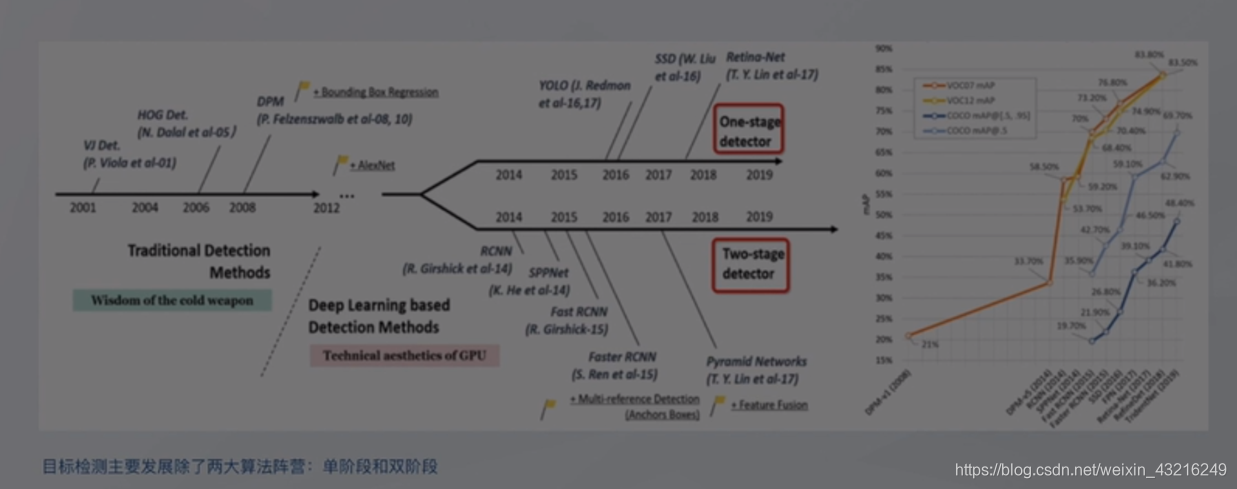
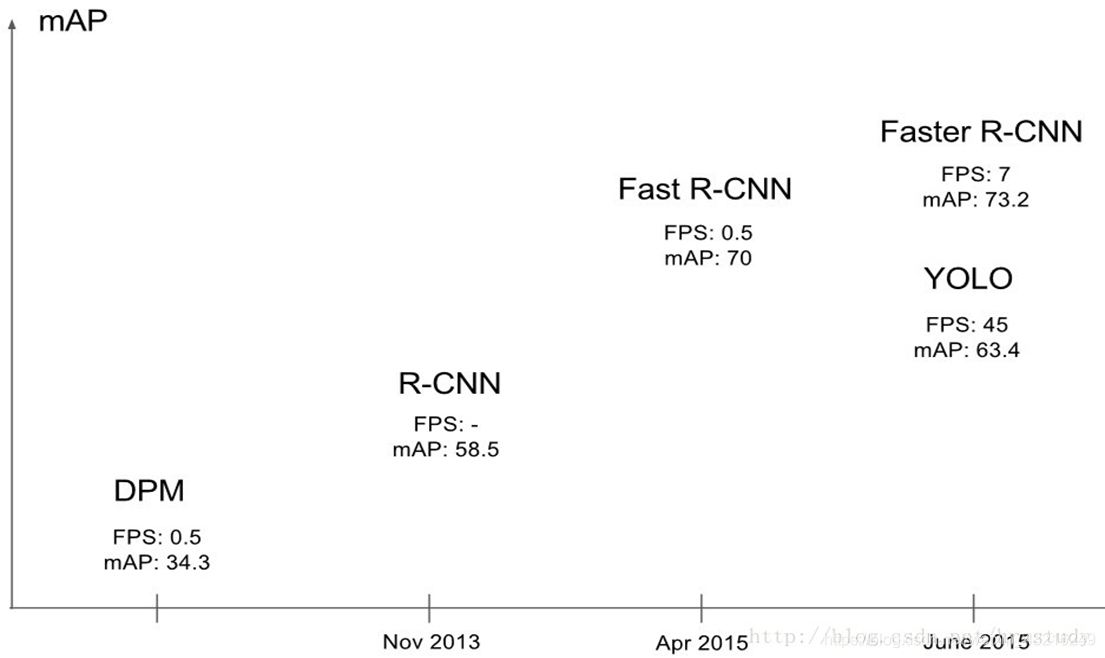
目标检测的历史过程(没有找到清晰的图,网上找的一张)
传统算法步骤
- 确定滑动窗口
- 利用滑动窗口窗口提取特征
- 对候选去进行特征提取
- 利用分类器(事先训练好)进行分类,判断候选区是否包含有效目标
- 对所有包含有效目标的候选区域进行合并
- 作图,绘制出检测目标的轮廓图
问题:
如果窗口过大,则会丢失数据;如果窗口过小,则会数据过多,冗长
二、了解YOLO
附上YOLO的经典图片,以及连接

YOLO官网链接
YOLO简介
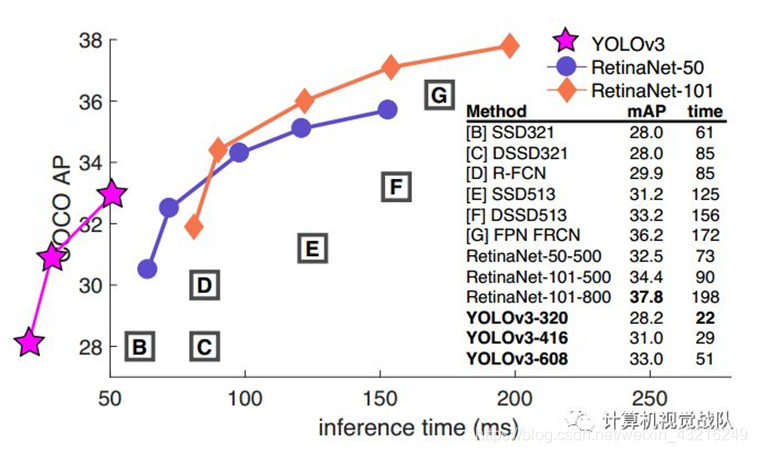
YOLO检测物体的速度很快。标准版本的YOLO在Titan X的GPU上能达到45FPS。网络较小的版本Fast YOLO在保持mAP是之前的其他实时物体检测其的两倍的同时,检测速度可以达到155FPS。
YOLO原理
将物体检测任务当作回归问题(regression problem)来处理,直接通过整张图片的所有像素得到bounding box的坐标、box中包含物体的置信度和class probabilities。通过YOLO,每张图象只需要看一眼就能得出图像中都有哪些物体和这些物体的位置。
检测流程
- 将图像resize后作为神经网络的输入
- 运行神经网络,得到一些bounding box、box中包含物体的置信度和class probabilities
- 进行非极大值抑制,筛选Boxes
YOLO的优缺点(实际上就是单阶段的优点)
| 优点 | 缺点 |
|---|---|
| 1. 检测物体非常快 | 1.精确度低于其他检测系统 |
| 2.可以很好的避免背景错误,产生False positives | 容易产生物体的定位错误 |
| 3.可以学到物体的泛化特征 | 对小物体的检测效果不好(尤其是密集的小物体,应为一个栅栏只能预测2个物体) |
算法流程
必须提前说明,这里的三个参数:
- S:栅格数
- B:Bounding boxes个数
- C:检测类别数
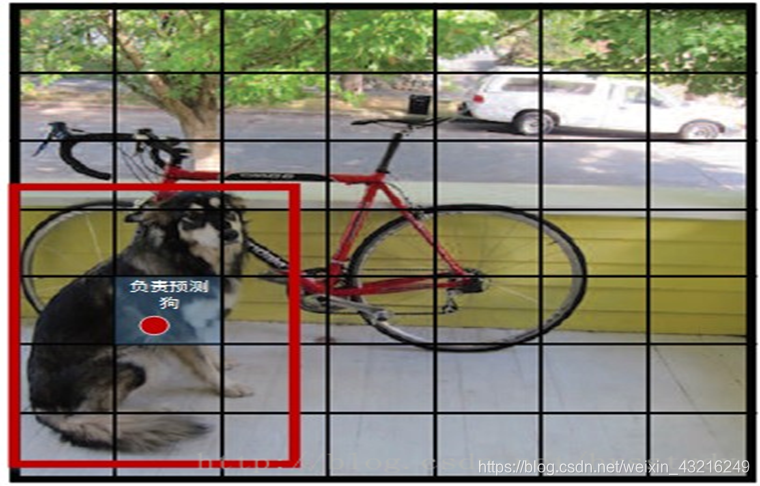
YOLO将输入的图像分成S*S的栅格,每个栅格负责检测中心落在该栅格中的物体
每一个栅栏预测B个Bounding boxes,以及这些Bounding Boxes的confidence scores.
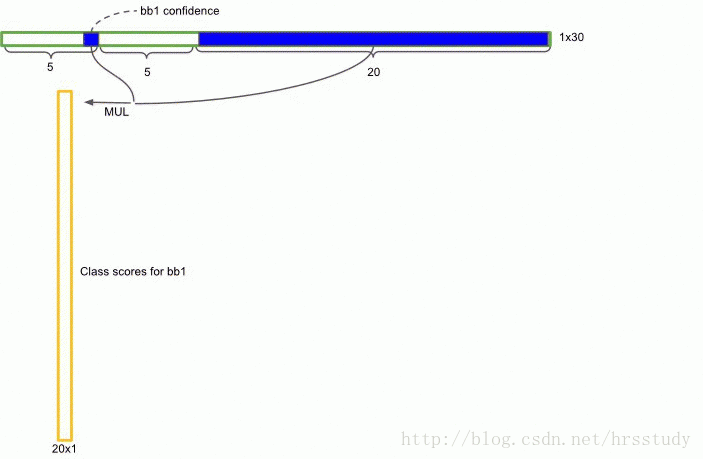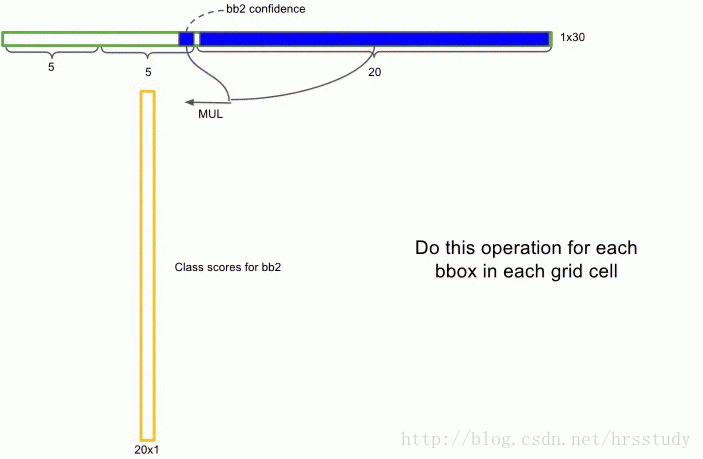
confidence scores:反映了模型对于这个栅格的预测:该栅格是否含有物体,以及这个box的坐标预测的准确度。共包含5个参数:左上角的坐标信息(x,y),宽高(w,h)以及cs
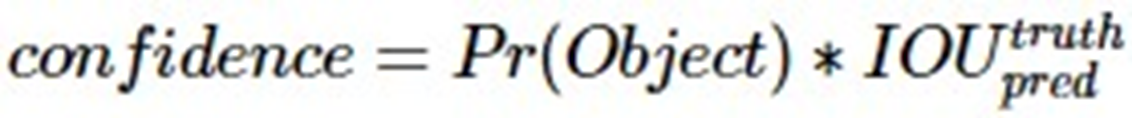
如果栅格不存在一个object,则cs=0
除此之外,每个栅格还要预测C个conditional class probability(条件类别概率):Pr(class|obect),在包含一个object的前提下,属于某个类别的概率。
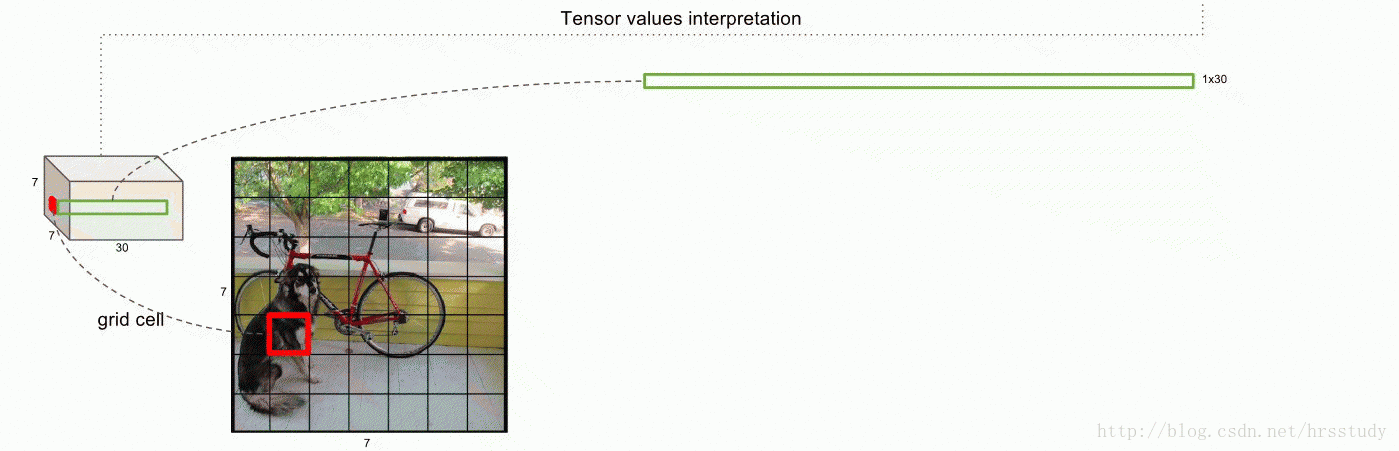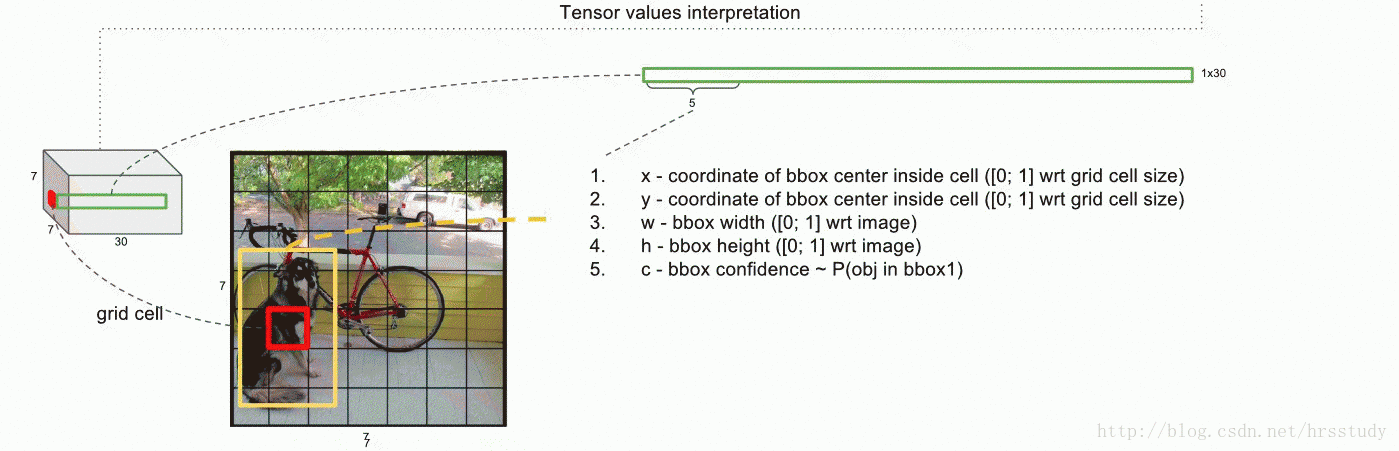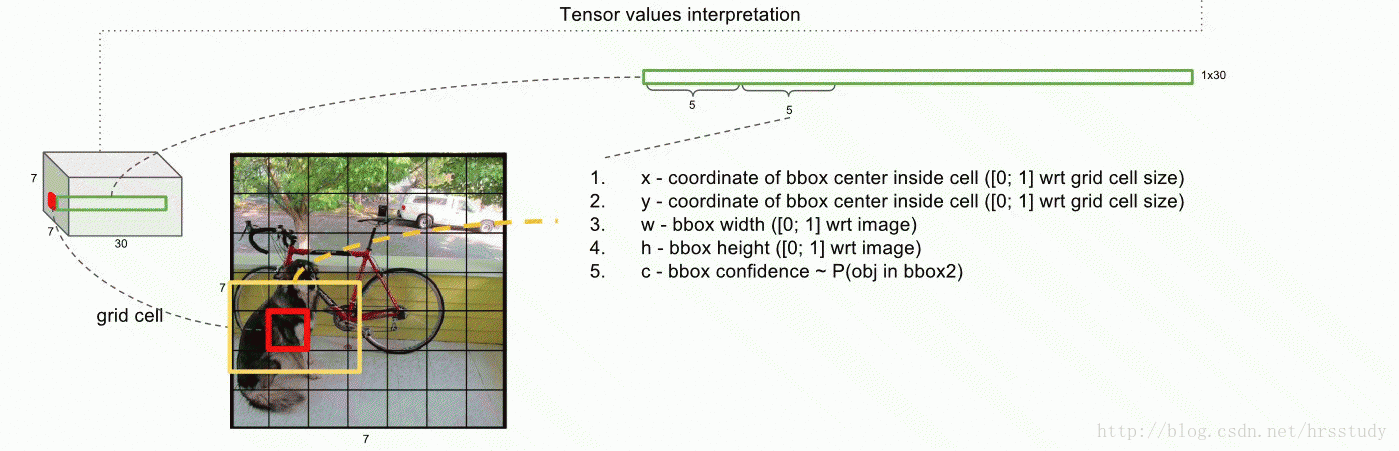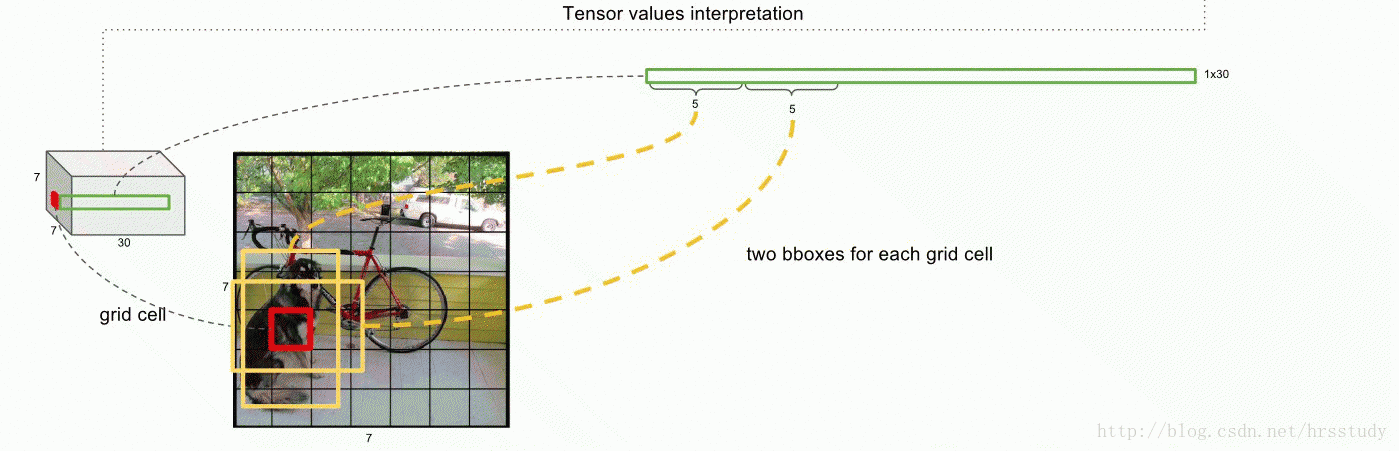
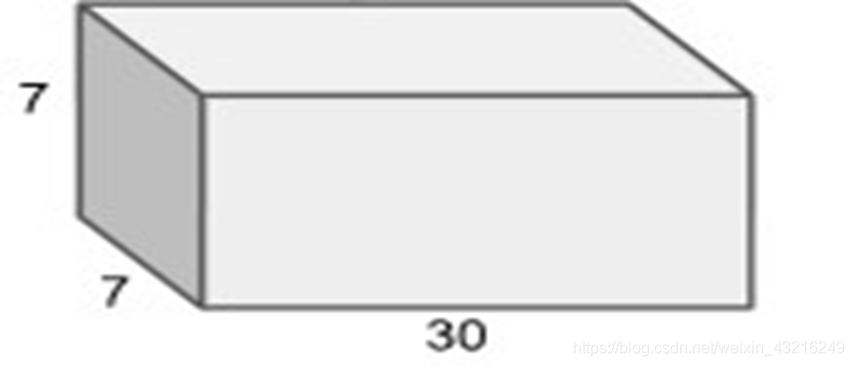
每个彩色图片可以看成是一个三维的矩阵,类似于一个长方体(有兴趣的可以查看我的另一个关于opencv学习的博客(还未发布)),因此在上图中,将每一个栅格抽象化为大长方体中的一个小长方体,具体如下:
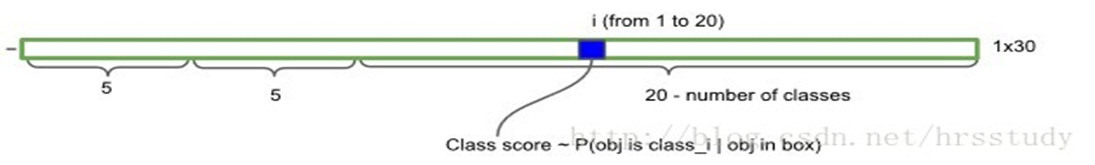
这张图的两个5代表两个bounding box预测出的信息,而最后的20代表c(类别)的个数。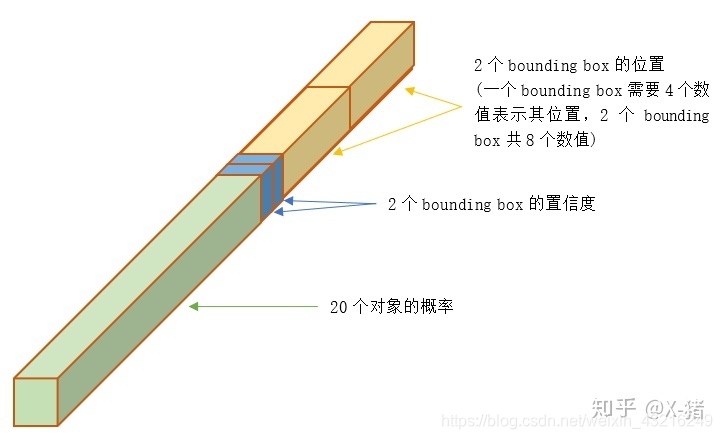
注意:
Conditional class proilitu信息是针对每个网络的,confidence信息是针对每个bounding box的。在测试阶段,将每个栅栏的conditional class proability于bb的confidencce相乘:
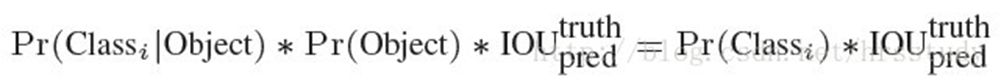
这样就可以得到每个bb的具体类别的confidence score.
这乘积既包括了bb中预测的class的proability信息,也反映了bounding box是否包含object和bounding box坐标的准确度。
例:
假如使用VOC数据集时:
- S = 7,
- B = 2,
- C = 20
- 则最后的prediction是7730 (SS(B*5+C))
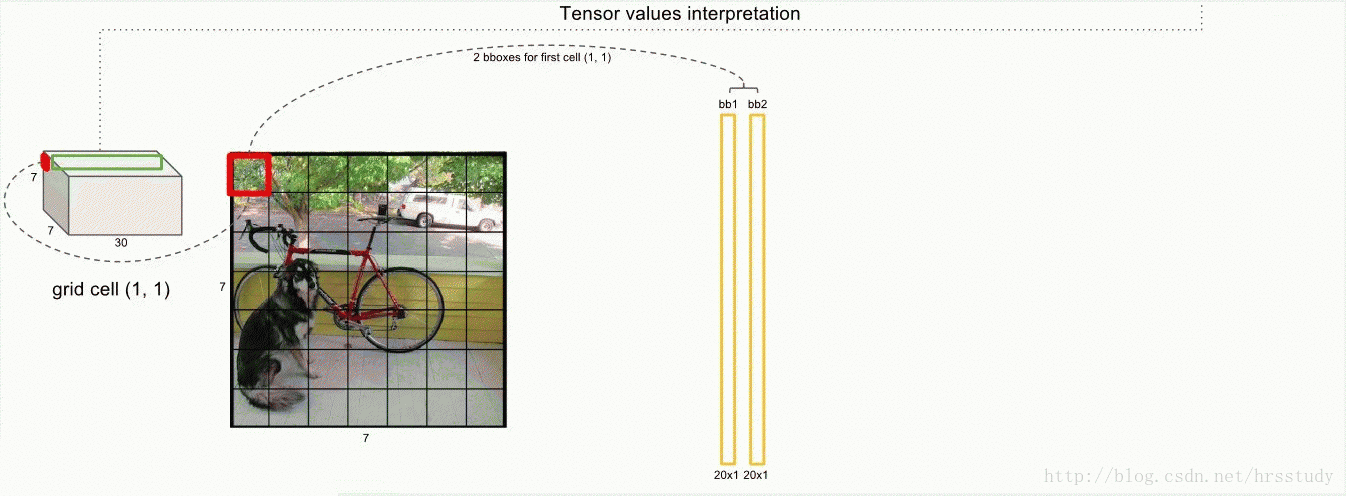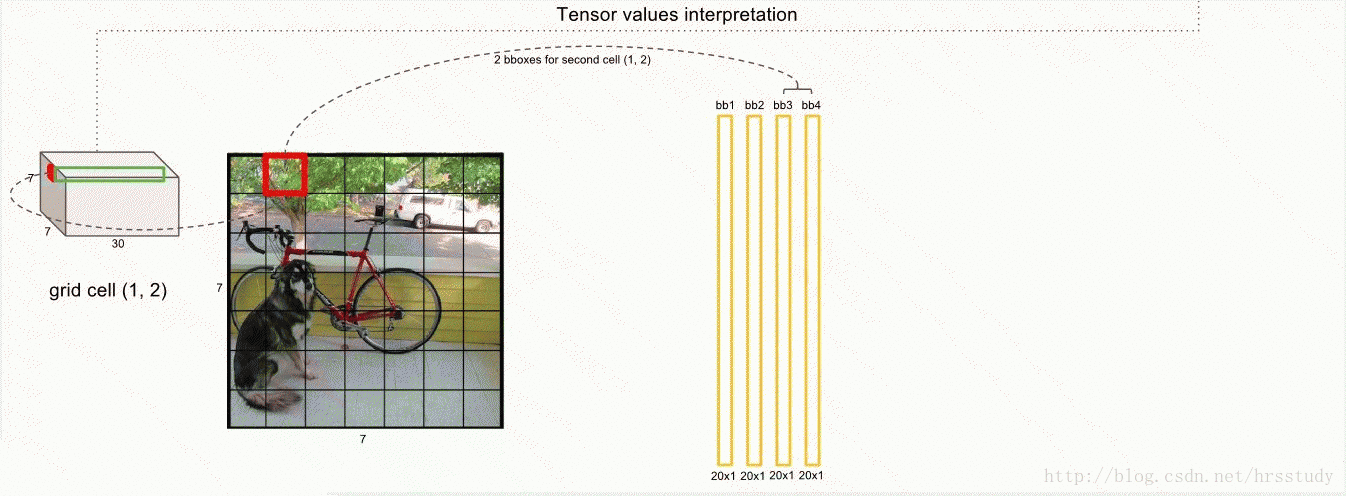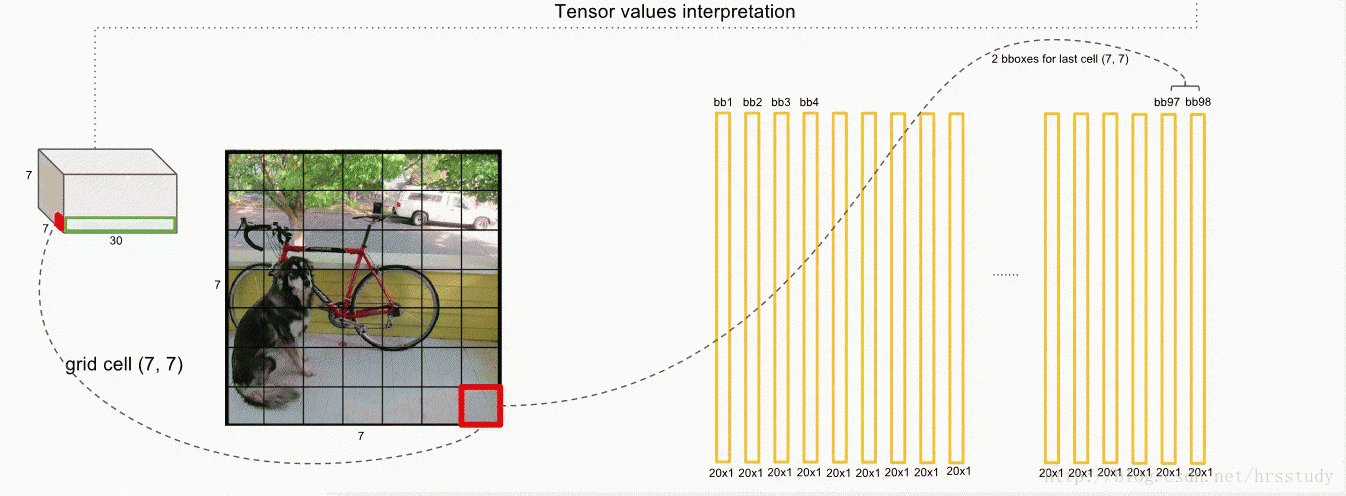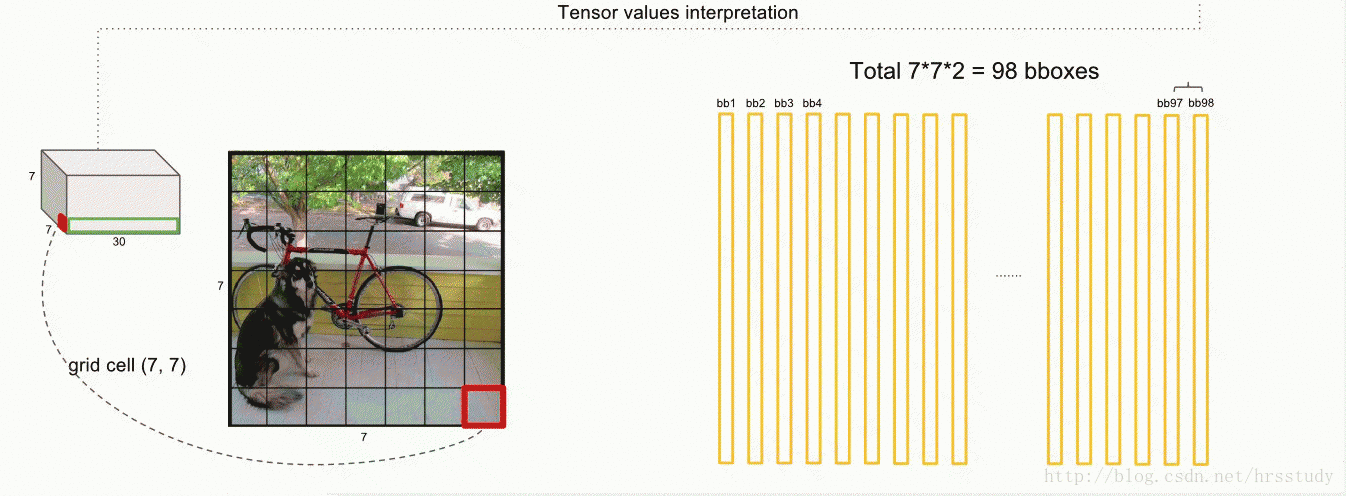
注意每个bboxes的维度以及其数量。
每个bbox检测7×7(49)个栅栏,共2个,因此最后得出98个向量,同时每个向量维度为20*1。
在原图中的bboxes如下: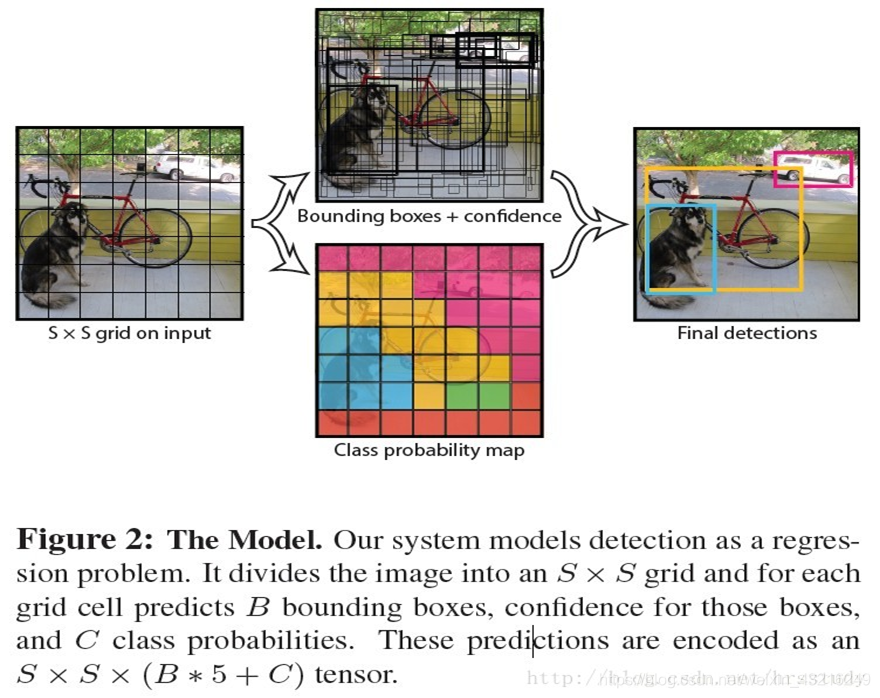
Network Design
YOLO 检测网络包括24个卷积层和2个全连接层
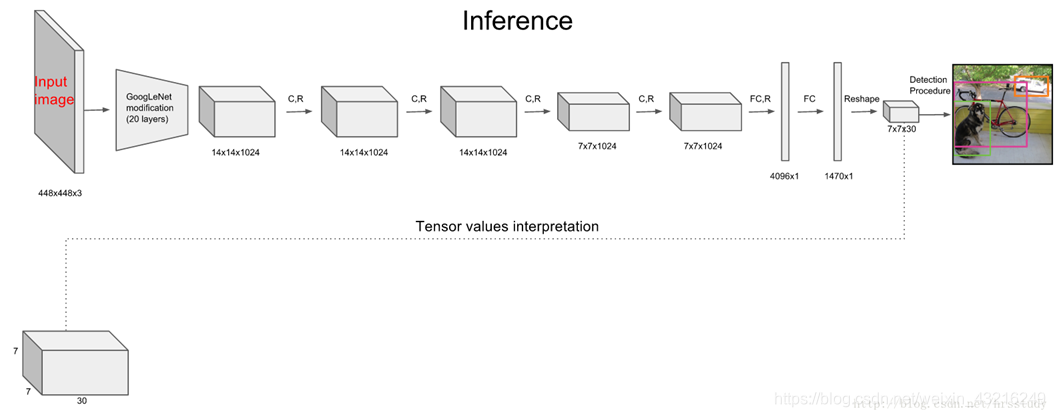
卷积层用来提取图像特征,全连接层用来预测图像位置和类别概率(直接pretrain其他主干网络,最后修改FC部分)
损失函数
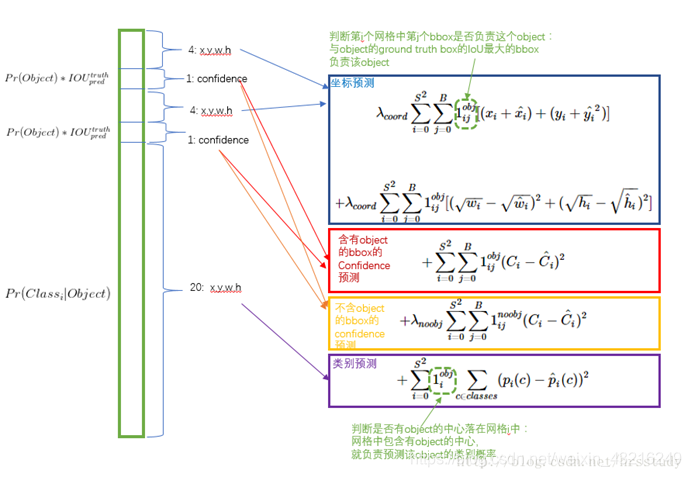
一个向量中,前4维代表着相关的bbox框,第5维代表是否存在物体的概率。一下以此类推。后20维每维代表着一个类别,同时存放着其概率。因此,x,y,w,h进行目标检测的第一个阶段,物体的定位,之后,在进行下一步的物体识别。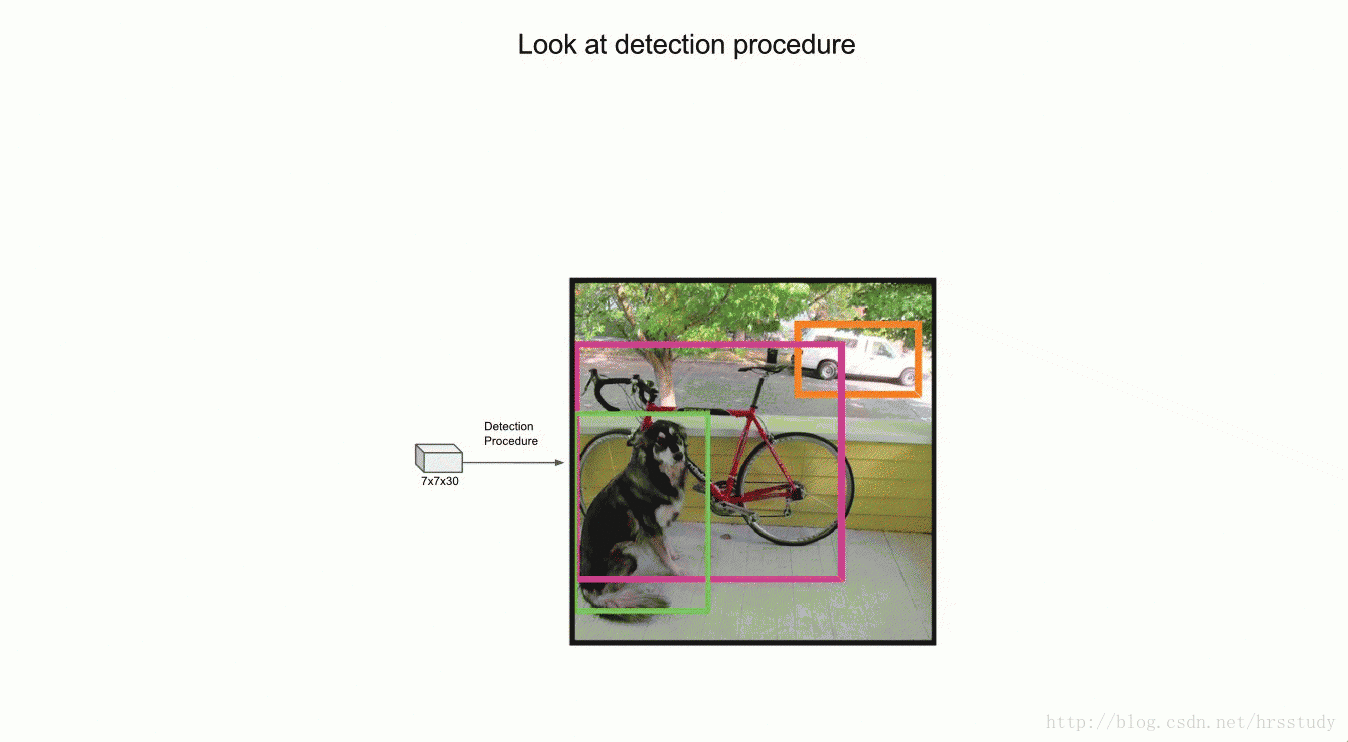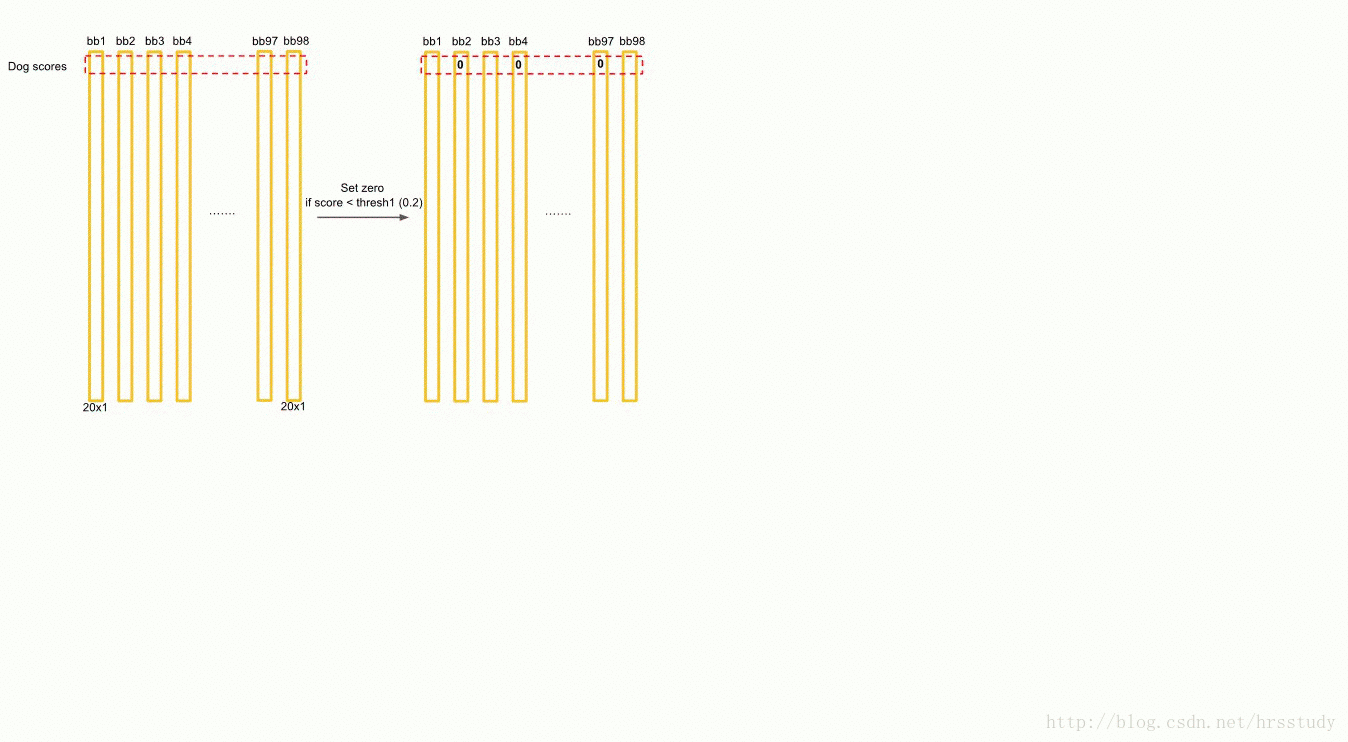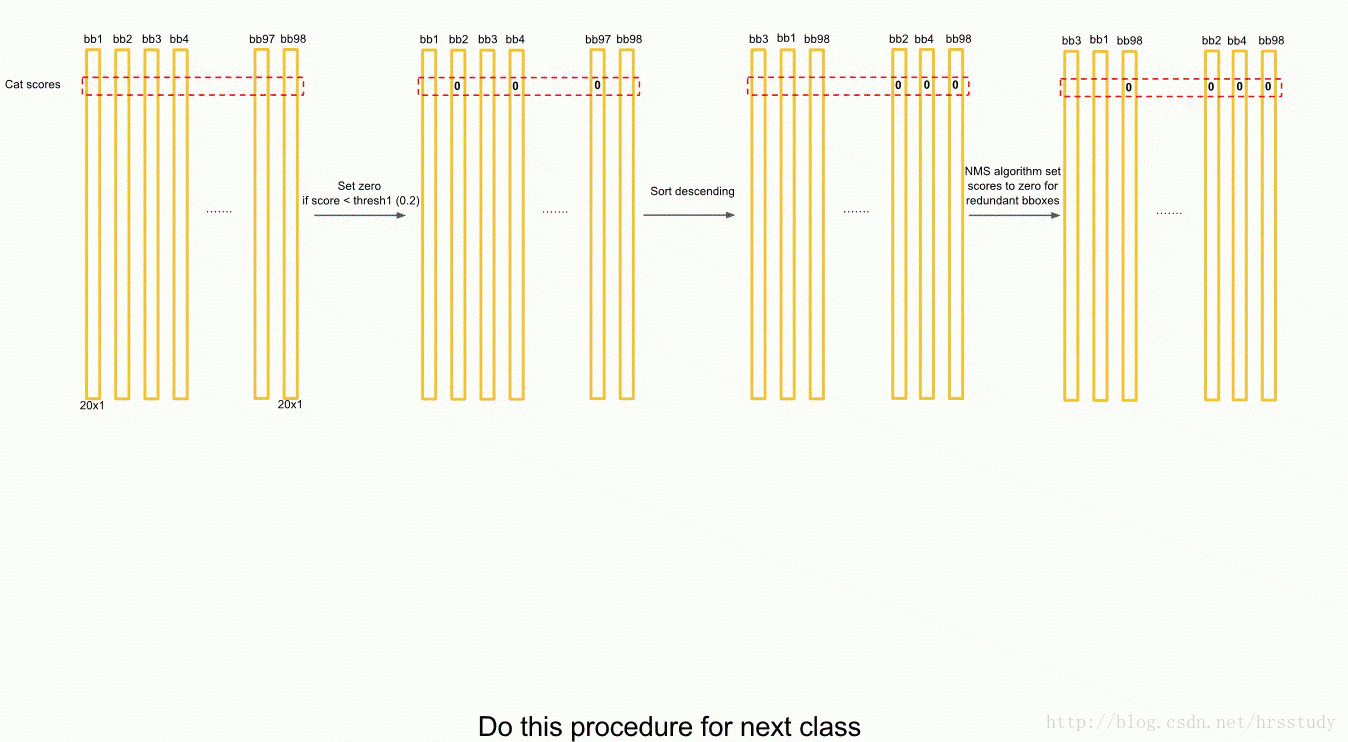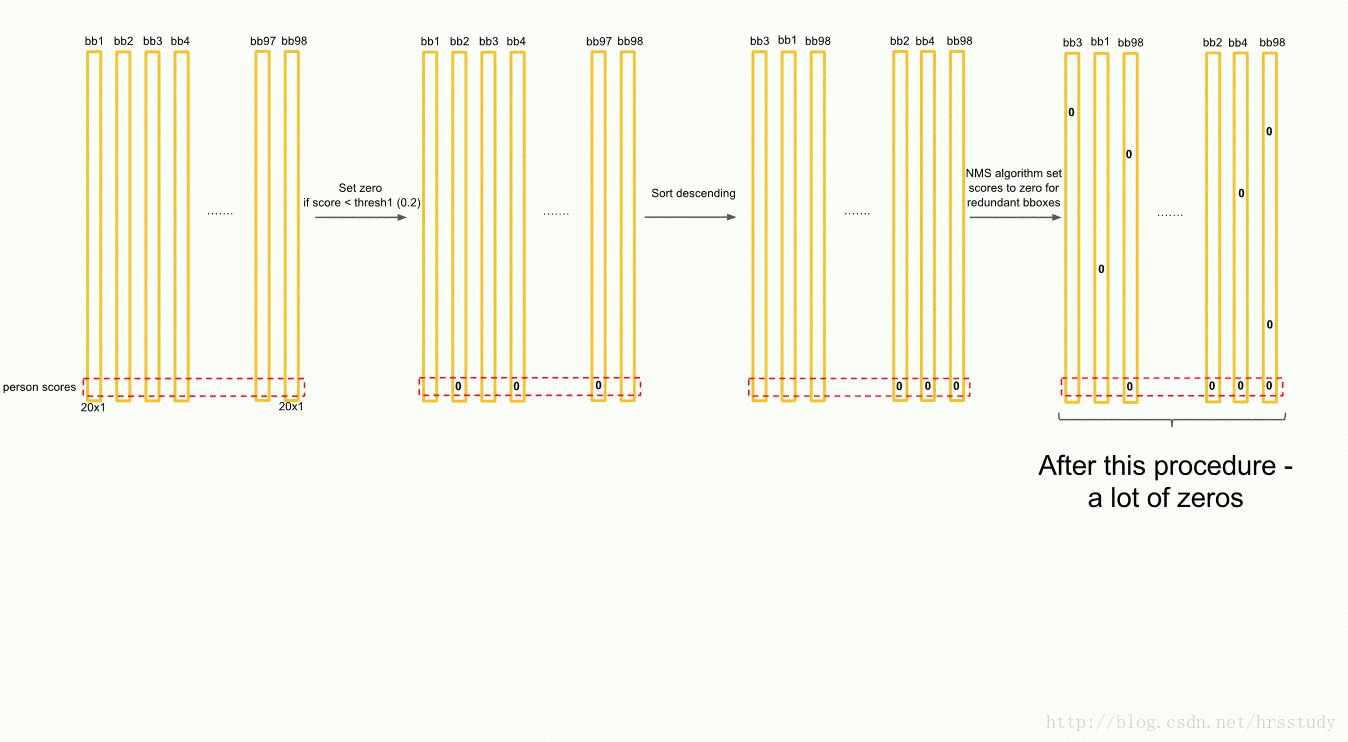
在上图中,将得到的98个向量的每一对应维度的值进行阈值分割(自定义阈值),小于该阈值的数值归零。第二步,在归零之后,进行降序排列,重新组合98个向量位置,最后,使用NMS(非极大值抑制)算法,去除重复率较大的bboxes。最后保留了最大的两个bboxes。
NMS简单介绍
针对某一类别,学则得分最大的bboxes,之后计算它与其他bboxes的IOU,
若IOU>0.5,则重复率较大,保留得分大的值,另一个设0;否则,不变。由此循环,直至结束。
当NMS算法结束后,进入下一阶段。
步骤:
- 设置一个Score的阈值,低于该阈值的候选对象排除掉(将该Score设为0)
- 遍历每一个对象类别
2.1.遍历该对象的98个得分
a.找到Score最大的那个对象及其bounding box,添加到输出列表
b.找到每个Score不为0的候选对象,计算其与上面输出对象的bounding box的IOU
d.根据预先设置的IOU阈值,所有高于该阈值(重叠度较高)的候选对象排除掉(将Score设置为0)
e.如果所有bounding box要么在输入列表中,要么Score=0,则该对象类别的NMS完成,返回步骤2处理下一种对象 - 输入列表即为预测的对象
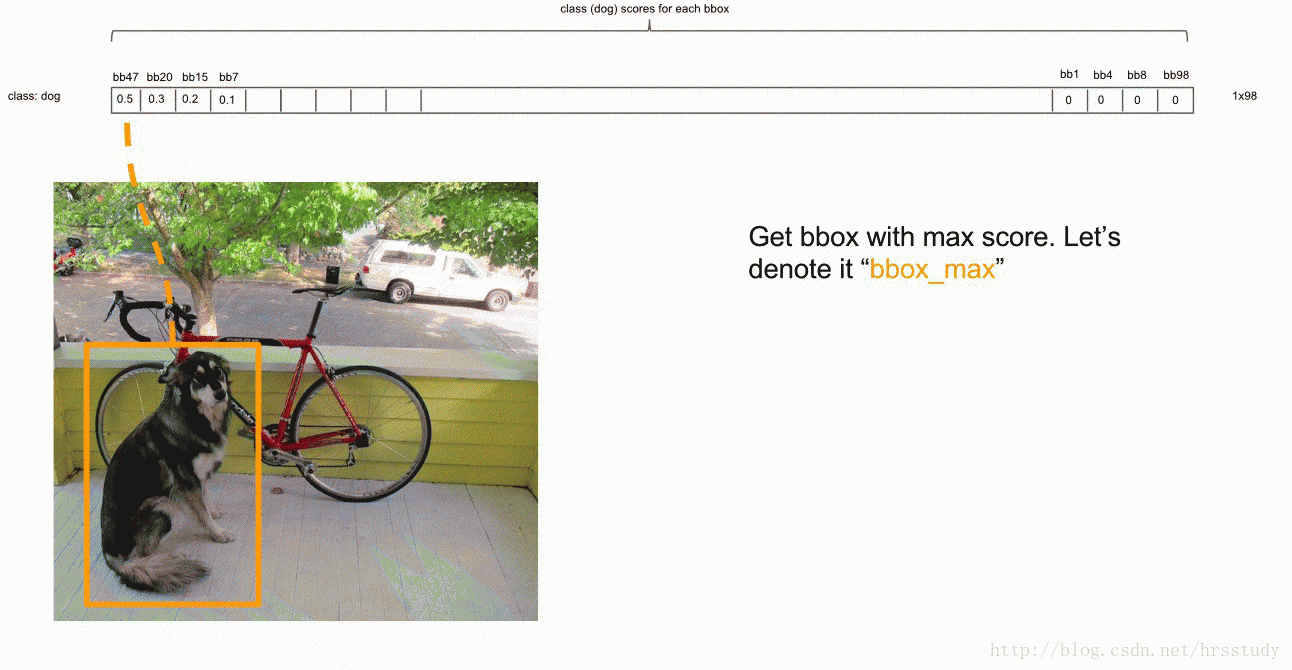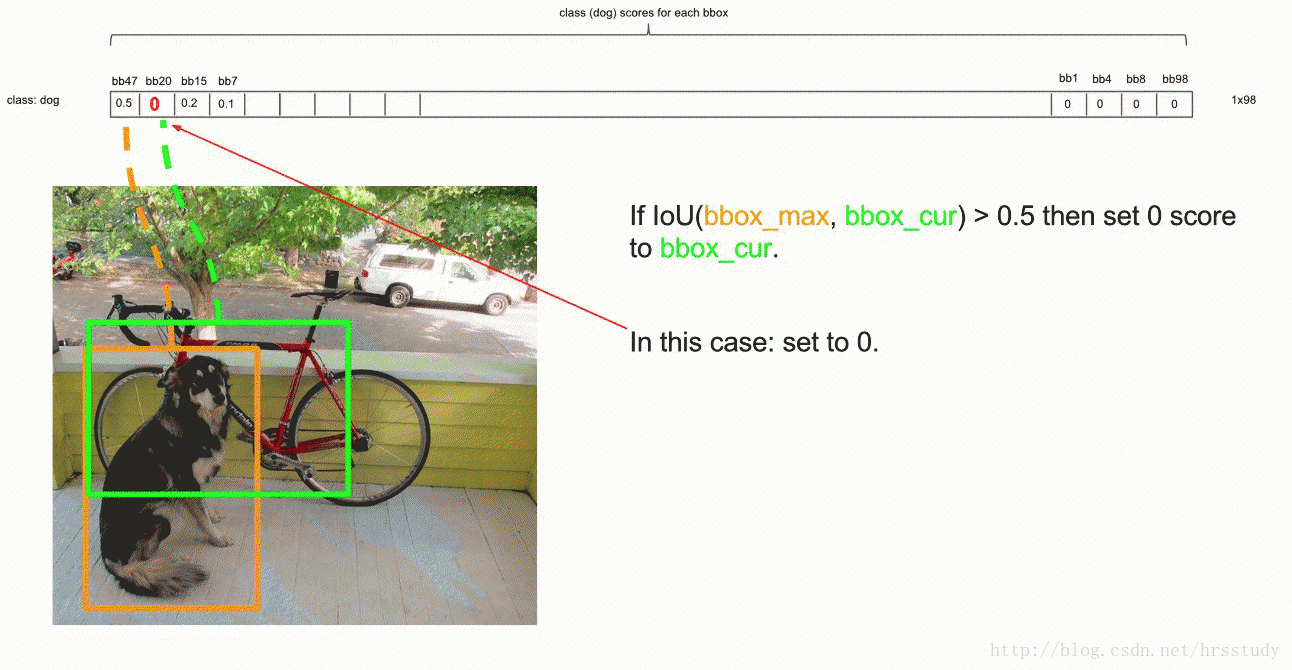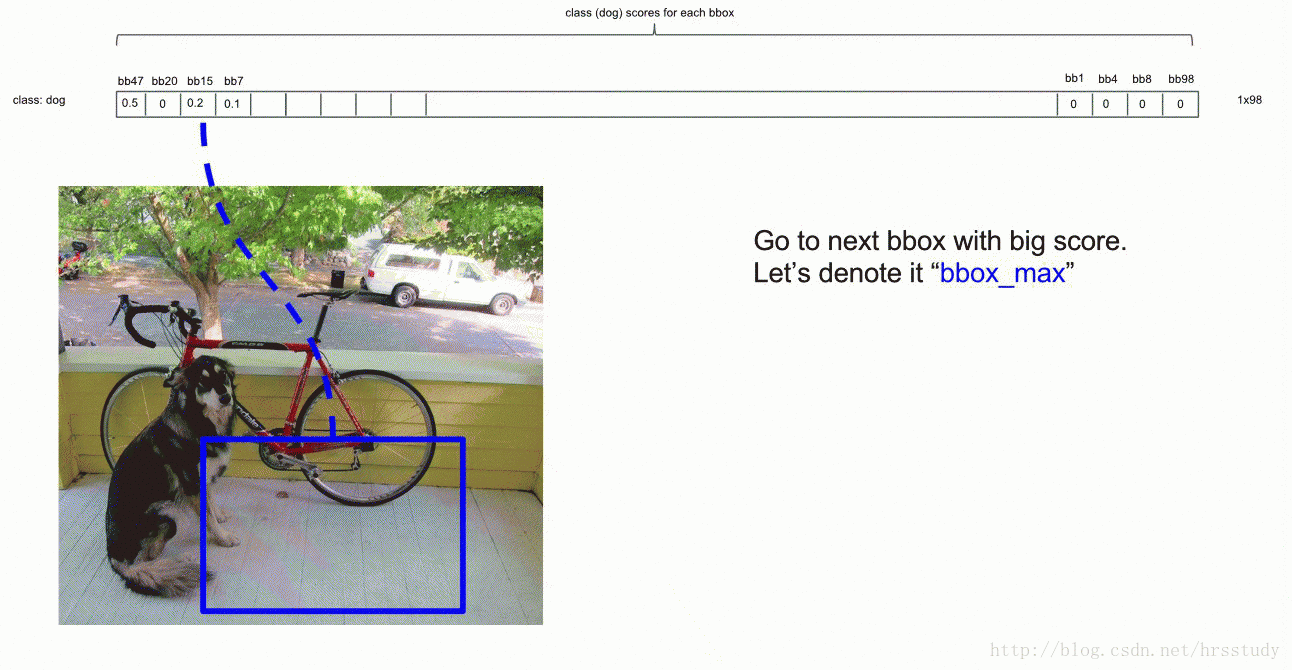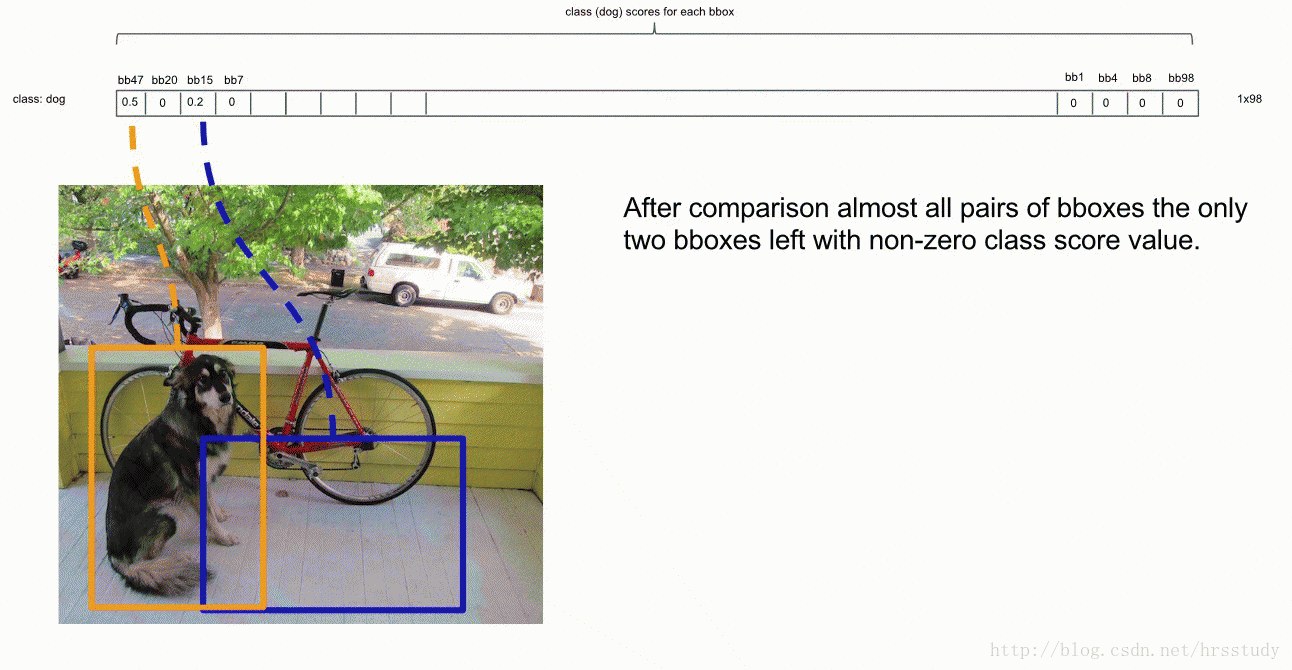
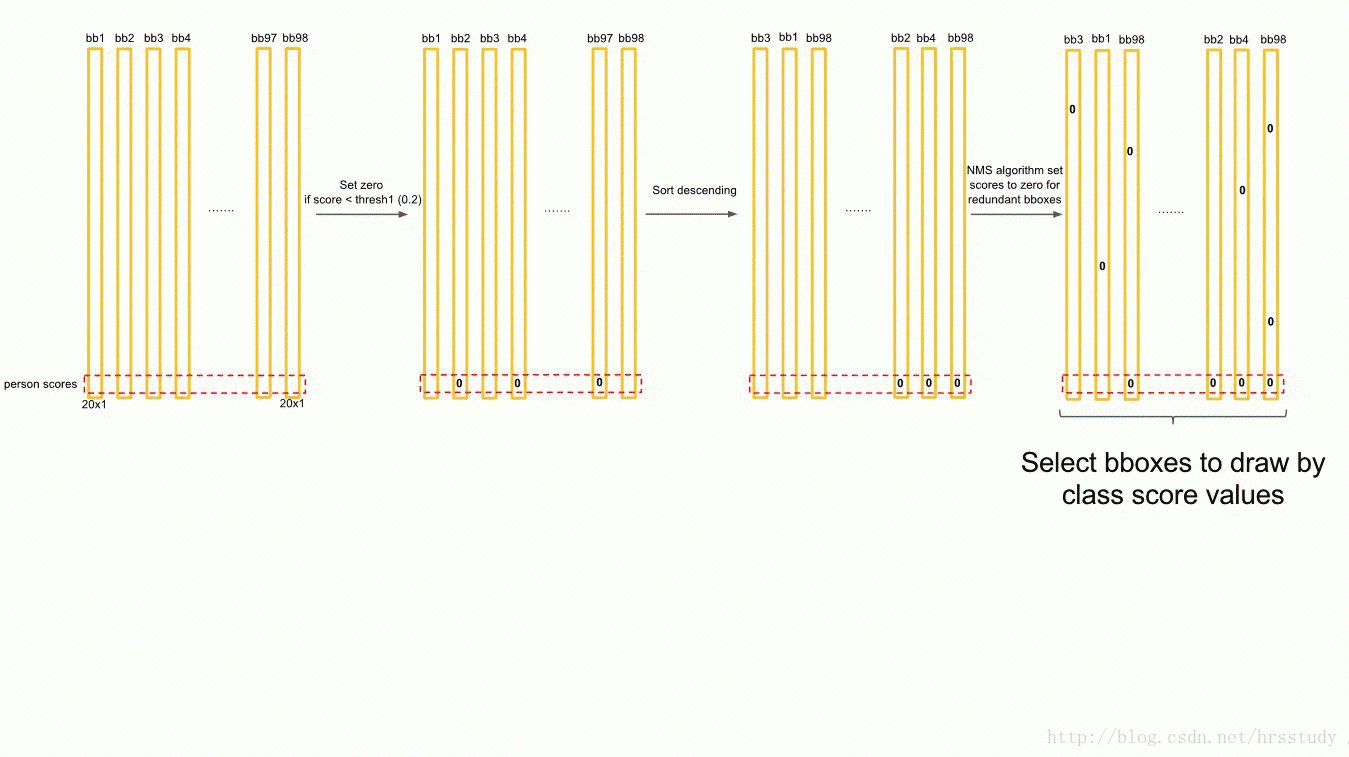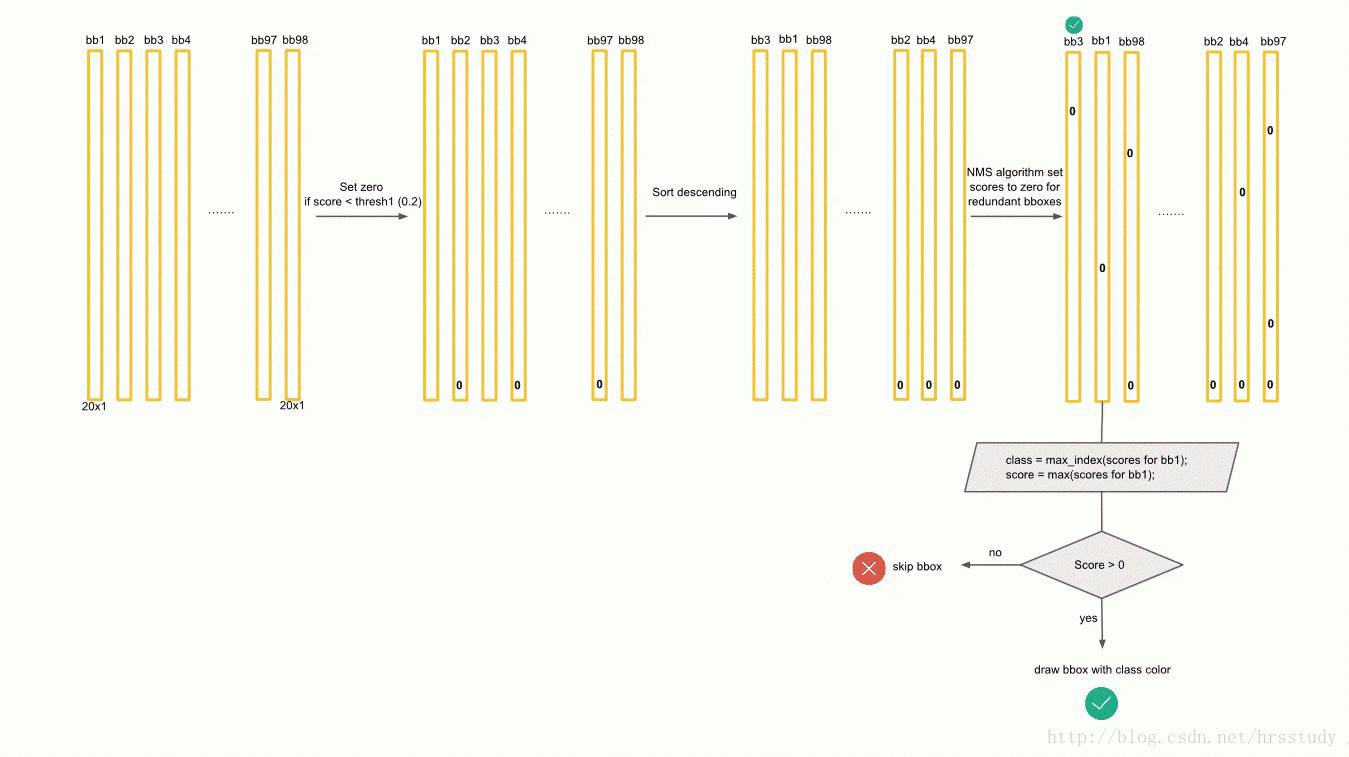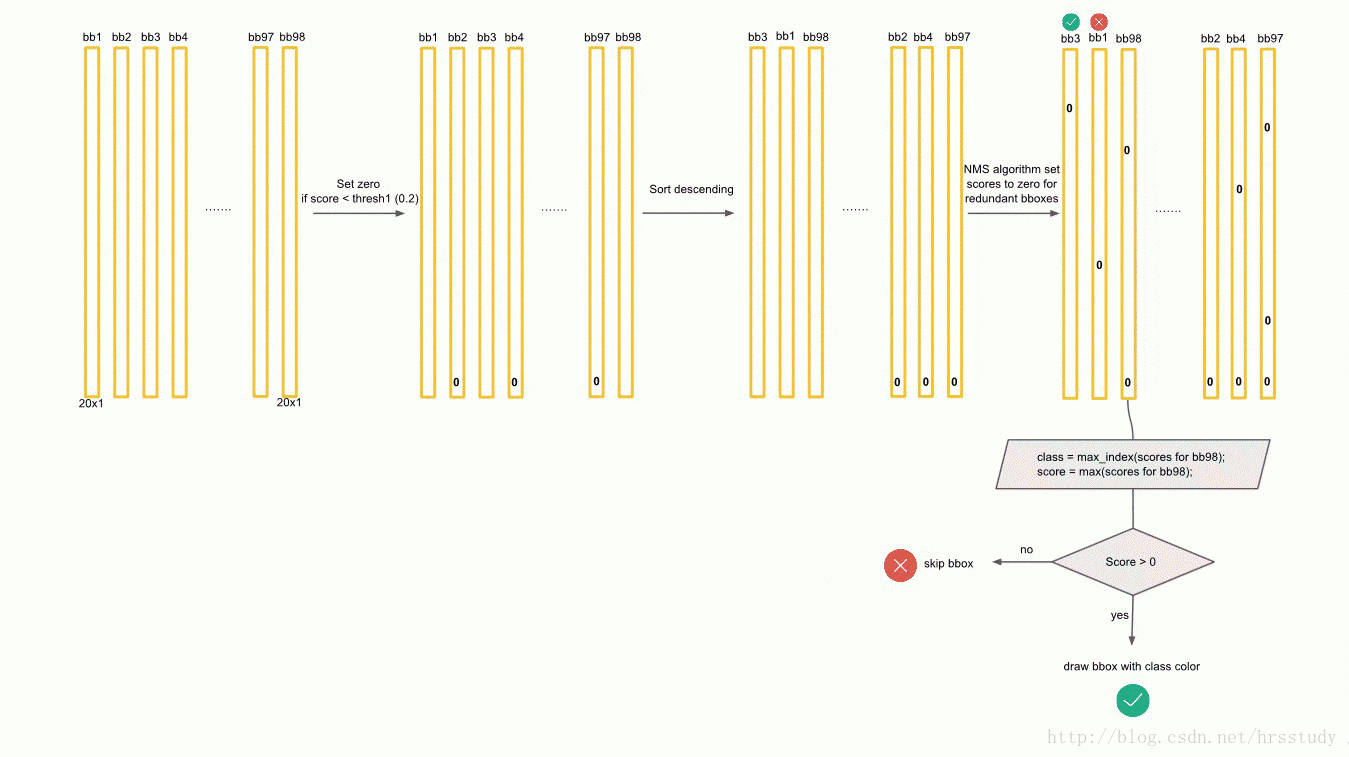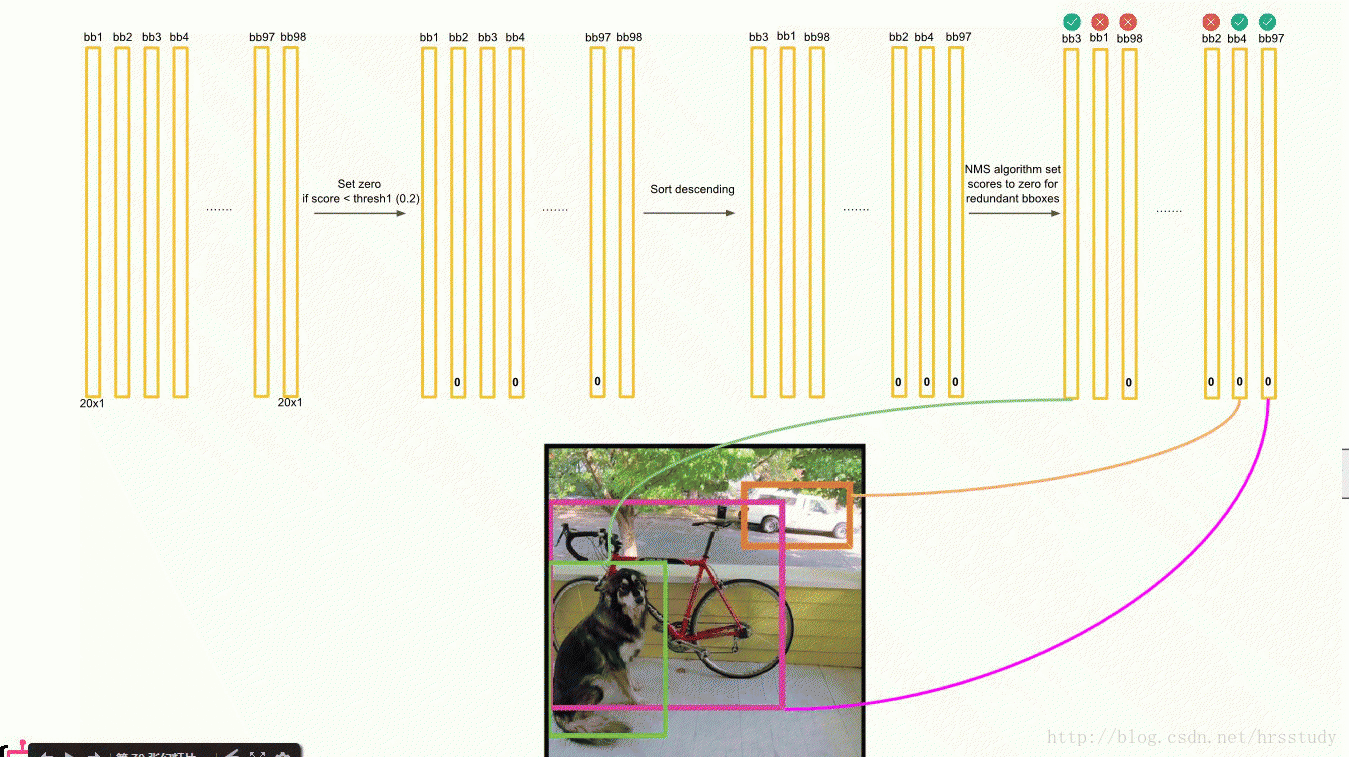
当每一个类别对象筛选结束后,找出每个bboxes中的最大值,并且执行如上图的判断语句,符合阈值,则在图中添加对应颜色的类别框。
补充
以上为YOLO系列的基本原理,并且随着技术的发展,YOLO V1已经发展到了YOLO V3.以下是YOLO V3的基本特点及其基本结构。
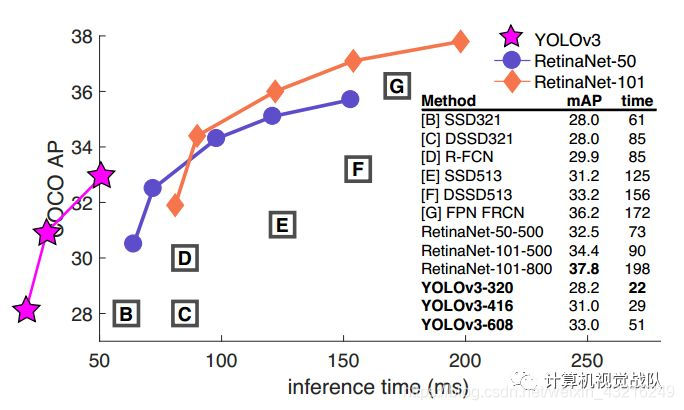
网络基本结构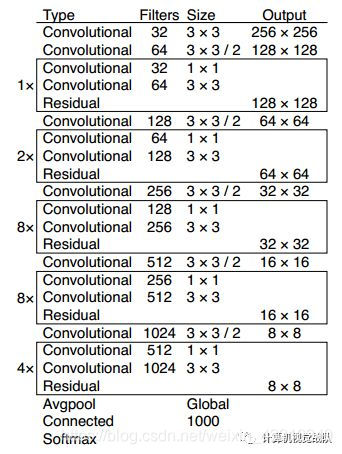
参考
You Only Look Once: Unified, Real-Time Object Detection
目标检测|YOLO原理与实现
图解YOLO
YOLO系列之yolo v1
YOLO系列之yolo v2
YOLO系列之yolo v3

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)